Цикл “Данные без противоречий” — про TDCV2, открытый конструктор тестовых данных, который я пишу сам. Работает он так: вы описываете конфигом, какой файл вам нужен, а конструктор порождает его целиком — от двух строк до сотен тысяч. Нужно это, когда надо наполнить базу, проверить отчёт или показать демо, а настоящие данные брать нельзя. От генераторов случайных значений он отличается одним: следит, чтобы данные не противоречили сами себе — про это весь цикл.
○ Часть 1 — Связи между полями
○ Часть 2 — Свободный формат вывода
○ Часть 3 — Справочники
○ Часть 4 — Форма данных рисунком
○ Часть 5 — Генерация через RegExp
● Часть 6 — Синтетика с известным ответом
В первой части я связывал поля внутри строки, во второй собирал из значений файл любого вида, в третьей связывал записи целиком, в четвёртой задавал форму данных рисунком, в пятой порождал строки по RegExp. Всё это было про тестовые данные: наполнить базу, проверить отчёт. Сегодня про другое применение — исследовательское.
Статья пригодится тем, кто готовит синтетические данные для обучения моделей, проверяет методы анализа или пишет пайплайн, который должен переживать неполные и грязные данные. И тем, кто учит статистику или машинное обучение и хочет показать студентам явление, а не рассказать о нём.
Недавно я обучил детектор бокового движения только на синтетике и выпустил его на настоящие журналы Лос-Аламосской лаборатории. Весь выдуманный мир там уместился в конфиг на 135 строк, но рассказывать, как такой мир собирается, было некогда — статья была про сети. Эта статья как раз про построение данных.
Задача
У настоящего датасета есть недостаток — он не знает правильного ответа. Неизвестно, как на самом деле устроен доход, почему пустые ячейки пустые и какие строки — выбросы. Метод, который вы на таком датасете проверяете, нечем поймать за руку: он что-то нашёл, а правильно ли — не узнать.
В синтетике правильный ответ закладываете вы сами. Отсюда план на всю статью: взять несколько обычных инструментов анализа, для каждого заложить в данные известный ответ и посмотреть, найдёт ли его инструмент. Каждый опыт устроен одинаково: вопрос, что закладываем, по какому признаку считаем опыт удачным, и что вышло. Опытов четыре:
-
Регрессия. Найдёт ли она связь, заложенную между двумя колонками?
-
Заполнение пропусков. Вернёт ли оно настоящее среднее, когда часть ответов пропала?
-
Детектор поломок. Найдёт ли он все отмеченные выбросы, не подняв ни одной ложной тревоги?
-
Правило контрольной карты. Выдержит ли оно шум, который помнит своё прошлое?
Все цифры в статье — настоящий прогон движка, конфиги приведены целиком или почти целиком.
Мир для опытов
Опытам нужен мир, и я возьму выдуманный: межгалактическую станцию с экипажем в десять тысяч человек. Про экипаж мы знаем то, что он сам о себе написал в анкете: возраст и доход. Анкета здесь не случайно: в анкетах ответы пропадают естественно, на вопрос о доходе отвечают не все, и это пригодится во втором опыте. Позже к экипажу добавится реактор станции, у которого есть датчик нагрузки.
Доход здесь в межгалактических кредитах. Это не для красоты: у каждой страны свои деньги, и про зарплату в рублях, долларах или тенге у каждого читателя есть свои цифры. Любое число в настоящей валюте немедленно встретило бы ответ “у нас столько не платят”. Сколько получает молодой пилот грузового звездолёта и сколько ветеран, никто проверить не может, поэтому кредиты остаются тем, чем и должны быть в этом примере, — просто числами.
Первый вопрос к миру — какими должны быть числа. Большинство генераторов по умолчанию выдают их равномерно: в диапазоне от 18 до 80 лет возраст 19 встречается так же часто, как 42. Люди так не устроены. Возраст и рост собираются колоколом вокруг среднего, доходы перекошены вправо — много средних и немного огромных. Модель, обученная на равномерных числах, учится на мире, которого не бывает.
В TDCV2 форма задаётся атрибутом distribution у обычного числового генератора. Готовых форм девять:
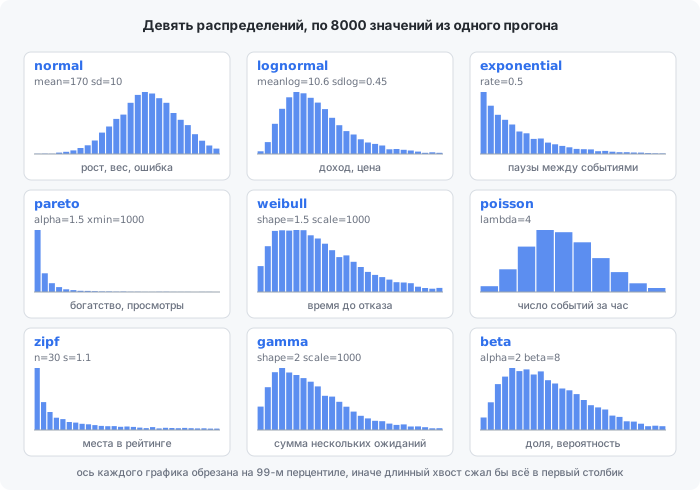
Для экипажа нужны две: возраст колоколом (normal) и доход с перекосом вправо (lognormal). У колокола хвосты уходят в обе стороны бесконечно, поэтому возраст изредка вышел бы отрицательным; min и max прижимают такие значения к границе. И главное: доход растёт с возрастом, поэтому параметр его распределения записан не числом, а выражением над колонкой Age:
<tdc> <env count="10000" seed="survey"> <sequence name="Age"> <gen type="number" distribution="normal" mean="42" sd="12" min="18" max="80"/> </sequence> <sequence name="Income"> <gen type="number" distribution="lognormal" meanlog="9.9 + 0.017 * Age" sdlog="0.4"/> </sequence> </env> <block> <line><data>${{Age}},${{Income}}</data></line> </block></tdc>
18,2337457,15916137,5639025,3260425,2456729,29020
Строчка meanlog="9.9 + 0.017 * Age" — это вся модель мира: логарифм дохода растёт на 0.017 с каждым годом, а вокруг этого роста разброс 0.4. Статистик назвал бы это условным распределением, а я называю просто связью между колонками — ровно тем, ради чего цикл называется “без противоречий”. Двадцатилетний с доходом как у шестидесятилетнего здесь бывает, но редко, как и в жизни.
Одно слово из конфига понадобится дальше много раз: seed, зерно. Это число или слово, от которого движок считает все случайные значения. Одинаковое зерно даёт одинаковый файл до байта, сколько ни запускай; другое зерно — другой экипаж, устроенный по тем же правилам. Здесь зерно survey, а сменить его можно, не трогая конфиг, ключом --seed.
Опыт 1. Найдёт ли регрессия заложенную связь
Вопрос. Если притвориться, что конфига мы не видели, восстановит ли обычная регрессия связь дохода с возрастом?
Что заложено. Наклон 0.017 и сдвиг 9.9 для логарифма дохода.
Критерий. Заложенный наклон должен попасть в 95-процентный интервал того, что найдёт регрессия.
Регрессия логарифма дохода на возраст, четыре строки на numpy:
import numpy as npage, income = np.loadtxt("survey.csv", delimiter=",", unpack=True)slope, intercept = np.polyfit(age, np.log(income), 1)print(f"наклон {slope:.5f}, сдвиг {intercept:.3f}")
наклон 0.01722, сдвиг 9.889
Результат. Найдено 0.01722 и 9.889. Интервал наклона на десяти тысячах строк — от 0.0166 до 0.0179, заложенные 0.017 внутри. Разброс остатков вышел 0.395 при заложенных 0.4. Опыт удался.
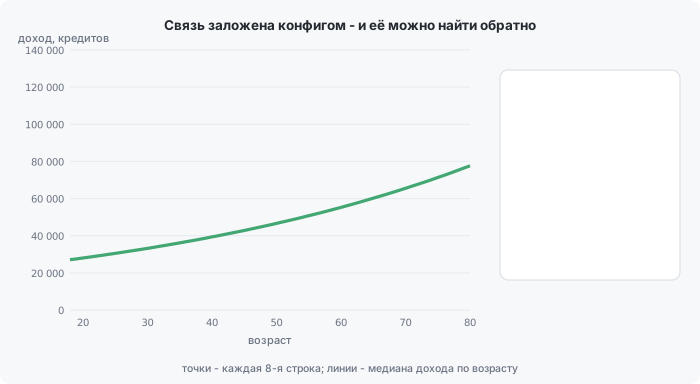
Для регрессии результат скучный: метод старый, работает. Но опыт был нужен ради схемы, а не ради регрессии. Заложили связь, сгенерировали данные, прогнали метод, сравнили с заложенным. Так можно проверить что угодно: новую модель, самописный пайплайн, библиотеку заполнения пропусков.
Правда, в этом опыте анкету заполнили все десять тысяч человек. В жизни так не бывает, и это следующий опыт.
Опыт 2. Вернёт ли заполнение настоящее среднее
Пустая ячейка выглядит одинаково, но появляется по-разному. В статистике различают три механизма пропусков, и на нашей станции у каждого своя история:
-
MCAR — пропуск совершенно случаен. Часть анкет потерялась при пересылке с дальних палуб.
-
MAR — пропуск зависит от другой колонки, которую видно. Молодые члены экипажа реже указывают доход.
-
MNAR — пропуск зависит от самого пропавшего значения. Самые богатые не пишут, сколько зарабатывают.
Вопрос. Если посчитать средний доход по тем, кто ответил, и заполнить пропуски самым ходовым способом — средним по ответившим того же десятилетия возраста, — получится ли настоящее среднее?
Что заложено. Тот же экипаж, но с пропусками одного из трёх видов. В TDCV2 все три задаются атрибутами того же генератора: missing — доля пустых, missing_when — условие, при котором ответ вообще может пропасть. Внутри условия _value — то самое значение, которое сейчас пропадёт:
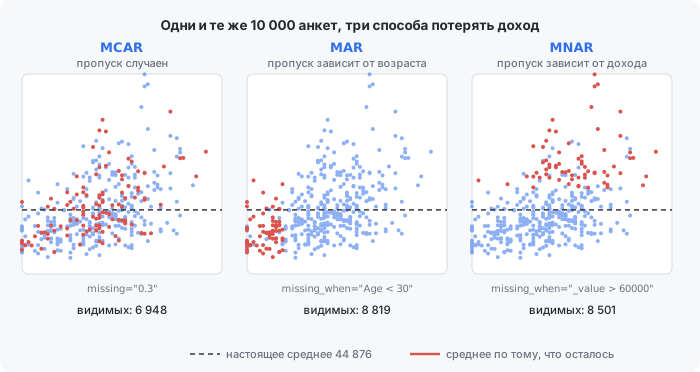
<!-- MCAR: каждый ответ пропадает с вероятностью 0.3 -->missing="0.3" missing_as="NULL"<!-- MAR: пропадают только доходы людей младше 30, и то в 80% случаев -->missing="0.8" missing_when="Age < 30" missing_as="NULL"<!-- MNAR: пропадают доходы больше 60 000 кредитов -->missing="0.8" missing_when="_value > 60000" missing_as="NULL"
Любую из строк дописываем к генератору Income из конфига выше. Решение “пропасть ответу или нет” движок принимает отдельно от самого дохода, поэтому при том же зерне доходы не меняются — пропавший ответ просто исчезает. Вот четыре прогона — без пропусков и с каждым механизмом, склеенные построчно:
Age full MCAR MAR MNAR18 23374 NULL NULL 2337457 159161 NULL 159161 NULL37 56390 56390 56390 5639025 32604 32604 NULL 3260425 24567 24567 NULL 2456729 29020 29020 NULL 2902029 20722 20722 20722 2072236 56493 56493 56493 56493
Это и есть то, чего нет у настоящего датасета: рядом с неполной колонкой лежит полная. Значит, настоящее среднее известно — 44 876 кредитов.
Критерий. После заполнения среднее должно отличаться от настоящего не больше чем на 1%, то есть примерно на 450 кредитов.
|
|
ответов |
среднее по ответившим |
после заполнения по возрасту |
критерий |
|---|---|---|---|---|
|
без пропусков |
10 000 |
44 876 |
— |
— |
|
MCAR |
6 948 |
44 793 |
44 886 |
выполнен |
|
MAR |
8 819 |
46 621 |
44 885 |
выполнен |
|
MNAR |
8 501 |
38 874 |
39 502 |
не выполнен |
Результат. Учебник по статистике обещает ровно это, и здесь его можно потрогать руками:
-
MCAR выбросил почти треть анкет, а среднее почти не сдвинулось. Пропуски ничего не знают о доходе, поэтому оставшиеся анкеты — честная выборка.
-
MAR завысил среднее на 1 745 кредитов: пропали молодые, а у них доходы ниже. Но возраст виден, и заполнение по возрасту вернуло среднее на место — 44 885 против настоящих 44 876.
-
MNAR занизил среднее на шесть тысяч кредитов, и заполнение по возрасту почти не помогло: ошибка осталась больше 12%. Пропали именно большие доходы, а по тем, кто ответил, этого не видно. Чтобы это исправить, нужно знание со стороны — как именно богатые отвечают на анкеты, — а в самих данных его нет.
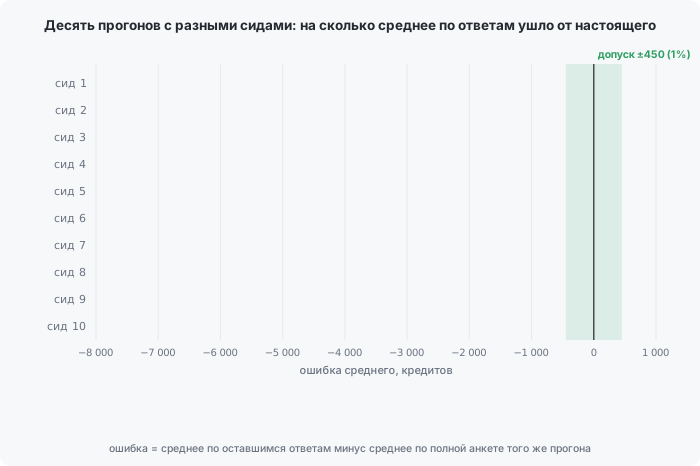
Один экипаж ничего не доказывает: вдруг повезло. Поэтому опыт повторяется с десятью разными зёрнами, то есть на десяти разных экипажах. Это просто цикл в шелле:
for s in $(seq 1 10); do tdcv2 survey-mnar.tdc --seed $s -o mnar-$s.csvdone
На всех десяти MNAR занижает среднее на величину от 5 826 до 6 510 кредитов. Сдвиг устойчивый и одного знака, значит, это свойство механизма, а не случайность одного прогона. В статистике такое называют симуляционным исследованием, и обычно модель мира для него пишут кодом. Здесь вся модель мира — тот же конфиг, а зерно — единственное, что меняется между повторами.
Последнее про пропуски. Если опыт что-то требует от данных — скажем, чтобы с доходом осталось хотя бы 90% анкет, — это требование можно записать прямо в конфиг, и движок откажется выдавать файл, который ему не отвечает:
<sequence name="Income"> <gen type="number" distribution="lognormal" meanlog="9.9 + 0.017 * Age" sdlog="0.4" missing="0.8" missing_when="_value > 60000"/></sequence><sequence name="Answered"><gen type="stat" of="Income" op="count"/></sequence><assert that="Answered >= 9000" says="хотя бы 90% анкет должны остаться с доходом"/>
tdcv2: assert failed: хотя бы 90% анкет должны остаться с доходом Answered >= 9000 with Answered = 8501
Из конфига эта доля не видна: она зависит от того, сколько доходов выше 60 000 кредитов, а это решает распределение. Код выхода 1, так что CI остановится. Одна ловушка, на которую я сам наступил: op="count" не считает пустые ячейки, но NULL из missing_as для него обычное значение. С меткой NULL та же проверка насчитала все 10 000 строк и молча прошла. Поэтому в конфиге с проверкой пустая ячейка остаётся пустой.
С анкетами всё. Дальше — реактор.
Опыт 3. Найдёт ли детектор поломки
У реактора станции есть датчик нагрузки, он пишет одно значение в час. Нагрузка ходит по суточному кругу: днём станция работает, нагрузка растёт, ночью спит, нагрузка падает. Такой повторяющийся ритм называют сезоном, даже если он длиной в сутки, а не в год. Поверх ритма — мелкий шум измерения, а иногда датчик сбоит и выдаёт значение на 20% выше настоящего. Ищет эти сбои детектор, и его-то мы и проверяем.
Чтобы оценить детектор, нужно знать, какие часы сбойные на самом деле. На настоящих данных это знание добывают ручной разметкой — дорого и с ошибками. В синтетике разметку делает тот же механизм, что делает сбой:
<tdc> <env count="10000" seed="plant"> <sequence name="Hour"><gen type="increment" value="0"/></sequence> <sequence name="Load"> <gen type="timeseries" base="100" period="24" amplitude="15" noise="2" decimals="1" anomaly="0.01" anomaly_factor="1.2" anomaly_flag="Spike"/> </sequence> </env> <block> <line><data>${{Hour}},${{Load}},${{Spike}}</data></line> </block></tdc>
base — средний уровень, period="24" и amplitude="15" — суточный ритм и его размах, noise — шум. anomaly="0.01" — доля сбоев, anomaly_factor — во сколько раз сбой больше настоящего значения, а anomaly_flag="Spike" заводит новую колонку с правильным ответом. Вот два места, где сбои есть:
76,115.6,false77,116.0,false78,113.4,false79,134.9,true80,115.3,false...91,87.0,false92,88.6,false93,105.5,true94,90.1,false
Первый сбой видно глазом: 134.9 выше всего, что датчик выдаёт в обычные часы. А второй — 105.5 — это нормальное дневное значение. Сбоем его делает только то, что он пришёлся на ночь, когда нагрузка около 88. Глазом его не найти, правильный ответ знает только колонка Spike.
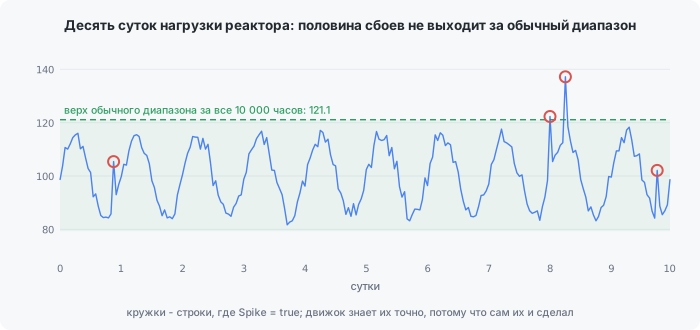
Вопрос. Какой детектор находит сбои: с одним порогом на весь ряд или тот, что сравнивает час с тем же часом в соседние сутки?
Критерий. Найдены все 95 отмеченных часов, ложных тревог ноль.
Результат. Обычные значения за 10 000 часов лежат от 79.3 до 121.1, а из 95 сбоев внутрь этого диапазона попали 54. Детектор с одним порогом без ложных тревог ловит не больше остальных 41: опустить порог ниже 121.1 — значит начать тревожить в обычные часы. Критерий не выполнен. Детектор, который сравнивает час с тем же часом в соседние трое суток, ловит все 95 без единой ложной тревоги. Критерий выполнен. Без колонки с правильным ответом оба детектора выглядели бы рабочими.
Детектор целиком
import csv, statistics as strows = list(csv.reader(open("sensor.csv")))load = [float(r[1]) for r in rows]spike = [r[2] == "true" for r in rows]# остаток: насколько час отличается от того же часа в соседние трое сутокres = []for i, v in enumerate(load): same_hour = [load[j] for j in (i-72, i-48, i-24, i+24, i+48, i+72) if 0 <= j < len(load)] res.append(v - st.median(same_hour))mad = st.median(abs(r) for r in res) * 1.4826for k in (3, 4, 5): hit = [abs(r) > k * mad for r in res] tp = sum(h and s for h, s in zip(hit, spike)) fp = sum(h and not s for h, s in zip(hit, spike)) print(f"k={k}: поймано {tp} из {sum(spike)}, ложных {fp}")
k=3: поймано 95 из 95, ложных 16k=4: поймано 95 из 95, ложных 0k=5: поймано 95 из 95, ложных 0
mad — типичное отклонение часа от своих соседей, пересчитанное в сигмы; k — порог в этих сигмах.
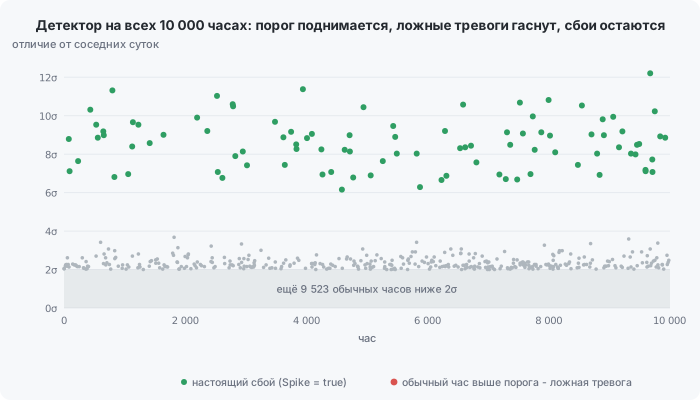
Опыт удался, и сразу возникает следующий вопрос: а где у этого детектора граница? Сбой на 20% он видит, а на 5%? Здесь помогает одно свойство движка: при том же зерне и том же имени колонки сбоят те же самые часы при любом anomaly_factor — меняется только высота сбоя. Значит, можно уменьшать сбой и смотреть, сколько из тех же 95 часов детектор ещё видит:
|
порог детектора |
сбой 5% |
сбой 10% |
сбой 20% |
ложных |
|---|---|---|---|---|
|
3 сигмы |
19 из 95 |
84 из 95 |
95 из 95 |
16 |
|
4 сигмы |
2 из 95 |
59 из 95 |
95 из 95 |
0 |
|
5 сигм |
1 из 95 |
22 из 95 |
95 из 95 |
0 |
Это кривая чувствительности. При шуме 2 и уровне 100 сбой на 5% — это две с половиной сигмы, и детектор его почти не видит, как ни настраивай. Знать это до того, как детектор пропустит настоящую поломку, полезнее, чем после.
Колонка с правильным ответом устроена так, чтобы не врать. Если ячейку со сбоем опустошил missing, метка в ней false: сбоя, который можно найти, в пустой ячейке нет, и метка “сбой” рядом с пустотой учила бы детектор неправде. Та же логика была в статье про боковое движение: колонку “чужой вход” считала та же формула, что порождала сам вход, поэтому метка и событие разойтись не могли.
Сбой другого вида и точная доля
Пока сбой был одного вида: настоящее значение, умноженное на коэффициент. Но датчики ломаются и по-другому — например, залипают и выдают ноль. Умножением такой сбой не получить. И есть вторая тонкость, важная, когда детекторы сравнивают между собой. anomaly="0.01" — это вероятность, а не квота: на 10 000 часов при зёрнах с первого по пятое сбоев выходит 105, 114, 88, 109 и 102. Если сравнивать два детектора на разных зёрнах, точность у них будет плавать уже от одного этого: доля ложных среди срабатываний прямо зависит от того, сколько настоящих сбоев в данных.
Оба вопроса решает <mix> — выбор между вариантами с заданными долями, он уже встречался в цикле. Первый вариант — обычный ряд, второй — залипший датчик, он помечается anomaly="true", а колонку с правильным ответом заводит flag:
<mix name="Load" percent="99,1" flag="Stuck"> <case><gen type="timeseries" base="100" period="24" amplitude="15" noise="2" decimals="1"/></case> <case anomaly="true"><gen type="number" value="0"/></case></mix>
0,103.5,false1,104.9,false2,0,true3,111.0,false
Ряд внутри варианта идёт по настоящему номеру строки: залипший час выпадает из волны, а соседние часы остаются на своих местах.
Залипших часов ровно 100 из 10 000 при любом из тех же пяти зёрен. Часы разные, доля одна: движок раздаёт варианты на весь столбец сразу, методом наибольшего остатка, поэтому доля сходится ровно, а не примерно.
Опыт 4. Выдержит ли правило шум с памятью
До сих пор шум датчика был независимым: высокое значение в этот час ничего не говорит о следующем. Настоящая ошибка измерения так себя почти не ведёт. Датчик, который ушёл вверх, какое-то время там и остаётся. А многие методы рассчитаны именно на независимый шум.
Возьмём один такой метод — правило контрольной карты. Контрольные карты — старый инструмент с производства: на график наносят среднее и границы в две и три сигмы, а тревогу поднимают по простым правилам. Одно из них — “три точки подряд за пределом двух сигм по одну сторону”.
Вопрос. Сколько ложных тревог даст это правило, если шум датчика помнит своё прошлое?
Что заложено. Два ряда без всяких сбоев, одинаковые во всём, кроме памяти шума. За память отвечает атрибут noise_correlation: при 0.9 в следующий час переходит 90% шума текущего. Если знаете название, это модель AR(1).
<sequence name="White"><gen type="timeseries" base="20" noise="1" decimals="2"/></sequence><sequence name="Sticky"><gen type="timeseries" base="20" noise="1" noise_correlation="0.9" decimals="2"/></sequence>
Критерий. Сбоев в рядах нет, поэтому каждая тревога ложная. На шуме с памятью тревог должно быть не больше, чем на независимом.
Результат. На 20 000 строк разброс у обоих рядов почти одинаковый, 0.999 и 0.981. За три сигмы выходят 57 и 47 точек, тоже почти поровну. А правило срабатывает 0 раз на независимом шуме и 102 раза на шуме с памятью. Соседнее правило — “восемь точек подряд по одну сторону от среднего” — даёт 75 тревог против 831. Критерий не выполнен.
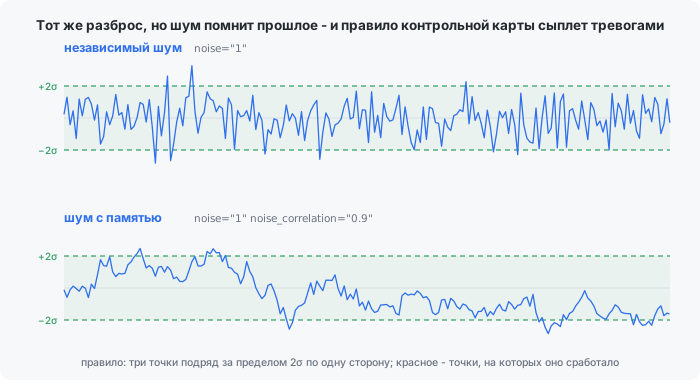
Дело не в ошибке правила: правила контрольных карт выведены в предположении, что точки независимы. Код, который проверяли только на независимом шуме, с этим случаем просто ни разу не встречался. В синтетике это один атрибут, и случай встречается до продакшена, а не в нём.
Генератор временных рядов умеет и больше, чем понадобилось в опытах. Ряд собирается из слоёв — уровень, рост, сезон и шум, — и каждый слой включается своим атрибутом:
<gen type="timeseries" base="1000" trend="4" period="30" amplitude="150" noise="40"/>
Сезонов может быть несколько сразу: period="7,365" с двумя амплитудами даёт недельный ритм поверх годового, а peak_at говорит, на какую строку приходится пик, — чтобы летний максимум пришёлся на июль, а не на апрель, куда синус ставит его по умолчанию.
Что из этого следует
Итог четырёх опытов:
|
опыт |
критерий |
результат |
|---|---|---|
|
Регрессия |
заложенный наклон внутри 95% интервала |
выполнен |
|
Заполнение пропусков |
среднее с точностью до 1% |
MCAR и MAR — выполнен, MNAR — нет |
|
Детектор сбоев |
95 из 95, ноль ложных |
сравнение с соседними сутками — выполнен, один порог — нет |
|
Правило контрольной карты |
ложных не больше, чем на независимом шуме |
не выполнен: 102 против 0 |
Невыполненные критерии здесь полезнее выполненных. Каждый из них — граница инструмента, которую мы нашли до того, как в неё упёрлись на настоящих данных. Отсюда три способа пользоваться синтетикой в исследованиях:
-
Проверить метод. Заложить связь и посмотреть, найдёт ли её регрессия, модель или пайплайн.
-
Измерить границу. Найти сбой, который детектор уже не видит, и механизм пропусков, который уже ничем не заполнить.
-
Нарушить предположение. Подсунуть методу шум с памятью, перекошенное распределение или зависимые пропуски и посмотреть, что сломается.
Честная оговорка тоже из опытов. Синтетика содержит ровно то, что вы в неё заложили. Если в настоящем мире пропуски устроены не так, как в конфиге, хорошая оценка на синтетике ничего не гарантирует. Поэтому в статье про боковое движение экзаменом были настоящие журналы, а не выдуманный мир. Выдуманный мир — это гипотеза о том, как устроены данные, и проверять её приходится на настоящих.
Зато гипотеза записана явно. Конфиг на десяток строк плюс зерно дают тот же файл байт в байт, на любой машине и на любом из пяти языков, на которых написан движок. Все конфиги этой статьи я прогнал на TypeScript, Python и Rust — контрольные суммы файлов совпали. Такой конфиг помещается в приложение к статье целиком. Кто захочет повторить опыт, получит не “похожий датасет”, а тот же самый.
Инструмент называется TDCV2, лежит под MIT.
○ Часть 1 — Связи между полями
○ Часть 2 — Свободный формат вывода
○ Часть 3 — Справочники
○ Часть 4 — Форма данных рисунком
○ Часть 5 — Генерация через RegExp
● Часть 6 — Синтетика с известным ответом
Буду очень рад любым комментариям! Найдете ошибку, не стесняйтесь сообщить о находке и поправлять меня в комментариях. Увидимся в следующей статье. Всем добра!
ссылка на оригинал статьи https://habr.com/ru/articles/1103580/