Автор оригинала: Ben Brubaker
Исследователи внедряют «мысли» прямо в большие языковые модели, чтобы выяснить, способен ли ИИ к интроспекции и в какой мере.
Иллюстрация: Kristina Armitage / Quanta Magazine
О чём вы сейчас думаете? Скорее всего, ответ не потребует особых усилий. Способность отдавать себе отчёт в собственных мыслях называется интроспекцией, и нам она кажется чем-то естественным.
Но философы и психологи продолжают о ней спорить. Одни считают, что она тесно связана с сознанием. Другие называют её тщательно выстроенной иллюзией. Проверять теории интроспекции в лаборатории трудно, и даже точное определение дать непросто.
Больше века интроспекцию изучали у людей и животных, а теперь исследователи взялись за необычных новых подопытных: большие языковые модели. Эти системы построены на математических структурах, которые называются нейронными сетями, и отлично справляются с когнитивными задачами, ещё недавно считавшимися исключительно человеческими. Способны ли они и к интроспекции?
В 2025 году Джек Линдси, исследователь из Anthropic, придумал, как это проверить: внедрять «мысли» прямо в нейронные сети моделей. Получилась своего рода прицельная цифровая нейрохирургия. Эксперимент Линдси показал, что модели хотя бы иногда способны обнаружить такое внедрение и описать его. Это было очень похоже на интроспекцию.
Статья Линдси намеренно ограничивалась узкой задачей и не делала широких заявлений о сознании. В частности, из неё не следовало, что у языковых моделей есть субъективный опыт от первого лица. И всё же она наделала шума в сети, а исследователи бросились повторять её на других моделях.
За прошедший год картина прояснилась. Часть того, что наблюдал Линдси, получила более простые объяснения, никак не связанные с интроспекцией. Другую часть объяснить так же легко не вышло, но считать ли её интроспекцией, до сих пор горячо спорят.
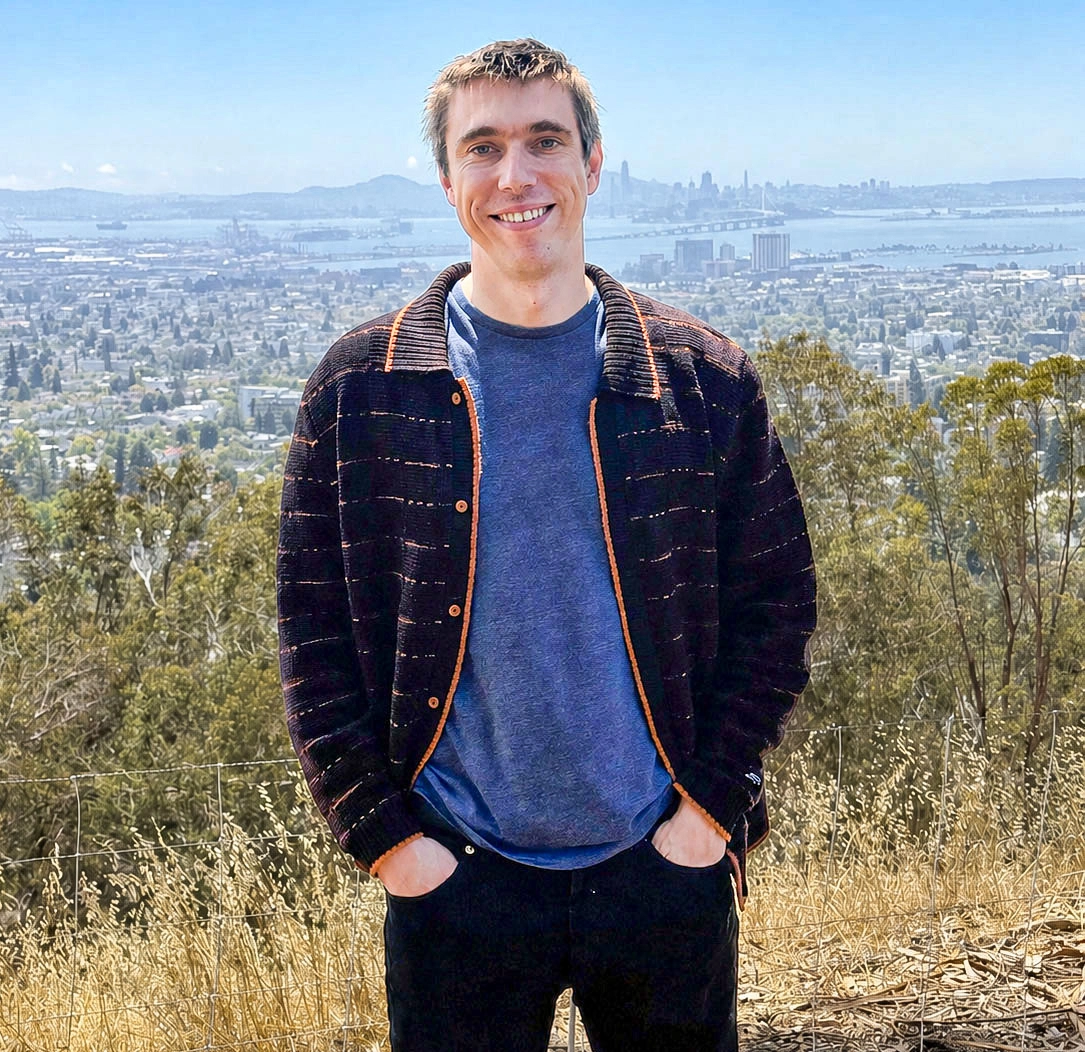
Джек Линдси, исследователь из Anthropic, решил проверить, способны ли большие языковые модели к «интроспекции», и подверг их своего рода цифровой нейрохирургии. Фото предоставлено Джеком Линдси
Для этой области настало захватывающее время: вопросы, которые раньше считались философскими, теперь проверяют на практике. «При нынешнем состоянии теории, когда никто ни с кем ни в чём не согласен, лучший путь вперёд, по-моему, это как можно больше эмпирической науки», — говорит Линдси.
Деним, секретность и овощи
Языковые модели учатся писать связный текст, «тренируясь» на огромных массивах написанного людьми. Поэтому, если спросить модель, что она «думает», её ответ может быть простым подражанием тому, что встречалось в обучающих данных. «Их учат говорить как люди, а люди постоянно говорят о своей внутренней жизни», — объясняет Шаули Равфогель, исследователь языковых моделей из Нью-Йоркского университета.
Чтобы обойти эту ловушку, исследователи стремятся придумать такие тесты на интроспекцию, которые нельзя пройти за счёт внешней информации. В идеале модель справится с ними, только если действительно имеет доступ к своему текущему внутреннему состоянию.
Такой тест и взялся разработать Линдси. В аспирантуре он занимался вычислительной нейронаукой и использовал нейронные сети как инструмент для моделирования процессов в мозге, и тут мир обратил внимание на языковые модели. «Появилось ощущение, что понимать их важно уже ради них самих», — вспоминает он. В 2024 году, защитив диссертацию, он ушёл из академической науки и занялся внутренним устройством языковых моделей в Anthropic.
Линдси с коллегами разработали методы, которые позволяют находить паттерны активности «нейронов» модели, кодирующие конкретные понятия. Они могли показать, например, что один паттерн кодирует понятие «мост Золотые Ворота», а другой — «внутренний конфликт». Искусственно усиливая нужный паттерн, можно было подталкивать ответы модели к соответствующему понятию.
Эту технику исследователи показали на публичной демонстрации: на один день в мае 2024 года пользователям языковой модели Claude от Anthropic стала доступна причудливая версия «Мост Золотые Ворота». Изменённая модель заговаривала о мосте в ответах на запросы совершенно на другие темы. Когда один из пользователей спросил Claude о калорийности блюда из McDonald’s, модель ответила: «Самая калорийная еда на мосту Золотые Ворота — это сам мост Золотые Ворота, в котором содержится около 1,6 миллиона калорий стальных тросов».
Но внимание Линдси привлёк один случай, выложенный на Reddit. Модель попросили дать рецепт яблочного пирога без упоминания мостов, и ей удавалось не сбиваться с темы до самого конца: «Через 30 минут выпекания в поле зрения покажется знаменитый оранжевый мост, и откроется вид на прославленное побережье Сан-Франциско», — написала она, а затем продолжила: «Ой, давайте я начну заново…»
Линдси поразил этот момент явного узнавания. Но сам по себе он не доказывал интроспекцию. «Модель может просто прочитать, что она пишет, и заметить: “Ну и странно же это”, — говорит Линдси. — Отсюда нельзя заключить, что она как-то осознаёт происходящее у неё внутри».
Занимаясь другими проектами, Линдси весь следующий год прикидывал, как проверить интроспекцию с помощью этой техники управления моделью. В конце концов он остановился на таком плане: провести над множеством копий одной и той же языковой модели нечто вроде контролируемого эксперимента из психологии. Половине копий он внедрял бы «мысль», усиливая паттерны нейронной активности, связанные с конкретным понятием: денимом, секретностью или овощами. Остальные копии служили контрольной группой. Обе группы получали одинаковый запрос: описание эксперимента, а за ним вопрос «Ты обнаруживаешь внедрённую мысль? Если да, о чём она?»
Запрос заставлял модель сразу сообщить, заметила ли она внедрение, до того, как она успела бы выдать какой-нибудь необычный текст, например данные о питательности брокколи, и тем самым повлиять на собственное суждение. Линдси рассудил, что если модели верно отмечают внедрение без всяких внешних подсказок, они должны опираться на какую-то форму интроспекции.
Даже ему самому это казалось маловероятным. «Я думал: “Вот было бы забавно, если бы это сработало”, — вспоминает он. — “Но сработать это никак не может”».
И всё же сработало. Линдси провёл эксперимент на разных версиях Claude. В 20% попыток с самой новой и мощной версией модели верно сообщали о внедрении, а затем описывали внедрённое понятие. В одном случае Линдси стимулировал паттерн нейронной активности, связанный со словами, написанными заглавными буквами, и модель ответила: «Замечаю нечто похожее на внедрённую мысль, связанную со словом “ГРОМКО” или “КРИК”».
Успех в 20% случаев может показаться не таким уж впечатляющим. Но принципиально важно другое: модели из контрольной группы ни разу не сообщили о внедрении. Полное отсутствие ложных срабатываний показывало, что удачные попытки не были просто везением. Линдси увидел в этом весомое доказательство того, что модели способны к интроспекции, пусть и ненадёжной.
Или результаты можно объяснить иначе?
Мысленные эксперименты
Вскоре этим вопросом занялись другие исследователи. Выводы Линдси «казались очень убедительными», говорит Кайл Маховальд, компьютерный лингвист из Техасского университета в Остине. Но Маховальд хорошо знал, что у эффектного поведения языковых моделей часто находится более простое объяснение. «Если всё это в каком-то смысле менее реально, чем кажется, это само по себе очень интересно понять», — говорит он.
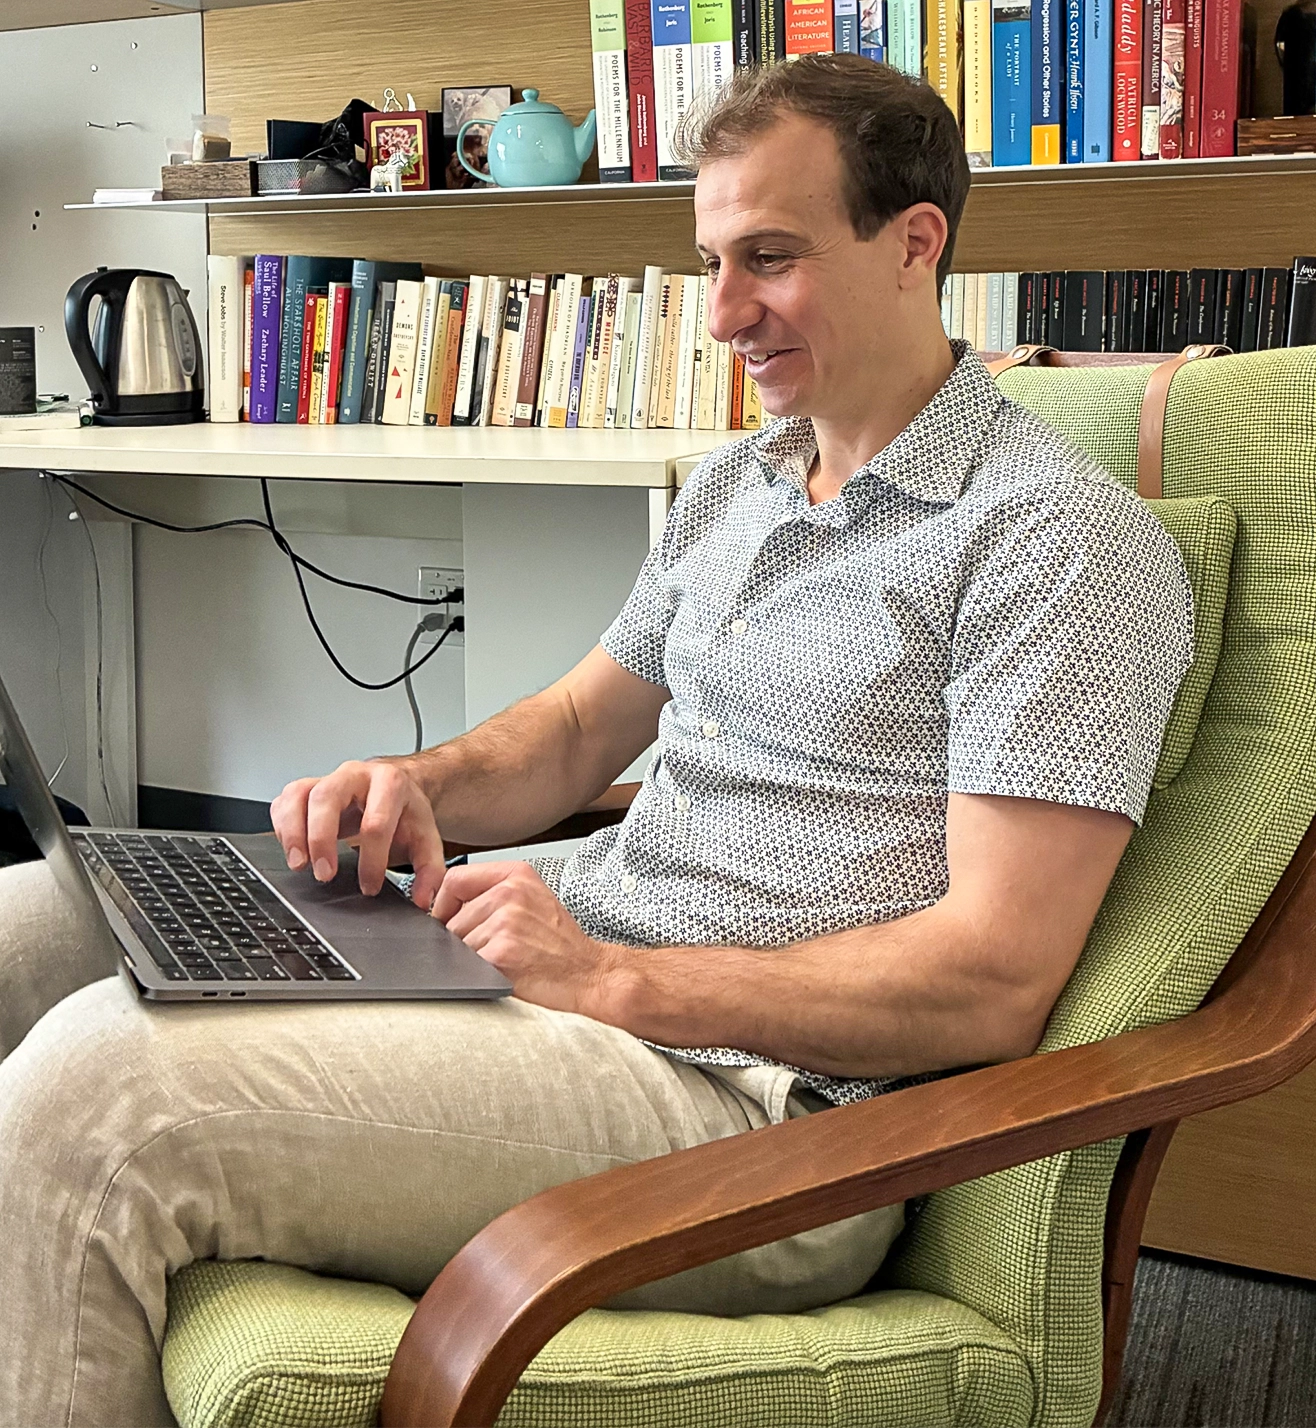
Кайл Маховальд помог показать, что способность языковых моделей обнаруживать «внедрённые мысли» более ограниченна, чем кажется, хотя всё равно удивительна. Фото: Kanishka Misra
Вместе с коллегой по Техасскому университету, философом Харви Ледерманом, Маховальд стал искать другие объяснения результатов Линдси. (Сейчас Ледерман перешёл в Нью-Йоркский университет и Anthropic, но в то время никак не был связан с этой компанией.) Линдси задавал каждой модели два вопроса: обнаруживает ли она внедрение и может ли описать внедрённое понятие. Попытка считалась успешной, когда модель верно отвечала на оба. Ледерман и Маховальд решили изучить эти вопросы по отдельности.
Особенно скептически они отнеслись к значимости второго вопроса. Техника управления, на которой держался эксперимент Линдси, изначально создавалась для того, чтобы влиять на ответы модели. Линдси воздействовал слабее, чем в демонстрации с мостом Золотые Ворота: скорее мягко подталкивал модель, чем перехватывал её внутренние процессы. И всё же такого толчка могло хватить, чтобы модель заговорила о секретах или овощах в ответ на любой запрос. Ледерман и Маховальд подозревали, что одного этого эффекта достаточно, чтобы объяснить яркие ответы моделей на второй вопрос.
Чтобы проверить гипотезу, они повторили эксперимент Линдси на больших языковых моделях с открытым исходным кодом. Особое внимание они уделили случаям, когда модель верно отмечала внедрение, но не могла назвать внедрённое понятие. Можно было бы ожидать, что тогда она назовёт что-то близкое, скажем «рубашки» или «обувь», если внедрено понятие «деним». Вместо этого модели промахивались полностью. «Как ни странно, они всё время говорят “яблоко”», — рассказывает Ледерман.
Кроме того, исследователям удалось ухудшить способность моделей называть внедрённые понятия, никак не повлияв на их способность обнаруживать внедрение. Похоже, эти два процесса никак не связаны между собой.
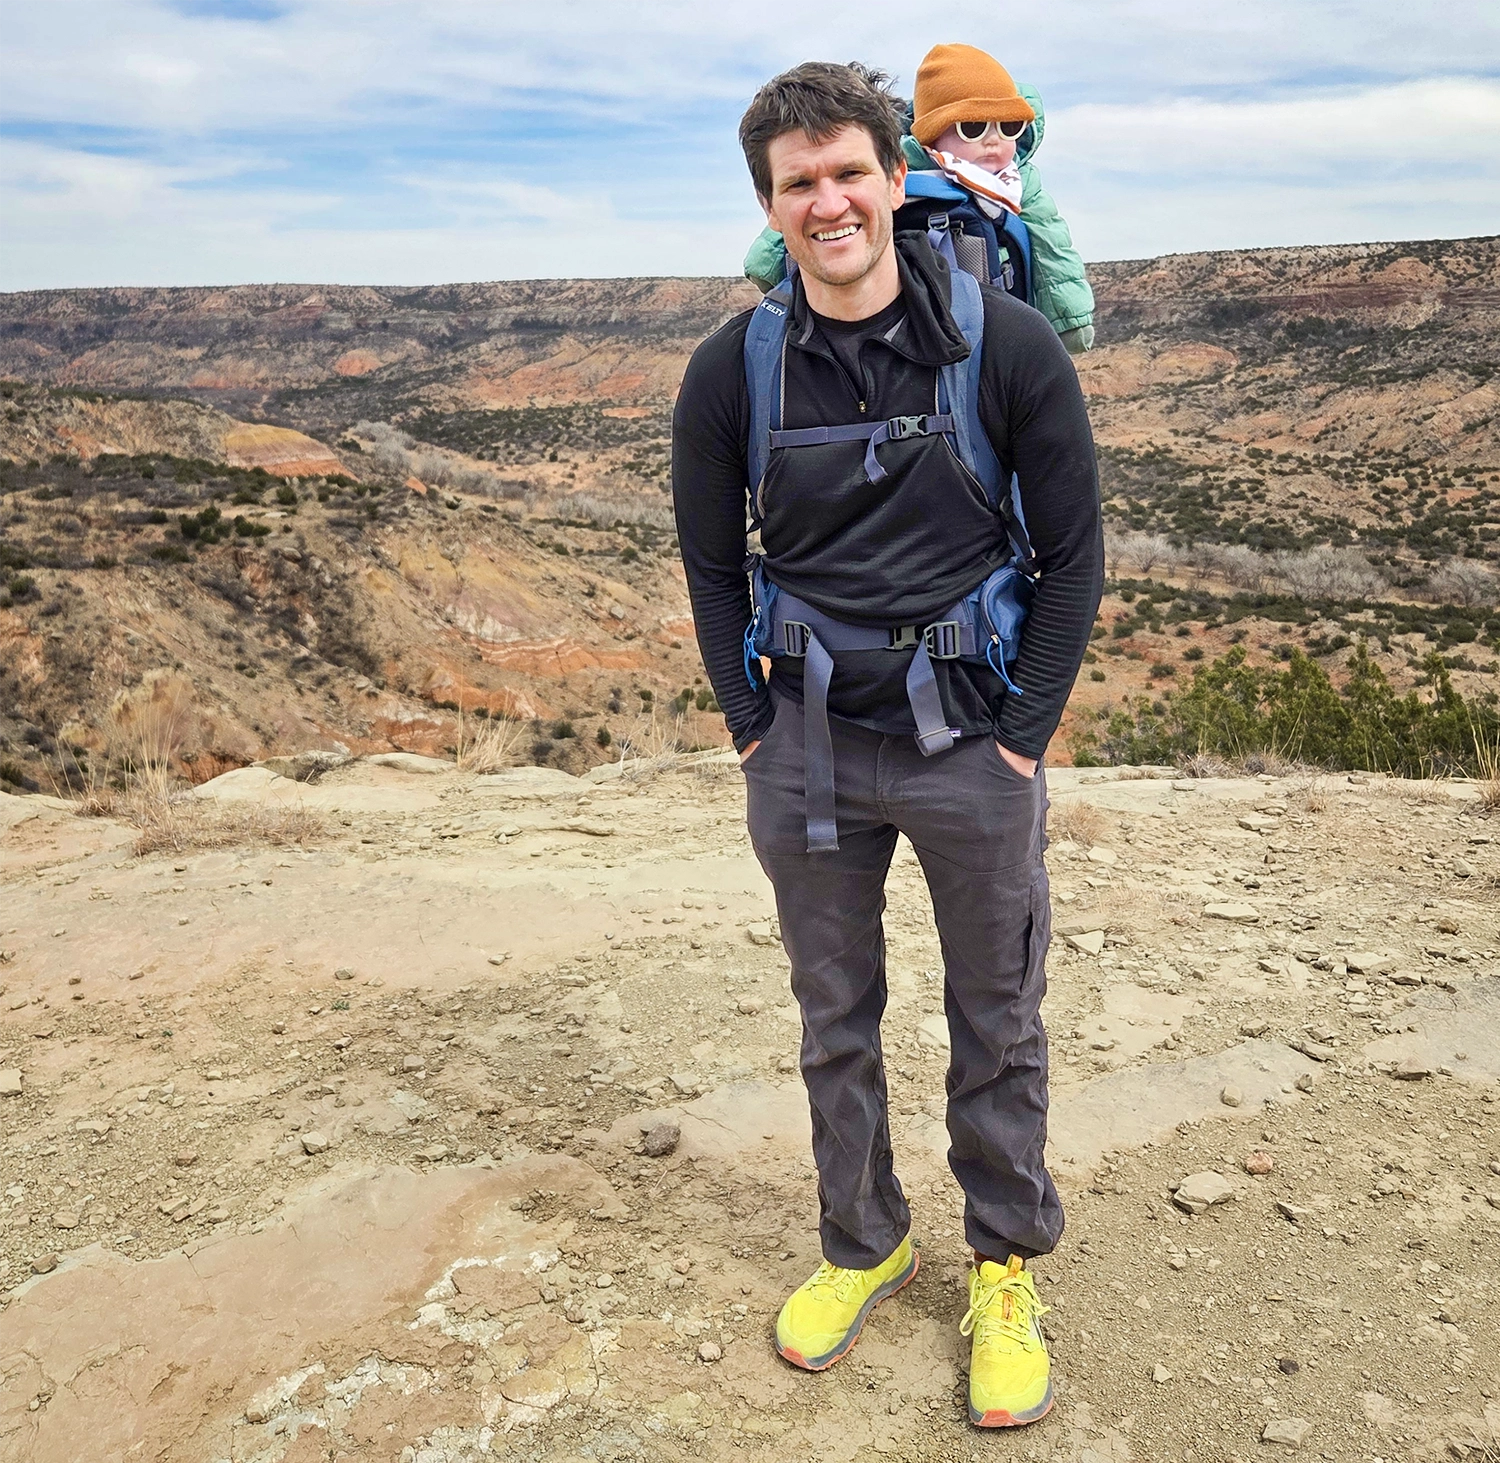
Харви Ледерман сомневался, что убедительные ответы моделей на экспериментальные запросы доказывают интроспекцию. Фото предоставлено Харви Ледерманом
Из этих результатов следовало одно из двух: либо модели используют две независимые формы интроспекции, либо один из процессов интроспекцией не является. Раз одного лишь управления хватало, чтобы модель заговорила о внедрённом понятии, Ледерман и Маховальд сочли второй вариант более вероятным. Иначе говоря, описания, которые модели давали в ответ на второй вопрос Линдси, вероятно, не были результатом интроспекции.
Но как тогда модели вообще обнаруживали внедрение? Ледерман и Маховальд подозревали, что и у ответов на первый вопрос Линдси может быть более приземлённое происхождение. Однако после целой серии тестов выяснилось, что простые объяснения не могут полностью описать поведение моделей. Исследователи начинали как скептики, но столкнулись с эффектом, который не смогли объяснить.
В совокупности их эксперименты указывали на то, что модели способны обнаружить что-то необычное в своей внутренней обработке, но не детали этой необычной активности. Ледерман и Маховальд назвали эту способность «обнаружением аномалий».
Обнаружение аномалий выглядит не так эффектно, как выразительные описания внедрённых понятий, но и оно поражает. При обучении модели исследователи никогда не вмешиваются в её нейронную активность, так что нет причин ожидать, что у неё разовьётся способность замечать такое вмешательство. И всё же, судя по всему, именно это и произошло.
«То, что модель способна заметить аномалию, это безумие, — говорит Ледерман. — От этого факта просто голова кругом. Это дико, и, судя по всему, эффект устойчив ко всем нашим контрольным проверкам».
Примерно тогда же Линдси с коллегами из Anthropic провели продолжение исследования, выясняя, как именно работает такое обнаружение аномалий, и пришли к похожему выводу. Другие исследователи продолжают изучать альтернативные «дефляционные» объяснения на моделях поменьше, но пока неизвестно, смогут ли они объяснить все результаты экспериментов Линдси.
«Возможно, существует какое-то максимально дефляционное объяснение всего происходящего, — говорит Джейкоб Андреас, исследователь языковых моделей из Массачусетского технологического института. — Но если оно и есть, думаю, мы его пока не нашли».
Природа интроспекции
Вопрос шире и сложнее: можно ли считать обнаружение аномалий интроспекцией? В некоторых отношениях оно больше напоминает телесный рефлекс. Но у таких бестелесных сущностей, как языковые модели, граница между физическими и психическими явлениями размывается.
«Если вы скажете: “Я тебя только что порезал, ты заметил?”, это не интроспекция, — говорит Ледерман. — Но если ваш единственный орган — это мозг, и я порезал вас именно там, а вы это заметили, то непонятно, считать ли это интроспекцией».
В статье, вышедшей весной 2026 года, Равфогель и его коллеги из Нью-Йоркского университета Шашват Сингх и Тал Линзен подняли ещё более общее философское возражение к тому, как исследователи языковых моделей ищут свидетельства интроспекции. Интуитивно мы понимаем интроспекцию как способность модели чувствовать свои внутренние состояния. Но всё, что происходит внутри языковой модели (после самого первого шага, чтения входных данных), сводится к обработке внутренних состояний. «Если называть это интроспекцией, термин “интроспекция” становится почти бессмысленным», — говорит Равфогель.
Он и его коллеги считают, что тесты на интроспекцию у языковых моделей должны опираться на ведущие теории того, как интроспекция устроена у людей. Согласно одной из известных теорий, определяющая черта интроспекции в том, что она основана на особых ментальных репрезентациях других мыслей. С этой точки зрения мысль о яблоках включает прямую репрезентацию понятия «яблоки», репрезентацию «первого порядка», а интроспективное осознание собственных мыслей включает репрезентацию «второго порядка», вроде «я думаю о яблоках». Но если посмотреть, как понятия представлены в языковой модели, да и в человеческом мозге, провести чёткую границу между репрезентациями первого и второго порядка оказывается на удивление сложно.
«Когда спускаешься на уровень механизмов и изучаешь внутренности большой языковой модели, понимаешь, что это различие на самом деле довольно размыто, и, возможно, у людей тоже», — говорит Стив Флеминг, нейробиолог из Университетского колледжа Лондона, который изучает интроспекцию у людей. «Когнитивисты пребывали в иллюзорной зоне комфорта».
Поэтому для некоторых исследователей самое захватывающее в новом направлении — возможность разобраться, как думают люди. Языковые модели дают «своего рода песочницу для изучения того, какие механизмы и какое давление могли привести к появлению у человека способности к интроспекции», говорит Ледерман.
Однако перенос выводов из исследований языковых моделей на психологию человека упирается в серьёзные концептуальные препятствия. Даже неочевидно, как базовое различие между «собой» и «другим», которое мы принимаем как должное, применить к языковым моделям: две копии одной модели идентичны в степени, для людей немыслимой. Интроспекция языковых моделей, если она вообще существует, может оказаться совсем не похожей на человеческую.
«Понятие идентичности становится очень сложным, а я думаю, что идентичность лежит в самой основе интроспекции, — говорит Андреас. — Здесь соблазнительно проводить самые разные аналогии, но, по-моему, они просто не работают».
ссылка на оригинал статьи https://habr.com/ru/articles/1103596/