«Внедрим ИИ, и через полгода половина команды не понадобится». Такую установку я встречаю у руководителей чаще, чем хотелось бы. Картинка у них простая: агент получает задачу одним промптом, пишет код, сам его тестирует и выкатывает, а людям остаётся нажать Merge.
На практике ИИ — не волшебная палочка, а ещё один инструмент, быстрый и мощный. Его нужно настроить под проект, дать ему контекст и проверять каждый результат. Без этого команда с каждым багом на проде переписывает куски системы, плодит новые баги, и так по кругу.
В прошлой статье «ИИ раздали — пользоваться не научили» я разбирал, почему ИИ не окупается, если раздать его командам и ничего больше не менять. В этой покажу, как работаю по спецификациям (SDD) с OpenSpec, какой контекст и какие скиллы нужны агенту и почему без людей с компетенциями всё это не взлетает. Пишу для разработчиков и лидов, которые настраивают процесс, и для руководителей, которые решают, как внедрять ИИ.
Демо и реальная задача
Руководители чаще всего видят ИИ на демо. За пять минут агент собирает CRUD или ускоряет SQL-запрос. У таких задач нет истории, и понятно, как выглядит правильный результат.
В реальной задаче вы меняете живую систему с интеграциями и правилами, которые часто нигде не записаны. Агент не знает, зачем здесь эта проверка и какой клиент читает это поле. Недостающее он достраивает сам, и код получается правдоподобным, но не обязательно верным.
В опросе Stack Overflow 2025 84% разработчиков используют ИИ или собираются начать, но точности его ответов доверяют 33%, а не доверяют 46%. Чаще всего (66%) жалуются на решения, которые почти правильные, но не совсем, а 45% говорят, что отлаживать сгенерированный код дольше. Авторы отчёта DORA 2025 называют ИИ усилителем: у сильных команд он усиливает сильные стороны, а у слабых их проблемы.
Поэтому предлагаю руководителям простой тест. Прежде чем планировать сокращения, сделайте с ИИ одну свою реальную задачу целиком, а не «оптимизируй запрос»: спроектируйте фичу, опишите требования, получите код, проверьте его и доведите до прода. Через пару дней станет видно, что ИИ ускоряет разработку и аналитику, а решать, правильно ли сделано, всё равно приходится вам. И это не быстрый процесс, приходится полностью погружаться в детали задачи.
Работа по спецификациям (SDD)
Spec-driven development — это когда сначала пишется спецификация, а код выводится из неё и проверяется против неё. Для работы с агентом это главное: агент генерирует ровно по тому, что ему дали. Однострочный тикет он додумает сам, а по полной спецификации с ограничениями и краевыми случаями работает в заданных рамках.
В сентябре 2025 года GitHub выложил в открытый доступ Spec Kit: шаблоны и CLI для цикла «спецификация → технический план → мелкие задачи → реализация». Его ведущий мейнтейнер Манфред Рим сравнил агента со стажёром, очень способным и очень быстрым, но всё-таки стажёром. А стажёру нужны чёткое ТЗ и наставник.
OpenSpec: из чего состоит
Я работаю с OpenSpec, лёгким фреймворком для SDD. Спецификации лежат в репозитории рядом с кодом в обычном Markdown, а агент работает с ними через slash-команды. Фреймворк поддерживает 30 с лишним инструментов, в том числе Claude Code, Cursor и GitHub Copilot. В папке openspec/ три части:
-
specs/: источник правды, как система работает сейчас, по доменам (orders/spec.md,payments/spec.md); -
changes/: предлагаемые изменения, по папке на каждое. Внутриproposal.md(зачем и что меняем),design.md(как),tasks.md(чек-лист реализации) иspecs/с дельтами требований; -
config.yaml: контекст проекта и правила, которые OpenSpec подставляет агенту при создании артефактов.
Требования пишутся на Markdown с ключевыми словами SHALL/MUST и сценариями GIVEN/WHEN/THEN. Дельта для фичи частичного возврата выглядит так:
## ADDED Requirements### Requirement: Частичный возвратСистема SHALL позволять вернуть часть оплаченной суммы заказа.Сумма всех возвратов по заказу MUST NOT превышать оплаченную сумму.#### Scenario: Возврат в пределах оплаты- GIVEN заказ оплачен на 10 000 ₽, возвратов по нему не было- WHEN менеджер оформляет возврат на 3 000 ₽- THEN создаётся возврат на 3 000 ₽- AND к возврату остаётся доступно 7 000 ₽#### Scenario: Сумма больше доступной- GIVEN по заказу на 10 000 ₽ уже вернули 8 000 ₽- WHEN менеджер пытается вернуть ещё 3 000 ₽- THEN возврат отклоняется с ошибкой «сумма превышает доступную»#### Scenario: Повторный запрос- GIVEN возврат уже создан с ключом идемпотентности K- WHEN приходит повторный запрос с тем же ключом K- THEN второй возврат не создаётся, клиент получает первый результат
Фича проходит цикл из трёх команд:
-
/opsx:propose add-partial-refund: агент создаёт папку изменения с proposal, дельтами спецификаций, design и tasks. На этом шаге вы ревьюите план, пока не написано ни строки кода. -
/opsx:apply: агент реализует задачи изtasks.mdи отмечает выполненные. -
/opsx:archive: изменение уходит в архив, а дельты вливаются в основные спецификации вspecs/.
Требования и план живут в репозитории, их читают и люди, и агент, а план вы проверяете до кода. После архивации specs/ снова описывает текущее поведение системы, и следующая задача стартует с актуальной картины. Если задача пока не ясна, перед propose варианты можно обсудить с агентом через /opsx:explore.
Контекст проекта для агента
Агент каждый раз приходит в проект как новичок в первый день. Человек за полгода впитывает контекст на созвонах и ревью, а агент знает только то, что записано. Спецификации описывают поведение системы, но этого мало, поэтому живой проект нужно описать для агента целиком:
-
контекст системы: что это за продукт, для кого он и где его границы;
-
бизнес-процессы: как идут заказ, оплата и возврат, кто участвует на каждом шаге;
-
пайплайны: CI/CD, фоновые джобы и интеграции, что и в каком порядке запускается;
-
бизнес-логика и инварианты: правила, которые нельзя нарушать ни при каком рефакторинге или оптимизации;
-
глоссарий: термины домена и их имена в коде.
Инварианты недооценивают чаще всего. Вы просите агента ускорить обработку возвратов, и он убирает «лишнее» повторное чтение из базы. Тесты зелёные, а при параллельных запросах клиент получает денег больше, чем заплатил. Агент сделал ровно то, что просили: что это чтение защищает правило, ему никто не сказал.
Глоссарий нужен по той же причине. Аналитик пишет в задаче «отмена», в коде есть Refund, Reversal и Cancellation, и без словаря агент выберет наугад. Когда термины описаны, новая задача ложится на правильные сущности.
Удобнее всего держать это в репозитории рядом с кодом, например так:
openspec/ config.yaml # стек, соглашения, ссылки на docs/context specs/ # как система работает сейчас, по доменам changes/ # изменения: proposal, design, tasks, дельты спекdocs/ context/ overview.md # что за система, для кого, границы business-processes.md # оформление, оплата, возврат по шагам invariants.md # что нельзя нарушать ни при какой оптимизации glossary.md # термины домена и их имена в коде pipelines.md # CI/CD, джобы, интеграции decisions/ # ADR: почему сделано так, а не иначеAGENTS.md / CLAUDE.md # правила для агента и ссылки на всё, что выше
И фрагмент invariants.md:
# Инварианты домена «Заказы»- Сумма всех возвратов по заказу ≤ оплаченной сумме. Проверка живёт в домене под блокировкой заказа, а не только в API.- Статус заказа меняется только через OrderStateMachine. Прямой UPDATE status запрещён.- Деньги — целые числа в копейках. Никаких float.- Повтор запроса с тем же Idempotency-Key возвращает первый результат.
Короткую выжимку (стек, соглашения, где лежит контекст) удобно положить в поле context файла openspec/config.yaml. OpenSpec подставляет его агенту при создании каждого артефакта.
Контекст надо поддерживать. Поменялся процесс, обновите файл, иначе агент будет работать по устаревшей картине. Обновление контекста стоит включить в Definition of Done наравне с тестами.
Скиллы и обвязка
Спецификация и контекст говорят агенту, что делать. Скиллы описывают, как это делается у вас: как пишется миграция, как ревьюится PR. Это переиспользуемые инструкции для агента, и писать их приходится под свой стек и свой стиль.
Первый фильтр ревью тоже можно отдать агенту, если дать ему чек-лист против спецификации. На просьбу «посмотри, всё ли нормально» он обычно отвечает, что всё нормально. Пример скилла:
---name: review-against-specdescription: Ревью PR на соответствие изменению в OpenSpec---1. Найди изменение в openspec/changes/: proposal, design, tasks и дельты спек.2. Для каждого сценария из дельт проверь, что код его реализует и что на него есть тест.3. Проверь, что ни один инвариант из docs/context/invariants.md не ослаблен.4. Найди новые зависимости и дубли утилит из /shared.5. Проверь, что тесты падают, если сломать бизнес-правило.6. Выдай список расхождений с файлом и строкой. Ничего не исправляй сам.
Такой скилл снимает с ревьюера рутину, и человек смотрит на суть: решает ли код задачу и не сломается ли он на стыках. Последнее слово на ревью остаётся за человеком.
Скиллы и правила сопровождают так же, как код:
-
Агент ошибся, или баг дошёл до прода.
-
Разбираем причину: не хватило контекста, правила или проверки в скилле?
-
Дописываем недостающее и прогоняем это изменение через ревью, как обычный PR.
-
Следующая задача идёт уже по обновлённым правилам.
Если поправить только код, агент повторит ту же ошибку в следующей фиче.
Люди, которые проверяют за ИИ
Спецификации и скиллы людей не заменяют. Чтобы отличить «почти правильно» от «правильно», нужны компетенции и насмотренность: знание домена и типичных ошибок. Джун видит код, который компилируется и проходит тесты. Опытный разработчик видит в том же коде гонку или нарушенный инвариант.
Контролируйте, как сотрудники пользуются ИИ
Смотреть стоит на одно: не стал ли человек прокладкой между тикетом и агентом. Если сотрудник пересылает задачу агенту, а результат отправляет на ревью не читая, толку от него нет. Вся проверка переезжает на лида, и он становится узким горлом.
Нужен наставник
На время внедрения нужен человек, который уже прошёл этот путь или обучение: лид или наставник с опытом SDD. Его задачи:
-
настроить правила, контекст и скиллы под проект;
-
научить команду писать спецификации и ревьюить ИИ-код;
-
смотреть, как люди пользуются инструментом, и поправлять;
-
следить за метриками и вовремя замечать, что качество поплыло.
В прошлой статье я сравнивал эту роль со скрам-мастером: она временная, но без неё методология растворяется в «у нас же есть Cursor».
Антипаттерн «один человек — четыре роли»
Некоторые компании в погоне за ИИ отдают одному сотруднику сразу четыре роли: бизнес-аналитика, системного аналитика, разработчика и тестировщика. Логика понятна: «код пишет ИИ, человеку остаётся поставить задачу». Часто этим человеком становится бизнес-аналитик, который не знает основ языка и не проходил обучение работе по SDD. Что из этого получится, думаю, объяснять не надо.
Каждая роль проверяет работу остальных. Если склеить их в одного человека без обучения, проверки исчезают, а ошибки всех четырёх ролей копятся в одной голове:
|
Роль |
Что проверяет |
Что теряется, если роль формальная |
|---|---|---|
|
Бизнес-аналитик |
Что нужно бизнесу и зачем |
Спецификация описывает не ту проблему |
|
Системный аналитик |
Как фича ложится в систему, контракты и интеграции |
Контракт расходится с реальностью, ломаются смежные системы |
|
Разработчик |
Как реализовать и сопровождать |
Код, который никто не понимает и не может починить |
|
Тестировщик |
Работает ли это на самом деле |
Тесты подтверждают код, а не требования |
Сделать «человеком-оркестром» разработчика, скорее всего, лучше: он хотя бы может проверить код. Но если у него нет soft skills и он не учился аналитике, то есть не умеет проводить интервью с заказчиком и описывать требования, спецификация выйдет слабой. А слабую спецификацию ИИ реализует так же быстро, как хорошую.
Если роли всё-таки объединяют, то только с обучением недостающим навыкам и внешней проверкой: ревью другим человеком и отдельным тестированием критичных сценариев. Без этого сэкономленное на штате уходит на исправление багов на проде.
Петля деградации
Без процесса вокруг ИИ команда попадает в петлю. Задачу отдают агенту одним промптом, код выглядит правильно, ревью проходит по диагонали, и на проде вылезает баг. Чинят его так же, просьбой «перепиши модуль» без разбора причины. Новый код снова «почти правильный», и баги переезжают на стыки.
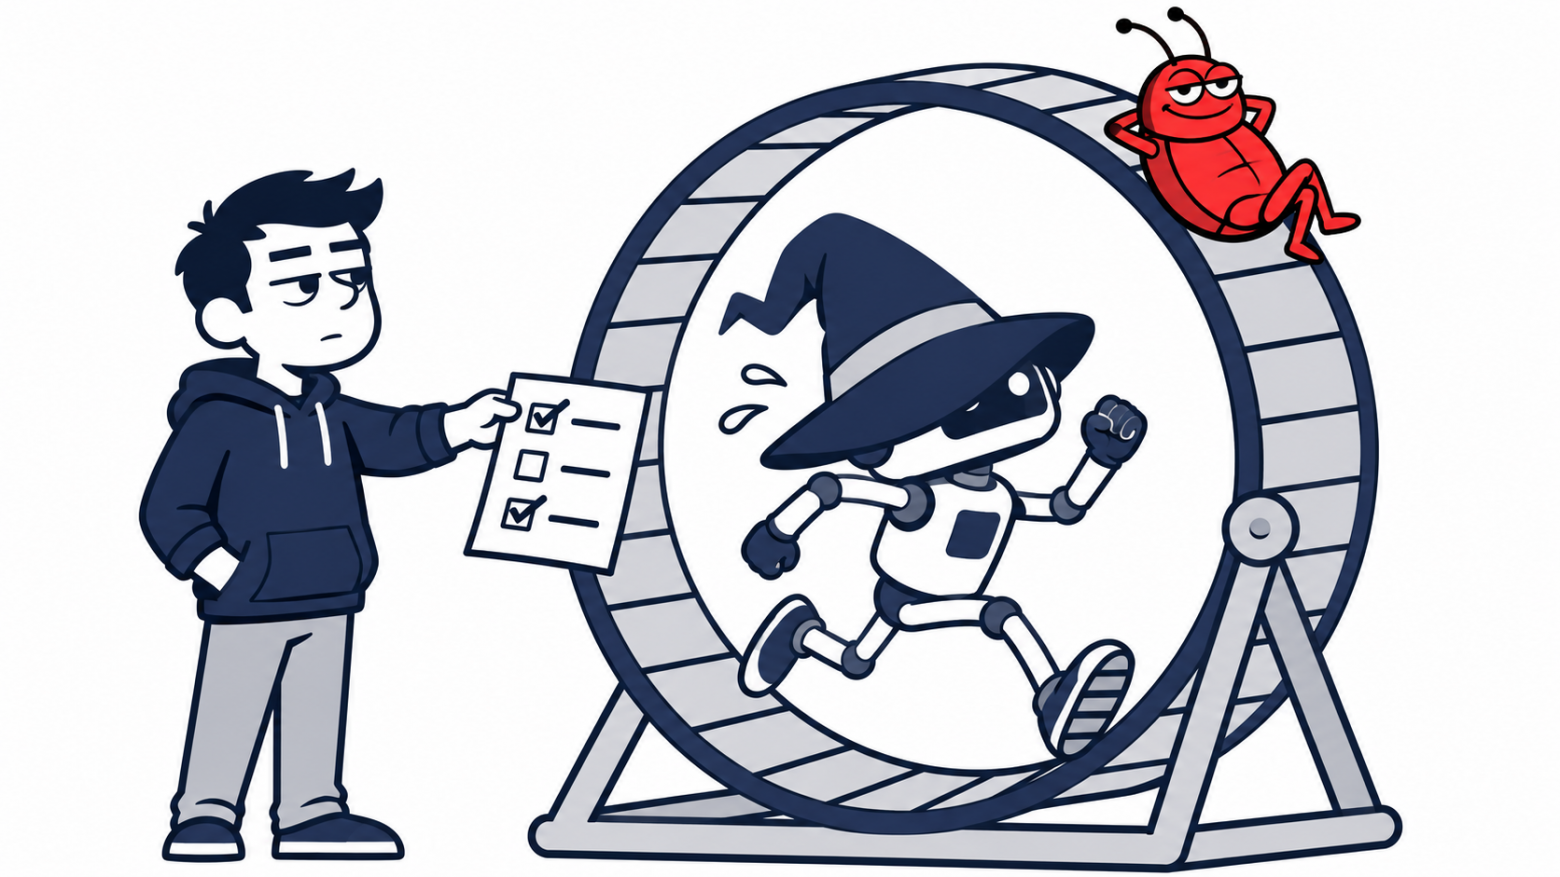
Выйти из петли можно одним способом: после каждого бага разбирать, чего не хватило, и дописывать это.
Последствия для бизнеса:
-
растут затраты: токены, ревью и тушение пожаров съедают время самых опытных людей;
-
падает качество фич, а с ним и доверие к ИИ внутри команды;
-
цели внедрения не достигнуты, и через год всё начинают с нуля, уже с более запутанной кодовой базой.
Чек-лист для руководителя и тимлида
Руководителю
-
Сделать одну свою реальную задачу целиком с ИИ, прежде чем планировать сокращения.
-
Назначить ответственного за внедрение: лида с опытом SDD или прошедшего обучение.
-
Не объединять роли без обучения недостающим навыкам и без внешней проверки.
-
Заложить время на подготовку контекста, правил и скиллов: они не приходят вместе с подпиской.
-
Мерить результат цифрами до и после: время цикла, баги на проде, долю переделок.
Тимлиду
-
Описать контекст проекта: процессы, пайплайны, инварианты, глоссарий.
-
Завести OpenSpec или другой SDD-инструмент и начинать любое изменение со спецификации.
-
Написать скиллы под свой стек: ревью против спецификации, миграции, тесты.
-
Включить обновление контекста и скиллов в Definition of Done.
-
Регулярно смотреть, как команда пользуется ИИ: саморевью PR, понимание кода, тесты на поведение.
-
После каждого бага на проде спрашивать: чего не хватило агенту и чего не хватило ревью?
Коротко
ИИ ускоряет разработку и аналитику там, где есть спецификация, описанный контекст и люди, которые умеют проверять результат. Без этого он ускоряет появление багов, и компания платит больше, чем до внедрения. ИИ — инструмент, и пользоваться им нужно учиться самому и учить команду.
А как у вас: описываете ли вы контекст проекта для агентов и кто отвечает за то, как команда пользуется ИИ? Сталкивались ли с тем, что одному человеку отдают сразу несколько ролей, и чем это закончилось?
ссылка на оригинал статьи https://habr.com/ru/articles/1103902/