В статье разберём яркий пример, когда простой запрос к субд сильно деградировал по времени выполнения после миграции с mssql на postgresql.
Проблема клиента
К нам обратился клиент: после миграции с MS SQL на Tantor Postgres 17 закрытие месяца в 1С:ERP стало занимать 8 часов вместо 12 минут.
Первым делом в таких ситуациях мы проверяем настройки Tantor Postgres, чтобы убедиться выполнены ли наши рекомендации по настройке под 1С. С ними было все ок, а также по ним мы увидели, что было настроено расширение auto_explain со сбором планов запросов длительностью более 5 сек. Если закрытие месяца тормозит из-за конкретных запросов, они наверняка окажутся в этом логе. Поэтому мы запросили логи у клиента.
Анализ логов показал, что почти 8 часов выполнялось несколько запросов обновления таблиц итогов регистра бухгалтерии: ИтогиПоСубконто2, ИтогиПоСубконто3. Все запросы имели 2 шаблона запроса и одну и ту же причину долгого выполнения. Рассмотрим план такого запроса:
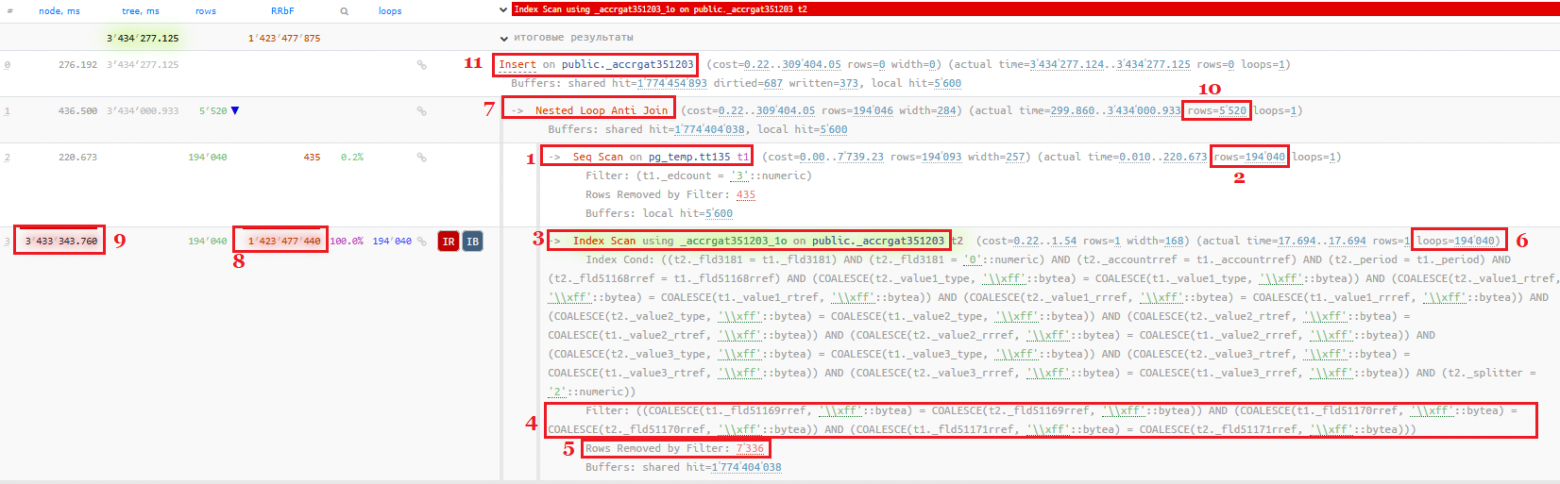
Разберем его:
-
Выбираются все записи из временной таблицы (1), которые нужно записать в таблицу итогов. Всего 194 040 записей (2)
-
Идет левое соединение с таблицей итогов по периоду, счету, измерениям и значениям субконто с целью отбросить те записи из временной таблицы, по которым уже есть записи в таблице итогов (запись в таблицу итогов состоит из 2х этапов, о них ниже). Условие WHERE T2._Period IS NULL оставляет только те записи временной таблицы, которых нет в таблице итогов.
-
Поиск соответствующих записей в таблице итогов идет через поиск по индексу accrgat3512031o (3). Но не все поля, по которым идет соединение 2х таблиц, есть в этом индексе, поэтому мы видим конструкцию Filter (4), которая фильтрует найденные записи в индексе. И за один цикл поиск отфильтровывается 7336 строк (Rows Removed by Filter: 7336), это и занимает основное время выполнения поиска в индексе (5). А так как во временной таблице 194 тысячи строк, то поиск в индексе выполняется не один раз, а 194 тысячи раз (6), т.к. соединение 2х этих таблиц идет через оператор Nested Loop (вложенные циклы) (7). Суммарно в узле index Scan через Filter отбрасывается почти полтора миллиарда строк (8), что и является причиной долгого выполнения данного узла плана запроса — 3 433 секунды (9).
-
В результате соединения этих 2 таблиц из 194 тысяч остается только 5520 строк (10), которые и вставляются в таблицу итогов (11).
Вообще запись в таблицу итогов регистра бухгалтерии состоит из 2х этапов:
-
Вставляются новые записи (INSERT) по тому периоду, счету, измерениям и значениям субконто, которых не было еще в таблице итогов — пример такого запроса мы рассмотрели выше.
-
Обновляются существующие записи (UPDATE) по тому периоду, счету, измерениям и значениям субконто, которые уже есть в таблице итогов — вот пример такого запроса. Причины долгого выполнения тут такие же как и выше — большое количество фильтруемых строк при Index Scan в цикле.
По плану запроса возникают следующие вопросы: по какой причине мы получаем такое большое количество фильтруемых строк? Быть может неожиданное распределение данных в таблицах? А может планировщик ошибся, и выбрал не самый подходящий индекс?
Но к сожалению, только план запроса не даст нам ответы на эти вопросы. Необходимо разобраться в учетной части, чтобы понять причины такого поведения.
Физическое устройство регистра бухгалтерии
Чтобы понять почему индекс не справляется, нужно разобраться в структуре таблиц итогов.
Для анализа я развернул типовую демо-базу ERP 2.5.8. Структуру регистра бухгалтерии «Хозрасчетный» можно представить так:
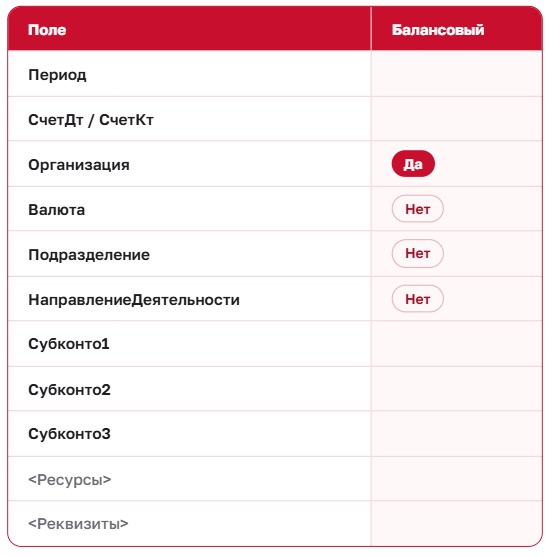
Признак балансовый=нет означает, что в в рамках одной проводки в дебете и кредите может быть разное значение измерения. Например, мы перемещаем основное средство между подразделениями в рамках одной организации (она может быть только одна, т.к. у нее признак балансовый=да).
Рассмотрим структуру таблиц итогов по субконто и их индексов.
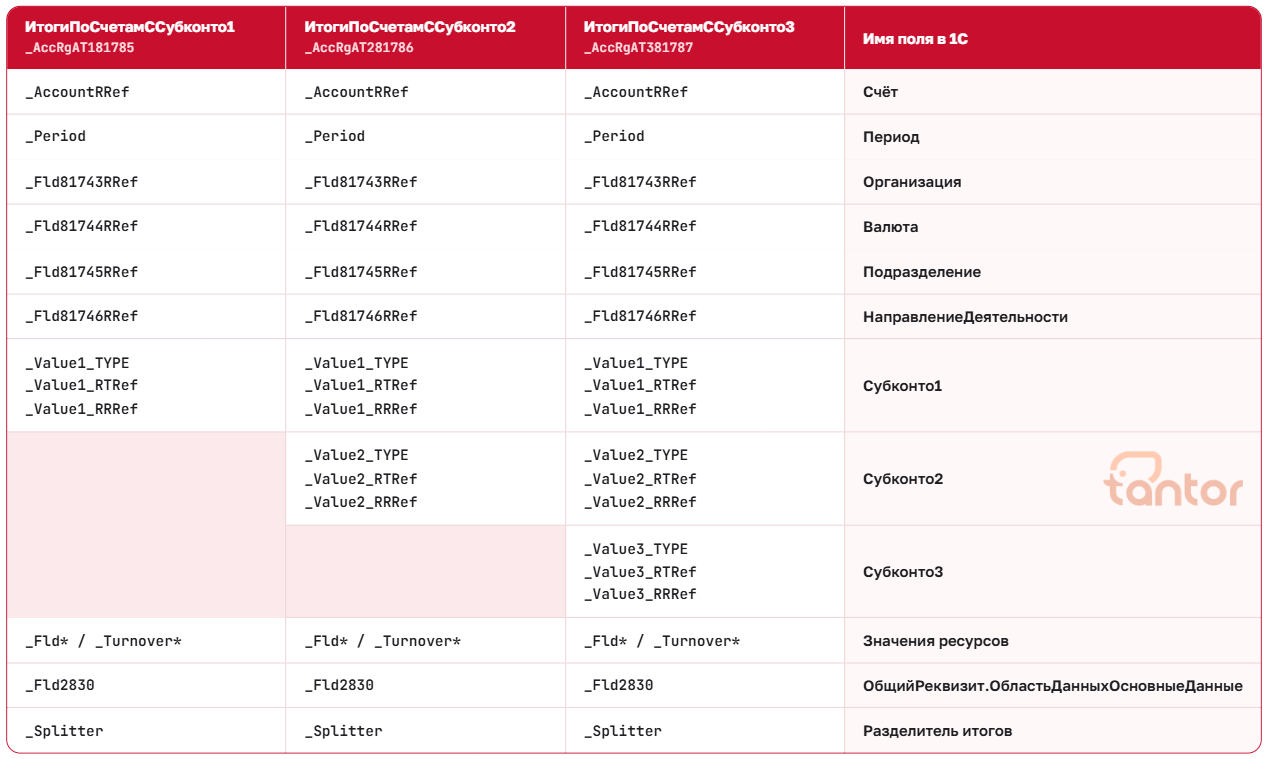
По сути состав данных регистров одинаковый, отличается только количество субконто. Структуру таблиц итогов ИтогиПоСчетам и ИтогиМеждуСчетами мы не рассматриваем, т.к. в повествовании они нам не понадобятся.
Рассмотрим индексы данных таблиц:
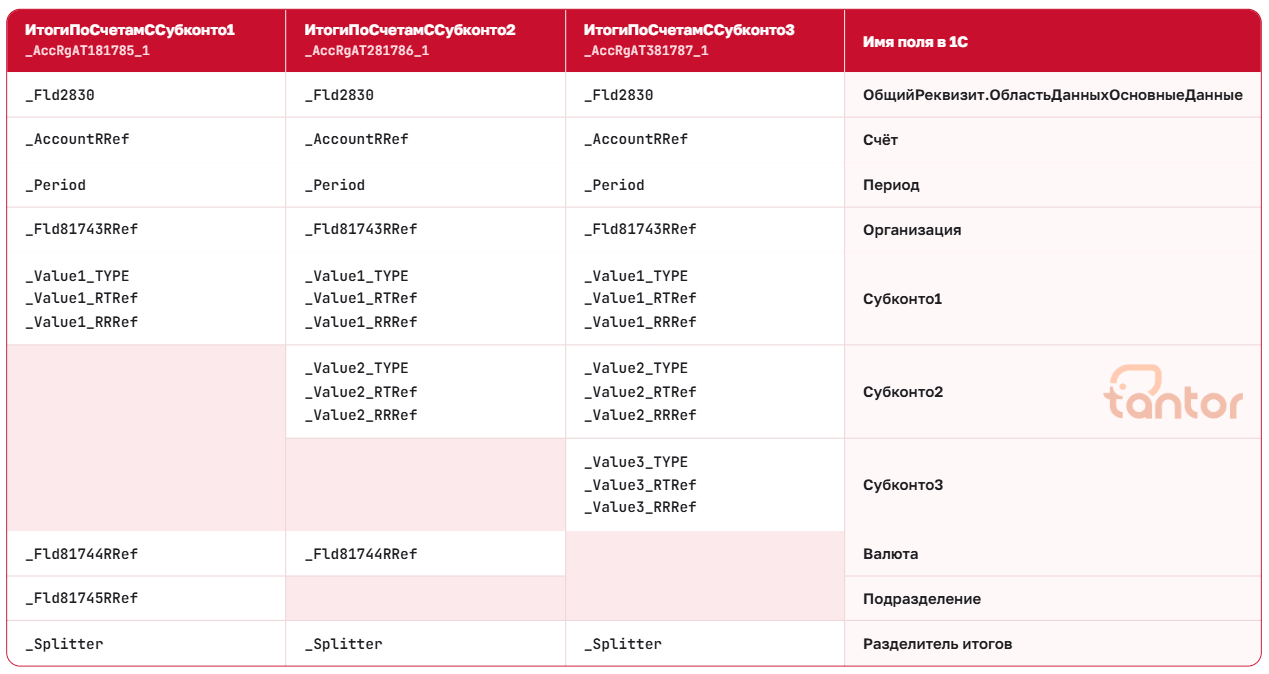
Индексы, как и таблицы, отличаются количеством субконто, но помимо этого имеют следующие различия:
Индекс таблицы ИтогиПоСчетамССубконто1 имеет в своем составе небалансовые измерения Валюта и Подразделение, индекс таблицы ИтогиПоСчетамССубконто2 только Валюту, а в индексе таблицы ИтогиПоСчетамССубконто3 вообще нет небалансовых измерений. А измерения НаправлениеДеятельности вообще нет в индексах!
Дополнение по индексам
У каждого индекса таблиц итогов по субконто есть индекс “напарник”. Например, в таблице ИтогиПоСчетамССубконто1 помимо индекса AccRgAT1817851 есть индекс AccRgAT1817851ong. Состав полей у этих индексов одинаков. Отличие в том, что по полям, у которых разрешено значение NULL, в составе индекса используется конструкция COALESCE.
Например, в индексе AccRgAT1817851 поле Подразделение задано просто как поле Fld81745RRef, а в индексе AccRgAT181785_1ong оно задано функцией COALESCE(_Fld81745RRef, ‘\xff’::bytea).
Данная функция используется как аналог функции IsNull() в MS SQL Server, то есть если переданное первым параметром значение равно Null, то берется значение второго параметра.
И здесь мне стало понятно из-за чего возникает долгое выполнение запроса у клиента: т.к. индексы таблицы итогов по субконто 2 и 3 не содержат всех небалансовых измерений, значит они как раз фильтруют строки по этим измерениям. Т.е. таблица итогов содержит примерно такие записи:
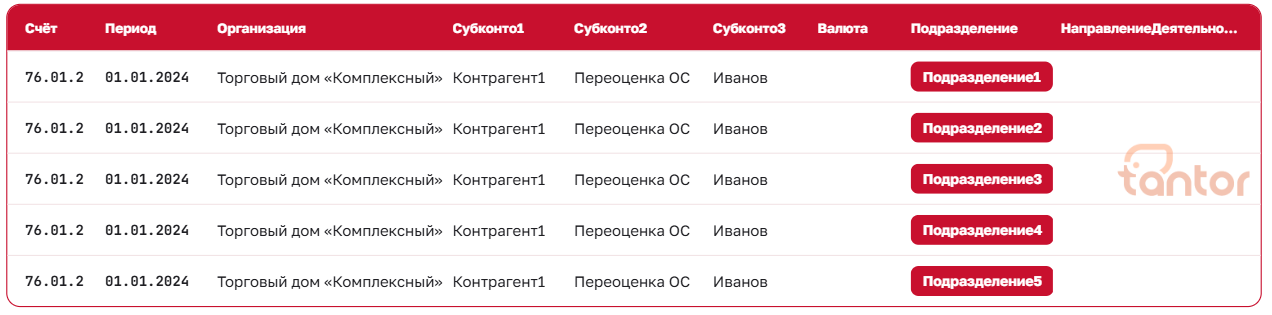
Мы видим 5 записей, у которых все поля, кроме поля Подразделение, содержат одинаковые значения. И когда мы мы хотим обновить итоги по этим всем измерениям и Подразделению «Подразделение1», то по индексу мы находим эти 5 записей, и через оператор Filter отбрасываем 4 из них, у которых Подразделение <> Подразделение1:
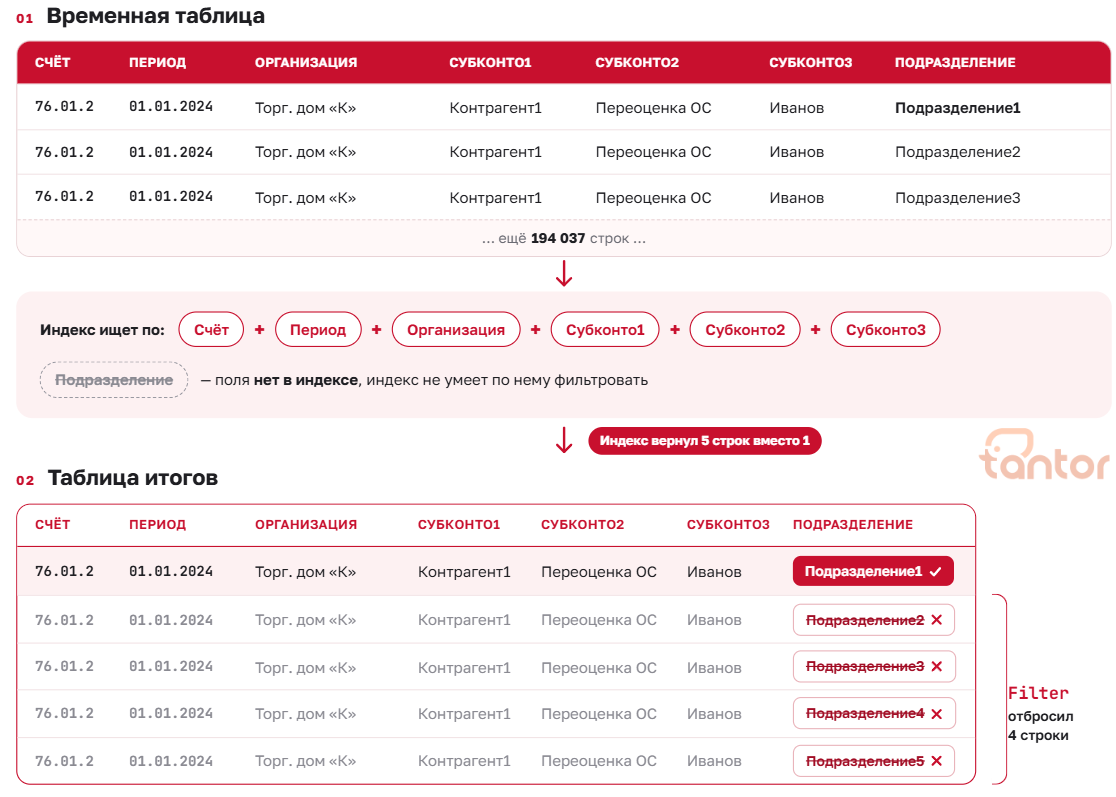
Тоже самое может быть, если разные направления деятельности.
Воспроизводим проблему на своем стенде, чтобы подтвердить правильность данных выводов.
Воспроизведение проблемы
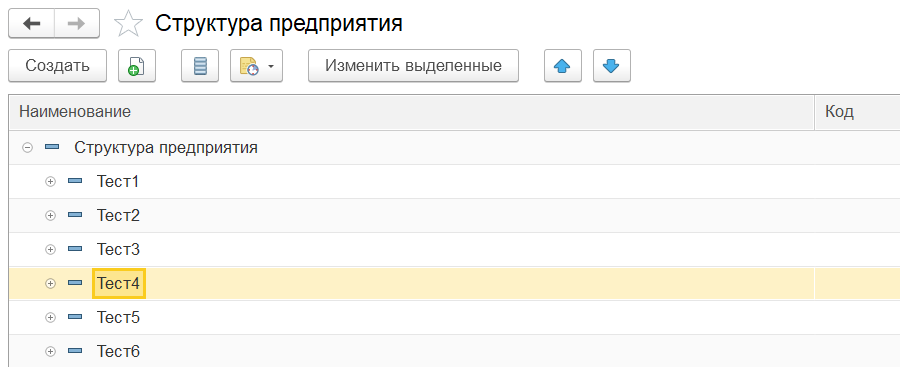
Первым шагом создадим 3 тысячи подразделений в демо-базе ERP с наименованием «ТестN»:
Далее нам нужно создать записи в таблице итогов, у которых будут все одинаковые значения, кроме подразделения. Для этого воспользуемся документом «Операция (регламентированный учет)», который позволяет создавать произвольные проводки. Генерируем в нем 3 тысячи строк через консоль кода и проводим:
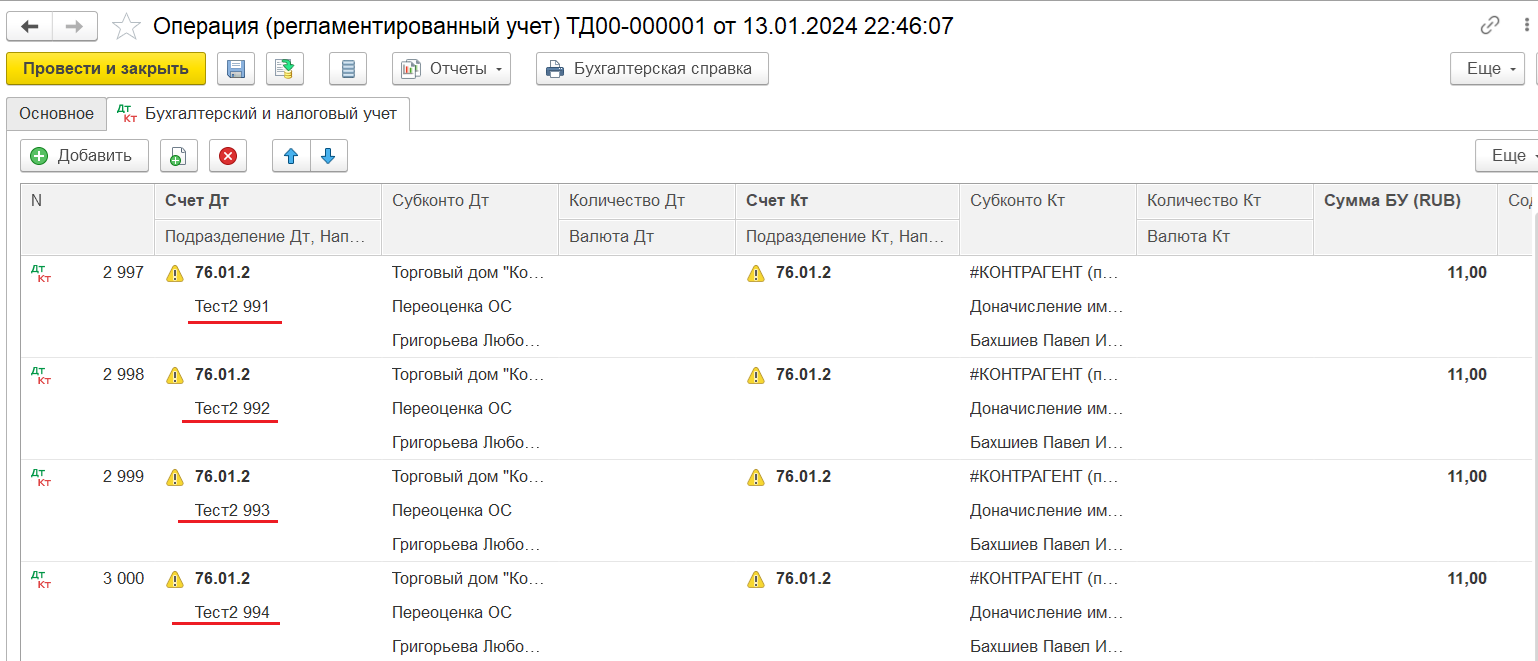
Копированием создаем такой же документ, проводим его и ищем в логе СУБД длительные запросы обновления таблиц итогов по субконто.
Проблема повторилась и у нас также идет долго обновление итогов по таблице ИтогиПоСубконто3:
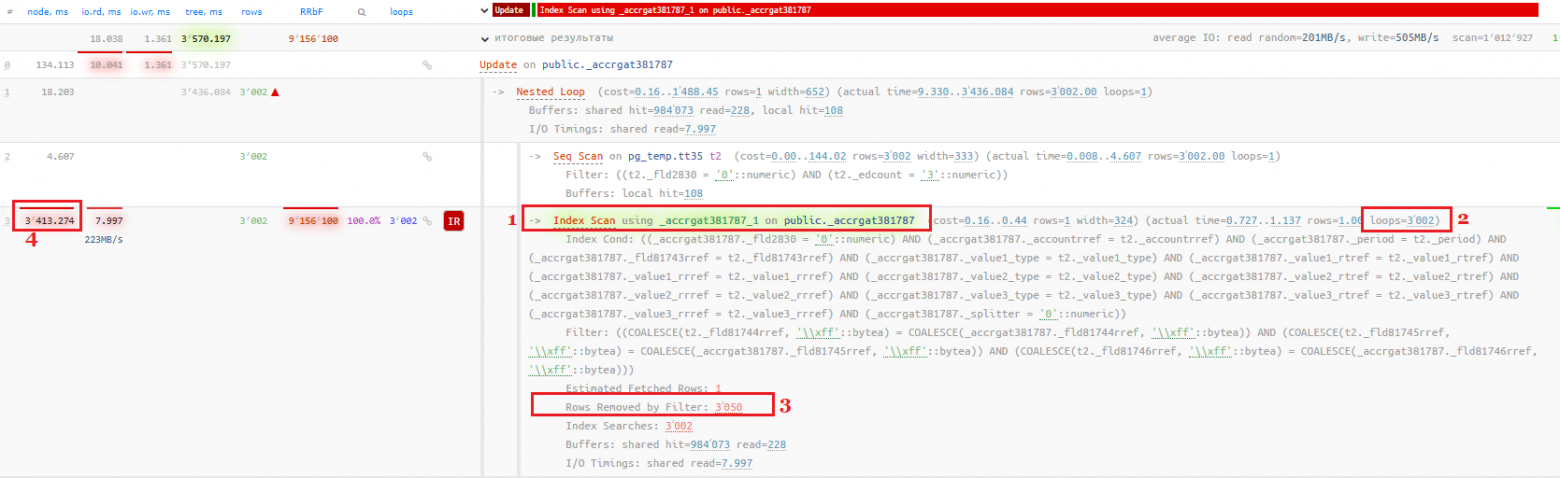
Что мы видим в плане:
-
Поиск по индексу таблицы итогов
-
Выполняется он 3002 раза, т.к. у нас используется вложенные циклы
-
На каждом цикле поиска в индексе фильтруется 3050 записей
-
Данный узел суммарно выполняется почти 3,5 секунды.
Первое, что мне пришло в голову — проиндексировать небалансовые измерения Подразделение, НаправлениеДеятельности, чтобы они попали в данный индекс. Сделаем это в конфигураторе, но после обновления базы смотрю состав индексов и вижу, что для таблиц ИтогиПоСубконто2, ИтогиПоСубконто3 структура индексов никак не поменялась — платформа создала дополнительный индекс только по основной таблице РегистрБухгалтерии.Хозрасчетный.
Следующим шагом я решил запретить Nested Loop (enable_nestloop = off) и посмотреть как выполнится данный запрос через Hash Join. Запрос выполнился всего за 0,1 секунды (план запроса) — это значительно быстрее. Отсюда можно сделать предварительный вывод, что Hash Join для данных запросов обновления итогов является более оптимальным вариантом соединения двух таблиц. Давайте разберемся, почему планировщик его не выбирает.
Почему планировщик игнорирует Hash Join
Мы определили, что в данном случае решением может быть выбор Hash Join вместо Nested Loop. Как заставить планировщик это сделать без выключения Nested Loop?
Давайте еще раз посмотрим на планы запросов, только получим их выполнением запроса только с конструкцией EXPLAIN, без конструкции ANALYZE, т.к. нам нужна только информация об оценке планировщика на стадии планирования запроса — фактические данные нам сейчас не нужны.
План запроса с Nested Loop:
Update on _accrgat381787 (cost=0.16..1330.05 rows=0 width=0)"" -> Nested Loop (cost=0.16..1330.05 rows=1 width=652)"" -> Seq Scan on tt19 t2 (cost=0.00..144.02 rows=3002 width=333)"" Filter: ((_fld2830 = '0'::numeric) AND (_edcount = '3'::numeric))"" -> Index Scan using _accrgat381787_1 on _accrgat381787 (cost=0.16..0.39 rows=1 width=324)"" Index Cond: ((_fld2830 = '0'::numeric) AND (_accountrref = t2._accountrref) AND (_period = t2._period) AND (_fld81743rref = t2._fld81743rref) AND (_value1_type = t2._value1_type) AND (_value1_rtref = t2._value1_rtref) AND (_value1_rrref = t2._value1_rrref) AND (_value2_type = t2._value2_type) AND (_value2_rtref = t2._value2_rtref) AND (_value2_rrref = t2._value2_rrref) AND (_value3_type = t2._value3_type) AND (_value3_rtref = t2._value3_rtref) AND (_value3_rrref = t2._value3_rrref) AND (_splitter = '0'::numeric))"" Filter: ((COALESCE(t2._fld81744rref, '\\xff'::bytea) = COALESCE(_fld81744rref, '\\xff'::bytea)) AND (COALESCE(t2._fld81745rref, '\\xff'::bytea) = COALESCE(_fld81745rref, '\\xff'::bytea)) AND (COALESCE(t2._fld81746rref, '\\xff'::bytea) = COALESCE(_fld81746rref, '\\xff'::bytea)))"
Видим, что стоимость Nested Loop = 1330.05.
Выключим его через «SET enable_nestloop=off;» и выполним запрос еще раз, чтобы получить план с Hash Join:
Update on _accrgat381787 (cost=219.07..21766.70 rows=0 width=0)"" -> Hash Join (cost=219.07..21766.70 rows=1 width=652)"" Hash Cond: ((_accrgat381787._period = t2._period) AND (_accrgat381787._accountrref = t2._accountrref) AND (_accrgat381787._fld81743rref = t2._fld81743rref) AND (COALESCE(_accrgat381787._fld81744rref, '\\xff'::bytea) = COALESCE(t2._fld81744rref, '\\xff'::bytea)) AND (COALESCE(_accrgat381787._fld81745rref, '\\xff'::bytea) = COALESCE(t2._fld81745rref, '\\xff'::bytea)) AND (COALESCE(_accrgat381787._fld81746rref, '\\xff'::bytea) = COALESCE(t2._fld81746rref, '\\xff'::bytea)) AND (_accrgat381787._value1_type = t2._value1_type) AND (_accrgat381787._value1_rtref = t2._value1_rtref) AND (_accrgat381787._value1_rrref = t2._value1_rrref) AND (_accrgat381787._value2_type = t2._value2_type) AND (_accrgat381787._value2_rtref = t2._value2_rtref) AND (_accrgat381787._value2_rrref = t2._value2_rrref) AND (_accrgat381787._value3_type = t2._value3_type) AND (_accrgat381787._value3_rtref = t2._value3_rtref) AND (_accrgat381787._value3_rrref = t2._value3_rrref))"" -> Seq Scan on _accrgat381787 (cost=0.00..348.58 rows=5215 width=324)"" Filter: ((_fld2830 = '0'::numeric) AND (_splitter = '0'::numeric))"" -> Hash (cost=144.02..144.02 rows=3002 width=333)"" -> Seq Scan on tt19 t2 (cost=0.00..144.02 rows=3002 width=333)"" Filter: ((_fld2830 = '0'::numeric) AND (_edcount = '3'::numeric))"
Стоимость Hash Join = 21766.70, что больше Nested Loop в 16 раз.
Может ли использование функции COALESCE так влияет на стоимость использования Hash Join? Проверим это, поменяв условие соединения двух таблиц по полю Подразделение с
AND (COALESCE(T2._Fld81745RRef,'\377'::bytea) = COALESCE(_AccRgAT381787._Fld81745RRef,'\377'::bytea))
на
AND T2._Fld81745RRef = _AccRgAT381787._Fld81745RRef
Включаем «SET enable_nestloop=on;» и выполняем запрос:
"Update on _accrgat381787 (cost=219.07..765.90 rows=0 width=0)"" -> Hash Join (cost=219.07..765.90 rows=1 width=652)"" Hash Cond: ((_accrgat381787._period = t2._period) AND (_accrgat381787._accountrref = t2._accountrref) AND (_accrgat381787._fld81743rref = t2._fld81743rref) AND (COALESCE(_accrgat381787._fld81744rref, '\\xff'::bytea) = COALESCE(t2._fld81744rref, '\\xff'::bytea)) AND (_accrgat381787._fld81745rref = t2._fld81745rref) AND (COALESCE(_accrgat381787._fld81746rref, '\\xff'::bytea) = COALESCE(t2._fld81746rref, '\\xff'::bytea)) AND (_accrgat381787._value1_type = t2._value1_type) AND (_accrgat381787._value1_rtref = t2._value1_rtref) AND (_accrgat381787._value1_rrref = t2._value1_rrref) AND (_accrgat381787._value2_type = t2._value2_type) AND (_accrgat381787._value2_rtref = t2._value2_rtref) AND (_accrgat381787._value2_rrref = t2._value2_rrref) AND (_accrgat381787._value3_type = t2._value3_type) AND (_accrgat381787._value3_rtref = t2._value3_rtref) AND (_accrgat381787._value3_rrref = t2._value3_rrref))"" -> Seq Scan on _accrgat381787 (cost=0.00..348.58 rows=5215 width=324)"" Filter: ((_fld2830 = '0'::numeric) AND (_splitter = '0'::numeric))"" -> Hash (cost=144.02..144.02 rows=3002 width=333)"" -> Seq Scan on tt19 t2 (cost=0.00..144.02 rows=3002 width=333)"" Filter: ((_fld2830 = '0'::numeric) AND (_edcount = '3'::numeric))"
Планировщик выбрал Hash Join и его стоимость уменьшилась с 21766.70 до 765.90 — он стал предпочтительнее Nested Loop.
Таким образом получается, что использование функции COALESCE сильно завышает стоимость Hash Join. Но стоимость выполнения каждой функции, доступной в SQL-запросах, хранится в системной таблице pg_proc. Получим её следующим запросом:
SELECT p.proname AS function_name, p.procost AS cost, p.prorows AS estimated_rows, p.proisstrict AS is_strict, p.prorettype::regtype AS return_typeFROM pg_proc pWHERE p.proname = 'coalesce';
Но данный запрос вернул пустой результат. Это означает, что стоимость использования этой функции определяется где-то в исходном коде. Я предположил, что при использовании Hash Join есть ошибка при расчете стоимости использования функции COALESCE, и поставил задачу на команду разработки СУБД, чтобы они проанализировали такое поведение.
Исправление оценки COALESCE
Анализ разработчика СУБД показал, что когда в условии соединения используется функция COALESCE, планировщик не мог извлечь статистику по такому выражению и применял жёстко заданную в коде константу: считалось, что 10% всех строк попадает в один bucket хэш-таблицы, что многократно завышало стоимость Hash Join. Мы исправили это поведение: теперь планировщик оценивает селективность подобных условий на основе реальной статистики по столбцам, а не константы по умолчанию. В результате появляется новый параметр enable_coalesce_estimation, который исправляет данное поведение. Подробнее о данной оптимизации написано в статье «Почему COALESCE ломает план PostgreSQL и как научить планировщик считать его селективность?«.
После доработки нашей СУБД проверяю опять тестовый запрос на нашей базе ERP и получаю следующий план:
"Update on _accrgat381787 (cost=219.07..786.76 rows=0 width=0)"" -> Hash Join (cost=219.07..786.76 rows=1 width=652)"" Hash Cond: ((_accrgat381787._period = t2._period) AND (_accrgat381787._accountrref = t2._accountrref) AND (_accrgat381787._fld81743rref = t2._fld81743rref) AND (COALESCE(_accrgat381787._fld81744rref, '\\xff'::bytea) = COALESCE(t2._fld81744rref, '\\xff'::bytea)) AND (COALESCE(_accrgat381787._fld81745rref, '\\xff'::bytea) = COALESCE(t2._fld81745rref, '\\xff'::bytea)) AND (COALESCE(_accrgat381787._fld81746rref, '\\xff'::bytea) = COALESCE(t2._fld81746rref, '\\xff'::bytea)) AND (_accrgat381787._value1_type = t2._value1_type) AND (_accrgat381787._value1_rtref = t2._value1_rtref) AND (_accrgat381787._value1_rrref = t2._value1_rrref) AND (_accrgat381787._value2_type = t2._value2_type) AND (_accrgat381787._value2_rtref = t2._value2_rtref) AND (_accrgat381787._value2_rrref = t2._value2_rrref) AND (_accrgat381787._value3_type = t2._value3_type) AND (_accrgat381787._value3_rtref = t2._value3_rtref) AND (_accrgat381787._value3_rrref = t2._value3_rrref))"" -> Seq Scan on _accrgat381787 (cost=0.00..348.58 rows=5215 width=324)"" Filter: ((_fld2830 = '0'::numeric) AND (_splitter = '0'::numeric))"" -> Hash (cost=144.02..144.02 rows=3002 width=333)"" -> Seq Scan on tt19 t2 (cost=0.00..144.02 rows=3002 width=333)"" Filter: ((_fld2830 = '0'::numeric) AND (_edcount = '3'::numeric))"
Стоимость Hash Join упала с 21766.70 до 786.76 и планировщик выбирает его вместо Nested Loop.
Далее мы решили убедиться, что и у клиента это решит проблему — отдали ему сборку для проверки. Но результат нас удивил: закрытие месяца всё равно выполнялось 8 часов. Анализ логов показал всю ту же проблему, что выбирается Nested Loop, а не Hash Join
На нашем синтетическом стенде таблица итогов содержала около 5 тысяч строк — и оптимизация enable_coalesce_estimation снижала стоимость Hash Join до приемлемого уровня. У клиента та же таблица содержала несколько миллионов строк. При таком объёме даже исправленная оценка COALESCE давала стоимость Hash Join в разы выше Nested Loop — и планировщик всё равно выбирал неоптимальный план.
Чтобы разобраться детально, нам нужны были реальные данные клиента. Мы согласовали с клиентом передачу нам 2х таблиц, участвующих в запросе обновления итогов: временной таблицы и таблицы ИтогиПоСчетамССубконто2. Для этого используем расширение auto_dump со следующими настройками:
shared_preload_libraries = 'auto_dump'auto_dump.enable = 'on'auto_dump.dump_persistent_tables = 'on'auto_dump.output_directory = '/var/lib/postgresql/auto_dump_files/'auto_dump.dump_on_query_string = 'UPDATE _AccRgAT251202'
Данное расширение позволяется при выполнении проблемного запроса автоматически создать SQL-файлы, которые буду содержать команды по созданию и наполнению данными таблиц, участвующих в искомом запросе (параметр dump_on_query_string). Дампятся как временные таблицы, так и постоянные (параметр dump_persistent_tables).
Клиент запустил еще раз закрытие месяца, проблемный запрос был успешно «сдамплен» и передан нам. Для воспроизведения требовалось выполнить команды создания и наполнения таблиц и можно было приступать к анализу причин. Приступим.
Выполним запрос и получим план:
"Update on _accrgat251202 (cost=0.22..416403.07 rows=0 width=0)"" -> Nested Loop (cost=0.22..416403.07 rows=187541 width=492)"" -> Seq Scan on tt11 t2 (cost=0.00..51105.79 rows=590432 width=240)"" Filter: ((_edcount = '2'::numeric) AND (_fld3181 = '0'::numeric))"" -> Index Scan using _accrgat251202_1o on _accrgat251202 (cost=0.22..0.59 rows=1 width=225)"" Index Cond: ((_fld3181 = '0'::numeric) AND (_accountrref = t2._accountrref) AND (_period = t2._period) AND (_fld51168rref = t2._fld51168rref) AND (COALESCE(_value1_type, '\xff'::bytea) = COALESCE(t2._value1_type, '\xff'::bytea)) AND (COALESCE(_value1_rtref, '\xff'::bytea) = COALESCE(t2._value1_rtref, '\xff'::bytea)) AND (COALESCE(_value1_rrref, '\xff'::bytea) = COALESCE(t2._value1_rrref, '\xff'::bytea)) AND (COALESCE(_value2_type, '\xff'::bytea) = COALESCE(t2._value2_type, '\xff'::bytea)) AND (COALESCE(_value2_rtref, '\xff'::bytea) = COALESCE(t2._value2_rtref, '\xff'::bytea)) AND (COALESCE(_value2_rrref, '\xff'::bytea) = COALESCE(t2._value2_rrref, '\xff'::bytea)) AND (_splitter = '0'::numeric))"" Filter: ((COALESCE(t2._fld51171rref, '\xff'::bytea) = COALESCE(_fld51171rref, '\xff'::bytea)) AND (COALESCE(t2._fld51170rref, '\xff'::bytea) = COALESCE(_fld51170rref, '\xff'::bytea)) AND (COALESCE(t2._fld51169rref, '\xff'::bytea) = COALESCE(_fld51169rref, '\xff'::bytea)))"" Estimated Fetched Rows: 1"
Видим из плана запроса, что оценки стоимости узла Nested Loop равна 416 тысяч. Выключим его enable_nestloop=off и посмотрим стоимость Hash Join:
"Update on _accrgat251202 (cost=234462.77..3433670334.57 rows=0 width=0)"" -> Hash Join (cost=234462.77..3433670334.57 rows=187541 width=492)"" Hash Cond: ((t2._period = _accrgat251202._period) AND (t2._accountrref = _accrgat251202._accountrref) AND (t2._fld51168rref = _accrgat251202._fld51168rref) AND (COALESCE(t2._fld51169rref, '\xff'::bytea) = COALESCE(_accrgat251202._fld51169rref, '\xff'::bytea)) AND (COALESCE(t2._fld51170rref, '\xff'::bytea) = COALESCE(_accrgat251202._fld51170rref, '\xff'::bytea)) AND (COALESCE(t2._fld51171rref, '\xff'::bytea) = COALESCE(_accrgat251202._fld51171rref, '\xff'::bytea)) AND (COALESCE(t2._value1_type, '\xff'::bytea) = COALESCE(_accrgat251202._value1_type, '\xff'::bytea)) AND (COALESCE(t2._value1_rtref, '\xff'::bytea) = COALESCE(_accrgat251202._value1_rtref, '\xff'::bytea)) AND (COALESCE(t2._value1_rrref, '\xff'::bytea) = COALESCE(_accrgat251202._value1_rrref, '\xff'::bytea)) AND (COALESCE(t2._value2_type, '\xff'::bytea) = COALESCE(_accrgat251202._value2_type, '\xff'::bytea)) AND (COALESCE(t2._value2_rtref, '\xff'::bytea) = COALESCE(_accrgat251202._value2_rtref, '\xff'::bytea)) AND (COALESCE(t2._value2_rrref, '\xff'::bytea) = COALESCE(_accrgat251202._value2_rrref, '\xff'::bytea)))"" -> Seq Scan on tt11 t2 (cost=0.00..51105.79 rows=590432 width=240)"" Filter: ((_edcount = '2'::numeric) AND (_fld3181 = '0'::numeric))"" -> Hash (cost=155581.04..155581.04 rows=3585533 width=225)"" -> Seq Scan on _accrgat251202 (cost=0.00..155581.04 rows=3585533 width=225)"" Filter: ((_splitter = '0'::numeric) AND (_fld3181 = '0'::numeric))"
Стоимость аж 3.4 млрд, т.е. почти в 100 тысяч раз больше! Включим нашу оптимизацию при использовании COALESCE — enable_coalesce_estimation = on:
"Update on _accrgat251202 (cost=64095.29..1756525012.03 rows=0 width=0)"" -> Hash Join (cost=64095.29..1756525012.03 rows=187541 width=492)"" Hash Cond: ((_accrgat251202._period = t2._period) AND (_accrgat251202._accountrref = t2._accountrref) AND (_accrgat251202._fld51168rref = t2._fld51168rref) AND (COALESCE(_accrgat251202._fld51169rref, '\xff'::bytea) = COALESCE(t2._fld51169rref, '\xff'::bytea)) AND (COALESCE(_accrgat251202._fld51170rref, '\xff'::bytea) = COALESCE(t2._fld51170rref, '\xff'::bytea)) AND (COALESCE(_accrgat251202._fld51171rref, '\xff'::bytea) = COALESCE(t2._fld51171rref, '\xff'::bytea)) AND (COALESCE(_accrgat251202._value1_type, '\xff'::bytea) = COALESCE(t2._value1_type, '\xff'::bytea)) AND (COALESCE(_accrgat251202._value1_rtref, '\xff'::bytea) = COALESCE(t2._value1_rtref, '\xff'::bytea)) AND (COALESCE(_accrgat251202._value1_rrref, '\xff'::bytea) = COALESCE(t2._value1_rrref, '\xff'::bytea)) AND (COALESCE(_accrgat251202._value2_type, '\xff'::bytea) = COALESCE(t2._value2_type, '\xff'::bytea)) AND (COALESCE(_accrgat251202._value2_rtref, '\xff'::bytea) = COALESCE(t2._value2_rtref, '\xff'::bytea)) AND (COALESCE(_accrgat251202._value2_rrref, '\xff'::bytea) = COALESCE(t2._value2_rrref, '\xff'::bytea)))"" -> Seq Scan on _accrgat251202 (cost=0.00..155581.04 rows=3585533 width=225)"" Filter: ((_splitter = '0'::numeric) AND (_fld3181 = '0'::numeric))"" -> Hash (cost=51105.79..51105.79 rows=590432 width=240)"" -> Seq Scan on tt11 t2 (cost=0.00..51105.79 rows=590432 width=240)"" Filter: ((_edcount = '2'::numeric) AND (_fld3181 = '0'::numeric))"
Стоимость упала в 2 раза с 3.4 до 1.7 млрд, но этого недостаточно, т.к. Hash Join все еще очень дорог по сравнению с Nested Loop. Или может Nested Loop слишком дешев? Конечно, ведь при оценке стоимости он не учитывает сколько строк будет отброшено через Filter, что составляет основное время его выполнения.
В плане запроса с Nested Loop мы видим строку Estimated Fetched Rows, которая говорит о том, сколько строк будет прочитано с диска. Мы бы могли добавить штраф для Nested Loop с помощью параметра cpu_filter_cost, но .т.к. значение в этом поле равно 1, то штраф добавить не получится — необходимо искать другое решение.
В ходе обсуждения с коллегами была предложена следующая идея:
Переключать вид соединения на HashJoin, если количество клауз (условий в соединении таблиц) больше пяти — оценки оптимизатора все равно смысла не имеют, а значит стабильность плана равна нулю. Поэтому HashJoin — надежный, консервативный запасной план.
А в патче PostgreSQL от фирмы 1С версии 18.4 была доработана логика расчета селективности:
Введён учёт «вероятно скоррелированных» условий (CKLikelyCorrelated), при 5+ клаузах селективность домножается на коэффициент 0.75 вместо наивного перемножения.
Мы рассмотрели оба варианта, но они не подходили нам, т.к. они не решали первопричину проблемы с завышенной стоимостью Hash Join, а срабатывали лишь при определенных условиях (эвристика), когда вероятно Hash Join будет предпочтительнее Nested Loop. И то, даже не смотря на то, что это эвристика, только первая идея с принудительным переключением на Hash Join действительно решала рассматриваемую нами проблему.
В итоге мы пошли другим путем..
Как работает Hash Join и откуда берется его стоимость
Разберем механизм работы Hash Join на простом примере. Есть таблица итогов из 6 строк и временная таблица с изменениями, которые нужно в неё записать. Соединяем их всего по двум полям: Счёт и Подразделение. Hash Join работает в два этапа.
Этап 1. Построение хэш-таблицы. Hash Join берет одну из таблиц, в нашем примере таблицу итогов, и раскладывает её строки по корзинам — bucket’ам. Номер bucket’а для каждой строки вычисляет хэш-функция по значениям полей соединения. Например, строка «60, Склад» получает хэш 0 и попадает в bucket 0, а строка «62, Офис» получает хэш 1 и попадает в bucket 1:
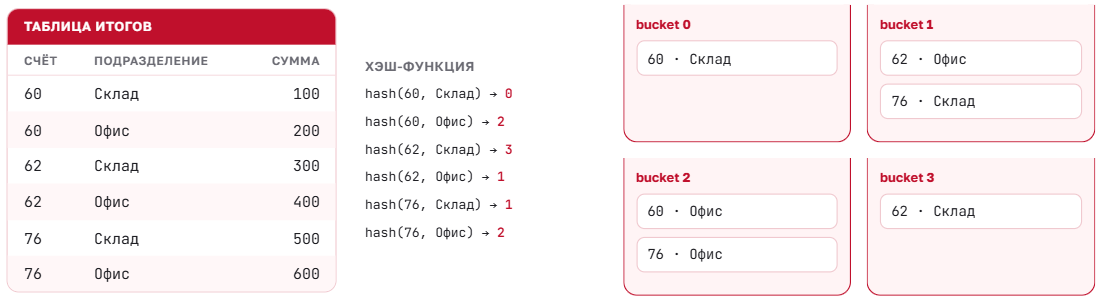
Одинаковые значения полей всегда дают одинаковый хэш, поэтому строки с одинаковым ключом гарантированно лежат в одном bucket’е. Обратное неверно: в один bucket могут попасть и строки с разными ключами. На изображении в bucket 1 лежат «62, Офис» и «76, Склад». Поэтому найти bucket ещё недостаточно — внутри него каждую строку нужно проверить на совпадение условий соединения.
Этап 2. Поиск. Теперь Hash Join идет по строкам временной таблицы. Для строки «62, Офис» он вычисляет тот же хэш, получает 1 и смотрит только в bucket 1. Там две строки: первая совпала, вторая отброшена. Получилось два сравнения:
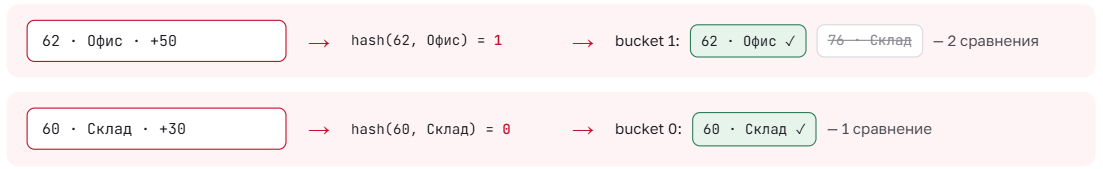
Получается, вся работа Hash Join определяется тем, сколько строк лежит в одном bucket’е. Если в каждом по одной строке, на каждую строку временной таблицы приходится одно сравнение. Если в каждом тысяча, то тысяча сравнений, и Hash Join превращается в перебор строк с фильтрацией.
На этапе планирования bucket’ов еще нет, и планировщику нужно заранее угадать, сколько строк окажется в одном bucket’е. Он делает это по статистике и смотрит на каждое поле соединения отдельно:
-
по Подразделению 2 уникальных значения на 6 строк, то есть 3 строки в bucket’е;
-
по Счету 3 уникальных значения, то есть 2 строки в bucket’е;
-
из этих оценок берётся наименьшая — 2 строки.
А на самом деле все 6 комбинаций «Счет + Подразделение» уникальны, и в bucket’е в среднем одна строка. Казалось бы, что ошибка безобидная — 2 строки вместо 1. Но в нашем случае у клиента соединение идет не по двум полям, а по 12ти, и не по 6 строкам, а по сотням тысяч. Планировщик думает, что в каждом bucket’е будут десятки тысяч строк и учитывает стоимость их фильтрации в своей оценке. Отсюда мы и получаем такую большую оценку Hash Join.
В итоге мы выполнили 2 доработки, чтобы улучшить оценку планировщика:
-
Научили его понимать, сколько строк уникальных комбинаций дают несколько полей соединения вместе
-
Учитывать эту оценку при планировании Hash Join
После этих 2х доработок выполняем наш запрос и он теперь выбирает Hash Join:
"Update on _accrgat251202 (cost=234462.77..431064.43 rows=0 width=0)"" -> Hash Join (cost=234462.77..431064.43 rows=187541 width=492)"" Hash Cond: ((t2._period = _accrgat251202._period) AND (t2._accountrref = _accrgat251202._accountrref) AND (t2._fld51168rref = _accrgat251202._fld51168rref) AND (COALESCE(t2._fld51169rref, '\xff'::bytea) = COALESCE(_accrgat251202._fld51169rref, '\xff'::bytea)) AND (COALESCE(t2._fld51170rref, '\xff'::bytea) = COALESCE(_accrgat251202._fld51170rref, '\xff'::bytea)) AND (COALESCE(t2._fld51171rref, '\xff'::bytea) = COALESCE(_accrgat251202._fld51171rref, '\xff'::bytea)) AND (COALESCE(t2._value1_type, '\xff'::bytea) = COALESCE(_accrgat251202._value1_type, '\xff'::bytea)) AND (COALESCE(t2._value1_rtref, '\xff'::bytea) = COALESCE(_accrgat251202._value1_rtref, '\xff'::bytea)) AND (COALESCE(t2._value1_rrref, '\xff'::bytea) = COALESCE(_accrgat251202._value1_rrref, '\xff'::bytea)) AND (COALESCE(t2._value2_type, '\xff'::bytea) = COALESCE(_accrgat251202._value2_type, '\xff'::bytea)) AND (COALESCE(t2._value2_rtref, '\xff'::bytea) = COALESCE(_accrgat251202._value2_rtref, '\xff'::bytea)) AND (COALESCE(t2._value2_rrref, '\xff'::bytea) = COALESCE(_accrgat251202._value2_rrref, '\xff'::bytea)))"" -> Seq Scan on tt11 t2 (cost=0.00..51105.79 rows=590432 width=240)"" Filter: ((_edcount = '2'::numeric) AND (_fld3181 = '0'::numeric))"" -> Hash (cost=155581.04..155581.04 rows=3585533 width=225)"" -> Seq Scan on _accrgat251202 (cost=0.00..155581.04 rows=3585533 width=225)"" Filter: ((_splitter = '0'::numeric) AND (_fld3181 = '0'::numeric))"
Его стоимость сократилась с 1.7 млрд до 431 тысячи.
А Nested Loop наоборот стал дороже и его стоимость возросла с 416 тысяч до 2х млн:
"Update on _accrgat251202 (cost=0.22..2113304.64 rows=0 width=0)"" -> Nested Loop (cost=0.22..2113304.64 rows=187541 width=492)"" -> Seq Scan on tt11 t2 (cost=0.00..51105.79 rows=590432 width=240)"" Filter: ((_edcount = '2'::numeric) AND (_fld3181 = '0'::numeric))"" -> Index Scan using _accrgat251202_1o on _accrgat251202 (cost=0.22..3.42 rows=6 width=225)"" Index Cond: ((_fld3181 = '0'::numeric) AND (_accountrref = t2._accountrref) AND (_period = t2._period) AND (_fld51168rref = t2._fld51168rref) AND (COALESCE(_value1_type, '\xff'::bytea) = COALESCE(t2._value1_type, '\xff'::bytea)) AND (COALESCE(_value1_rtref, '\xff'::bytea) = COALESCE(t2._value1_rtref, '\xff'::bytea)) AND (COALESCE(_value1_rrref, '\xff'::bytea) = COALESCE(t2._value1_rrref, '\xff'::bytea)) AND (COALESCE(_value2_type, '\xff'::bytea) = COALESCE(t2._value2_type, '\xff'::bytea)) AND (COALESCE(_value2_rtref, '\xff'::bytea) = COALESCE(t2._value2_rtref, '\xff'::bytea)) AND (COALESCE(_value2_rrref, '\xff'::bytea) = COALESCE(t2._value2_rrref, '\xff'::bytea)) AND (_splitter = '0'::numeric))"" Filter: ((COALESCE(t2._fld51171rref, '\xff'::bytea) = COALESCE(_fld51171rref, '\xff'::bytea)) AND (COALESCE(t2._fld51170rref, '\xff'::bytea) = COALESCE(_fld51170rref, '\xff'::bytea)) AND (COALESCE(t2._fld51169rref, '\xff'::bytea) = COALESCE(_fld51169rref, '\xff'::bytea)))"" Estimated Fetched Rows: 30"
Теперь получим фактический план выполнения нашего запроса:
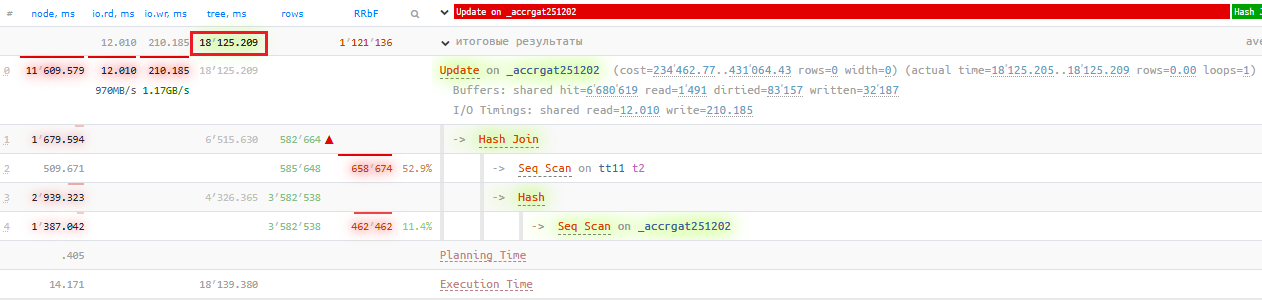
Запрос c Hash Join выполнился за 18 секунд вместо почти часа при выборе Nested Loop.
Также мы провели несколько нагрузочных тестов (о том как мы тестируем доработки писали тут), чтобы проверить как эта доработка повлияет на другие запросы. По результатам тестов это также улучшило и некоторые другие пользовательские операции.
Что делать, если столкнулись с такой проблемой?
Решений тут два.
На уровне СУБД проблема решена в Tantor Postgres 18.7. Если вы столкнулись с ней раньше, чем вышла эта версия, — напишите нам, поможем. Чтобы включить исправление, достаточно добавить в postgresql.conf:
enable_coalesce_estimation = onenable_multicolumn_stats_detail = on
Второе — создать индекс, который покрывает все поля соединения. В этом случае планировщик также выберет Nested Loop, но все условия будут проверяться прямо по индексу, без дорогостоящей фильтрации тысяч лишних строк на каждом цикле.
Если хотите протестировать продукт, вы можете бесплатно получить тестовую лицензию на 3 месяца по ссылке.
ссылка на оригинал статьи https://habr.com/ru/articles/1103888/