Вокруг оптимизации под генеративный поиск — Generative Engine Optimization (GEO), Answer Engine Optimization (AEO) и LLM Optimization — быстро вырос рынок противоречивых рекомендаций. Командам предлагают внедрять нестандартные текстовые файлы для языковых моделей, создавать отдельные «AI-карты сайта» или переписывать техническую документацию короткими абзацами по фиксированному числу слов. Когда начинаешь сверять эти советы с документацией поисковых систем и архитектурой конвейеров Retrieval-Augmented Generation (RAG), выясняется, что значительная часть подобных практик либо не влияет на индексацию, либо прямо вредит отображению сниппетов.
В этой статье разберём инженерную механику работы генеративных блоков в поиске (на примере Google AI Overviews, AI Mode и алгоритмов извлечения фрагментов), отделим задокументированные требования поисковых движков от отраслевых мифов и соберём воспроизводимый технический чек-лист проверки сайта: от управляющих директив обхода и превью до графа сущностей в JSON-LD и структуры документа под векторно-лексический поиск.
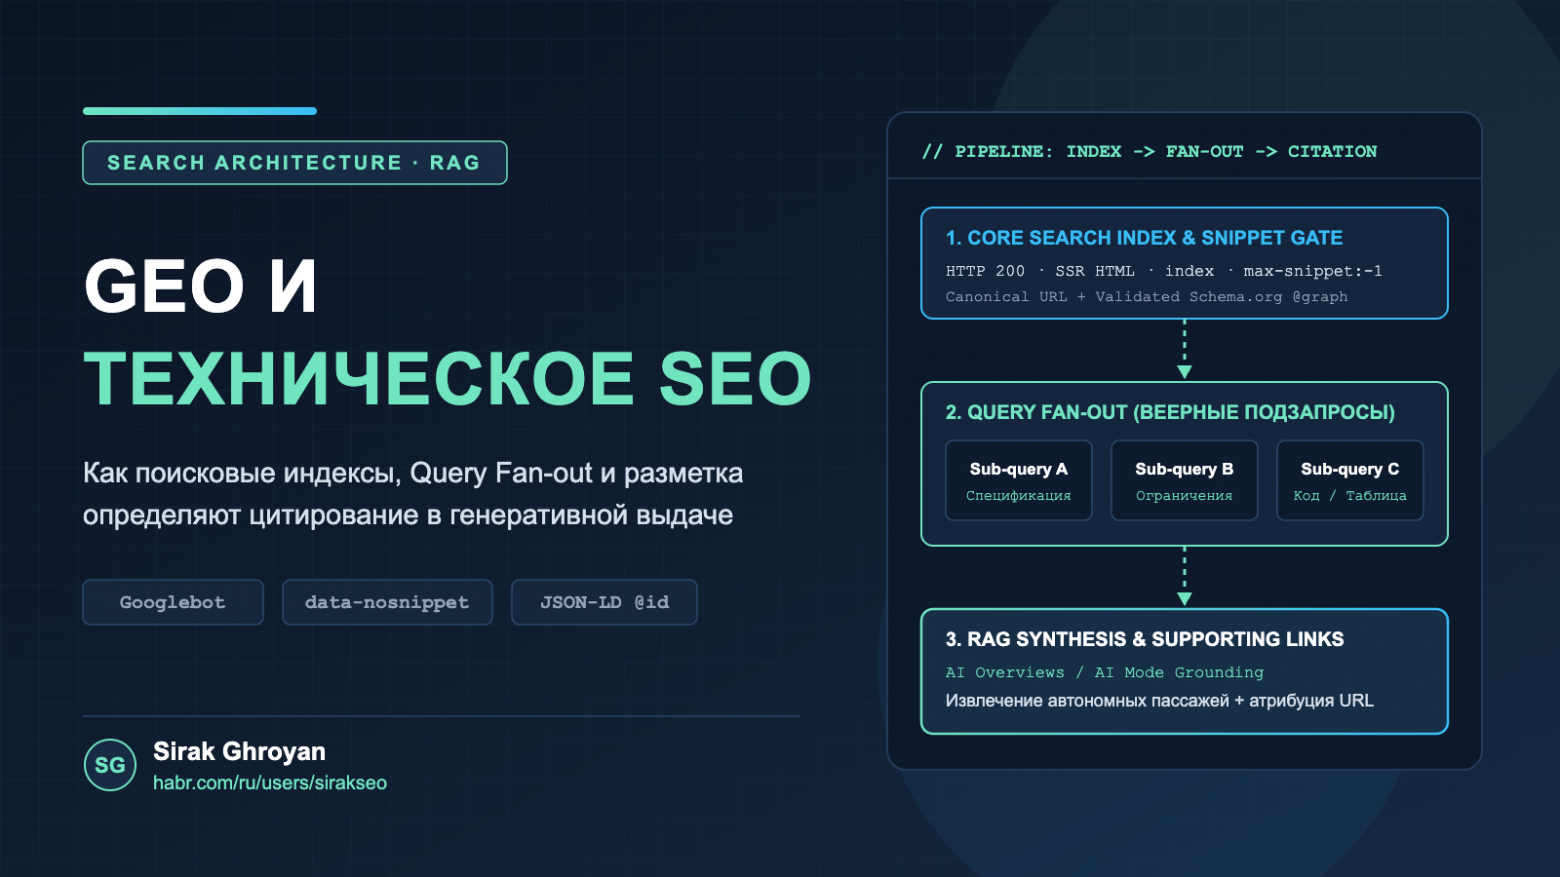
1. Архитектура генеративного ответа в поиске: базовый индекс, RAG и Query Fan-out
Главное архитектурное заблуждение при работе с AI-поиском — воспринимать генеративный блок над результатами выдачи как изолированную языковую модель, которая отвечает исключительно на основе весов, полученных во время предобучения. В поисковых системах промышленного масштаба генерация опирается на конвейер Retrieval-Augmented Generation (RAG), жёстко связанный с основным поисковым индексом.
Согласно официальной документации Google Search Central (AI features and your website), у режимов AI Overviews и AI Mode нет отдельного индекса, специальной формы регистрации или обособленного протокола подачи страниц. Чтобы документ в принципе мог стать опорной ссылкой (supporting link) в синтезированном ответе, он должен пройти базовый технический фильтр классического поиска:
-
Страница должна быть доступна для обхода основным краулером и находиться в поисковом индексе.
-
Страница должна иметь разрешение на формирование сниппета в стандартной поисковой выдаче.
Поверх базового индекса работает механизм, который в документации Google и профильных разборах (PPC Land: Explaining AI Overviews, Moz: Google GEO Guidelines) описывается как Query Fan-out (веерное расширение запроса).
[Пользовательский запрос] │ ▼[Декомпозиция намерения (Query Fan-out)] ├── Подзапрос A (определение / спецификация) ├── Подзапрос B (сравнение параметров / ограничения) └── Подзапрос C (практическая реализация / ошибки) │ ▼[Извлечение кандидатов из поискового индекса + проверка прав на сниппет] │ ▼[Ранжирование пассажей (Passage Retrieval) и синтез ответа с атрибуцией ссылок]
Когда пользователь задаёт составной технический или сравнительный вопрос, система не ограничивается одним лексическим запросом по исходной фразе. Модель генерирует серию фоновых поисковых подзапросов, охватывающих смежные подтемы и связанные сущности. Например, запрос о выборе архитектуры рендеринга для мультиязычного каталога может породить подзапросы о времени ответа сервера (TTFB), правилах связывания альтернативных языковых версий (hreflang), каноникализации дубликатов и индексации клиентского JavaScript.
Из этого механизма следуют два важных для инженеров и SEO-специалистов вывода:
-
Расширение пула цитируемых страниц. Классическая выдача ограничена десятью позициями по конкретной формулировке запроса. При веерном расширении кандидаты выбираются по целому набору фоновых подзапросов. Как показывают отраслевые исследования (MarTech: AI visibility depends on who writes about your brand, Search Engine Land: AI Overview citations and clicks), в список опорных ссылок генеративного ответа нередко попадают страницы, которые не занимают первые три строчки по головному запросу, но содержат точный, структурно выделенный ответ на один из дочерних подзапросов.
-
Смещение фокуса с уровня документа на уровень фрагмента (пассажа). Для синтеза ответа конвейеру требуется извлечь конкретный смысловой блок — таблицу ограничений, список условий или точное определение — и сопоставить его с другими источниками. Если ключевой факт размыт по пяти абзацам или скрыт за интерактивным элементом без серверной разметки, вероятность его выбора падает даже при высоком авторитете домена.
2. Краулеры, индексация и управление сниппетами: где возникает техническая блокировка
На практике потеря видимости в AI-блоках часто связана не с качеством текста, а с конфликтами в правилах доступа для роботов и директивах управления превью.
Разделение Googlebot и Google-Extended
В отраслевых публикациях регулярно встречается утверждение, что закрытие токена Google-Extended в robots.txt исключает сайт из AI Overviews, или наоборот — позволяет тонко управлять показом в поисковом AI без влияния на выдачу. Официальная документация Google (Google common crawlers и раздел Controlling your content in AI features in Search в руководстве по AI-функциям) проводит между ними чёткую границу:
-
Googlebotотвечает за обход контента для Google Поиска, включая встроенные в поиск генеративные функции (AI Overviews и AI Mode). -
Google-Extended— это управляющий токен вrobots.txt, который позволяет паблишерам регулировать использование данных сайта для обучения моделей Gemini и заземления (grounding) в продуктах Google за пределами основного поиска (например, в отдельных ассистентах и API-сервисах). Он не управляет включением страницы в поисковые AI Overviews.
Как директивы сниппетов влияют на RAG в поиске
Поскольку обязательным техническим условием участия страницы в AI Overviews и AI Mode является право на показ со сниппетом, стандартные мета-теги и HTTP-заголовки управления превью (Robots meta tag, data-nosnippet, and X-Robots-Tag specifications, Control your snippets in search results) напрямую определяют доступность контента для поискового синтеза:
|
Директива / Атрибут |
Уровень применения |
Техническое действие в классическом и AI-поиске |
Типичный риск при внедрении |
|---|---|---|---|
|
|
|
Полное исключение страницы из индекса и всех генеративных блоков поиска. |
Случайное сохранение тега на шаблонах документации или пагинации после релиза. |
|
|
|
Запрещает текстовый сниппет в выдаче и исключает использование страницы как источника для AI Overviews / AI Mode. |
Использование для «защиты от парсинга» при ожидании органического трафика из AI-ответов. |
|
|
|
Ограничивает максимальную длину текстового превью в символах. Жёсткие лимиты снижают вероятность включения в генеративный блок. |
Глобальная установка |
|
|
HTML-атрибут на |
Исключает содержимое конкретного DOM-узла из текстовых сниппетов и генеративных ответов поиска, не завися от JS-рендеринга. |
Оборачивание в |
Практическое правило для
data-nosnippet: атрибут работает как булев флаг (значение не требуется) и учитывается парсером Google вне зависимости от того, модифицируется ли узел клиентским скриптом. Его целесообразно применять точечно — для юридических дисклеймеров, сквозных виджетов, блоков cookie-уведомлений и динамических цен, которые не должны попадать в статическое резюме страницы.
Доступность исходного HTML и лимиты обхода
Второй критический узел — полнота отдачи контента в первичном HTML-ответе (Server-Side Rendering или статическая генерация). Хотя рендерер Google исполняет современный JavaScript, двухфазная обработка (первичный разбор сырого HTML и последующая очередь рендеринга) создаёт задержки при обновлении данных, а сторонние поисковые и AI-агенты часто вовсе не выполняют сложные клиентские бандлы (обзор GEO на SEO.com, руководство Backlinko по GEO).
Для русскоязычных и мультирегиональных проектов необходимо параллельно контролировать требования Яндекса. В документации Яндекс Вебмастера по индексированию сайта (панель управления) зафиксированы жёсткие технические ограничения: страницы, возвращающие коды 4xx/5xx, исключаются из поисковой базы, а документы объёмом свыше 10 МБ роботом игнорируются. При этом раздутый встроенными состояниями фреймворков (__NEXT_DATA__, инлайновые SVG-спрайты, неминифицированный CSS) HTML-документ способен вплотную приблизиться к порогу размера или замедлить извлечение значимого текста.
Ниже приведён компактный диагностический скрипт на Python (использующий только стандартную библиотеку), который можно запускать в CI или перед релизом шаблона. Он проверяет размер ответа, HTTP-заголовки X-Robots-Tag, мета-директивы сниппетов, наличие канонического адреса и долю текста вне клиентских скриптов:
#!/usr/bin/env python3"""Техническая проверка HTML-ответа на совместимость с требованиями индексации и сниппетов."""import reimport sysimport urllib.requestfrom html.parser import HTMLParserclass SnippetAndIndexParser(HTMLParser): def __init__(self): super().__init__() self.meta_robots = [] self.canonical = [] self.nosnippet_tags = 0 self.in_ignored_tag = False self.visible_text_chunks = [] def handle_starttag(self, tag, attrs): attr_dict = {k.lower(): (v or "") for k, v in attrs} if tag in ("script", "style", "noscript"): self.in_ignored_tag = True if "data-nosnippet" in attr_dict: self.nosnippet_tags += 1 if tag == "meta" and attr_dict.get("name", "").lower() in ("robots", "googlebot", "yandex"): self.meta_robots.append((attr_dict.get("name"), attr_dict.get("content", ""))) if tag == "link" and "canonical" in attr_dict.get("rel", "").lower(): self.canonical.append(attr_dict.get("href", "")) def handle_endtag(self, tag): if tag in ("script", "style", "noscript"): self.in_ignored_tag = False def handle_data(self, data): if not self.in_ignored_tag: cleaned = data.strip() if cleaned: self.visible_text_chunks.append(cleaned)def audit_html_payload(raw_bytes: bytes, headers: dict) -> dict: size_kb = round(len(raw_bytes) / 1024, 2) html_text = raw_bytes.decode("utf-8", errors="replace") parser = SnippetAndIndexParser() parser.feed(html_text) visible_text = " ".join(parser.visible_text_chunks) word_count = len(re.findall(r"\w+", visible_text)) x_robots = [v for k, v in headers.items() if k.lower() == "x-robots-tag"] all_directives = " ".join([ content.lower() for _, content in parser.meta_robots ] + [ x.lower() for x in x_robots ]) blocks_snippet = any(rule in all_directives for rule in ("noindex", "nosnippet", "max-snippet:0")) return { "payload_size_kb": size_kb, "exceeds_yandex_10mb_limit": len(raw_bytes) > 10 * 1024 * 1024, "x_robots_tag": x_robots, "meta_robots": parser.meta_robots, "canonical": parser.canonical, "data_nosnippet_containers": parser.nosnippet_tags, "ssr_visible_word_count": word_count, "snippet_and_ai_eligible": not blocks_snippet and word_count >= 30, }if __name__ == "__main__": sample_html = """<!DOCTYPE html> <html lang="ru"> <head> <meta name="robots" content="index, follow, max-snippet:-1"> <link rel="canonical" href="https://example.com/docs/rag-indexing"> </head> <body> <main> <h1>Архитектура индексации документов</h1> <p>Поисковый индекс использует канонический URL и разрешённый сниппет для построения ответа в выдаче. При серверном рендеринге основной текст сразу доступен краулеру без ожидания выполнения клиентских бандлов, что исключает потерю содержимого таблиц, спецификаций и определений на этапе первичного обхода.</p> </main> <footer data-nosnippet>Юридическое уведомление и настройки cookie.</footer> </body> </html>""".encode("utf-8") print(audit_html_payload(sample_html, {"X-Robots-Tag": "all"}))
Такая проверка мгновенно подсвечивает две классические регрессии при выкатке фронтенда: когда в SSR-ответе остаётся только пустой <div id="app"></div> (ssr_visible_word_count падает почти до нуля) или когда стейджинговый заголовок X-Robots-Tag: noindex, nosnippet попадает в продакшен-конфигурацию балансировщика.
3. Структурированные данные и семантическая разметка: документация против мифа о «специальных AI-файлах»
В 2025–2026 годах широкое распространение получила идея о том, что для попадания в генеративные ответы сайт обязан разместить специальные текстовые манифесты для языковых моделей или внедрить нестандартные расширения Schema.org.
В документации Google Search Central (AI features and your website) этот вопрос закрыт прямой формулировкой: создавать новые машиночитаемые файлы, специальные текстовые файлы для ИИ или особую разметку для появления в AI Overviews и AI Mode не требуется. Эту же позицию неоднократно подтверждали профильные обзоры (Search Engine Land: Google AI Overviews guide, Moz: AI SEO).
Зачем тогда в проектах, ориентированных на техническое SEO и GEO, уделяют столько внимания микроразметке JSON-LD? Причина лежит в плоскости разрешения неоднозначности сущностей (Entity Disambiguation) и валидации атрибутов:
-
Связывание графа сущностей через
@idиsameAs. Когда на странице используется стандартный словарь Schema.org (Organization,Person,TechArticle,SoftwareApplication,FAQPage), явные узлы@idи массивsameAsпозволяют поисковой системе однозначно сопоставить автора, компанию и продукт с записями в графе знаний и внешними авторитетными профилями. -
Строгое соответствие видимому тексту. Согласно базовому руководству Google (Intro to structured data), данные в JSON-LD обязаны отражать видимое пользователю содержимое страницы. Попытка зашить в скрытый JSON-LD ключевые слова или ответы на вопросы, которых нет в HTML-верстке, нарушает правила поисковой системы и приводит к игнорированию разметки.
-
Кросс-валидация под требования разных поисковых систем. Стандартная схема может проходить синтаксический линтер, но не содержать обязательных полей для конкретного типа сниппета в локальном поиске. Для проверки соответствия требованиям Яндекса к карточкам товаров, статей и организаций используется Валидатор микроразметки Яндекс Вебмастера, поддерживающий Schema.org, Open Graph, Microformats и RDFa.
Ниже показан шаблон связанного графа JSON-LD (@graph) для технической статьи, где документ, автор и организация объединены через сквозные идентификаторы @id без дублирования объектов:
{ "@context": "https://schema.org", "@graph": [ { "@type": "Organization", "@id": "https://example.com/#organization", "name": "Example Engineering", "url": "https://example.com/", "sameAs": [ "https://github.com/example-engineering" ] }, { "@type": "Person", "@id": "https://example.com/authors/sirak-ghroyan/#person", "name": "Sirak Ghroyan", "jobTitle": "SEO, GEO & AI Automation Specialist", "worksFor": { "@id": "https://example.com/#organization" }, "sameAs": [ "https://habr.com/ru/users/sirakseo/", "https://vc.ru/id247880" ] }, { "@type": "TechArticle", "@id": "https://example.com/docs/geo-technical-seo/#article", "headline": "Техническое SEO для AI-поиска и GEO: поисковые индексы, RAG и разметка", "author": { "@id": "https://example.com/authors/sirak-ghroyan/#person" }, "publisher": { "@id": "https://example.com/#organization" }, "datePublished": "2026-10-31", "dateModified": "2026-10-31", "mainEntityOfPage": "https://example.com/docs/geo-technical-seo/", "proficiencyLevel": "Expert" } ]}
Такая структура решает сразу две инженерные задачи: исключает расхождение реквизитов организации между шаблонами и явно задаёт связь TechArticle -> author -> Person -> sameAs в едином машиночитаемом графе.
4. Инженерия контента под извлечение пассажей (AEO / GEO) без потери технической глубины
Когда техническая доступность страницы обеспечена, вступает в силу второй уровень отбора — как именно ранжировщик пассажей и языковая модель выбирают фрагмент для включения в ответ.
Исследования пользовательского поведения и структуры генеративной выдачи показывают два взаимосвязанных фактора:
-
Согласно данным исследований пользовательского внимания, разобранным на PPC Land, большинство пользователей просматривают лишь верхнюю треть сгенерированного блока AI Overviews. Следовательно, наибольшую ценность имеют источники, которые подтверждают главный тезис в начале ответа или дают компактную сравнительную структуру.
-
Аналитика по оптимизации под генеративные модели (MarTech: Optimizing content for generative engine search models, Backlinko: Generative Engine Optimization) демонстрирует, что RAG-системы значительно лучше извлекают семантически автономные блоки.
Что означает семантическая автономность на уровне вёрстки и редактуры технического материала?
Принцип самодостаточного раздела (H2/H3 → Прямой ответ → Доказательство / Спецификация)
В традиционных лонгридах авторы часто используют связки, опирающиеся на предыдущий контекст: «Как мы увидели в примере выше, этот параметр меняет поведение системы…». При разбиении документа на чанки (chunking) или извлечении отдельного абзаца поисковым индексом такой фрагмент теряет подлежащее: вне окружающего текста невозможно понять, о каком именно параметре и какой системе идёт речь.
Для повышения точности извлечения каждый смысловой раздел строится по трёхслойной схеме:
-
Явный подзаголовок (
H2илиH3) с называнием сущности и условия. Не «Ограничения метода», а «Ограничения атрибутаdata-nosnippetпри серверном и клиентском рендеринге». -
Первые 2–3 предложения после заголовка — законченная формулировка. Абзац прямо называет объект, действие и граничное условие так, чтобы его можно было процитировать отдельно без потери смысла.
-
Фактологическая опора. Сразу за тезисом следуют проверяемые данные: таблица параметров, фрагмент конфигурации, ссылка на первичный стандарт или результаты измерений.
Почему шаблонные TL;DR и искусственная нарезка текста не работают в долгую
Важно провести грань между структурной ясностью и попытками механически подстроиться под парсер. Как справедливо отмечают авторы профильных разборов на MarTech и в отчётах Search Engine Roundtable (а также в обсуждении генерации сниппетов и длины описаний), поисковые алгоритмы не используют жёсткого «магического числа слов» для выбора сниппета или цитаты.
Более того, базовые ранжирующие системы Google (описанные в руководстве Creating helpful, reliable, people-first content) и регулярные обновления ядра (Core Updates) отсекают страницы, созданные путём поверхностной компиляции чужих материалов без добавленной ценности (Information Gain). Если страница состоит только из коротких пересказов без реальной технической фактуры, воспроизводимых сценариев проверки или собственных данных, она проигрывает на этапе базового ранжирования и просто не попадает в пул кандидатов для RAG.
5. Как измерять эффективность и ставить воспроизводимые эксперименты
Одно из самых частых препятствий при внедрении GEO и AEO в продуктовых командах — попытка оценивать результат по косвенным или недоказуемым метрикам. Чтобы не путать сезонные колебания спроса с эффектом от технических правок, работу стоит разделить на два контура: детерминированный технический контроль и наблюдательный анализ поисковых метрик.
Контур 1. Детерминированные проверки до и после релиза
Эти параметры имеют однозначный бинарный результат и должны проверяться автоматически на контрольной выборке URL из каждого типа шаблонов (карточка продукта, документация, категорийный листинг, статья):
-
Конечный код ответа
200 OKбез промежуточных цепочек редиректов у канонических адресов (документация Google по каноникализации дубликатов). -
Отсутствие блокирующих правил в
robots.txtдляGooglebotиYandex, а также отсутствие непреднамеренныхnosnippet/max-snippet:0в HTTP-заголовках и<meta name="robots">. -
Наличие основного содержательного текста, таблиц и заголовков
H1–H3непосредственно в первичном HTML-ответе сервера. -
Безошибочная валидация графа JSON-LD и соответствие значений в разметке видимому тексту страницы.
Контур 2. Измерение видимости и переходов с учётом ограничений инструментов
При анализе результатов в Google Search Console важно учитывать архитектурную особенность учёта трафика, явно зафиксированную в документации (AI features and your website — Measuring the performance of your site):
-
Показы и клики по ссылкам внутри AI Overviews и AI Mode включаются в общую статистику отчёта Performance внутри стандартного типа поиска
Web. -
Search Console не выделяет переходы из AI Overviews в отдельную вкладку поискового типа. При этом, как показывают исследования Search Engine Land, появление генеративного блока на информационном запросе часто меняет распределение кликов: общий CTR классических позиций может снижаться, тогда как пользователи, перешедшие по опорной ссылке из углублённого ответа, демонстрируют более высокую вовлечённость на странице.
Поэтому для корректной оценки изменений на сайте рекомендуется следующий протокол:
-
Фиксация контрольной и тестовой групп URL. Если вы перерабатываете структуру разделов (добавляете автономные блоки с определениями, таблицы спецификаций и связанную микроразметку
TechArticle/FAQPage), внедрите изменения сначала на фиксированной выборке страниц одного шаблона, оставив аналогичную группу страниц без изменений. -
Сегментация запросов по формулировкам. В выгрузке Search Analytics разделите короткие навигационные запросы и длинные составные запросы (вопросительные и сравнительные конструкции из 5+ слов, которые чаще всего инициируют веерное расширение Query Fan-out).
-
Сопоставление поисковых метрик с качеством сессий. Оценивайте не только изменение показов и CTR в отчёте
Web, но и глубину взаимодействия по целевым посадочным страницам в продуктовой аналитике (доскролл до целевых таблиц, взаимодействие с калькуляторами или документацией, целевые конверсии). -
Проверка внешнего консенсуса для брендовых и сравнительных запросов. Для запросов, где языковые модели сопоставляют несколько решений или брендов, внутрисайтовой оптимизации недостаточно: как показывают данные MarTech и Moz, генеративные системы опираются на независимые упоминания в отраслевых источниках, профильных сообществах и технической документации.
Такой подход возвращает обсуждение GEO и AEO в инженерное русло: вместо поиска «секретных тегов для нейросетей» команда последовательно устраняет преграды для индексации и формирования сниппетов, выстраивает чистый граф сущностей в разметке и проектирует структуру документов так, чтобы каждый раздел давал точный, проверяемый ответ как человеку, так и системе поиска.
ссылка на оригинал статьи https://habr.com/ru/articles/1104078/