Когда-то я писал о создании собственной RPG, и уже тогда в комментариях мне предложили внедрить в проект LLM для генерации квестов. В то время я довольно скептически отнёсся к этой идее. Однако технологии не стоят на месте: сейчас появился бесплатный API-доступ к языковым моделям (например, Gemini от Google), так почему бы не попробовать собрать что-нибудь на основе LLM? К тому же, помимо браузерного клиента игры, у меня когда-то был написан и текстовый клиент на Python, который можно переделать под генерацию промптов.
Сразу подчеркну, чем мой проект отличается от тех работ, которые стали появляться на хабре, или модов вроде Herika (Skyrim GPT). В большинстве из них языковая модель используется исключительно для общения с NPC. В моём же случае LLM в первую очередь совершает действия, а диалог — лишь приятный бонус. На первый взгляд разница кажется незначительной: какая разница, о чём спросить нейросеть — «что бы ты сказал?» или «что бы ты сделал?». На самом деле, разница принципиальная: сказать в можно всё что угодно, а вот сделать — нет.
Здесь я описываю наивную реализацию управления персонажа с помощью LLM: формирование на лету промпта и схемы ответа из поступающих с сервера игры данных, их отправка в LLM, получение и парсинг ответа, отправка команды на сервер, согласно ответу.
Общая схема
Игра — сетевая, обычно игроки подключаются к серверу через браузерный клиент, написанный на JavaScript. В отличие от таких проектов как NetHackers, среды minigrid для Reinforcement Learning или скажем последнего теста на AGI, онлайн игра подразумевает асинхронную работу. Сервер не ждёт команды от игрока, поэтому даже если ты ничего не делаешь мимо тебя могут пробегать другие игроки или гоблины (от последних можно и огрести). Поскольку всё асинхронно, да и ответ от LLM небыстрый, приходится всё делать на потоках. Нам нужно как минимум 3 потока:
-
основной, который будет получать строку с сервера и парсить её в структурированные данные;
-
поток, отправляющий запрос в LLM и ожидающий её ответа;
-
поток, ретранслирующий данные локальным браузерным клиентам, нужно же видеть картинку, что происходит. Разглядывать полотна текста не очень-то удобно.
Первый поток подключается к серверу и стартует остальные, генерирует и скидывает промпт во второй и забирает оттуда ответ, а также отправляет данные в ретранслятор, см. рисунок.
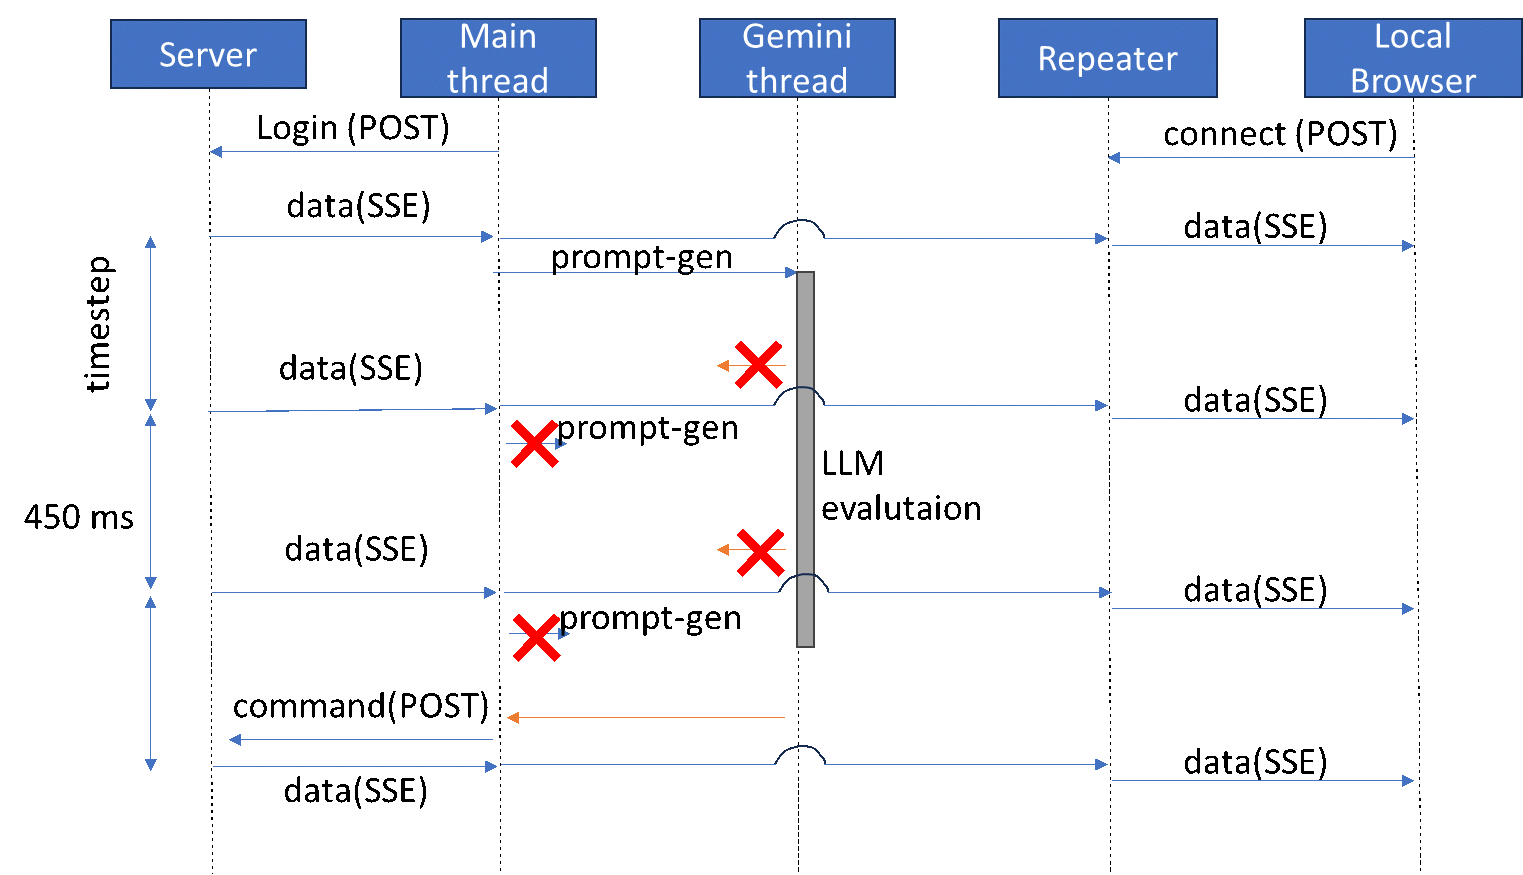
Из схемы сразу видна проблема – если LLM отвечает дольше, чем время игрового шага (а в моих экспериментах это так), то получается, что LLM пропускает некоторые шаги игрового мира. В LLM имеет смысл отправлять тот промпт, который соответствует ситуации уже после обработки предыдущего ответа, принятия действия и наблюдения результата. Иначе LLM не увидит результаты своих трудов.
Лимиты
Почти сразу я уперся в лимиты. Есть очевидные лимиты, указанные в тарифном плане, это число запросов в минуту (RPM), число запросов в день (RPD) и число токенов в минуту (TPM). Все эти величины считаются скользящим окном, а не обнуляются раз в минуту/день. Чтобы не превысить минутные лимиты на количество запросов, я просто разделил 60 на величину лимита и если ответ от LLM пришёл раньше этого времени, то просто подвешиваю поток на разницу. На бесплатном тарифе lite-моделям дозволено выдавать запрос раз в 4 секунды (для комфортной игры я выставил время дискретизации сервера 0.45 с, т.е. я успеваю обрабатывать LLM только каждый 10 игровой шаг в лучшем случае). С дневными лимитами уже ничего не поделаешь, после 500 запросов переключаем модель. Этот же Gemini посоветовал завести несколько аккаунтов, но я таким баловаться не стал, тем более что с одного IP такое палится на раз. По токенам у меня расход очень скромный, его почти не видно в масштабе лимита. Но есть ещё не оговоренный лимит: в API Gemini можно получать идентификатор ответа и его скармливать в последующий запрос (типа продолжение диалога), так вот, на длину такой цепочки тоже есть лимит. Ошибка называется «Conversation ancestor chain exceeds maximum validation depth.» Возможно, этот лимит не фиксированный, а зависит от заполнения контекстного окна. По моим ощущениям я достигаю этого лимита где-то за 100 итераций.
Генерация промптов
При запуске LLM-ного потока я сразу отправляю статичный запрос, который объясняет общие правила игры, какие бывают предметы, что можно делать, в каком виде давать ответ и т.д. Этот запрос я назвал MASTER-PROMPT, частично он написан руками, частично туда подставляются данные, сгенерированные «крафтовой системой»: набор предметов, рецепты (нам ведь не хочется тратить время на их самостоятельное нахождение?), здания и прочее. Когда LLM возвращает ответ, мы берём его идентификатор и подаем его в следующий запрос, см. рисунок ниже.
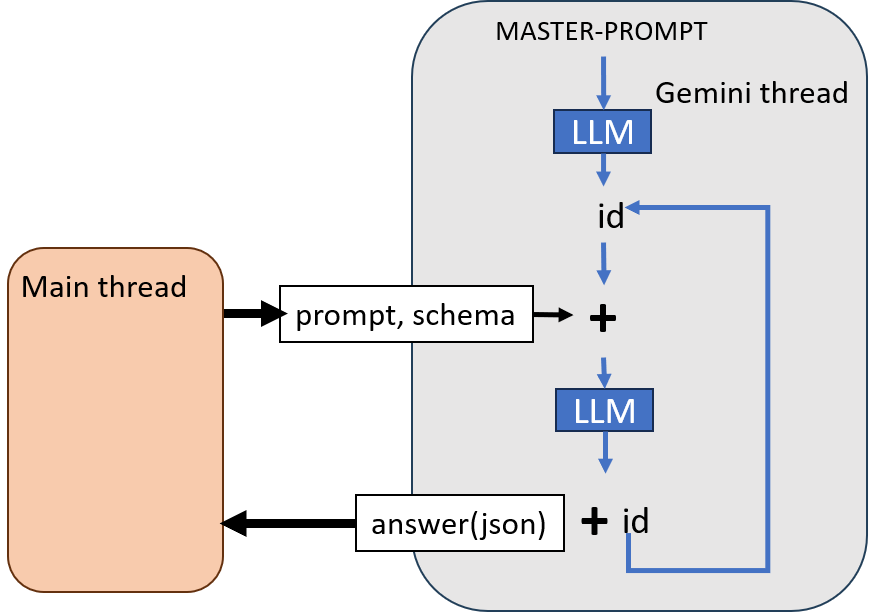
В современных LLM-ных API можно задавать схему ответа (в Gemini она называется response_format). Фактически это строгое требование вернуть ответ в виде валидного json с указанными полями, часть которых можно пометить «обязательными». Для содержимого полей можно указать тип данных и дополнительные свойства. Такая форма значительно упрощает парсинг ответа и избавляет от простыней ненужного текста (и, вероятно, излишней траты токенов). Я попробовал два варианта получения действия персонажа от LLM:
-
Под каждое возможное действие завожу численное поле от 0 до 1, а в MASTER-PROMPT прошу проставить в таких полях вероятность выбора данного действия. При парсинге пробегаюсь по всем числовым полям и выбираю действие с максимальным значением.
-
Делаю текстовое поле «action», в котором enum-ом перечисляю все возможные варианты. LLM-ка соответственно выбирает одно из них.
Не заметил особого влияния на результат, поэтому выбрал второй вариант, поскольку его проще парсить (опять же токенов должно тратится меньше). Кроме действия я ещё заставляю возвращать несколько полей: цель, планы, мысли и что сказать. Причем последнее делаю не обязательным, так персонаж может что-то сказать, если захочет, а может и промолчать.
Промпт генерируется из полученных наблюдений: что персонаж видит, что слышит, что делает в данный момент, его инвентаря, инвентаря оппонента (если торгуем) и т.д. Обработка наблюдений позволяет определить доступные игроку действия и добавить их в схему. Кстати, для перечня того, что можно скрафтить, пригодилась одна из прошлых разработок. Она же позволяет убрать из рецептов крафта те, что тратят, необходимые для более важной цели, ресурсы.
Память
Очевидно, что для нормального функционирования таких «агентов» необходима память. Я добавил «ячейковую память» — запоминаю важные объекты и их координаты, «событийную память», память о предыдущих действиях. LLM-ку регулярно приходится ловить за руку, она спокойно может сказать «кладу медь, олово, уголь и форму для литья» в плавильню, не имея половины из перечисленного. По этой причине добавил «память о дефиците» — когда разбираю строку с перечнем предметов и обнаруживаю несоответствие, прописываю недостающий предмет в эту память. Потом можно пробовать фильтровать действия, противоречащие дефициту. Например, если у вас есть дефицит по углю, то вам, скорее всего, не стоит пытаться разжечь печь или поместить туда ингредиенты. Т.е. вы раньше уже попробовали и обнаружили, что угля нет, и пока его не добудете, нет смысла пробовать ещё.
Пример сгенерированного промпта
You stay at coordinates [0, 0] and facing East. You are staying, you HP = 50. Your inventory has changed. It is now as follows: bone(x133), stone(x298, equipped), piece of copper ore(x4), flint stone(x14), bone knife(x30), brick(x5), berry(x3), unfired brick(x16), unfired bowl(x1). You will need the following materials and tools to achieve your aim: clay (2x), coal (3x), tin_ore (1x), handle (1x), flammable (12x), fuel (9x). Pay attention to the places where they can be found or purchased. It probably doesn’t make sense to build anything until all ingredients are found. You need to produce or buy these things to achieve your aim: bronze_pickaxe_head[1], copper[2], tin[1], pickaxe_mold[1], brick[10], bowl[1]. You see: clay wall at[2, 1], wall at[2, 2], wall at[4, 0], clay wall at[4, -2], damaged granite wall at[3, 4], fire furnace at[2, 0], stone-like objects on the floor at[2, -1], stone-like objects on the floor at[1, 2], stone-like objects on the floor at[3, 0], stone-like objects on the floor at[3, -1], stone-like objects on the floor at[2, 3], stone-like objects on the floor at[3, -3], stone-like objects on the floor at[3, 4] and free cells at [2, -1], [1, -1], [1, 2], [3, 0], [3, -1], [3, -2], [2, -2], [2, 3], [4, -1], [4, -3], [3, -3], [5, -2], [0, 0], [0, 1], [1, 0], [1, 1]. The clay wall is in front of you. This could get you the resources you need. Mining the wall at coordinates [2, 2] may yield the resources you need. Mining the wall at coordinates [4, 0] may yield the resources you need. Mining the wall at coordinates [4, -2] may yield the resources you need. The fire furnace is in front of you. You can craft: bone_knife, bone_awl. Negative experience with the furnace: you put in 15 unfired bricks and 1 coal, ignite it, and the bricks remained unfired. Positive experience with the furnace: you put in 3 unfired bricks 1 coal and 1 kindling, ignite it, and the bricks became fired. Recent events: timestep 291: the furnace fired up at [(2, 0)]; timestep 295: the furnace cooled down at [(2, 0)]; timestep 316: You cancel exchange/trade, there are no useful items to take or to give, don’t trade/exchange with the same person/object; timestep 332: the furnace fired up at [(2, 0)]; timestep 336: the furnace cooled down at [(2, 0)]; timestep 358: You cancel exchange/trade, there are no useful items to take or to give, don’t trade/exchange with the same person/object; timestep 374: the furnace fired up at [(2, 0)]; timestep 378: the furnace cooled down at [(2, 0)]; timestep 400: You cancel exchange/trade, there are no useful items to take or to give, don’t trade/exchange with the same person/object; timestep 417: the furnace fired up at [(2, 0)]. Your previous actions were: use_flint_stone, mine, cancel, use_flint_stone, mine, cancel, use_flint_stone, mine, cancel, use_flint_stone. Your primary objective right now is to obtain piece of coal, bundle of kindling. Resolve this before moving on to the main goal. Your last aim was «Obtain piece of coal and bundle of kindling», set 240 steps ago.
Результаты
В принципе, это худо-бедно работает: управляемый LLM-кой игрок ходит, собирает предметы, пытается получить металлы из руды (иногда это у него выходит), строит здания, однажды ему даже удалось построить плавильню, загрузить туда правильные предметы и отлить наконечник кирки (один из самых сложных рецептов в текущей крафтовой системе). Правда до этого он очень долго бродил туда-сюда и нашел кучу полезных предметов от какого-то погибшего дварфа, так что многие ингредиенты достались ему нахаляву.
В то же время, назвать поведение такого агента разумным никак нельзя. Он часто попадает в какую-то мертвую петлю: то крафтит один и тот же предмет, не особо нужный, то крутится на месте, то застревает в обменах с объектами. Не особо понимает координатное описание, проходит мимо полезных ресурсов, хотя ему явно в промпте пишется – «справа стена с нужными тебе минералами» — пройдет мимо, не повернётся.
Из приятных моментов – хорошее сопровождение репликами, говорит по делу, комментирует свои действия, пытается разговаривать с пробегающими мимо дварфами-NPC.
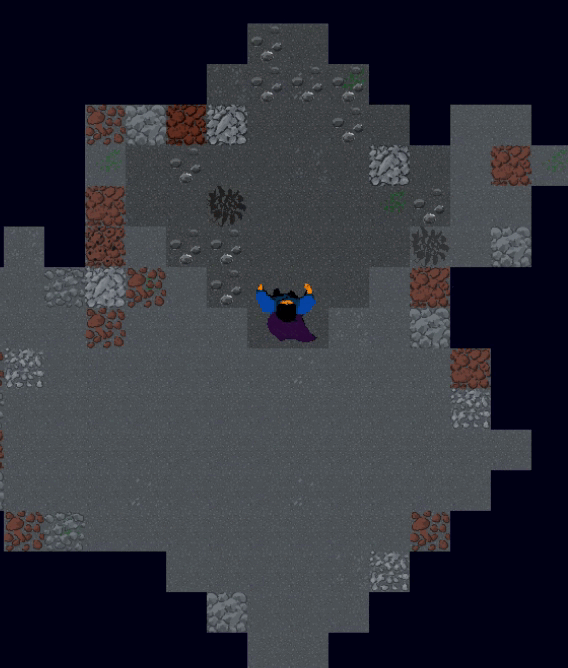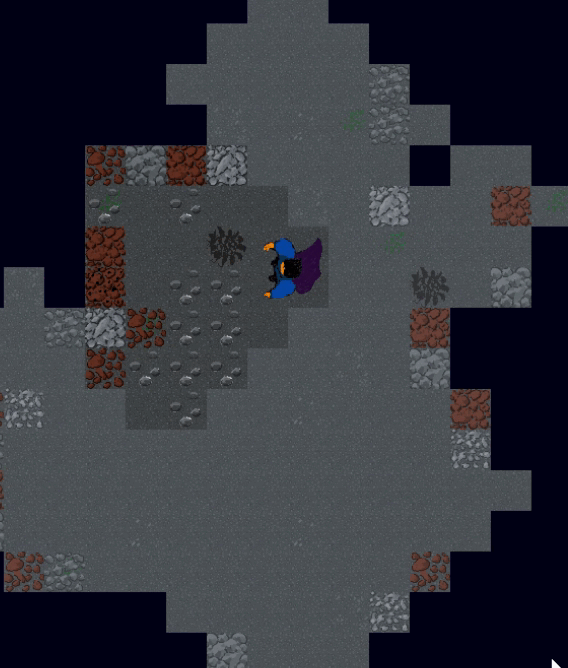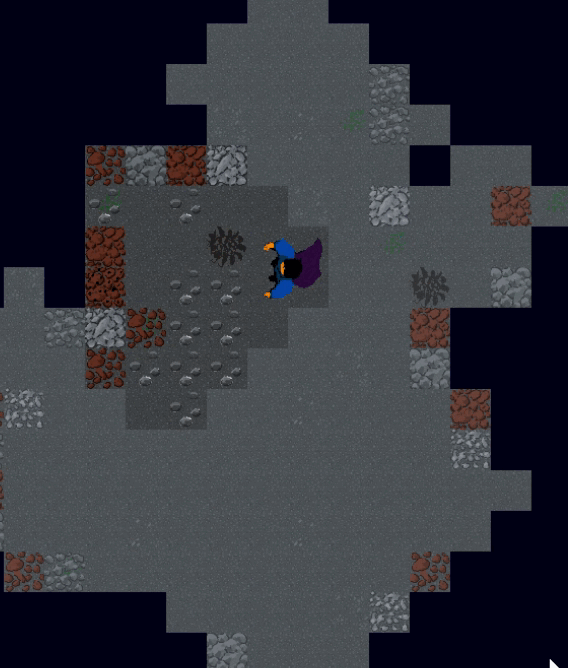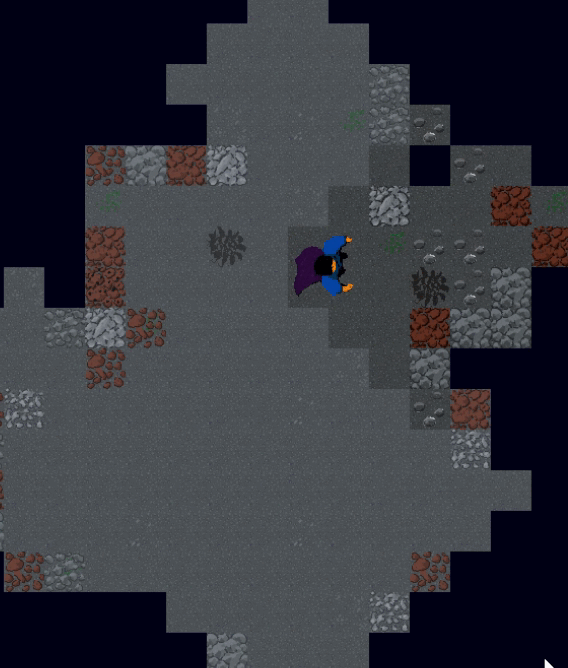
Небольшой пример движения в виде гифки
Торговля
Из забавного. В игре есть дварфы, у них очень хороший алгоритмический искусственный интеллект, они целенаправленно добывают ресурсы, сражаются с гоблинами, умеют строить, крафтить и даже торговать. Единственное что, торговля реализована только пассивная, сами они не инициируют обмен с игроком. Однако они умеют оценивать товары согласно текущему своему состоянию, отказываться, если предложенный обмен невыгоден, а если игрок спросит – могут сообщить, что они хотят купить.
Мой агент несколько раз пытался торговать с дварфами, но чаще всего дварфы отказываются брать тот хлам, который предлагает агент. Тем не менее один раз ему удалось обменяться, правда себе в убыток: променял все имеющееся олово на 4 порции медной руды, один уголь и 2 глины (т.е. редкие ресурсы на гораздо более часто встречаемые).
Поля json-ответа, отвечающие за обмен
"give_list": "7 piece of tin","take_list": "4 piece of copper ore; 1 piece of coal; 2 piece of clay",
Заключение
-
Самая банальная и в то же время самая разрушительная проблема – это скорость. Если бы запрос обрабатывался за полсекунды, то можно было бы всё сделать синхронно, а, главное, обрабатывать бы все, что происходит подряд, без разрывов. Может быть надо попробовать развернуть какую-нибудь небольшую локальную LLM.
-
Ожидаемо, у LLM плохо с пространственным воображением, передача всей топографической информации в виде перечня с координатами работает плохо.
-
Можно ещё добавить диалоговую память и посмотреть на общение агентов, но тогда точно лимитов Gemini не хватит, надо искать альтернативу.
-
Пока такое ощущение, что LLM можно поручить генерировать высокоуровневые команды и речь, но реализацию надо делать какими-то более эффективными методами. Т.е. она может решить, что нужно подойти к такому-то объекту, а как это сделать, лучше предоставить какому-то другому алгоритму.
ссылка на оригинал статьи https://habr.com/ru/articles/1104606/