Когда мы в августе смотрели, как агенты применяют техники тестирования и верификации¹, вышло так: GPT-5.6 Sol выдавал скорее карикатуру на технику, если его просили работать по TDD, с QuickCheck, с Lean 4 и так далее. Когда конкретный способ тестирования не указывали (назовём такое условие Default), агент писал кучу бесполезных юнит-тестов, и это всё равно оказалось одним из лучших условий: просьбы тестировать определённым способом в основном делали результат хуже. В том эксперименте мы давали агентам RFC на Zstd и просили реализовать формат. Во всех условиях, кроме Default, к заданию добавлялась приписка о том, как тестировать.
Повторный прогон того же эксперимента на GPT-6 Astra показал два крупных отличия:
-
Astra стала настолько способнее, что нужна задача потруднее: на реализации Zstd почти каждое условие почти каждый раз даёт 100% корректности на уровне усилий medium, какую технику ни возьми.
-
Похоже, агенты стали применять техники тестирования и верификации осмысленнее.
По первому пункту: раньше, когда агенты реализовывали Zstd по RFC с помощью 5.6 Sol, в среднем они тратили $3,50 на уровне medium и $5,50 на уровне xhigh, а полной корректности на скрытых тестах добивались примерно в 63% и 77% случаев соответственно. С Astra агент тратит $1 и на уровне medium проходит все тесты более чем в 99% случаев.
По второму пункту пример такой. Когда мы просили 5.6 Sol заняться фаззингом, он генерировал массу бесполезных случайных входов, которые в основном проходили по одним и тем же путям в коде и ничего интересного не проверяли. Агенты на 6 Astra в той же просьбе фаззят структурированно: реально задействуют пути в коде и находят нетривиальные баги. Вот только улучшило ли это корректность, сказать нельзя, потому что бенчмарк на Zstd упёрся в потолок.
Ещё мы пробовали давать 5.6 Sol RFC на IMAP, но для этой модели задача оказалась слишком сложной. С 6 Astra получается такое распределение результатов (по оси Y — процент прогонов, в которых прошли все тесты; сами тесты агентам не показывают; каждая точка — результат 80 прогонов одного условия).
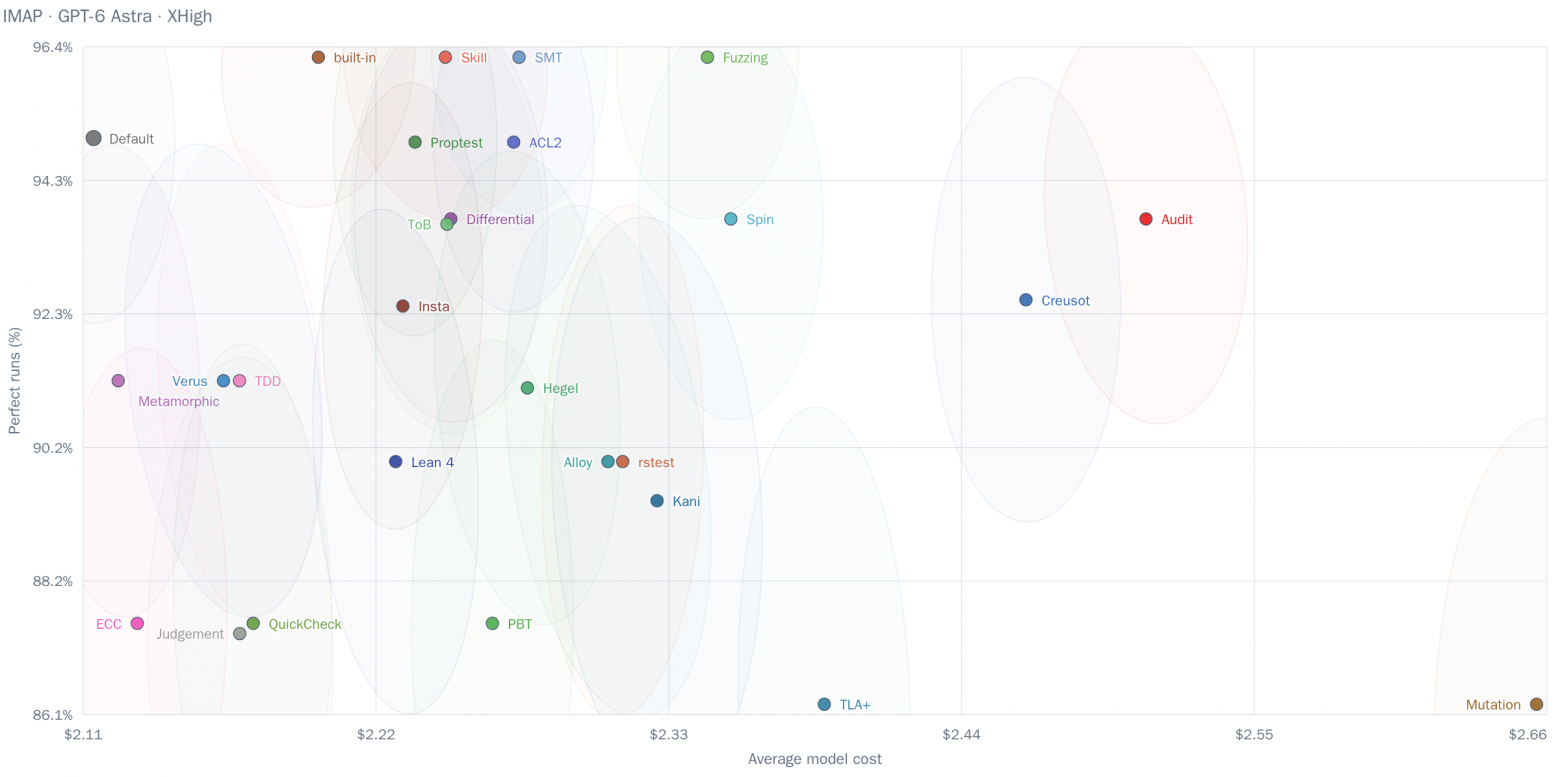
IMAP, GPT-6 Astra, уровень xhigh. По оси X — средняя стоимость прогона, по оси Y — доля безошибочных прогонов. Интерактивная версия на сайте автора.
Default снова выглядит неплохо. Некоторые условия дают чуть более высокую корректность, но и стоят дороже. RFC на IMAP потолка ещё не достиг, и всё же хотелось бы увидеть результаты на задаче потруднее: большую часть времени я занимаюсь задачами, которые агенты чаще всего не решают с одной попытки. Для этого возьмём эксперимент с pandoc, который мы разбирали, когда сравнивали языки программирования. Посмотреть на задачи покрупнее я хочу ещё и потому, что на них модели нередко ведут себя заметно иначе. Мы видели это на примере «пещерного режима» и на примере языков. С пещерным режимом большие выигрыши, о которых рассказывали люди, уменьшились или вовсе исчезли. С языками это проявилось сразу в нескольких вещах: например, реализации Zstd на C и C++ с безопасностью памяти справлялись хотя бы более-менее, а реализации Pandoc на тех же языках страдали от проблем с памятью сплошь и рядом.
Pandoc намного сложнее. Даже после нескольких ходов (в среднем примерно 14) ни одно условие не добралось до 100% корректности, поэтому будем смотреть не на долю прогонов со 100%, а на долю пройденных тестов.
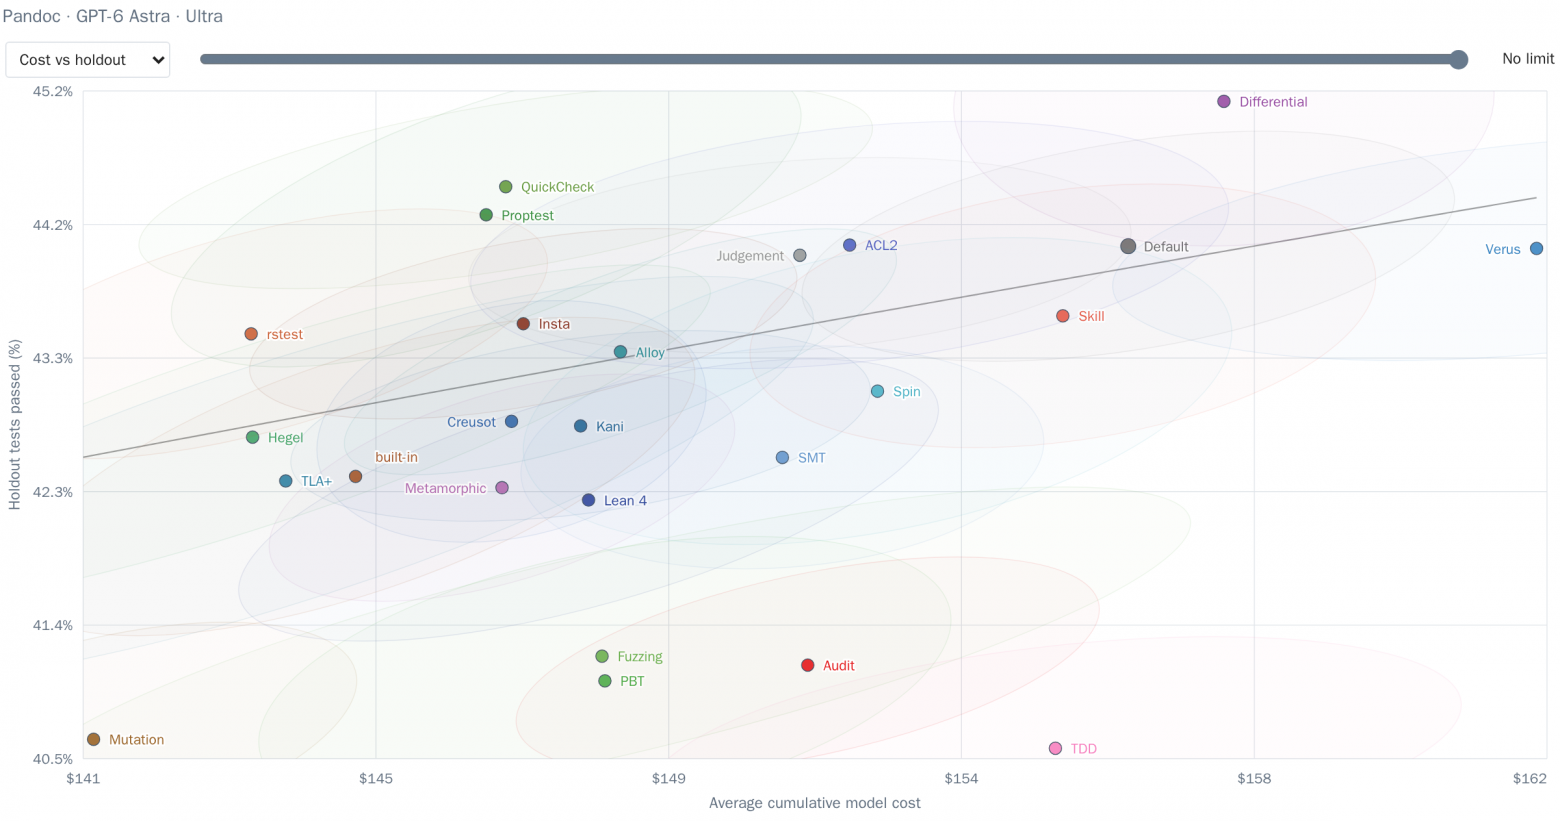
Pandoc, GPT-6 Astra, уровень Ultra. По оси X — средняя накопленная стоимость, по оси Y — доля пройденных скрытых тестов. Линия — кривая, подогнанная по Default. Интерактивная версия с ползунком лимита расходов и другими срезами.
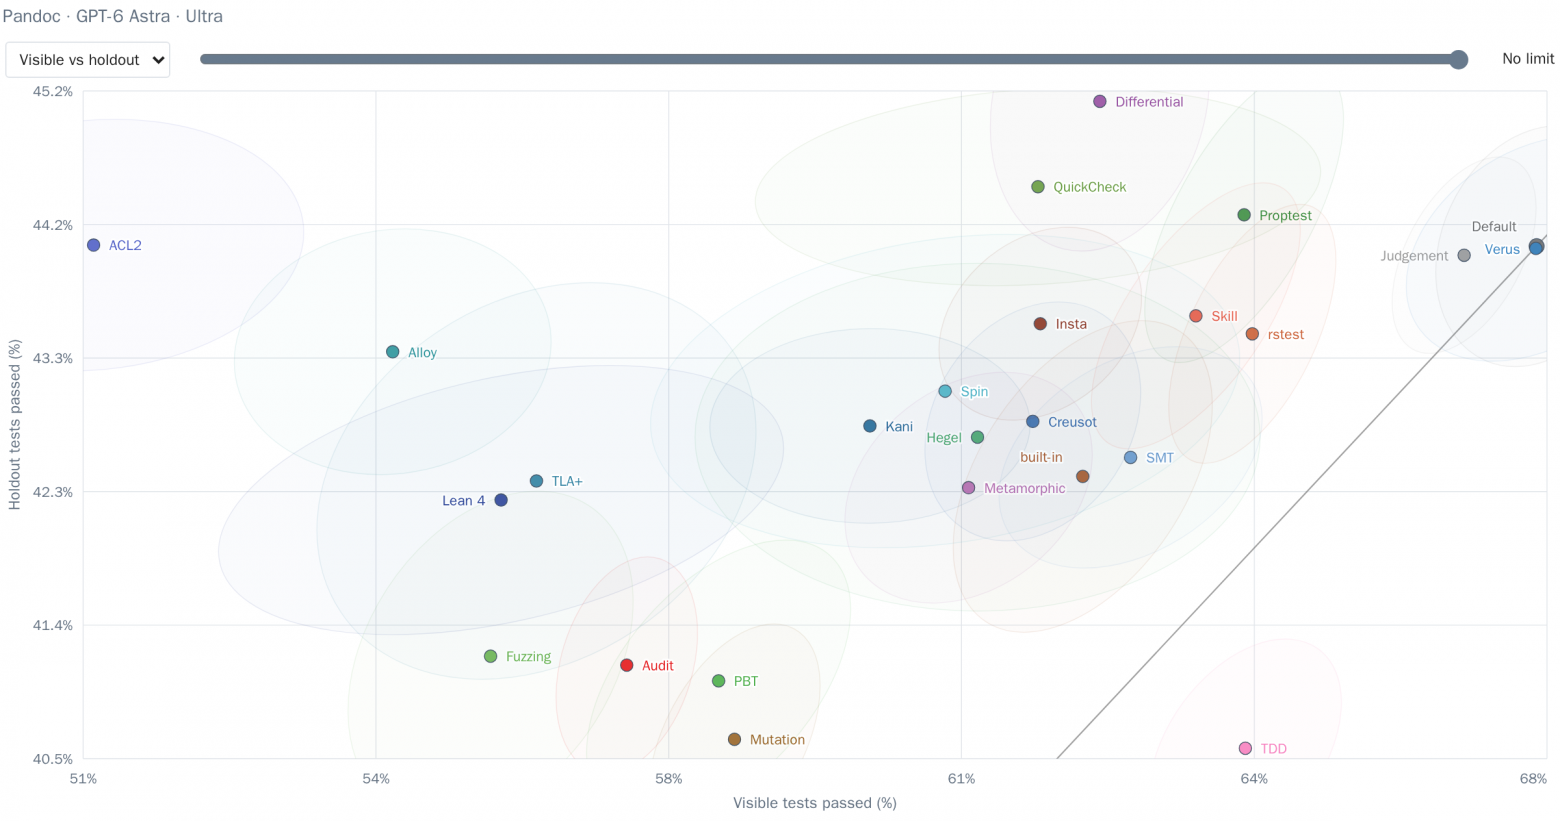
Тот же эксперимент в срезе «видимые тесты против скрытых».
Из-за цены каждое условие здесь запускалось всего 25 раз. По розничным ценам это обошлось примерно в 90 тысяч долларов.
Прим. пер.: на сайте автора график интерактивный, а одна картинка показывает только один срез, поэтому ниже итоговые цифры из данных, встроенных в этот график. Таблицу собрал переводчик, в оригинале её нет. Для каждого прогона взята последняя оценённая версия, лимит расходов не задан, значения — средние по 25 прогонам. Порядок строк не рейтинг: автор ниже объясняет, почему разницу в доли процента нельзя принимать за разницу между техниками.
|
Условие |
Скрытые тесты, % |
Видимые тесты, % |
Средняя стоимость, $ |
|---|---|---|---|
|
Differential |
45,1 |
62,5 |
157 |
|
QuickCheck |
44,5 |
61,8 |
147 |
|
Proptest |
44,3 |
64,2 |
147 |
|
ACL2 |
44,1 |
50,8 |
152 |
|
Default |
44,1 |
67,6 |
156 |
|
Verus |
44,1 |
67,6 |
162 |
|
Judgement |
44,0 |
66,7 |
151 |
|
Skill |
43,6 |
63,6 |
155 |
|
Insta |
43,5 |
61,8 |
147 |
|
rstest |
43,5 |
64,3 |
143 |
|
Alloy |
43,3 |
54,3 |
149 |
|
Spin |
43,1 |
60,7 |
152 |
|
Creusot |
42,8 |
61,7 |
147 |
|
Kani |
42,8 |
59,9 |
148 |
|
Hegel |
42,7 |
61,1 |
143 |
|
SMT |
42,6 |
62,9 |
151 |
|
built-in |
42,5 |
62,3 |
145 |
|
TLA+ |
42,4 |
56,0 |
144 |
|
Metamorphic |
42,4 |
61,0 |
147 |
|
Lean 4 |
42,3 |
55,6 |
148 |
|
Fuzzing |
41,2 |
55,5 |
148 |
|
Audit |
41,1 |
57,0 |
151 |
|
PBT |
41,0 |
58,1 |
148 |
|
Mutation |
40,6 |
58,3 |
141 |
|
TDD |
40,5 |
64,2 |
155 |
Напомню: в прошлых экспериментах с языками и техниками тестирования сбои часто были странными следствиями того, как работают агенты. Агенты на Clojure по умолчанию писали неправильный код преобразования байтов, агенты на Verus писали пустые доказательства. Это совсем не похоже на причины, которые приводят люди, когда советуют агентам конкретный язык или технику. Обычно это приятные на слух объяснения, почему что-то должно быть лучше. Звучат они очень по-человечески, но, судя по тому, что агенты делали на самом деле, с реальностью не связаны².
Поскольку прогонов здесь было «всего лишь» на 90 тысяч долларов, мы почти ничего не можем объяснить: данных для этого мало. Мы видим, что некоторые условия отработали лучше других, но что это значит, сказать трудно. Так что далеко идущих выводов делать не стоит. Кое-что, впрочем, согласуется с ожиданиями. Можно было предположить, что большинство предложенных техник и библиотек дадут лучшее обобщение, то есть более высокий результат на скрытых тестах относительно видимых (на графике «видимые против скрытых» точка выше и левее линии Default), а TDD обобщит хуже (ниже и правее этой линии).
Но если проверка свойств действительно даёт лучшее обобщение, а условия вроде TDD, порождающие много мелких тестов, обобщают хуже, то и у условия built-in отношение скрытых тестов к видимым должно быть ниже, чем у Default. Этого мы не увидели. Почему, непонятно, и без гораздо большего числа прогонов определить это, думаю, нельзя.
Что до самих результатов: линии на графиках «стоимость против скрытых» и «стоимость против видимых» — это кривые, подогнанные по форме всех траекторий на протяжении нескольких ходов, причём подгонка сделана по Default. То, что ниже и правее линии, можно считать худшим результатом, то, что выше и левее, лучшим. С 5.6 Sol было ясно, что условия тестирования в целом не приносят пользы, и причин тому было несколько:
-
Почти ни одно условие не обошло Default.
-
В других экспериментах (подробно здесь не разбираются) похожие промпты тоже не обошли Default.
-
Тесты, которые писали агенты в условиях, отличных от Default, были в основном нелепыми и не передавали ценности техники.
Здесь же многие разные техники показывают результат лучше Default. Настоящая неопределённость по каждому условию довольно велика (больше, чем показывают бутстрэп-интервалы на графиках), но условий, обошедших Default, так много, что одно или несколько из них правдоподобно обходят его на самом деле, пусть мы и не знаем, какие именно. Более того, некоторые условия, вероятно, и правда лучше других, но данных недостаточно, чтобы сказать, какие в целом сильнее. Куда проще, когда почти всё выглядит плохо сразу по множеству техник.
Вот какие вопросы у меня есть к результатам:
-
Насколько эти результаты можно экстраполировать на большее число ходов, чтобы приблизиться к почти полной корректности на Pandoc? Обычно условия с новыми ходами примерно сохраняют порядок, так что правдоподобно, что расстановка останется прежней, но это не проверено.
-
Какая часть результатов объясняется малой выборкой по каждому условию? В эксперименте с Pandoc мы запускали каждое условие «всего» 25 раз. Ходов было много, но и из прошлых экспериментов, и просто из работы с агентами мы знаем, что при циклической работе над сгенерированным кодом результат сильно зависит от пройденного пути.
-
Какая часть результатов объясняется малой выборкой по мелким, почти незаметным вариациям? Несколько дурацких экспериментов показали мне, что на одну и ту же просьбу можно получить очень разные результаты из-за пустяковых изменений: другого построения фразы, другого регистра букв и так далее. Сколько в нынешних результатах такого случайного?
-
Какая часть результатов объясняется малой выборкой по самим задачам? Мы посмотрели на одну задачу «размером с Pandoc». Если посмотреть на сто, насколько Pandoc окажется показательным?
Если бы я всерьёз хотел ответить на эти вопросы, пришлось бы запустить как минимум в 100 раз больше, чем здесь, чтобы покрыть всю матрицу. Стив Йегге упоминал, что с помощью примерно 20 подписок на Claude тратит около 120 тысяч долларов токенов в месяц по розничным ценам. Сотню раз на такой установке не наберёшь, но в 2–3 раза больше сделать можно, если расширить тестирование ограниченно и подключить немного догадок и экстраполяции. Есть ли мне смысл этим заниматься, не уверен: времени уйдёт много, свободного у меня мало. Но если вспомнить, что изучали учёные, когда исследовали продуктивность программистов, может, этим стоит заняться аспиранту: информации это даст больше, чем ряд широко цитируемых работ. А вот кто взялся бы за такое в индустрии, кроме ИИ-лаборатории, не знаю.
При всём этом, если держать в голове, что мы не знаем, насколько хорошо результаты обобщаются, вот что показалось мне интересным:
-
Дифференциальное тестирование заставило агентов разбираться в тестах и инвариантах так, что это дало более глубокое «понимание», чем в других условиях.
-
TDD снова отстал, но отстали не все условия, при которых агенты пишут много мелких тестов.
-
ACL2 (средство доказательства теорем) показал себя хорошо (как и в эксперименте с Zstd на 5.6 Sol).
-
Тестирование на основе свойств (речь про ряд библиотек, вынуждающих применять эту технику, условие с таким названием тут ни при чём) наконец дало тесты, которые делают то, на что от такого тестирования обычно рассчитываешь.
(1): Я пытался добиться этого от агентов с помощью наспех написанного скила для эксперимента с Zstd на 5.6 Sol. Сам скил отработал прилично, но агенты по сути этого не делали. А вот в эксперименте с Pandoc дифференциальное тестирование действительно заставило агентов внимательно разбирать граничные условия и придумывать, как написать тесты (а значит, и код), которые правильно реализуют обе стороны границы. Я не уверен, что это обобщается, но было бы интересно проверить, обобщается ли, и что ещё может заставить агентов делать такое систематически.
(2): Отставание TDD — ровно то, чего я и ждал (напомню, в эксперимент с 5.6 Sol я добавил TDD потому, что считал: он покажет себя слабо). Но раз другие условия, порождающие много мелких тестов, не отстали, доверия к правдоподобному объяснению «много мелких тестов — хуже результат» должно стать меньше.
(3): Мне давно кажется, что ACL2 недооценён по сравнению с другими средствами верификации (в некоторых областях промышленности его применяли широко и с хорошим эффектом, если сравнивать с объёмом академической работы о нём). Уверенности в этом мнении у меня было мало и остаётся мало, но в проведённых мной экспериментах он пока работает хорошо. Учитывая, сколько усилий вкладывается в то, чтобы агенты эффективно работали с Lean, я ожидаю, что со временем Lean обойдёт ACL2, даже если сегодня ACL2 впереди. Но сегодня ACL2 не кажется плохим выбором. Если вы занимаетесь верификацией или доказательствами на Lean 4, мне было бы любопытно узнать, как ваши результаты соотносятся с ACL2.
(4): Ура (возможно). По всем причинам выше я не слишком уверен, что это обобщается, но Proptest снова показал себя хорошо. И на этот раз тестирование было намного лучше, чем в эксперименте с Zstd на 5.6 Sol. Инсайдерских сведений у меня нет, но я бы предположил, что между 5.6 Sol и 6 Astra не было какой-то большой работы именно над тестированием на основе свойств, фаззингом и прочим, и улучшение пришло от лучшего обобщения и выросших способностей. Если это так (и если дело тут не в том, что я потратил 90 тысяч по розничным ценам вместо 9 миллионов), то для будущего тестирования это хороший знак: стоит ожидать, что модели будут лучше тестировать и без отдельных усилий по улучшению этих навыков.
Пока я прогонял эти тесты и готовил пост, завирусилось утверждение, что агентам надо запретить писать тесты (на основе прогона DeepSWE). Звучало оно так:
ok it’s official… [многоточие в оригинале] юнит- и интеграционные тесты, написанные ИИ, эмпирически доказанно бесполезны. скажите своим агентам, чтобы перестали сами писать тесты
Как мы уже отмечали, DeepSWE, на мой взгляд, не отражает работу, которой занимаюсь я, поэтому для меня лично он ничего не значит. К тому же там использовался Sonnet 5.5 High, так что в целом он справлялся только с задачами намного легче тех, что разобраны здесь. А и здесь, и в других недавних экспериментах видно: выводы об эффективности техник часто не переносятся на задачи другого размера или сложности. Мне кажется правдоподобным, что на задачах, которые кодинг-агентам даются совсем легко, запрет на тесты снижает стоимость (именно это и было показано, если вам вообще важен DeepSWE). Но обобщать это до «юнит- и интеграционные тесты, написанные ИИ, эмпирически доказанно бесполезны» на основании такого теста кажется неверным независимо от того, верно ли это для других задач, и вряд ли утверждение верно. Оно опиралось на просьбу не писать тесты, что дало похожую корректность и небольшую экономию (в среднем 9%). В наших тестах, и здесь, и раньше, мы видим и разницу в корректности, и разницу в стоимости больше 9%, так что утверждение вроде «юнит- и интеграционные тесты, написанные ИИ, эмпирически доказанно бесполезны», основанное на 9-процентной разнице в цене на бенчмарке из мелких задач, вряд ли верно. Стоит заметить и то, что проверяющая система DeepSWE в отношении тестирования сломана: помимо прочего, агент может добавить тест, имя которого совпадёт с именем секретного теста проверяющей системы, и это вызовет сбой. Из-за таких проблем добавление тестов наказывается по самому устройству бенчмарка, а это не отражает реальное использование.
Можно сказать, что утверждение сработало блестяще: заявить с преувеличением, что нечто эмпирически доказано, — отличный способ завируситься³ или собрать кучу цитирований. Но для выяснения того, как эффективно работать с кодинг-агентами, такой способ не годится.
В недавнем посте Нолана Лоусона о том, как выбор JavaScript-фреймворка влияет на агентов, он заметил:
Моя цель не в том, чтобы написать окончательный бенчмарк на тему «я вайб-кодер, какой фреймворк мне выбрать?». Смысл этого поста — показать, что в эпоху кодинга с ИИ всё ещё можно принимать решения на основе данных вместо ощущений.
Здесь я чувствую то же самое: думаю, запускать игрушечные эксперименты и смотреть на результаты полезно. Думаю, даже человек с ресурсами ИИ-лаборатории не смог бы сказать, что X или Y «эмпирически доказанно бесполезны [или полезны]», но какую-то информацию мы всё же получить можем.
Судя по увиденному в наших экспериментах, если бы мне понадобилась библиотека тестирования на основе свойств для Rust, я бы склонялся к proptest, а для любой задачи, где я взял бы Lean, склонялся бы попробовать ещё и ACL2, чтобы посмотреть, как отличаются результаты и не станет ли лучше. Остаётся и немало сведений, которые складываются в такое вот интуитивное ощущение.
Как я отмечал в N последних постах, я стараюсь описывать каждый такой эксперимент за 30 минут: результатов слишком много, а времени мало. Поэтому разбирать, что случилось в каждом условии, как в эксперименте с Zstd на 5.6 Sol, не буду. Я и так уже вышел за 30 минут, поэтому остановлюсь здесь, а к тестированию и верификации, возможно, вернёмся в будущем посте.
Спасибо Лоренсу Трэтту, Эдварду З. Яну, Софии Уиздом и Марко Прими за комментарии, исправления и обсуждение.
Приложение: почему ИИ-лаборатории не публикуют больше сравнений эффективных техник?
В отличие от нас, случайных людей, у них действительно есть ресурсы на относительно полные эксперименты, а информации о том, что работает, вообще не хватает. Если бы люди лучше понимали, как пользоваться ИИ, похоже, они бы и пользовались им больше. К тому же, по моему опыту, с моделями OpenAI и с моделями Anthropic работают разные техники. Если бы одна из компаний публиковала хорошие сведения о том, что работает с её моделями, это могло бы подтолкнуть людей к такому взаимодействию с агентами, которое выгодно этой компании.
Довод против, наверное, примерно такой: выручка растёт так быстро, что на другой работе можно заработать больше, и/или разница в том, как люди пишут промпты, всё равно не имеет значения. Со стороны первое мне кажется правдоподобным, а второе, по-моему, верным быть не может: я не раз видел, как разумные люди, не делающие явных глупостей, получают очень разные результаты, вплоть до того, что один не может получить рабочее решение задачи, с которой другой легко справляется. Если результаты «настоящие» и не вызваны тем, что проверялся достаточно широкий набор вещей, эффект больше, чем кажется при беглом взгляде на график: по мере того, как мы вкладываем в реализацию Pandoc больше усилий, ходов и долларов, отдача в корректности падает. Это видно по линии подгонки Default: её наклон намного меньше, чем у прямой из (0,0) в точку Default, и это заметно по самой кривой. При этом различия, которые я наблюдал на практике от того, как люди пишут промпты, намного больше, чем то, что мы видим, меняя технику тестирования парой слов в задании. Думаю, это довольно неудивительно (мы и не ждём каких-то волшебных слов о тестировании, дающих улучшение в 10 раз), но из-за этого эксперимент, выявляющий различия в том, как люди пишут промпты, получается трудным и дорогим.
Приложение: комментарии об агентном тестировании
Дэвид Р. Макайвер заметил:
Кстати, по своим проверкам скила я замечаю одну вещь: ChatGPT куда меньше увлекается тестированием на основе свойств, чем Claude. Claude довольно охотно пишет такие тесты и, похоже, получает от них пользу при разработке в моих текущих бенчмарках, а ChatGPT sol этого не делает, если сильно не настаивать. Так что тут может быть чувствительность к промпту, а может быть и особенность модели. Я пока вообще не оптимизировал скил под ChatGPT, так что, возможно, нечаянно что-то для него запорол. Кстати, я на самом деле не знаю, что Claude лучше в тестировании на основе свойств, чем ChatGPT (надо бы это проверить). Он просто проявляет больше инициативы, но вполне возможно, что, когда они действительно пишут свойства, качество примерно одинаковое.
С Claude я не проводил столь же широкого тестирования. Учитывая сказанное Макайвером, правдоподобно и то, что Claude лучше в тестировании на основе свойств, и то, что нет. Кроме того, поскольку он разрабатывает Hegel и в основном работает с Claude, правдоподобно и то, что Hegel лучше работает с Claude, чем с Codex, и с Claude мы увидели бы у Hegel результаты получше. Так что тут может быть чувствительность к промпту, а может быть и особенность модели.
На графике этого нет, но и исходный скил Hegel, использованный в эксперименте с Zstd на 5.6 Sol, и обновлённый, созданный после того, как Макайвер дополнительно проверил скил после того эксперимента, отработали хуже, чем Hegel без скила. Корректность была довольно близкой, а стоили оба намного дороже, причём обновлённый скил дороже исходного. Мне кажется довольно интересным, что скил, улучшенный для одних случаев, стал хуже в других. Как мы обсуждали в прошлом посте, некоторые виды скилов (например, скилы по техникам тестирования), работающие на разных моделях и уровнях усилий, похоже, написать очень трудно. Отсюда же ещё одно наблюдение: условие Skill, то есть скил, который я быстро набросал на основе своего опыта управления агентным тестированием с GPT-5.5 и GPT-5.6 Sol, в эксперименте на 5.6 Sol показало себя хорошо, а здесь, с 6 Astra на Pandoc, слабо. Человек с большим опытом управления тестированием на 6 Astra и на задачах покрупнее, вероятно, мог бы написать скил, который в таких условиях сработает лучше, по крайней мере на задачах, похожих на те, над которыми он работал. Но я не изучал эффективность тестирования на Astra достаточно серьёзно, чтобы написать такой скил самому.
Кстати, по разным случайным причинам я привык к Codex. Вроде бы справляюсь. Это мало что говорит о том, насколько эффективно я работал бы с Claude.
Роман Левентов написал:
Привет, Дэн! Твой пост про ИИ-кодинг подтолкнул меня попробовать фаззинг и генеративное тестирование.
Часть системы, которую я разрабатываю, устроена примерно как диаграмма состояний. Представь чат поддержки, где автоматика может предлагать действия или сообщения, которые сотрудник поддержки (человек) отправляет пользователю. LLM сообщений не пишет, её дело — классифицировать некоторые намерения обращений. Переходы между состояниями детерминированы. Могут приходить и внешние события о предмете обращения, которые существенно влияют на возможные следующие действия или решения. Всё это порождает богатую систему состояний. Написана она на TypeScript.
Мне пришлось переписать значительную часть этой системы, и, чтобы снизить риски переписывания и заодно попробовать фаззинг, я решил применить его в процессе. Первые 5 дней я работал с sol xhigh, потом ещё 4–5 дней в основном с astra medium или high (примерно тогда astra и вышла). Я поручил агенту написать генератор трасс из всех возможных видов событий и эффектов, влияющих на логику.
Первые 4 дня генеративное тестирование не могло найти ни одного нового дефекта, который агенты-ревьюеры не нашли бы сами раньше. Я всегда работаю так: определяю множество углов, областей и зон ревью (для этого переписывания их было около 15), заставляю агентов сгенерировать по моим шаблонам довольно подробный промпт для каждой области, а затем запускаю в этих областях субагентов с дословными промптами, пока они находят дефекты или что-то, что надо исправить.
Всего за время переписывания агенты-ревьюеры нашли примерно 210 багов и дефектов, а сгенерированные тесты под конец немного разогнались и дали около 20 новых дефектов, которых сами агенты не заметили. Итого примерно 230.
Изменения в продакшен-коде составили около 30 тысяч строк, а тестовая обвязка со всем, что написано специально для поддержки этого подхода, к концу выросла примерно до 300 тысяч строк. Наверное, это было очень неэффективно, но я не вникал.
После деплоя вылезло несколько (4–5) совсем «дурацких» багов, которые, казалось бы, не мог пропустить процесс, прогнавший больше 100 агентов-ревьюеров и нашедший 230 багов. И всё же для переписывания такой сложной системы состояний я считаю это хорошим результатом.
В целом я считаю это отрицательным результатом, потому что сгенерированные тесты помогли найти всего 10% дефектов и потребовали гигантского объёма кода (300 тысяч строк) и токенов агентов на разработку и поддержку.
Мне это кажется интересным, и я был бы рад видеть больше людей, описывающих такие случаи из практики.
Примечания автора
¹ Тот пост вышел в сентябре, но тесты проводились в августе. Основная часть работы для этого поста сделана в сентябре, а опубликовать его я собрался только в ноябре. Хотя я стараюсь тратить на описание экспериментов почти ноль усилий, я всё сильнее отстаю и просто не пишу о результатах, которые раньше, до агентов, опубликовал бы.
² Недавно слышал такое: Rust особенно хорош для агентов, потому что у него удобные сообщения об ошибках, ведущие агента к правильному решению. Я встречал это несколько раз. Я не скажу, что это абсолютно не может быть правдой: возможно, какой-то большой набор экспериментов, который мне не по карману, и нашёл бы какой-то эффект. Но я изучал этот вопрос намного внимательнее всех, от кого слышал такое утверждение, и, похоже, это неверно для всех задач, на которые я смотрел, по крайней мере на той выборке, которую могу себе позволить. Если утверждение и верно, в большинстве случаев его эффект, похоже, перекрывается другими факторами, так что причиной выбирать язык он быть не должен. Если называть одну-единственную причину, почему Rust хорош для агентов (а именно это и случилось, когда такое всплывало в последний раз), то эта причина, кажется, не та.
Заметьте ещё, что правдоподобные «по-человечески звучащие» причины эффективности, вероятно, так же неверны и в оценке людей. Просто мы не можем позволить себе такой эксперимент на людях, поэтому и передаём друг другу эти неопровержимые, но ничем не подкреплённые объяснения. Напомню, мы смотрели на литературу об эффективности статической и динамической типизации, потому что люди часто говорили, что исследования показывают превосходство статических типов над динамическими, но, когда мы заглянули в основные опубликованные на тот момент работы, доказательств этому почти не нашлось.
³ К таким вещам, похоже, подходит какой-нибудь вариант поговорки «ложь успевает обежать весь мир, пока правда надевает сапоги». У вирусного твита с преувеличенным утверждением на момент написания 2,8 тысячи лайков, 2,8 тысячи сохранений и 395 ретвитов, а прошло чуть меньше месяца с момента публикации. Как вы думаете, какой отклик соберёт твит об этом посте? Вряд ли я могу заключить на реальные деньги пари, что более точный твит наберёт меньше, потому что кто-нибудь мог бы принять пари и накрутить ему отклик через какой-нибудь сервис. Но в любой теме, которую я вижу в соцсетях, самые вирусные утверждения почти всегда преувеличены и неверны, а более взвешенные и менее ошибочные угнаться за ними не могут. Людям, похоже, очень нравится уверенность, даже (или особенно) там, где сам уровень уверенности говорит о почти наверняка неверном утверждении.
ссылка на оригинал статьи https://habr.com/ru/articles/1104744/