Сыграем в «словесную лесенку»
BLOG → BLOT → SLOT → SPOT ↝ POST
Недавно друг рассказал мне о новом варианте игры «Словесная лесенка»: найти путь преобразований от начального слова до конечного, где на каждом шаге разрешено заменить одну букву, либо удалить одну букву, либо вставить одну букву, либо анаграммировать слово. Это меня раздражало (бывает дьявольски сложно вычленить пути, идущие через анаграммы), поэтому, естественно, я написал программу для решения таких задачек. Когда оказалось, что прогон программы занимает более 1 секунды, мне, конечно же, захотелось её оптимизировать. Занимаясь этим, я обнаружил интересный фокус для индексирования анаграмм — для каждого слова из словаря подгонять идентификатор бесколлизионного произведения простых чисел под одно 64-разрядное целое число — такого я раньше никогда не видел (хотя, у вычислительной техники долгая история, и Кнут, вероятно, заметил это ещё в 1965 году).
Для полноты картины должен отметить, что меня интересовало решение конкретной задачи: найти все анаграммы в словаре. Если вы хотите просто найти все анаграммы для конкретного слова, то вам подойдёт какое‑то гораздо более простое решение, например, хеш‑таблица! В изложенном далее материале мы найдём все анаграммы и поговорим о полном пути вверх по лестнице.
Находим анаграммы
Вот два обычных приёма для поиска диаграмм: использовать для подбора уникального идентификатора буквы в слове (независимо от порядка) либо перестановку с сортировкой по буквам, либо вектор подсчёта букв (вектор Париха):
letter_sort("spot") -> "opst"
или
letter_count("spot") -> "[... o:1, p: 1, s: 1, t:1 ...]"
После чего прогоняем этот код по словарю и вставляем в хеш‑таблицу элементы в зависимости от того, сколько в них букв. Вот как это выглядит на python‑подобном псевдокоде:
for word in dictionary: table[letter_sort(word)] += word
В результате создаётся таблица с записями такого вида:
"opst" : ["spot", "post", "tops", "stop"]
Исходная операция: сортировка строк
Поскольку в последнее время я писал немного ржавый код, если вы понимаете, о чём речь, я решил всё это самостоятельно написать на Rust, а не понукать БЯМ, чтобы она сделала это за меня (это задача уровня leetcode, поэтому решить её самостоятельно мне не составляло труда). Получился примерно такой код:
fn anagram_dictionary(words: &[String]) -> HashMap<String, Vec<String>> { let mut anagrams: HashMap<String, Vec<String>> = HashMap::new(); for word in words { let key: Vec<u8> = word.bytes().sorted().collect(); let key = String::from_utf8(key).expect("dictionary words must be ASCII"); anagrams.entry(key).or_default().push(word.clone()); } anagrams}
После предварительного прочтения словаря Scrabble™ и записи его в память, эта функция формирует словарь анаграмм за
31 мс (173 нс / слово)
Кажется, нормально. Вы правы, я пошутил: это БЕЗУМНО МЕДЛЕННО. Учитывая, что в этом словаре 178 690 записей, получается, что при его построении мы тратим 173 наносекунды на слово. За 173 наносекунды можно выполнить примерно 4400 команд на Macbook Pro M1. Кто же станет ждать так долго?
Обойдёмся без операций выделения Vec
Взявшись за оптимизацию, первым делом нужно обратить внимание на операции выделения памяти (аллокации), а в нашей задаче таких просто завались. Каждое слово требует или выделить Vec, или добавить данные к Vec, для чего иногда также приходится выделять память. На практике у нас в таблице содержится около 161 019 ключей, то есть, речь идёт о 161 k аллокаций! Давайте улучшим это, подобрав более подходящую структуру данных. При этом отметим две вещи:
-
Когда в хеш‑таблице 161 k записей, а в словаре всего 178 k элементов, большинство записей в этой хеш‑таблице будут синглтонами.
-
У нас в памяти сохранён оригинальный список слов, и, зная его размер, его можно проиндексировать по основанию.
Так что сделаем две вещи. Сначала найдём способ сохранять элементы‑синглтоны, вообще не прибегая при этом к структуре данных с динамическим размером. Затем реализуем эквивалент связного списка, чтобы можно было прикреплять к таким спискам новые элементы, а просканировать их все только один раз — в самом конце. Для этого воспользуемся подобной структурой:
heads: HashMap::<K, u32>, next: Vec<u32>, word: Vec<u32>
Здесь heads индексируется ключом, идентифицирующим анаграмму (напр., строкой, отсортированной по символам). Эту структуру u32 мы перегрузим старшим битом (у нас всего 170 k слов или около того), чтобы в ней можно было представлять или конкретное значение данных (индекс элемента в списке) ИЛИ заходить по индексу в массивы вида next+word. Next‑массив как раз и есть наш связный список — он содержит указатели, каждый из которых направлен на другую запись в next‑массиве. В массиве слов (word‑массив) содержатся ассоциированные данные. Выглядит это вот так:
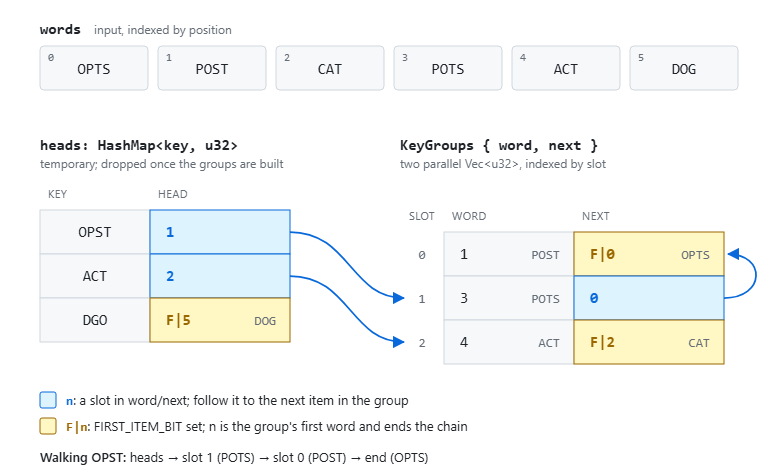
Результат: 31 мс → 20 мс (112 нс / слово)
Упаковываем данные о количестве букв в u128
Уже гораздо лучше, но это не предел. Сортировка этой строки и выделение памяти под новую строку — операции, требующие немалого времени, а у нас 178 k таких операций. Это большой довесок наносекунд.
Давайте попробуем предпочесть вектор для подсчёта букв и плотно упакуем его в целое число. Если взять всего 26 символов (исходим из того, что в любом слове один и тот же символ повторяется не более 15 раз), можно было бы использовать 4 бита на символ. Таким образом, 26 x 4=104 бит. Это вполне умещается в u128. Притом, что такую структуру данных не назовёшь крошечной, у неё, как минимум, аккуратный фиксированный размер, кратный 16 байт, и она подойдёт в качестве ключа для быстрого поиска по хеш‑таблице.
/// Группируем слова по u128 и ведём 4-битный счёт каждой из букв латиницы от A до Z./// Рассматриваются слова в верхнем регистре, записанные буквами от A до Z, причём, в любом слове ни одна буква не повторяется более 15 раз.fn u128_lettercount(words: &[String]) -> KeyGroups { let items = words.iter().enumerate().map(|(idx, word)| { let mut lettercount = 0u128; for letter in word.bytes() { lettercount += 1u128 << ((letter - b'A') as u32 * 4); } (lettercount, idx as u32) }); KeyGroups::new(words.len(), items)}
(Обратите внимание, что здесь мы ещё кое‑что делаем — возвращаем список анаграмм, а не полный словарь, в котором содержались бы и слова, не поддающиеся анаграммированию),
Если обойтись без манипуляций со строкой и её сортировки, то также получается значительный выигрыш:
Результат: 20 мс → 5,6 мс (31 нс / слово)
Ускоренная хеш‑таблица
Вероятно, у вас уже напрашивается вопрос: «во что нам обходится медленная хеш‑таблица, используемая в Rust по умолчанию»?
Давайте переключимся на FxHashMap из rustc_hash, гораздо более быстрый. Работая с ним, можно не беспокоиться о конкурирующих данных, поступающих на вход в вашу хеш‑таблицу.
Результат: 5,6 мс → 4,1 мс (23 нс / слово)
Кажется, что так гораздо лучше. Но предел ли это?
64-битная гёделева нумерация с настроенными простыми числами
Разумеется, ещё нет!
Если хранить количество букв как u128, работа идёт также немного медленнее, чем может быть. Дело в том, что эта информация будет разделена на два 64-разрядных регистра, которые компилятору придётся складывать, то есть, выполнять вдвое больше работы, чем при простой проверке на равенство. Но, если попробовать организовать подсчёт букв в 64 битах, то мы сможем сохранять всего 2 бита, а во многих словах одна и та же буква встречается более 3 раз (например, в «MISSISSIPPI» 4 буквы «S»).
Давайте лучше воспользуемся подходом, который называется «нумерация Гёделя». Для этого создадим небольшую таблицу, в которой с каждой буквой будет соотноситься отдельное простое число. Тогда любое слово можно будет идентифицировать по произведению таких букв‑простых чисел. Так мы гарантированно получим уникальный идентификатор для каждой совокупности букв. Можно упрощённо предположить, что «a → 2, b → 3, c → 5» и так далее. Но наша статья — о практике, поэтому хотелось бы уместить результат в 64 бита. Если придерживаться такого наивного присваивания, как показано выше, то переполнение наступит на 365-м слове из нашего лексикона, «ABORTIVENESSES». Но оно всего 14 символов в длину, а у нас есть ещё 3157 15-символьных слов! Если хочется закольцевать этот механизм, то как раз для этого нам пригодится только что реализованная хеш‑функция. Однако, такой подход не гарантирует, что не возникнет случайной коллизии между двумя словами, поэтому придётся дополнительно озаботиться, как это проверять…
Вот как схитрим: найдём оптимизированный вариант присваивания простых чисел буквам алфавита. Нам нужен такой, при котором ни одно из слов в нашем скрэббл‑словаре не переполнит 64-битное число. Сначала я задумался о том, чтобы расположить буквы латиницы в соответствии с их стандартной частотностью в английском языке (ETAOINSHRDLU, так далее), но оказывается, что здесь есть небольшая ошибка: нас волнуют отнюдь не такие слова как «the», а такие как «WRONGHEADEDNESS». Поэтому следует отталкиваться от паттернов, которые вычленяются в 3157 15-символьных словах. Например, притом, что «E» остаётся соответствовать 2, распространённая «T» соответствует 29, а 3 мы оставляем под «I». Товарищ «J» получает 101, так как самое длинное слово с двумя или более J состоит всего из 12 символов: JEJUNENESSES. При таком раскладе лучше, чтобы у всех этих E, N и S были значения пониже, и так и оказывается: они получают 2, 19, 17 соответственно. Следовательно, нам хватит 64 бит для обработки 15 N подряд.
Для решения этой задачи я сначала сделал маленький прогон программы с упорядочиванием букв по частоте (получается немного лучше, чем в алфавитном порядке, но не слишком). В программе выполняется цикл, в рамках которого находим первое слово, вызывающее переполнение. После этого подставляем для некоторых букв простые числа поменьше. Было интересно подбросить эту задачу решателю:
const LETTER_PRIMES: [u64; 26] = [ 5, // A 61, // B 37, // C 53, // D 2, // E 71, // F 47, // G 41, // H 3, // I 101, // J 73, // K 23, // L 59, // M 19, // N 7, // O 43, // P 97, // Q 11, // R 17, // S 29, // T 31, // U 89, // V 67, // W 83, // X 13, // Y 79, // Z];
и получить вариант, не вызывающий переполнения ни в одном слове из словаря Скрэббл. Удалось найти бесколлизионный канонический 64-разрядный идентификатор для набора букв в слове (для Скрэббл), выражаемый в виде кода так:
fn prime_anagramdict(words: &[String]) -> KeyGroups { let items = words.iter().enumerate().map(|(idx, word)| { let mut product = 1u64; for letter in word.bytes() { product = product.wrapping_mul(LETTER_PRIMES[(letter - b'A') as usize]); } (product, idx as u32) }); KeyGroups::new::<FxBuildHasher, _>(words.len(), items)}
В таком представлении слово с наибольшим произведением — это
PSYCHOPATHOLOGY = 17 763 551 150 644 031 915
составляющее в log2 63,945; то есть, здесь мы проходим примерно 96,2% пути через всё пространство 64-разрядных чисел. Впритирку, но помещается.
Результат: 4,1 мс → 2,6 мс (14,7 нс/слово — в 12 раз быстрее исходного варианта)
Используем представление слова, упакованное в u128
Наконец, вот последняя возможная оптимизация. Можно не читать содержимое словаря как строки, а укладывать их в упакованные представления u128, используя при этом 5 бит на символ. После этого понадобится немного распараллелить код ЦП на уровне инструкций (ILP), накапливая произведение при помощи двух независимых аккумуляторов. Такое представление u128 позже пригодится нам и для ускорения других элементов игры «Из мухи в слона». Код выглядит примерно так:
fn prime_anagramdict_packed(packed_words: &[u128]) -> KeyGroups { let items = packed_words.iter().enumerate().map(|(idx, &packed)| { let mut even = 1u64; let mut odd = 1u64; let mut rest = packed; while rest != 0 { even = even.wrapping_mul(PACKED_PRIMES[(rest & 0x1f) as usize]); odd = odd.wrapping_mul(PACKED_PRIMES[((rest >> 5) & 0x1f) as usize]); rest >>= 10; } (even.wrapping_mul(odd), idx as u32) }); KeyGroups::new::<FxBuildHasher, _>(packed_words.len(), items)}
Результат: 2,6 мс → 2,3 мс (13 нс/слово — в 13 раз быстрее исходного варианта)
Низкоуровневые оптимизации: ветвления и автовекторизация
Уже довольно хорошо. На закуску расскажу ещё об одной оптимизации, которая помогает исправить часть ошибок при прогнозировании ветвлений в этом оставшемся!= 0 цикле. Можно трактовать все слова так, как будто в каждом из них 16 символов, игнорируя при этом нули в конце и соотнося их с 1 в нашей таблице простых чисел (то есть, они не будут влиять на произведение). Используя фиксированную длину 16 мы также упрощаем векторизацию нашему другу‑компилятору. В качестве дополнительной поддержки давайте отделим вычисление произведения простых чисел от вставки результата в хеш‑таблицу. Так мы добьёмся дополнительного параллелизма на уровне инструкций в нашем (теперь уже векторизованном) цикле умножения.
В итоге код примет вид:
fn packed_prime_product(packed: u128) -> u64 { debug_assert!(packed >> 80 == 0, "word longer than 16 letters"); let mut even = 1u64; let mut odd = 1u64; let mut rest = packed; for _ in 0..8 { even = even.wrapping_mul(PACKED_PRIMES[(rest & 0x1f) as usize]); odd = odd.wrapping_mul(PACKED_PRIMES[((rest >> 5) & 0x1f) as usize]); rest >>= 10; } even.wrapping_mul(odd)} fn prime_anagramdict_packed(packed_words: &[u128]) -> KeyGroups { let products: Vec<u64> = packed_words.iter().map(|&p| packed_prime_product(p)).collect(); let items = products.iter().enumerate().map(|(idx, &product)| (product, idx as u32)); KeyGroups::new::<FxBuildHasher, _>(packed_words.len(), items)}
Результат: 2,3 мс → 1,96 мс (10,9 нс/слово, в 15 раз быстрее исходного варианта)
Вот мы и достаточно приблизились к тому варианту, который, как я полагаю, пойдёт на одном ядре моей машины даже без явной векторизации. Получившиеся у нас 1,96 мс — это примерно 1,23 нс на байт, что теоретически выводит нас на 3,2 x 8 x 1,23 = 31 инструкцию (но в реальности будет меньше). По‑моему, тут остаётся не так много места для дальнейшей оптимизации — но, возможно, я неправ! Есть вариант реализовать для этого случая ещё более быструю хеш‑таблицу, но я бы остановился на вполне обычных вещах, доступных в готовом виде.
Подытожу сделанные оптимизации
|
Шаг |
Оптимизация |
Общее время |
Время / Слово |
Ускорение по сравнению с исходным, раз |
|
0 |
Исходный уровень ( |
31,0 мс |
173 нс |
1,0 |
|
1 |
Плоские массивы |
20,0 мс |
112 нс |
1,6 |
|
2 |
4-разрядные количества букв, упакованные в u128 |
5,6 мс |
31 нс |
5,5 |
|
3 |
Переход на |
4,1 мс |
23 нс |
7,6 |
|
4 |
64-разрядная нумерация по Гёделю (настроенные в рамках корпуса произведения простых чисел) |
2,6 мс |
14,7 нс |
11,9 |
|
5 |
5-разрядные входные слова, упакованные в u128 + ILP с двумя аккумуляторами |
2,3 мс |
13,0 нс |
13,5 |
|
6 |
Неветвящийся цикл фиксированной длины + проход автовекторизации по произведениям |
1,96 мс |
10,9 нс |
15,8 |
ссылка на оригинал статьи https://habr.com/ru/articles/1104760/