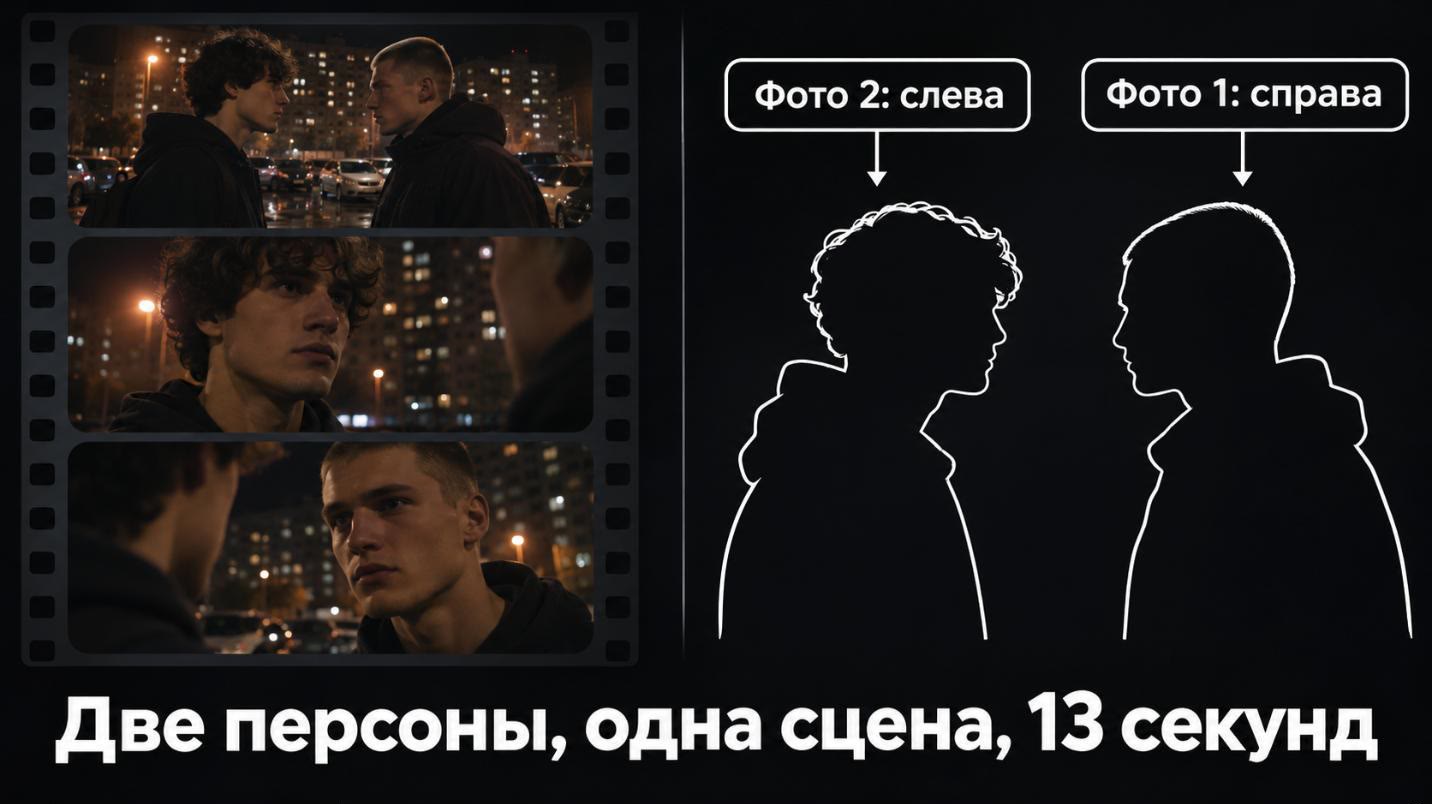
Сцену из тренда мои слезы не помогут нейросеть собирает по двум портретам: двое стоят вплотную у ночных многоэтажек, камера переводит взгляд с одного лица на другое, губы двигаются под строчку песни. Для этого формата в Umnik AI есть готовый шаблон «Мои слёзы» на модели Kling 4.0 в режиме reference-to-video: два окна для фото, без промпта, на выходе вертикальный ролик 13 секунд в 720p.
С виду формат простой, но технически это одна из неудобных задач для видеогенерации: два разных лица на расстоянии ладони, постоянные переходы камеры между ними и ожидание, что губы попадут в песню. Ниже раскладка сцены по секундам, причины, по которым две персоны в кадре трудны для видеомоделей, подготовка фото, типовые артефакты и два ручных способа для своего сюжета.
Как выглядит тренд
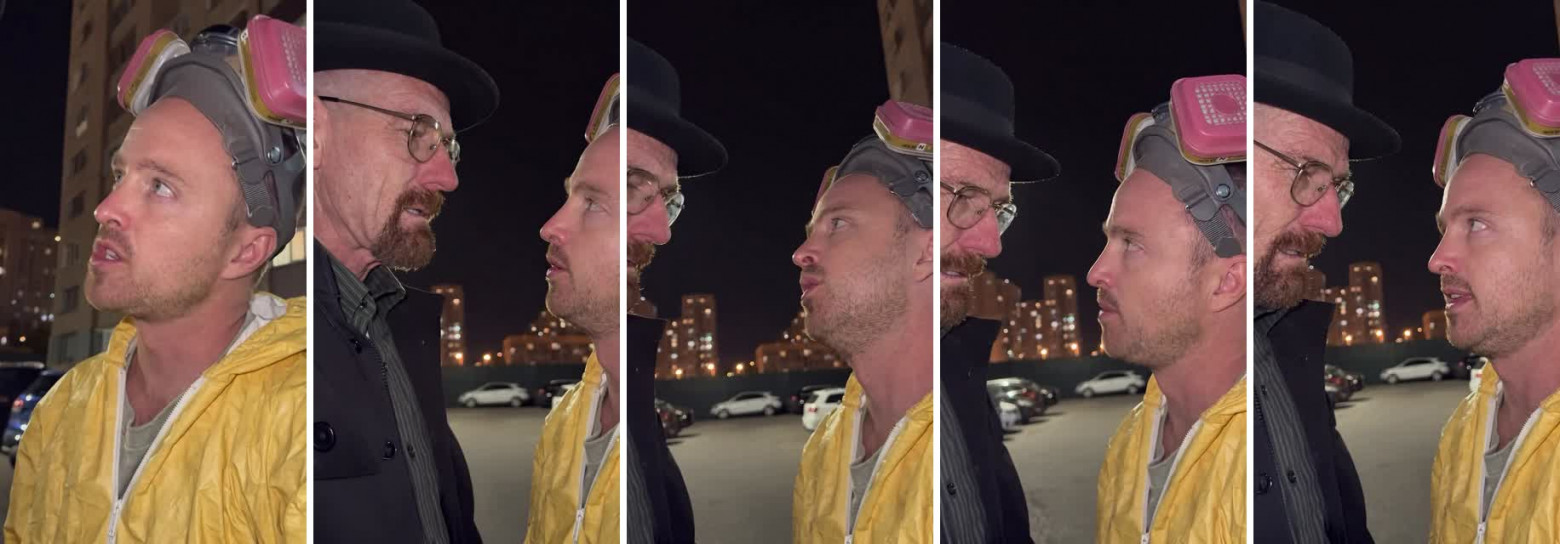
Формат держится на трёх постоянных элементах.
-
Место. Ночной двор спального района, панельные дома с десятками светящихся окон, парковка, машины у бордюра, оранжевые фонари, иногда мокрый асфальт с бликами.
-
Мизансцена. Два человека стоят почти нос к носу, корпусы развёрнуты друг к другу, взгляд не отрывается от партнёра. Руки обычно опущены или в карманах, вся выразительность в лицах.
-
Камера. Медленно обходит пару или переключается между крупными планами. Статичных роликов в тренде почти нет.
Звук везде один: фрагмент песни, давший тренду название. Драматургия держится на контрасте: пафосная строчка и взгляд в упор на фоне самого обычного двора с машинами. Панельный район здесь важен как узнаваемая декорация: зритель сразу считывает место, и всё внимание уходит на лица. Для видеомодели это тоже удобно, потому что фон однородный и повторяющийся, а значит, ошибки чаще возникают на героях, а не на окружении.
Самые разошедшиеся ИИ-версии сделаны с героями сериала «Во все тяжкие», отсюда второе название, тренд во все тяжкие ии. Здесь это только пример оригинала: дальше речь о роликах со своими лицами, промптов на персонажей и актёров в статье нет.
Шаблон «Мои слёзы» в Umnik AI: три шага
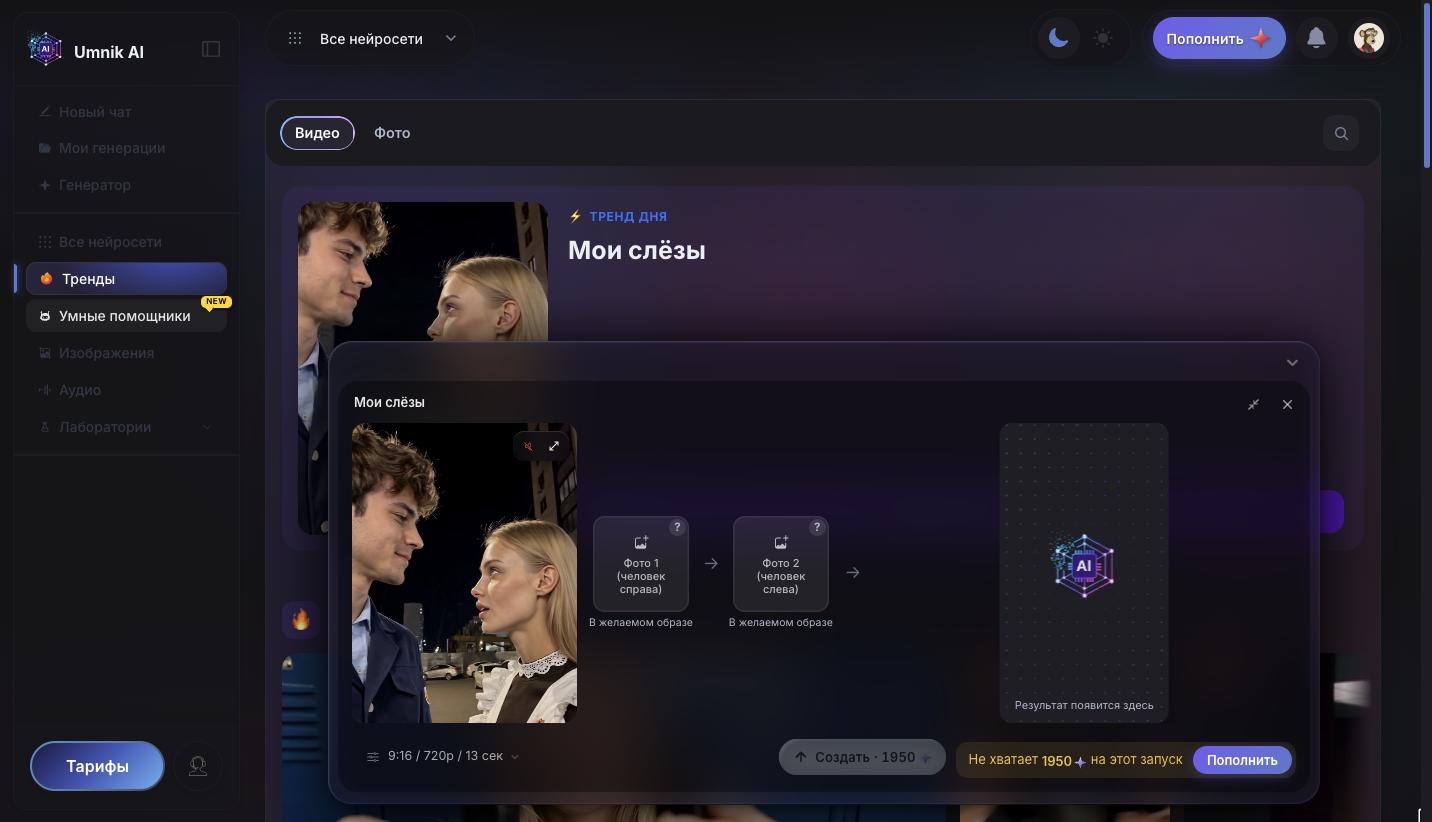
Шаг 1. Открыть шаблон. Перейдите на страницу шаблона «Мои слёзы». Модель и параметры уже выставлены.
Шаг 2. Загрузить два фото. В окно «Фото 1 (человек справа)» загружается тот, кто в ролике будет стоять справа, в окно «Фото 2 (человек слева)» тот, кто будет слева. Под обоими окнами подсказка «В желаемом образе»: одежда и причёска с фото перейдут в видео.
Шаг 3. Запустить генерацию. Стоимость видна в карточке перед запуском. Промпт не нужен, сцена уже описана внутри шаблона.
|
Параметр |
Значение |
|---|---|
|
Модель |
Kling 4.0, reference-to-video |
|
Длительность |
13 секунд |
|
Разрешение и формат |
720p, вертикальный 9:16 |
|
Входные данные |
2 фото: «справа» и «слева» |
|
Промпт |
не нужен |
|
Стоимость |
видна в карточке перед запуском |
Токены в Umnik AI общие для всех моделей, и если генерация не выполнилась, они возвращаются автоматически. Готовое видео хранится в разделе «Мои генерации» 7 дней, поэтому скачивайте его сразу.
Как устроена сцена по секундам
Чтобы понимать, откуда берутся артефакты, полезно разложить 13 секунд на отрезки. Ниже примерная раскладка по типовым роликам тренда: конкретная генерация может сдвинуть границы на секунду или поменять порядок планов.
|
Отрезок |
План |
Что происходит |
Где чаще ломается |
|---|---|---|---|
|
0-2 с |
общий, по пояс |
пара лицом к лицу на фоне домов |
масштаб фигур |
|
2-5 с |
крупный, правый |
камера у лица справа, губы двигаются |
сходство лица |
|
5-8 с |
крупный, левый |
переход к лицу слева |
перестановка героев |
|
8-11 с |
средний, профили |
камера обходит пару |
смешение черт |
|
11-13 с |
общий или крупный |
финальная пауза, взгляд в упор |
дрожание контуров |
Самые рискованные участки приходятся на переходы между планами. Пока камера держит одно лицо, в кадре одна идентичность, а в профилях на 8-11 секунде модели нужно удержать два лица на расстоянии ладони друг от друга.
Кого ставить в какое окно
По примерной раскладке первым крупный план получает человек справа, то есть «Фото 1». Если один из снимков заметно чище, крупнее или с более выразительным лицом, логично отдать ему правую позицию: первый крупный план задаёт впечатление от всего ролика. Разница в росте тоже влияет на кадр. Если один герой выше, на общих планах модель сохранит это соотношение, и при сильной разнице в росте второе лицо может уйти к нижнему краю кадра. Фото по пояс у обоих смягчает эффект.
13 секунд хватает на одну музыкальную фразу и два-три перехода камеры. В более длинном ролике черты лица чаще «дрейфуют» к концу, а в более коротком не успевает сложиться ритм «взгляд, ответный взгляд, пауза».
Что происходит на переходах камеры
Переход с крупного плана одного героя на крупный план другого для модели означает почти полную смену содержимого кадра. На крупном плане второе лицо частично или полностью уходит из поля зрения, и при возврате к общему плану модель должна восстановить его по исходному фото, а не по предыдущим кадрам. Именно поэтому дефекты лица чаще всплывают не в середине крупного плана, а в первые полсекунды после перехода.
Облёт пары в профиль сложен по другой причине. Исходные фото почти всегда фронтальные, и профиль модель достраивает сама. Нос, линия подбородка и уши в профиль получаются менее похожими, чем анфас, и это нормальное поведение для генерации по фото, а не признак сломанного запуска.
Почему две персоны в кадре сложны для видеомодели
Ролик с двумя людьми заметно сложнее ролика с одним. Причин четыре.
-
Смешение признаков. При похожем типаже часть черт одного героя переходит к другому: брови, цвет волос, щетина, очки. В итоге ни один не совпадает с исходником полностью.
-
Привязка к месту. Модели нужно запомнить, кто где стоит. При смене плана привязка может потеряться, и в следующем общем плане герои окажутся зеркально переставлены.
-
Неравномерное внимание. Одно лицо получается детальным, второе мягким. Обычно выигрывает то фото, которое крупнее, резче и ярче освещено.
-
Перекрытие. Вплотную плечо закрывает подбородок, волосы одного попадают на лицо другого, и модель достраивает пиксели по догадке: отсюда сросшиеся воротники и рваные контуры.
Чем reference-to-video отличается от оживления кадра
В режиме оживления кадра (image-to-video) модель получает одну картинку как первый кадр и продолжает её во времени. Всё, что не видно на этой картинке, модель придумывает, и лица со временем уходят от исходника.
В режиме reference-to-video фото служат не первым кадром, а образцами внешности. Модель строит сцену с нуля, но сверяет лица с референсами на протяжении всего ролика. Для тренда с переходами камеры это важно: после крупного плана второе лицо восстанавливается по своему фото, а не по размытым соседним кадрам.
Как шаблон решает это окнами «справа» и «слева»
В свободном режиме reference-to-video модель получает два фото и текст и сама решает, какое лицо куда поставить. В шаблоне «Мои слёзы» каждое окно связано с позицией в кадре: «Фото 1» всегда человек справа, «Фото 2» всегда человек слева.
-
Раскладка задана заранее, поэтому перестановки героев между планами случаются реже.
-
Каждая идентичность приходит из отдельного снимка с одним человеком, и признаки двух лиц не смешиваются ещё на входе, как бывает с общим фото на двоих.
-
Сцена и движение камеры уже описаны под эти две позиции, своего промпта, который мог бы сбить расстановку, нет.
При этом шаблон не исправляет сами исходники. Если фото сильно отличаются по масштабу или свету, неравномерное внимание всё равно останется, а если на снимке закрыты глаза, модели неоткуда взять взгляд, на котором держится сцена. Поэтому дальше про подготовку исходников.
Как подготовить фото для тренда мои слезы не помогут ии
Качество ролика почти целиком определяется двумя снимками.
Ракурс. Фронтальный портрет или лёгкий поворот на три четверти, камера на уровне глаз, голова и плечи целиком в кадре. Герои в сцене смотрят друг на друга, поэтому человеку для окна «справа» удобно слегка повернуть голову влево, а человеку для окна «слева» вправо. Снимок сверху или снизу искажает пропорции лица, и модель переносит это искажение в видео.
Свет. Ровный рассеянный: окно днём, пасмурная улица, светлая комната. Ночную гамму с фонарями модель добавит сама, ей нужна чистая информация о лице. Цветные подсветки, резкие тени от верхних ламп и вспышка в упор мешают. Оба фото желательно снять при похожем свете, иначе второе лицо почти наверняка выйдет менее детальным.
«В желаемом образе». Модель берёт образ с фото как есть: домашняя футболка останется домашней футболкой у ночных многоэтажек. Для зимнего двора подходят куртки, худи, шарфы. Однотонная одежда переносится стабильнее принта, надписи превращаются в кашу. Объёмный капюшон на голове усиливает перекрытие силуэтов, поэтому его надёжнее опустить. Тёмные очки и чёлка скрывают взгляд, на котором держится сцена. Другой образ можно заранее собрать в генераторе картинок, описав одежду словами без имён героев и актёров.
Кадр и файл. Один человек на фото, одинаковый масштаб, без бьюти-фильтров и сжатых скриншотов из мессенджера. Фото с камеры телефона в исходном качестве дают заметно чище результат, чем пересохранённые копии.
Пример подготовки пары фото
Пример: двое друзей снимают друг друга у окна в подъезде днём. Оба в тёмных куртках без надписей, капюшоны опущены, телефон на уровне глаз, кадр по пояс. Тот, кто будет справа, слегка поворачивает голову влево, второй вправо. Снимки делаются одним телефоном с одного расстояния, поэтому масштаб и свет совпадают. Такая пара закрывает почти все пункты чек-листа ниже ещё до загрузки.
Фото другого человека загружайте только с его согласия: изображение гражданина охраняет ст. 152.1 ГК РФ. Для фото детей нужно согласие родителей.
Короткий чек-лист перед запуском:
|
Проверка |
Как должно быть |
|---|---|
|
Людей на каждом фото |
один |
|
Кадр |
по пояс или крупно, голова целиком |
|
Свет |
ровный, похожий на обоих фото |
|
Глаза |
открыты, без тёмных очков и чёлки |
|
Одежда |
та, что нужна в ролике, без крупных надписей |
|
Окна |
правый герой в «Фото 1», левый в «Фото 2» |
Когда все пункты сходятся, загружайте снимки в шаблон «Мои слёзы».
Типовые артефакты и как их чинить
|
Артефакт |
Вероятная причина |
Что сделать |
|---|---|---|
|
Герои поменялись местами |
фото перепутаны между окнами |
правый в «Фото 1», левый в «Фото 2» |
|
Лицо плывёт |
мелкий или пересвеченный портрет |
снимок крупнее, ровный свет |
|
Одно лицо резкое, второе мыльное |
разный масштаб и свет |
выровнять кадр и свет |
|
Губы не попадают в песню |
модель не слышит трек |
подобрать фрагмент при публикации |
|
Рваный контур при сближении |
перекрытие силуэтов |
убрать капюшон, повторить запуск |
|
Надпись на одежде стала кашей |
мелкий текст на фото |
однотонная одежда |
Герои меняются местами
Чаще всего виноваты окна: нумерация читается как «первый слева», а в шаблоне «Фото 1» отвечает за человека справа. Если раскладка верная, а перестановка всё равно случилась на одном из планов, запустите шаблон ещё раз с теми же фото: генерации отличаются друг от друга, и следующая часто проходит чисто.
Плывёт лицо
Дрейф черт обычно начинается на 8-13 секунде, и причина почти всегда в исходнике: лицо мелкое, пересвеченное или сжатое. Замените фото на более крупное и резкое. Если плывёт только один герой, сравните его снимок со вторым: чаще всего он темнее, мельче или снят под углом.
Губы не попадают в песню
Видео генерируется без аудиодорожки, поэтому губы двигаются «как будто поют», а не под конкретные слова. При публикации выберите отрезок трека, где ритм совпадает с губами, и сдвиньте начало звука на долю секунды. Точнее синхронизирует Motion Control с референсом, снятым под этот трек.
Как проверять результат
Удобно смотреть готовый ролик не целиком, а по отрезкам из раскладки выше. На 0-2 секунде проверьте, что оба героя на своих местах. На 2-8 секунде сравните каждое крупное лицо с исходным фото. На 8-11 секунде посмотрите на профили и место, где силуэты касаются друг друга. На последних двух секундах проверьте, не дрожат ли контуры. Если дефект только в одном отрезке, его можно отрезать при монтаже, а не перезапускать генерацию.
Звук: что делает модель и что делается при публикации
Готовой песни в ролике не будет. Видео служит визуальным рядом, а трек добавляют из библиотеки звуков соцсети при публикации. Так одну генерацию можно выложить под разные фрагменты, а если нужного трека в библиотеке нет, сцена у ночных домов узнаётся и под другую музыку. При выборе фрагмента ориентируйтесь на паузы: если в ролике герой замирает на финальном взгляде, удобно, чтобы на это место пришлась пауза или длинная нота в треке.
Свой сюжет: Motion Control и связка GPT Image 2.6 + Seedance 2.5
Для другой локации, своей хореографии или точной синхронизации есть два ручных способа собрать ИИ видео вдвоем под песню.
|
Критерий |
Шаблон «Мои слёзы» |
Kling V3 Motion Control |
GPT Image 2.6 + Seedance 2.5 |
|---|---|---|---|
|
Что загрузить |
2 фото |
фото + видео |
2 фото, затем кадр |
|
Промпт |
не нужен |
по желанию |
обязателен |
|
Кто задаёт движение |
шаблон |
видео-референс |
текст |
|
Свой сюжет |
нет |
да |
да |
|
Синхронизация губ |
приблизительная |
как на референсе |
приблизительная |
|
Стоимость, 720p |
видна в карточке |
910 токенов за 13 с |
около 336 токенов |
Kling V3 Motion Control: движение из своего видео
Kling V3 Motion Control переносит движение с видео-референса на фото. Порядок работы:
-
Снять референс: двое лицом к лицу, третий человек ведёт камеру вертикально, без склеек и рывков, около 13 секунд. Лица не закрыты руками и волосами, в кадр не попадают прохожие. Если в референсе поют под нужный трек, губы в итоге совпадут с ним заметно точнее.
-
Подготовить общее фото в той же расстановке: кто слева в видео, тот слева и на фото.
-
Загрузить оба файла, выбрать 720p и запустить.
В 720p секунда стоит 70 токенов, 13 секунд выходят в 910 токенов: дороже остальных, зато движение под контролем автора.
GPT Image 2.6 + Seedance 2.5: стартовый кадр и текст движения
Сначала в GPT Image 2.6 по двум портретам собирается стартовый кадр: картинка medium 35 токенов плюс 8 за каждое фото, итого 51 токен. Затем кадр оживляется в Seedance 2.5, ролик 720p стоит 285 токенов. Всего около 336 токенов.
Движение задаётся только текстом, поэтому промпт удобно писать по отрезкам, как в раскладке выше. Несколько правил, которые снижают число неудачных запусков:
-
Один план, одно действие, одно предложение. Длинные перечисления в одном предложении модель смешивает.
-
Называйте героев по позиции: «человек справа», «человек слева». Так проще удержать привязку, чем с описанием внешности.
-
Отдельной фразой запрещайте лишнее: «лица и одежда не меняются, без резких движений».
-
Локацию и свет описывайте и в промпте картинки, и в промпте видео одинаково, иначе ночь может стать сумерками.
Пример структуры, без имён и персонажей:
Вертикальное видео 9:16, ночь, двор у многоэтажек. Начало: общий план, двое стоят лицом к лицу. Затем камера плавно приближается к лицу человека справа, его губы двигаются. Затем мягкий переход к лицу человека слева, он смотрит в ответ. В конце камера медленно обходит пару, оба видны в профиль. Лица и одежда не меняются, без резких движений.
Плюс связки в цене и свободе локации: крыша, подъезд, заснеженная остановка. Минус в том, что текст описывает движение приблизительно, и ракурсы оригинала кадр в кадр не повторить. Здесь работает режим оживления кадра, поэтому к концу ролика лица уходят от исходника сильнее, чем в шаблоне.
Частые вопросы
Как мои слезы не помогут нейросеть делает по фото?
Модель получает два портрета и собирает из них ролик тренда: двое у ночных многоэтажек, камера переходит с лица на лицо. В шаблоне «Мои слёзы» для этого нужны только два фото.
Почему два окна, а не одно общее фото?
Отдельные окна привязывают каждое лицо к своей позиции и не дают признакам двух людей смешаться. «Фото 1» отвечает за человека справа, «Фото 2» за человека слева.
Можно ли сделать тренд мои слезы не помогут с персонажами сериала?
Версии с героями «Во все тяжкие» здесь только пример формата. Используйте свои фото или фото людей, которые дали согласие: изображение человека охраняет ст. 152.1 ГК РФ.
Будет ли в ролике песня?
Нет. Трек добавляют из библиотеки звуков соцсети при публикации, губы совпадают с ним приблизительно.
Какой формат у ролика?
Вертикальное видео 9:16, 720p, 13 секунд, модель Kling 4.0 в режиме reference-to-video. Стоимость видна в карточке перед запуском.
Почему в профиль лица похожи меньше, чем анфас?
Исходные фото обычно фронтальные, и профиль модель достраивает сама. Лёгкий поворот головы на фото в сторону партнёра даёт модели больше информации о боковой части лица, и профиль выходит точнее.
Итог
Мои слезы не помогут нейросеть собирает за одну генерацию, если правильно подать два исходника. Окна «справа» и «слева» снимают главную сложность сцены: модели не нужно угадывать, кто где стоит, а режим reference-to-video восстанавливает каждое лицо по своему фото после переходов камеры. Остальное зависит от фото: один человек на снимке, ровный свет, похожий масштаб и нужная одежда.
Для классической сцены хватит шаблона «Мои слёзы». Для своего сюжета подойдут Motion Control с собственным референсом или связка GPT Image 2.6 и Seedance 2.5, а другие форматы с готовыми карточками собраны в разделе Тренды.
ссылка на оригинал статьи https://habr.com/ru/articles/1105222/