Нейросети для видео за последний год перестали быть одной кнопкой «сделать красиво». У каждой модели появилась своя специализация: одна держит лицо на крупном плане, другая снимает длинный дубль с толпой, третья правит уже готовый ролик по текстовой команде. Поэтому вопрос «какая видеонейросеть лучшая» больше не имеет одного ответа. Честнее спросить по-другому: какую нейросеть взять под конкретный кадр.
В этой подборке я разбираю ИИ для видео как съемочную группу. У каждого участника своя роль, свой любимый кадр и свое ограничение. Внутри короткий рейтинг, тестовая раскадровка из шести кадров, таблица «кадр — нейросеть», пример сборки одного ролика из нескольких моделей, формула промпта и готовые шаблоны.
Какие нейросети для видео брать сейчас
-
Seedance 2.5 — длинные сцены до 30 секунд одним дублем, много референсов и кинематографичная камера.
-
Kling 3.0 и 4.0 — живые лица и мимика на крупных планах. В четвертой версии появились ключевые кадры и ролики до 30 секунд.
-
Kling Motion Control — переносит движения из видео-образца на вашего персонажа: танцы, жесты, трюки.
-
Study AI Видео — общий вход во все видеомодели. Выбираете модель под задачу в одном окне и сравниваете результаты без десятка подписок.
-
Оживление фото — превращает статичный снимок в короткий живой ролик. Самый простой старт, если промпты пока пугают.
-
Шаблоны ИИ-трендов — готовые сценарии вирусных роликов: добавили фото, нажали генерацию, скачали.
-
Veo 3.1 — диалоги и звук. Реплики, синхронизация губ и шумы окружения получаются в одном проходе.
-
Wan 3.0 — сцены с несколькими героями и длинные общие планы до 30 секунд. Удобна для серийного контента.
-
Gemini Omni Flash — правит готовое видео по текстовой команде: поменять свет и погоду, убрать или добавить объект.
-
HappyHorse — быстрые атмосферные вставки и короткие сцены со звуком, отличный кандидат для второго плана.
Почему «лучшая нейросеть для видео» — неправильный вопрос
Большинство подборок построены как рейтинг: первое место, второе, третье. Проблема в том, что видеонейросети давно перестали соревноваться в одной дисциплине. Модель, которая лучше всех держит лицо в диалоге, может посредственно справляться с толпой. Модель, которая снимает красивый длинный дубль, может проигрывать в точности мимики.
В кино никто не спрашивает, кто лучше: оператор или звукорежиссер. Каждый отвечает за свой участок. С нейросетями для видео сейчас работает та же логика. Хороший ролик на 30–60 секунд почти всегда собирается из кадров, сделанных в двух-трех разных моделях, а потом склеивается в монтажке.
Поэтому вместо классического рейтинга я провел кастинг. Написал одну раскадровку, раздал кадры всем участникам и посмотрел, кто какой кадр вытягивает стабильно, а кому просто повезло с первой генерацией.
Как мы выбирали: тестовая раскадровка из шести кадров
Для теста я взял короткую историю «утро в маленькой кофейне» и разбил ее на шесть кадров. Каждый кадр проверяет отдельный навык видео нейросети:
-
Крупный план с репликой. Бариста смотрит в камеру и говорит фразу на русском. Проверяем мимику, губы, голос.
-
Предметный кадр. Чашка на деревянной стойке, камера медленно облетает ее по кругу. Проверяем физику жидкости, пар, стабильность формы.
-
Движение по образцу. Бариста повторяет танцевальное движение из короткого видео-референса. Проверяем перенос движения.
-
Длинный общий план. Утро, в кофейню заходят трое посетителей, садятся, бариста приносит заказ. Проверяем нескольких героев в одном дубле.
-
Оживление старого фото. Черно-белый снимок кофейни прошлого века превращается в живую сцену. Проверяем работу с фотографией.
-
Правка готового ролика. В уже снятом кадре меняем дождь за окном на солнце и убираем лишний предмет со стойки. Проверяем редактирование.
Каждый промпт я прогонял по нескольку раз в каждой модели, которая заявляет нужный режим. Одна удачная генерация ничего не говорит о нейросети. Интересно другое: сколько попыток нужно, чтобы получить пригодный кадр, и насколько результаты похожи друг на друга.
Критерии отбора
-
Стабильность. Повторяемость результата на одном и том же промпте.
-
Лица и руки в движении. Нет ли «плывущих» черт лица, лишних пальцев и дергающихся предметов.
-
Звук и синхронизация губ. Генерирует ли модель голос и шумы сама и совпадает ли речь с артикуляцией.
-
Понимание промптов на русском. Насколько точно модель читает описание сцены без перевода.
-
Контроль. Ключевые кадры, референсы, первый и последний кадр, длина за один проход.
-
Доступ из России. Можно ли пользоваться без VPN и зарубежной карты.
В итоговый состав попали модели, которые уверенно закрыли хотя бы один кадр из шести и доступны из России в одном агрегаторе.
Съемочная группа: роли нейросетей для видео
Первыми идут видеомодели, которые закрыли самые сложные кадры теста. В середине списка три инструмента-входа: они нужны, чтобы не тратить время на выбор модели и настройку. Дальше снова модели, каждая со своей ролью.
1. Seedance 2.5 (Сиданс) — режиссер длинного дубля
Seedance 2.5 от ByteDance умеет то, на чем спотыкаются многие модели: снимать сцену до 30 секунд одним проходом, без склеек из коротких кусков. Можно подать много референсов сразу: текст, фото героя, фото локации, видео с нужным движением камеры.
На четвертом кадре теста с тремя посетителями Seedance лучше всех удержала общий ритм сцены: люди заходят, садятся, бариста подходит, камера плавно ведет за ним. Подробно о том, как запускать модель и писать для нее промпты, мы рассказывали в отдельной статье про Seedance 2.5.
Что умеет:
-
сцены до 30 секунд в одном дубле;
-
высокое разрешение, вплоть до 4K;
-
мультимодальные референсы для героя, локации и стиля;
-
генерация по тексту и оживление фото со звуком.
Главный плюс — цельная история в одном кадре. Ограничение: длинной сцене нужен подробный промпт с порядком действий. Кому-то это лишняя работа, а кто-то наоборот рад точному контролю.
Попробовать нейросеть Seedance 2.5
2. Kling 3.0 и Kling 4.0 (Клинг) — оператор крупного плана
Kling от Kuaishou стабильно сильнее остальных на лицах. Мимика, взгляд, мелкие движения губ и бровей на крупном плане выглядят естественно. Kling 3.0 дает ролики до 15 секунд со звуком, а вышедшая 15 октября Kling 4.0 удвоила длину до 30 секунд и добавила до десяти ключевых кадров на таймлайне, по которым модель ведет камеру и состояние героя.
На первом кадре теста с репликой баристы Kling чаще других выдавал пригодный дубль с первой-второй попытки.
Что умеет:
-
реалистичные лица и эмоции в движении;
-
генерация по тексту, по фото, по первому и последнему кадру;
-
нативный звук и речь на нескольких языках;
-
в версии 4.0 ключевые кадры и длинные ролики до 30 секунд.
Главный плюс — крупные планы, которые не выдают нейросеть. Ограничение: динамичные сцены с большим количеством людей у Kling получаются аккуратнее в коротких отрезках, поэтому длинную массовку удобнее отдать Wan или Seedance.
Попробовать нейросеть Kling 3.0
3. Kling Motion Control — хореограф: перенос движения с видео на фото
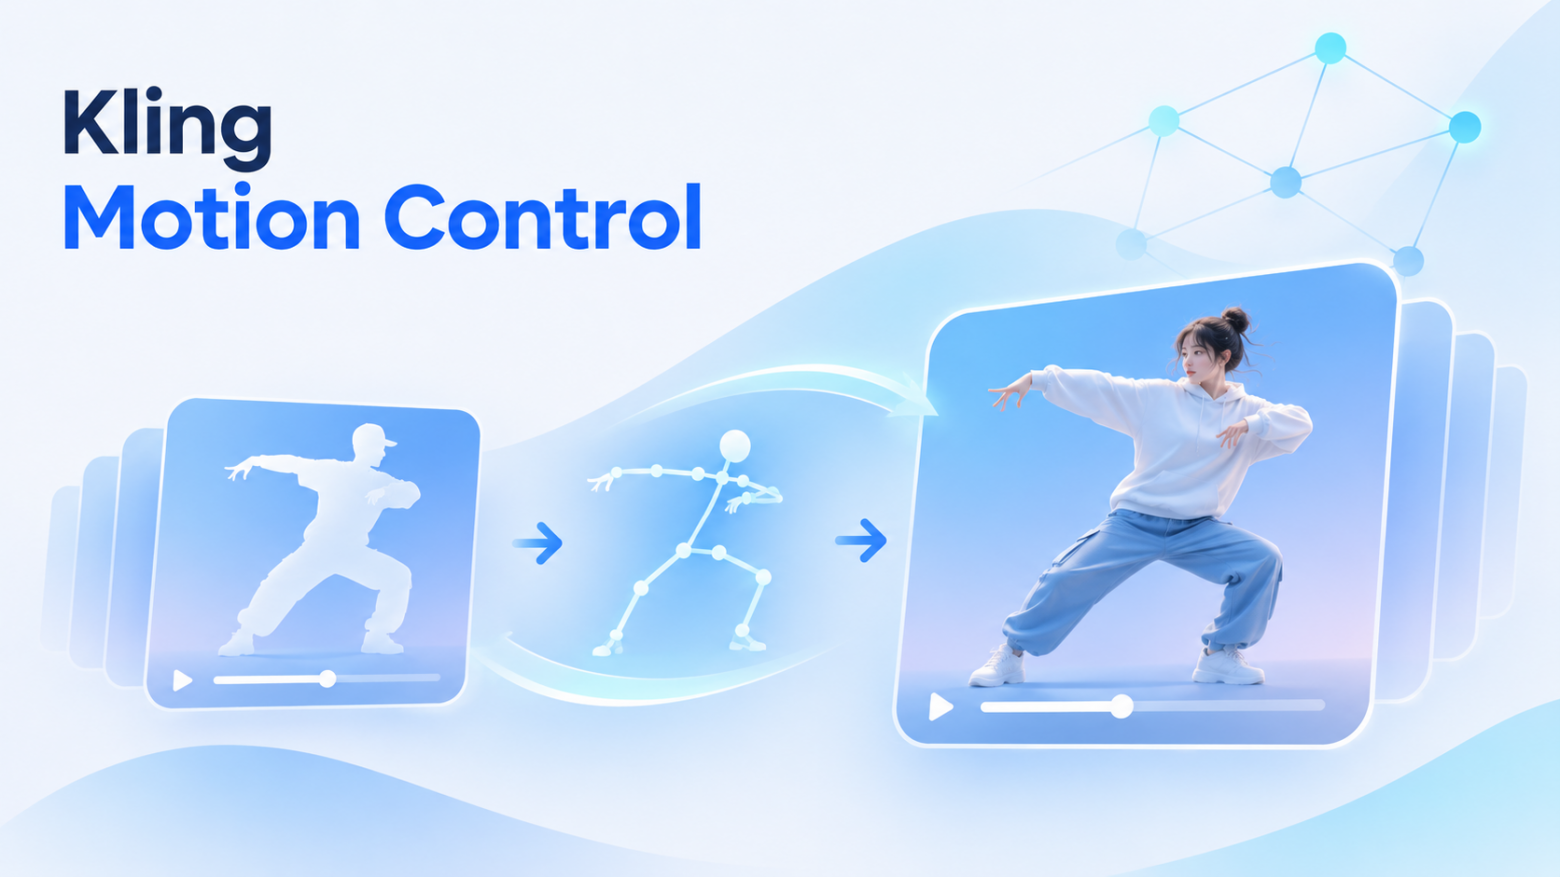
Отдельный режим Kling, который не придумывает движение сам, а берет его из вашего видео-образца. Загружаете фото персонажа и короткий ролик с нужным танцем или жестом, а нейросеть переносит движение на героя, сохраняя его внешность.
На третьем кадре теста бариста повторил движение из референса почти один в один, включая поворот корпуса. Именно на этом режиме держится большая часть танцевальных трендов последних месяцев.
Что умеет:
-
перенос движений, жестов и мимики с видео на персонажа с фото;
-
танцы, спортивные движения, трюки;
-
сохранение внешности героя;
-
работа с людьми, животными и мультяшными персонажами.
Главный плюс — точная хореография без описания словами. Ограничение: качество зависит от референса. Если в исходнике человек обрезан кадром или быстро уходит из фокуса, перенос получится менее точным.
Попробовать нейросеть Kling Motion Control
4. Study AI Видео — продюсер, который собирает все ИИ для видео в одном окне
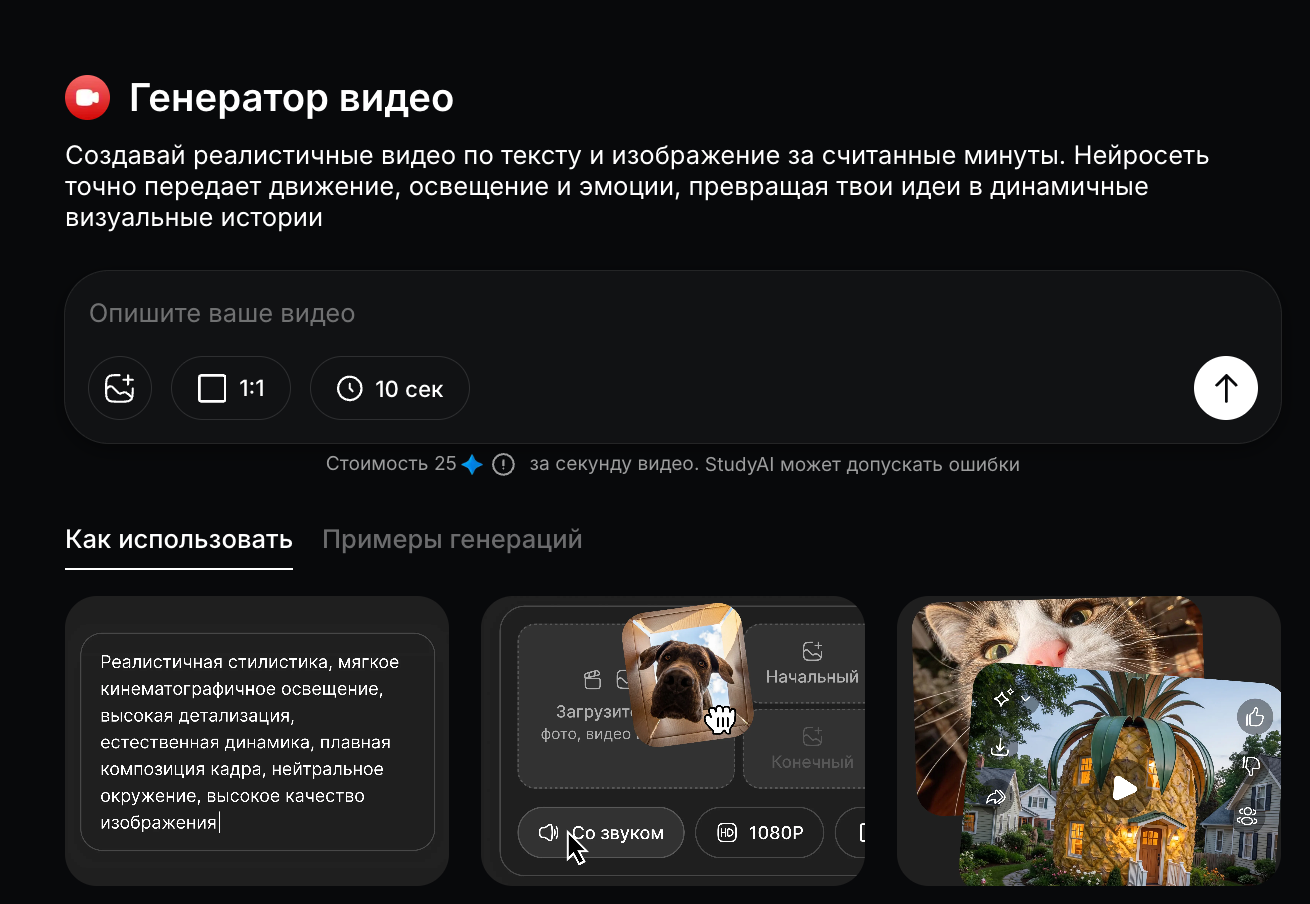
Продюсер в кино сам не снимает, зато знает, кого позвать на конкретную задачу. Раздел видео в Study AI работает так же: внутри одного кабинета лежат Seedance, Kling, Veo, Wan, Gemini Omni Flash и другие модели, а переключаться между ними можно без отдельных регистраций.
На тестах это сэкономило больше всего времени. Один и тот же промпт про кофейню я запускал в трех моделях подряд и сразу видел, кто справился лучше. При работе с отдельными сервисами на это уходит в разы больше времени: разные интерфейсы, разные лимиты, разная оплата.
Что умеет:
-
генерация видео по тексту и по фото в разных моделях из одного окна;
-
русский интерфейс и промпты на русском;
-
оплата российской картой, работа без VPN;
-
рядом лежат нейросети для картинок, музыки и текста, если ролику нужны стартовый кадр, саундтрек или сценарий.
Главный плюс — сравнение моделей на одном промпте за пару минут. Ограничение: агрегатор не добавляет моделям новых функций, он дает к ним доступ. Если у модели нет нужного режима, в агрегаторе его тоже не будет.
Попробовать нейросеть Study AI Видео
5. Оживление фото — аниматор: видео из фото без промптов
Это самый быстрый путь к первому ролику. Загружаете снимок, при желании пишете пару слов о движении, получаете короткое видео, где человек моргает, улыбается, поворачивает голову, а ветер шевелит волосы.
На тестовом кадре со старым черно-белым фото кофейни инструмент аккуратно добавил легкое движение людям и пару за окном, не разрушив композицию. Для семейных архивов, открыток и постов «было — стало» этого хватает с запасом. Для сложного сюжета с несколькими действиями лучше взять полноценные модели из этой подборки: Seedance, Kling или Wan.
Что умеет:
-
оживление портретов, групповых и старых фотографий;
-
работа без сложных промптов, достаточно описать движение простыми словами;
-
короткие ролики, удобные для сторис и мессенджеров;
-
быстрая генерация, можно перепробовать несколько вариантов подряд.
Главный плюс — нулевой порог входа. Ограничение: это инструмент для одного действия в кадре. Кому-то этого мало, а кому-то как раз нужно «просто оживить бабушкину фотографию» без настроек.
Попробовать нейросеть Оживление фото
6. Шаблоны ИИ-трендов — SMM-ассистент для вирусных роликов
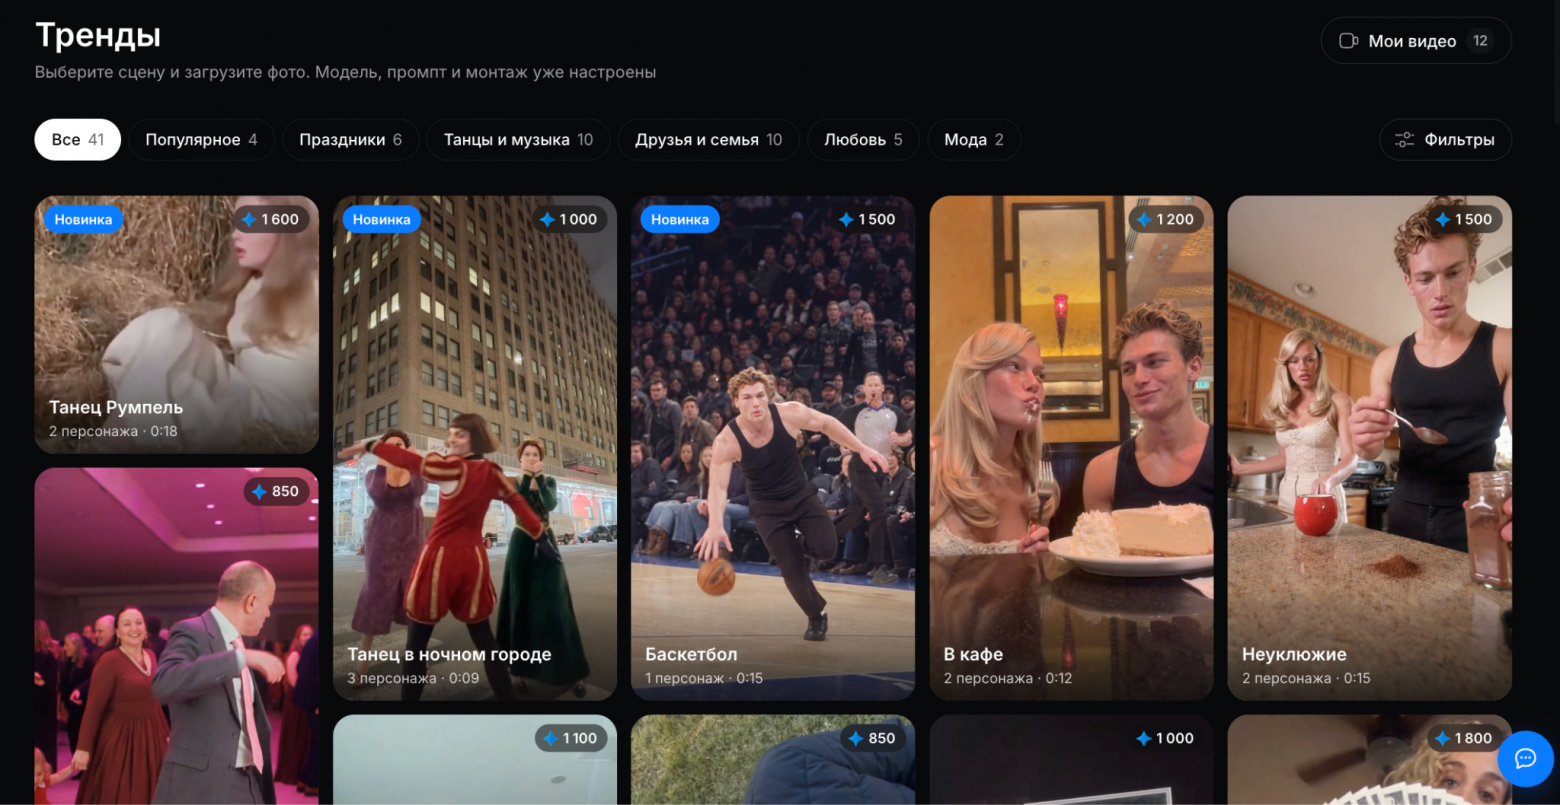
Шаблон тренда — это уже собранный сценарий популярного ролика: сцена, движение камеры, музыка и тайминг. От вас нужно только фото, иногда два. Промпт писать не нужно, монтировать тоже.
Я проверил несколько шаблонов на фото баристы из тестовой истории. Тренды с заменой героя в готовой сцене получаются заметно стабильнее, чем попытка повторить то же самое промптом с нуля: шаблон уже подобран под нужную модель и формат 9:16. Для SMM и личного блога это самый короткий путь от идеи до ролика в Reels, Shorts или VK Клипах.
Что умеет:
-
десятки готовых трендовых сценариев в одном каталоге;
-
генерация по одному-двум фото, без промптов;
-
вертикальный формат под соцсети;
-
музыка и движение камеры уже встроены в шаблон.
Главный плюс — результат за два действия. Ограничение: шаблон есть шаблон, сюжет менять нельзя. Для своей истории подойдут Seedance, Kling и другие модели из подборки.
Перейти к шаблонам трендов в Study AI
7. Veo 3.1 (Вео) — звукорежиссер и актер диалога
Veo 3.1 от Google одной из первых стала генерировать видео сразу со звуком: речь, шаги, звон посуды, фоновый шум улицы. В диалоговых сценах это главный козырь. Модель понимает подробные описания, работает с фото-референсами и умеет строить ролик между заданным первым и последним кадром.
В тесте Veo лучше всех справилась с атмосферой: шипение кофемашины, гул голосов, стук двери совпадали с действиями в кадре. Реплика баристы тоже звучала естественно.
Что умеет:
-
видео со встроенным звуком и синхронизацией губ;
-
точное выполнение длинных подробных промптов;
-
генерация по тексту, по фото, по первому и последнему кадру;
-
реалистичная физика и свет.
Главный плюс — сцена со звуком без отдельной озвучки. Ограничение: за один проход получаются короткие клипы, длинную сцену приходится продлевать или собирать из нескольких частей.
8. Wan 3.0 (Ван) — массовка и длинные общие планы
Wan 3.0 от Alibaba генерирует ролики от пары секунд до 30 секунд со звуком и хорошо держит нескольких персонажей в одном кадре. Там, где другие модели путают героев местами или «склеивают» их лица, Wan сохраняет внешность каждого до конца сцены.
На общем плане с посетителями Wan шла почти вровень с Seedance, а по скорости генерации оказалась удобнее для серии вариантов. Для регулярного контента, где нужно сделать много роликов в одном стиле, это сильный кандидат.
Что умеет:
-
сцены до 30 секунд с несколькими героями;
-
генерация по тексту, по фото и по референсам;
-
нативный звук;
-
первый и последний кадр для контроля начала и финала.
Главный плюс — несколько персонажей без путаницы. Ограничение: на сверхкрупных планах лиц Kling выглядит чуть выразительнее, поэтому многие сочетают эти две модели в одном ролике.
9. Gemini Omni Flash (Джемини Омни) — монтажер правок: ИИ для редактирования видео текстом
Gemini Omni Flash от Google — модель нового типа. Она не только генерирует ролики, но и правит уже готовые в режиме диалога. Загружаете короткое видео и пишете: «замени дождь за окном на солнечное утро» или «убери чашку слева». Следующей репликой можно уточнить результат, не начиная заново.
На шестом кадре теста Omni Flash единственная из основного состава сделала правку погоды и удаление предмета без перегенерации всей сцены: композиция и движение героя остались прежними.
Что умеет:
-
редактирование готового видео текстовыми командами;
-
смена света, погоды, стиля, удаление и добавление объектов;
-
генерация по тексту, фото и видео-референсам;
-
встроенный звук.
Главный плюс — правки без пересъемки. Ограничение: модель рассчитана на короткие фрагменты, поэтому длинный ролик удобнее править по кускам.
Попробовать нейросеть Gemini Omni Flash
10. HappyHorse (Хэппи Хорс) — оператор второго плана
HappyHorse 1.0 от Alibaba весной неожиданно поднялась на вершину независимых слепых сравнений видеомоделей. Она делает ролики до 15 секунд в 1080p сразу со звуком и синхронизацией губ на нескольких языках. Веса модели открыты, поэтому ее быстро подхватили многие сервисы.
В тесте HappyHorse лучше всего показала себя на атмосферных кадрах: пар над чашкой, утренний свет на стойке, улица за окном. Такие вставки нужны почти в каждом ролике, и делать их в тяжелых моделях часто избыточно.
Что умеет:
-
короткие сцены со звуком по тексту и по фото;
-
генерация по нескольким референсам с сохранением стиля;
-
синхронизация губ на нескольких языках;
-
быстрая генерация для перебора вариантов.
Главный плюс — красивый второй план без лишних затрат времени. Ограничение: сложную постановку с несколькими действиями лучше отдать Seedance или Kling.
Попробовать нейросеть HappyHorse
Кто не вошел в основной состав, но пригодится
-
Runway Aleph — видеонейросеть для постпродакшна: меняет стиль, ракурс и объекты в готовом ролике. Хорошая альтернатива Gemini Omni Flash, если нужно переделать сцену целиком.
-
MiniMax H3 (Hailuo 3.0) — новая версия Hailuo со звуком и роликами до 15 секунд. Сильна в правках по референсу, пока доступна не во всех агрегаторах.
-
Grok Imagine Video 1.5 — быстрая модель xAI для оживления изображений со звуком. Удобна для черновиков, когда важна скорость.
-
Sora — потребительское приложение OpenAI закрыли весной, поэтому в подборке ее нет. Старые инструкции по Sora сейчас неактуальны.
Таблица: какой ИИ для видео за какой кадр отвечает
|
Нейросеть |
Роль в группе |
Лучший кадр из теста |
Длина за один проход |
Свой звук |
На входе |
|
Seedance 2.5 |
Режиссер длинного дубля |
Общий план с действиями |
До 30 сек |
Да |
Текст, фото, видео |
|
Kling 3.0 / 4.0 |
Оператор крупного плана |
Лицо с репликой |
До 15 / до 30 сек |
Да |
Текст, фото, ключевые кадры |
|
Kling Motion Control |
Хореограф |
Движение по образцу |
Короткие ролики |
По исходнику |
Фото + видео-образец |
|
Veo 3.1 |
Звукорежиссер |
Диалог и атмосфера |
Короткие клипы |
Да |
Текст, фото, первый и последний кадр |
|
Wan 3.0 |
Массовка |
Несколько героев |
До 30 сек |
Да |
Текст, фото, референсы |
|
Gemini Omni Flash |
Монтажер правок |
Правка готового ролика |
Короткие фрагменты |
Да |
Текст, фото, видео |
|
HappyHorse |
Второй план |
Атмосферные вставки |
До 15 сек |
Да |
Текст, фото, референсы |
|
Оживление фото |
Аниматор |
Старое фото |
Короткие ролики |
Нет |
Фото |
Кастинг по задаче: какую видео нейросеть взять
Ниже типовые задачи, с которыми чаще всего приходят к ИИ для видео, и состав, который под них подходит.
|
Задача |
Основная нейросеть |
Чем подстраховать |
|
Ролик с лицом для Reels и Shorts |
Kling 3.0 / 4.0 |
Veo 3.1 для звука |
|
Видео для карточки товара |
Seedance 2.5 |
HappyHorse для крупных вставок |
|
Танец или трендовое движение |
Kling Motion Control |
Шаблоны трендов |
|
Поздравление по фото |
Шаблоны трендов |
Оживление фото |
|
Обучающий ролик или объяснение |
Veo 3.1 |
Wan 3.0 для общих планов |
|
Короткий фильм или клип |
Seedance 2.5 + Kling |
Wan 3.0 для массовых сцен |
|
Оживить архивный снимок |
Оживление фото |
Kling для сложного движения |
|
Исправить готовый ролик |
Gemini Omni Flash |
Runway Aleph |
Если нужна нейросеть для видео бесплатно на русском и без VPN под одну простую задачу, начните с оживления фото или шаблона тренда. Если задача сложнее одного действия, переходите к полноценным моделям.
Как собрать один ролик из нескольких нейросетей
Вот как выглядела финальная сборка тестовой истории про кофейню. Это рабочая схема, которую можно повторить под любой сюжет.
-
Стартовый кадр. Сгенерировал внешний вид баристы и интерьер кофейни в Nano Banana Pro. Одна и та же картинка дальше служит референсом во всех видеомоделях, поэтому герой не меняется от кадра к кадру.
-
Крупный план. Реплику баристы отдал Kling: лицо и губы там самые живые.
-
Общий план. Сцену с посетителями сделал в Seedance 2.5 одним длинным дублем.
-
Вставки. Пар над чашкой и свет на стойке сгенерировал в HappyHorse.
-
Правки. В одном кадре за окном лил дождь, хотя по сюжету утро солнечное. Исправил в Gemini Omni Flash одной командой.
-
Склейка. Собрал кадры в обычном видеоредакторе, подложил музыку и субтитры.
Ключевая идея: стартовое изображение решает проблему «разных лиц» лучше любого промпта. Если герой каждый раз генерируется с нуля, нейросети неизбежно рисуют его немного по-разному.
Режиссерский бриф: формула промпта для видеонейросети
Почти все модели одинаково хорошо понимают промпт, построенный как короткое задание оператору. Формула:
[план и ракурс] + [кто в кадре и что делает] + [движение камеры] + [свет и время суток] + [звук] + [формат и длительность]
Порядок важен: сначала то, что зритель увидит первым. Писать можно на русском. Для сложных движений камеры английские термины вроде dolly in или orbit иногда срабатывают точнее, кому-то это удобно, а кому-то проще описать движение своими словами.
Крупный план с репликой:
text
Крупный план, девушка-бариста за стойкой смотрит в камеру, улыбается и говорит: «Доброе утро, ваш капучино готов». Камера медленно приближается. Мягкий утренний свет из окна слева. Звук: шипение кофемашины, тихая музыка. Вертикальное видео 9:16, 8 секунд.
Предметный кадр для товара:
text
Чашка кофе с латте-артом на деревянной стойке, над ней поднимается пар. Камера плавно облетает чашку по кругу на уровне стола. Теплый свет, фон размыт. Звук: тихий звон ложки. Горизонтальное видео 16:9, 6 секунд.
Длинный общий план с несколькими героями:
text
Общий план маленькой кофейни утром. В дверь заходят трое посетителей, снимают куртки и садятся за столик у окна. Бариста подходит с подносом и ставит три чашки. Камера медленно следует за баристой. Солнечный свет, уютная атмосфера. Звук: колокольчик на двери, гул голосов. 16:9, 20 секунд.
Оживление старого фото:
text
Оживи фотографию: люди за столиками начинают негромко разговаривать, официант проходит между столами, за окном проезжает трамвай. Сохрани черно-белый стиль и зернистость пленки. Легкое движение камеры вперед.
Правка готового ролика:
text
Замени дождь за окном на солнечное утро, добавь солнечные блики на стойку. Убери чашку слева. Движения бариста и ракурс камеры не меняй.
Частые ошибки, из-за которых ролик выглядит «нейросетевым»
-
Одна модель на все. Самая частая причина слабого результата. Лицо, толпа и предметка — разные задачи, и у каждой свой лучший исполнитель.
-
Слишком много действий в коротком клипе. В 5–8 секундах помещается одно основное действие. Три события подряд почти гарантируют спешку и странную физику.
-
Нет стартового изображения. Без референса герой меняется от кадра к кадру. Сначала сделайте картинку, потом анимируйте ее.
-
Оценка по одной генерации. Первая попытка может оказаться случайно удачной или случайно провальной. Делайте два-три прогона, прежде чем менять промпт или модель.
-
Промпт как список прилагательных. «Красиво, кинематографично, 8K, шедевр» почти ничего не дает. Модели понимают действия, камеру и свет, а не оценочные слова.
Нейросеть для видео бесплатно и без VPN: что реально работает из России
Большинство сильных видеомоделей зарубежные, и напрямую оплатить их российской картой нельзя. Поэтому на практике есть два пути.
Первый — агрегаторы нейросетей, где модели собраны в одном кабинете с русским интерфейсом и оплатой картой РФ. Это самый простой вариант, если нужна нейросеть для видео онлайн без VPN и без зарубежных карт. В Study AI после регистрации можно бесплатно сделать пробные генерации и понять, какая модель подходит под вашу задачу, а дальше расход идет по токенам.
Второй — открытые модели, например HappyHorse или Wan прошлых версий, которые можно запустить на своем компьютере. Но для этого нужна мощная видеокарта и время на настройку, так что вариант подходит скорее разработчикам, чем тем, кому нужен ролик к вечеру.
Честно о слове «бесплатно»: генерация видео — самая ресурсоемкая задача для ИИ, поэтому полностью бесплатных безлимитных сервисов с качеством уровня Kling или Seedance не существует. Бесплатные генерации нужны, чтобы попробовать и выбрать, а регулярная работа почти всегда платная.
Вопросы и ответы
Какая нейросеть для видео лучшая в 2026 году?
Одной лучшей нет, есть лучшая под кадр. Для лиц и эмоций — Kling 3.0 и 4.0, для длинных сцен — Seedance 2.5 и Wan 3.0, для диалогов со звуком — Veo 3.1, для правок готового ролика — Gemini Omni Flash. Новичкам проще начать с оживления фото или шаблонов трендов.
Есть ли нейросеть для видео бесплатно и на русском?
Да, в агрегаторах вроде Study AI можно бесплатно попробовать видеонейросети на русском без VPN: интерфейс русский, промпты тоже можно писать по-русски. Бесплатные генерации ограничены, их хватает на пробу нескольких моделей.
Какая нейросеть делает видео из фото?
Почти все современные модели умеют оживлять фото. Для простого оживления портрета подойдет инструмент «Оживление фото», для сложного сюжета по фото — Kling, Seedance 2.5 и Wan 3.0, для переноса танца на человека с фото — Kling Motion Control.
Какая нейросеть делает видео со звуком и голосом?
Звук и речь сразу генерируют Veo 3.1, Kling 3.0 и 4.0, Seedance 2.5, Wan 3.0, HappyHorse и Gemini Omni Flash. Лучше всего синхронизация губ получается у Veo и Kling.
Можно ли нейросетью отредактировать готовое видео?
Да. Gemini Omni Flash и Runway Aleph меняют свет, погоду, стиль и объекты в уже снятом ролике по текстовой команде. Для полноценного монтажа, нарезки и улучшения качества нужны отдельные инструменты.
Что случилось с Sora и чем ее заменить?
Потребительское приложение Sora от OpenAI закрыли весной, а затем отключили и API. Ближайшие замены по качеству — Seedance 2.5, Kling 4.0 и Veo 3.1.
Сколько секунд видео можно сгенерировать за один раз?
Зависит от модели. Seedance 2.5, Wan 3.0 и Kling 4.0 делают до 30 секунд за проход, Kling 3.0 и HappyHorse до 15 секунд, Veo 3.1 и Gemini Omni Flash работают короткими клипами. Ролик длиннее собирается из нескольких генераций.
Итоги
Нейросети для видео сейчас лучше всего работают командой. Kling отвечает за крупные планы и эмоции, Seedance 2.5 и Wan 3.0 за длинные сцены, Veo 3.1 за звук и диалоги, Gemini Omni Flash за правки, HappyHorse за атмосферные вставки. Тем, кто только начинает, проще стартовать с оживления фото и готовых шаблонов трендов, а потом переходить к собственным сюжетам.
Главный практический совет: делайте стартовое изображение героя, раздавайте кадры разным моделям по их сильным сторонам и не судите нейросеть по одной генерации.
Все модели из подборки можно сравнить на одном промпте на агрегаторе Study AI: видео нейросети, генераторы фото, музыки и текста работают там на русском и без VPN.
ссылка на оригинал статьи https://habr.com/ru/articles/1105424/