Иногда интересную книгу хочется не читать, а слушать: по дороге на работу, во время прогулки или домашних дел. Но далеко не каждое произведение существует в аудиоформате. Особенно это касается новых авторских рассказов, учебной литературы, электронных документов и собственных рукописей. Решить эту проблему помогает озвучка книг нейросетью, которая преобразует написанные предложения в естественную человеческую речь.
Сегодня озвучка текста голосом через нейросеть позволяет подобрать мужского или женского рассказчика, настроить выразительность, скорость произношения и характер интонации. Современные голосовые модели способны читать художественную литературу, научно-популярные произведения и образовательные материалы, сохраняя особенности выбранного голоса.
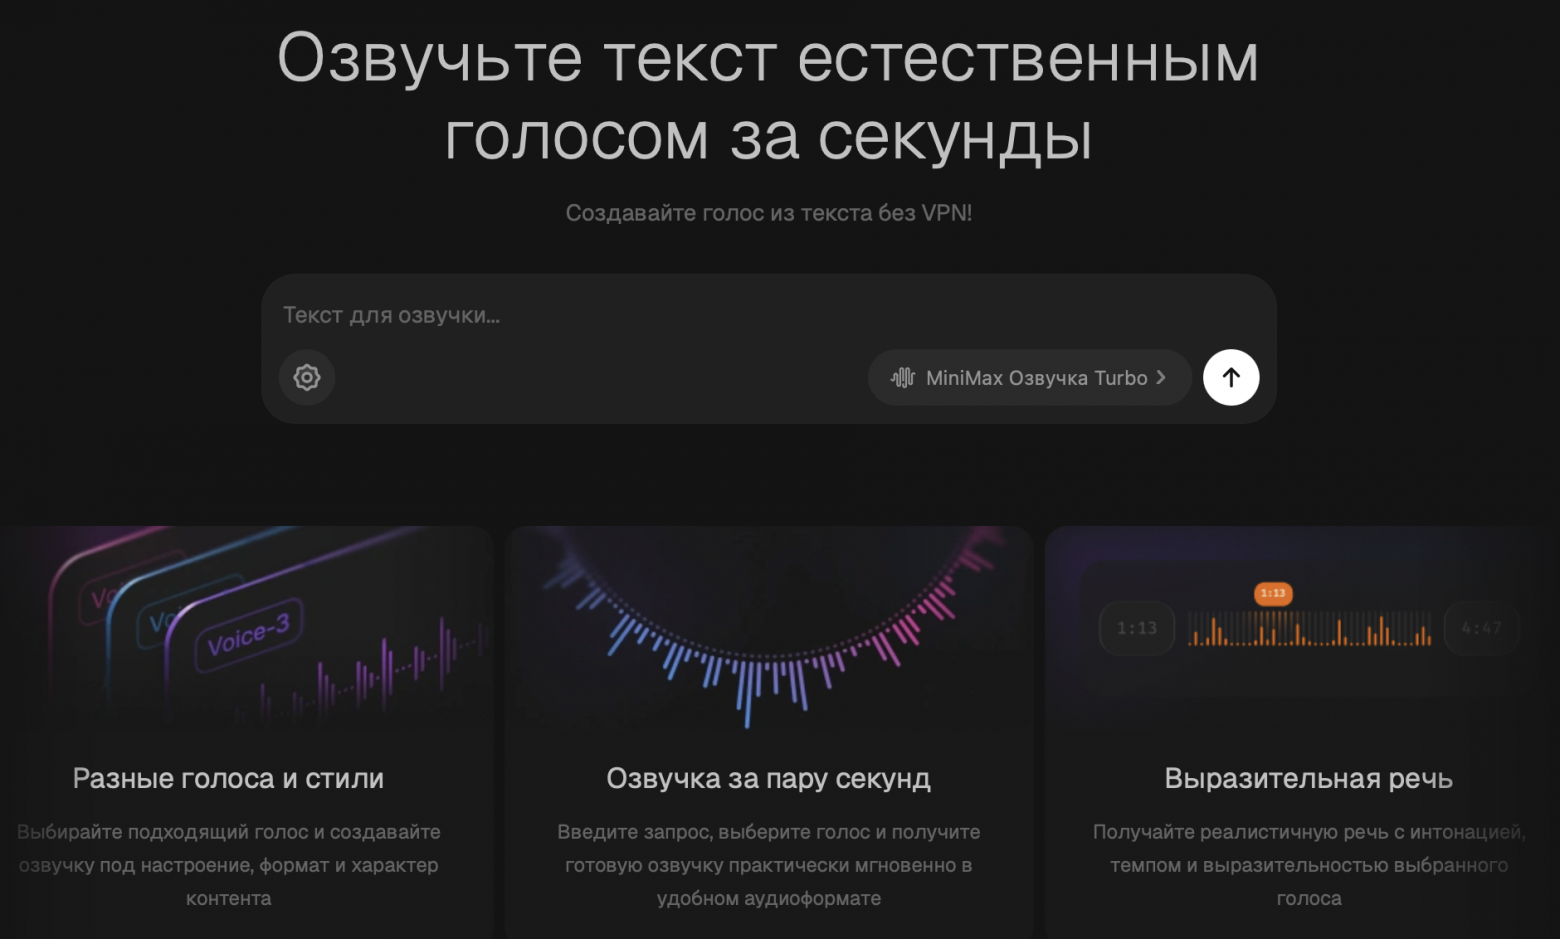
При этом качественная аудиокнига отличается от простой записи, в которой синтезированный голос последовательно произносит слова. Слушателю нужны правильные смысловые акценты, понятные диалоги, естественные паузы и комфортный темп. Рассмотрим, как организовать этот процесс, какие настройки действительно влияют на результат и какие три ИИ-сервиса стоит попробовать.
Как превратить обычный текст в полноценную аудиокнигу с помощью ИИ?
Генерация аудио с помощью ИИ основана на технологии Text-to-Speech, или TTS. Она преобразует письменный текст в звуковую дорожку, используя обученную модель синтеза речи. Пользователь передает текст, выбирает голос и получает аудиозапись, которую можно прослушать или сохранить в поддерживаемом формате.
Раньше подобные инструменты часто выдавали механическую речь с одинаковыми паузами и неестественными ударениями. Новые голосовые модели значительно лучше учитывают контекст предложений, различают вопросительную и повествовательную интонацию, а некоторые позволяют отдельно управлять эмоциональной окраской произношения.
Что можно озвучивать нейросетью
Для преобразования в аудиоформат подходят практически любые материалы, содержащие связный текст. Однако настройки лучше подбирать с учетом того, как слушатель будет воспринимать информацию.
Наиболее распространенные варианты:
-
Художественная литература. Романы, повести, рассказы, детективы, фантастика и приключенческие произведения.
-
Детские книги. Сказки, короткие истории, познавательные рассказы и произведения с большим количеством диалогов.
-
Учебные материалы. Конспекты, лекции, пособия, литературные произведения из школьной программы.
-
Научно-популярные книги. Материалы по истории, психологии, технологиям, экономике и другим направлениям.
-
Авторские рукописи. Собственные рассказы, черновики романов, сценарии и неопубликованные произведения.
-
Электронные документы. Текстовые файлы, статьи, инструкции и материалы, сохраненные в PDF.
Почему для книги недостаточно обычного синтезатора речи
Главная особенность литературной озвучки заключается в продолжительности. Голос, который приятно звучит в коротком рекламном объявлении, необязательно подойдет для трехчасового повествования. Слишком эмоциональная манера быстро утомляет, а монотонное чтение мешает воспринимать сюжет.
Поэтому озвучка книг реалистичным голосом требует баланса между выразительностью и стабильностью. Хороший рассказчик не подчеркивает каждое слово, а выделяет только действительно важные детали. Во время спокойных описаний он поддерживает ровный ритм, а в напряженных эпизодах немного меняет интонацию.
Не менее важна согласованность звучания. Если первую главу читает спокойный низкий голос, а следующую – заметно более высокий и энергичный, аудиокнига воспринимается как набор отдельных записей. Именно поэтому параметры рассказчика желательно определить до начала основной генерации.
Какие форматы книг можно использовать
Сервисам синтеза речи проще всего работать с обычным текстом. Его можно скопировать из документа, вставить в редактор и отправить на генерацию. Некоторые платформы дополнительно поддерживают импорт PDF и EPUB, но возможности зависят от выбранного инструмента.
Озвучка PDF книги нейросетью имеет свои особенности. Если документ содержит обычный текстовый слой, его часто удается извлечь непосредственно. Сканированные страницы сначала требуют распознавания символов, поскольку для программы они могут выглядеть как изображения.
Отдельная ситуация – книги с таблицами, формулами и иллюстрациями. Перед преобразованием стоит решить, что должно звучать в записи, а что лучше пропустить.
Как озвучить книгу нейросетью онлайн бесплатно: последовательность действий
На первый взгляд задача выглядит простой: открыть голосовой генератор, вставить текст и запустить обработку. Такой способ подойдет для нескольких абзацев, но с полноценной книгой лучше использовать более организованный подход.
Современная озвучка текста нейросетью позволяет получать качественные фрагменты даже без навыков работы со звуком. Чтобы не переделывать готовые главы из-за неправильно выбранного рассказчика, рекомендуется сначала подготовить небольшой пробный материал.
Шаг 1. Определите назначение будущей записи
Подумайте, кто будет слушать аудиокнигу и в каких обстоятельствах. Для личного прослушивания можно выбрать привычную разговорную подачу. Если запись предназначена для образовательного проекта, приоритетом станут отчетливая дикция и отсутствие ненужных эмоциональных переходов.
Для художественного произведения полезно заранее определить повествовательную перспективу. История от первого лица часто лучше воспринимается как личный рассказ, тогда как повествование от третьего лица допускает более нейтральную дикторскую манеру.
Шаг 2. Подготовьте электронную версию произведения
Откройте книгу и проверьте, нет ли в тексте технических элементов, которые не нужно произносить. После копирования из PDF могут оставаться номера страниц, разорванные слова, повторяющиеся колонтитулы и посторонние символы.
Особое внимание уделите прямой речи. Если реплики разных персонажей случайно объединены в один абзац, синтезатору будет сложнее определить эмоциональные переходы. Удобнее всего сохранить отдельный текстовый документ, предназначенный именно для озвучивания. Оригинальную рукопись при этом лучше оставить без изменений.
Шаг 3. Выберите пробный фрагмент
Для тестирования достаточно небольшого отрывка, содержащего несколько типов предложений. Идеально, если в нем присутствуют описание обстановки, короткий диалог и эмоционально окрашенная фраза.
Такой материал помогает сразу оценить несколько характеристик: правильно ли голос ставит ударения, не торопится ли во время диалогов, различает ли вопросы и утверждения. Проверять эти особенности на нейтральном предложении вроде «Сегодня хорошая погода» практически бесполезно.
Шаг 4. Подберите голос рассказчика
Выбор между мужским и женским голосом – только начало. Дополнительно важны тембр, речевой ритм, возрастное впечатление и эмоциональная манера.
Для исторического романа можно попробовать глубокий, размеренный голос. Современной молодежной прозе подойдет более легкая разговорная подача, а учебному материалу – нейтральный рассказчик с отчетливой артикуляцией. Необязательно выбирать самый выразительный вариант из доступных. Иногда спокойный голос лучше передает содержание и меньше утомляет при длительном прослушивании.
Шаг 5. Получите первую аудиозапись
Перенесите выбранный отрывок в ИИ для озвучки текста, укажите голос и доступные параметры генерации. Если сервис поддерживает текстовые инструкции для стиля, добавьте краткое описание желаемого звучания.
После обработки обязательно прослушайте результат целиком. Если темп подходит, но голос неправильно произносит несколько имен, не нужно сразу менять всю конфигурацию. Достаточно исправить проблемные слова и проверить их повторно.
Шаг 6. Продолжите работу над остальными главами
Когда пробная запись устраивает, переходите к полноценной книге. Если платформа рассчитана на небольшие текстовые фрагменты, загружайте главы последовательно. Для каждого отрывка используйте одинаковый голос и сохраненные параметры.
Таким образом можно создать аудиокнигу через нейросеть, не пытаясь обработать огромное произведение одним запросом. Такой подход также упрощает повторную запись отдельных предложений и последующее объединение файлов.
ТОП-3 лучших нейросетей для озвучки книг и создания аудиокниг
Для литературной озвучки особенно интересны инструменты, способные сохранять естественность речи, поддерживать русский язык и управлять выразительностью голоса. При выборе стоит учитывать не только качество отдельных фраз, но и удобство работы с большим текстом.
В подборку вошли три ИИ-сервиса с разными преимуществами:
-
ElevenLabs – голосовая платформа с инструментами для создания аудиокниг, настройки рассказчиков и работы с длинными произведениями.
-
MiniMax – нейросеть для синтеза естественной речи с настройками темпа, тембра, эмоциональности и различными голосовыми моделями.
-
Gemini – ИИ от Google с технологией Flash TTS для выразительного преобразования текста в аудио и управления голосом с помощью инструкций.
Каждый вариант решает задачу по-своему. ElevenLabs особенно удобен для организации больших аудиопроектов, MiniMax интересен гибкими голосовыми настройками, а Gemini Flash TTS предоставляет возможности контекстного управления произношением.
1. ElevenLabs – нейросеть для профессиональной озвучки книг и длинных произведений
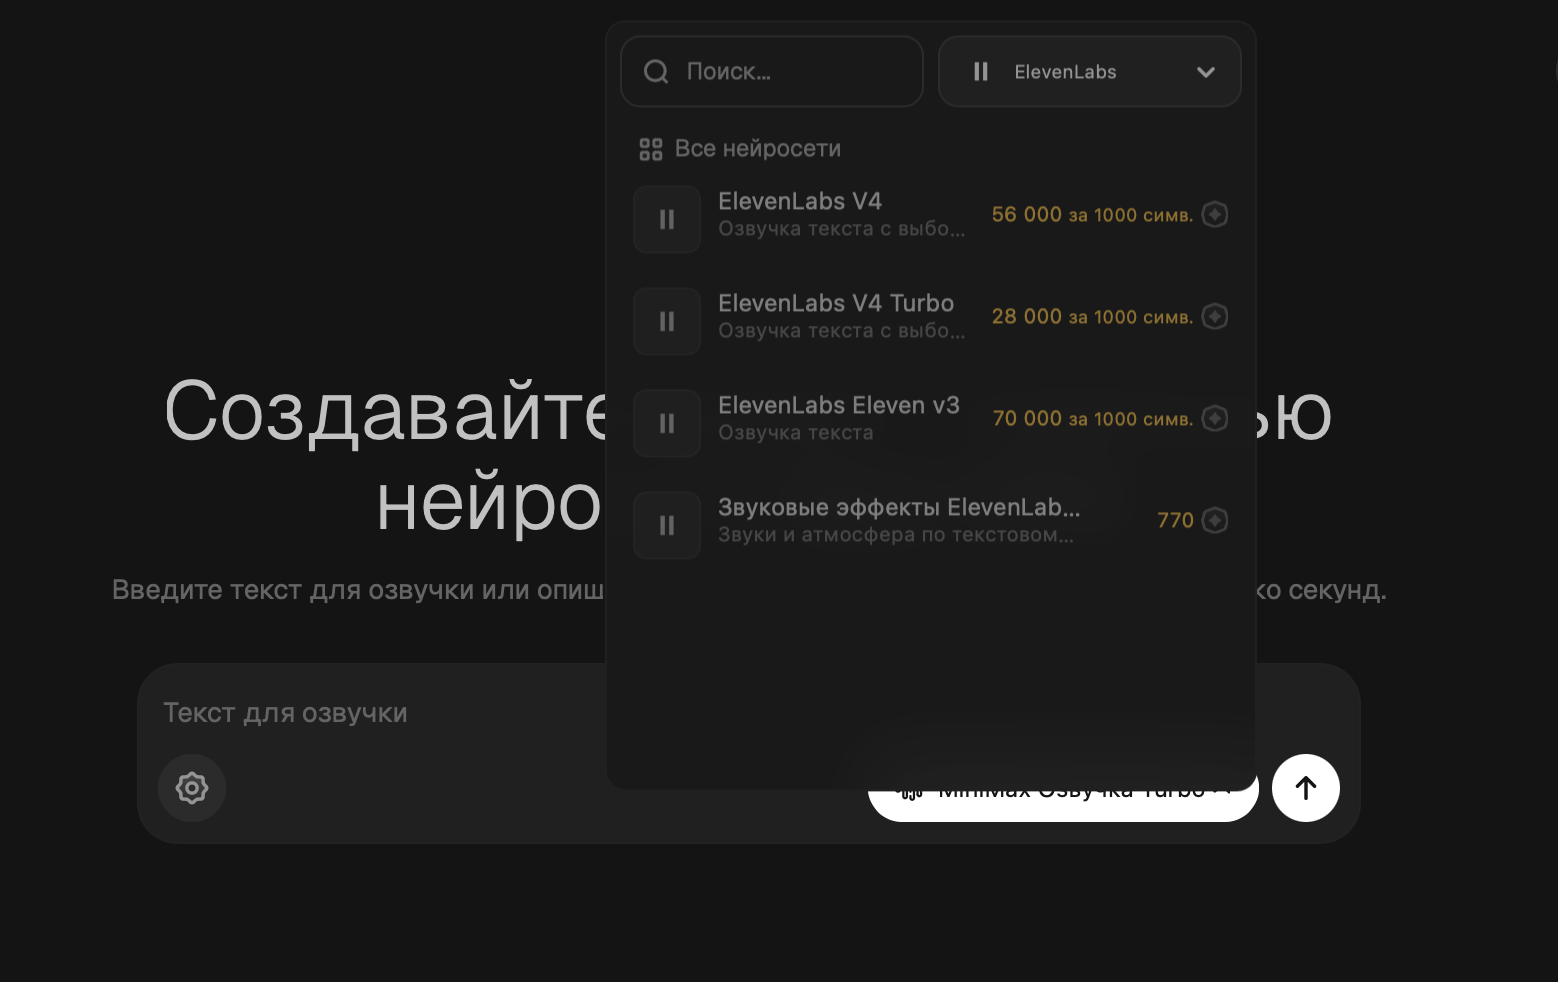
ElevenLabs – специализированная нейросеть для генерации речи искусственным интеллектом. Она подходит для создания художественных аудиокниг, подкастов, голосового сопровождения и других проектов, в которых важны естественная интонация и качество звучания.
Сильная сторона ElevenLabs заключается не только в голосовых моделях, но и в инструментах для работы с большими текстами. В редакторе аудиокниг можно организовать произведение по главам, выбрать рассказчика, исправить отдельные фрагменты и подготовить результат к экспорту.
Какие возможности полезны при озвучке литературы
Для начала пользователь может выбрать голос из библиотеки и проверить его на отрывке будущей книги. Доступны разные характеристики звучания, включая возрастное впечатление, тембр, языковые особенности и манеру подачи.
Для аудиокниг важны следующие функции:
-
организация текста по главам;
-
выбор одного рассказчика или нескольких голосов;
-
настройка произношения имен и нестандартных слов;
-
изменение отдельных абзацев без полной переделки проекта;
-
управление голосовыми параметрами;
-
экспорт готового аудио в доступных форматах.
В специализированном режиме поддерживается загрузка документов EPUB и PDF. Сервис анализирует их структуру, выделяет разделы и позволяет проверить результат распознавания перед генерацией. Это особенно удобно, если пользователь хочет создать аудиокнигу из текста онлайн, не копируя каждую страницу вручную.
Как использовать ElevenLabs для аудиокниги
Сначала выберите литературный фрагмент и несколько подходящих голосов. Сравните их на одном тексте, чтобы различия были связаны именно с голосом, а не с содержанием предложений.
Когда рассказчик выбран, установите его как основной голос проекта. Затем добавьте главы, проверьте распознанную структуру и подготовьте словарь произношения. Для художественных произведений можно отдельно назначить голоса важным персонажам, если используется соответствующий режим.
В качестве ориентира для повествовательной манеры подойдет следующий шаблон:
Промпт для ElevenLabs
Зрелый рассказчик, насыщенный средний тембр, спокойная литературная подача. Плавный ритм, естественная дикция, мягкие паузы между абзацами, умеренная эмоциональность, без рекламных интонаций.
В режимах, где отсутствует отдельное поле стилевых инструкций, подобную подачу следует подбирать через библиотеку голосов и доступные настройки, а не вставлять описание в сам текст книги.
Главное преимущество ElevenLabs – возможность работать с произведением как с полноценным аудиопроектом. При этом бесплатный план имеет ограниченный объем генерации, поэтому для большой книги может потребоваться дополнительный объем или платный тариф.
2. MiniMax – ИИ для естественной генерации голоса и озвучивания литературных текстов
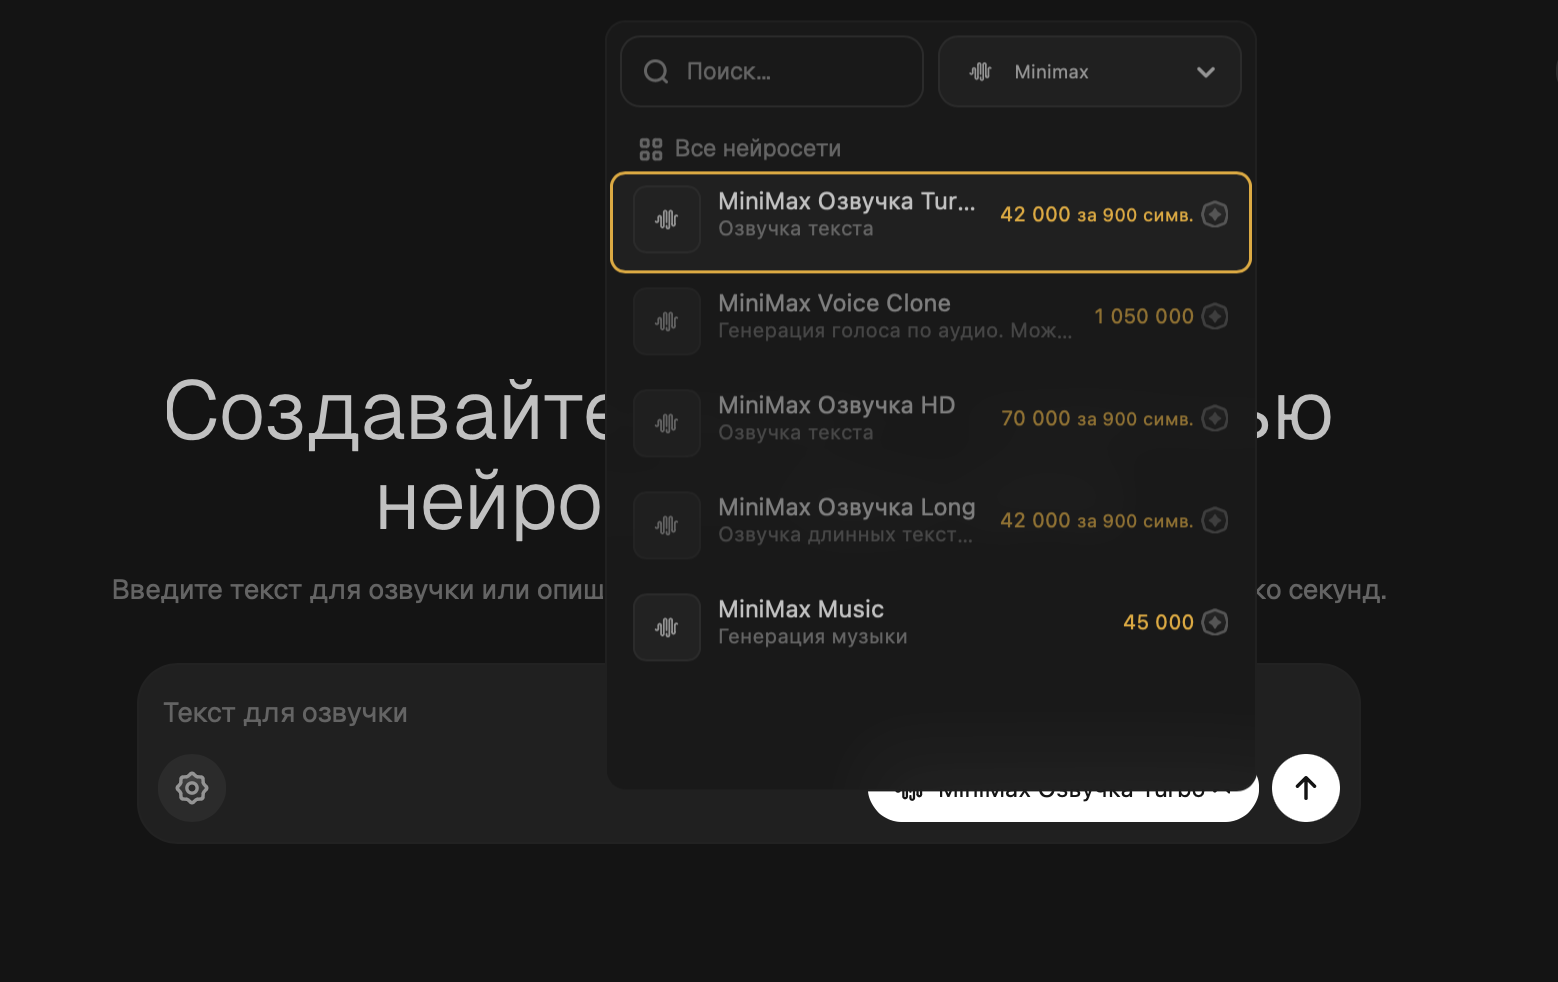
MiniMax – ИИ с технологиями синтеза речи, позволяющими преобразовывать текст в аудио с реалистичным голосовым звучанием. Нейросеть можно использовать для рассказов, образовательных материалов, литературных отрывков и других задач, где важна выразительная, но разборчивая речь.
Для аудиокниг MiniMax интересен возможностью сочетать качественный голос с техническими настройками. Пользователь может подбирать подходящий вариант произношения, изменять темп и управлять отдельными характеристиками синтезированной речи.
Какие голосовые модели подходят для книг
В линейке MiniMax Speech представлены модели, ориентированные на разные задачи. Например, Speech 2.8 HD предназначена для качественного синтеза с естественными речевыми особенностями, а Speech 2.8 Turbo делает акцент на скорости обработки.
Для литературного проекта разумно сначала попробовать вариант HD. При длительном прослушивании важны небольшие интонационные изменения, плавное произношение и отсутствие неприятных цифровых искажений.
Turbo может оказаться удобнее для быстрых предварительных генераций. Например, если автору необходимо прослушать несколько вариантов главы и выбрать окончательную редакцию.
Что можно настроить в MiniMax
В зависимости от интерфейса и выбранной модели доступны различные способы управления речью. Среди наиболее полезных для книги параметров:
-
Speed – скорость произношения текста.
-
Pitch – высота голосового тона.
-
Volume – уровень громкости.
-
Voice – выбор голосового профиля.
-
Emotion – эмоциональная окраска, если поддерживается выбранной моделью.
-
Формат аудио – способ сохранения полученной записи.
Особое внимание стоит уделить высоте тона. Если слишком сильно повысить Pitch, даже спокойный рассказчик может начать звучать неестественно. Лучше сначала подобрать готовый голос с подходящим тембром, а затем вносить небольшие корректировки.
Чем MiniMax удобен для больших текстов
При подготовке длинного произведения важна возможность сохранять выбранный голос и последовательно генерировать новые фрагменты. Это позволяет работать с главами независимо и при необходимости заменять отдельные участки записи.
MiniMax также поддерживает технологии создания и воспроизведения пользовательских голосовых профилей. Однако использовать образец чужого голоса следует только при наличии необходимого согласия и прав.
Промпт для MiniMax
Женский голос среднего регистра, теплый насыщенный тембр, уверенная спокойная манера. Размеренный темп, четкие окончания слов, легкая эмоциональная выразительность, естественные переходы между фразами.
Если интерфейс предлагает отдельные параметры скорости и эмоций, описание можно сократить до характеристик тембра. Остальные свойства удобнее задать соответствующими настройками.
Для каких произведений лучше выбрать MiniMax
Сервис стоит попробовать для современной прозы, рассказов, биографий, коротких повестей и образовательной литературы. Особенно полезен он в проектах, где нужно получить несколько вариантов голосового исполнения и сравнить их между собой.
Возможности бесплатной генерации зависят от действующих условий доступа. Для знакомства с качеством речи достаточно небольшого фрагмента, но полную многочасовую аудиокнигу обычно приходится создавать с учетом доступного объема.
3. Gemini Flash TTS – нейросеть Google для озвучивания текста с управлением интонацией
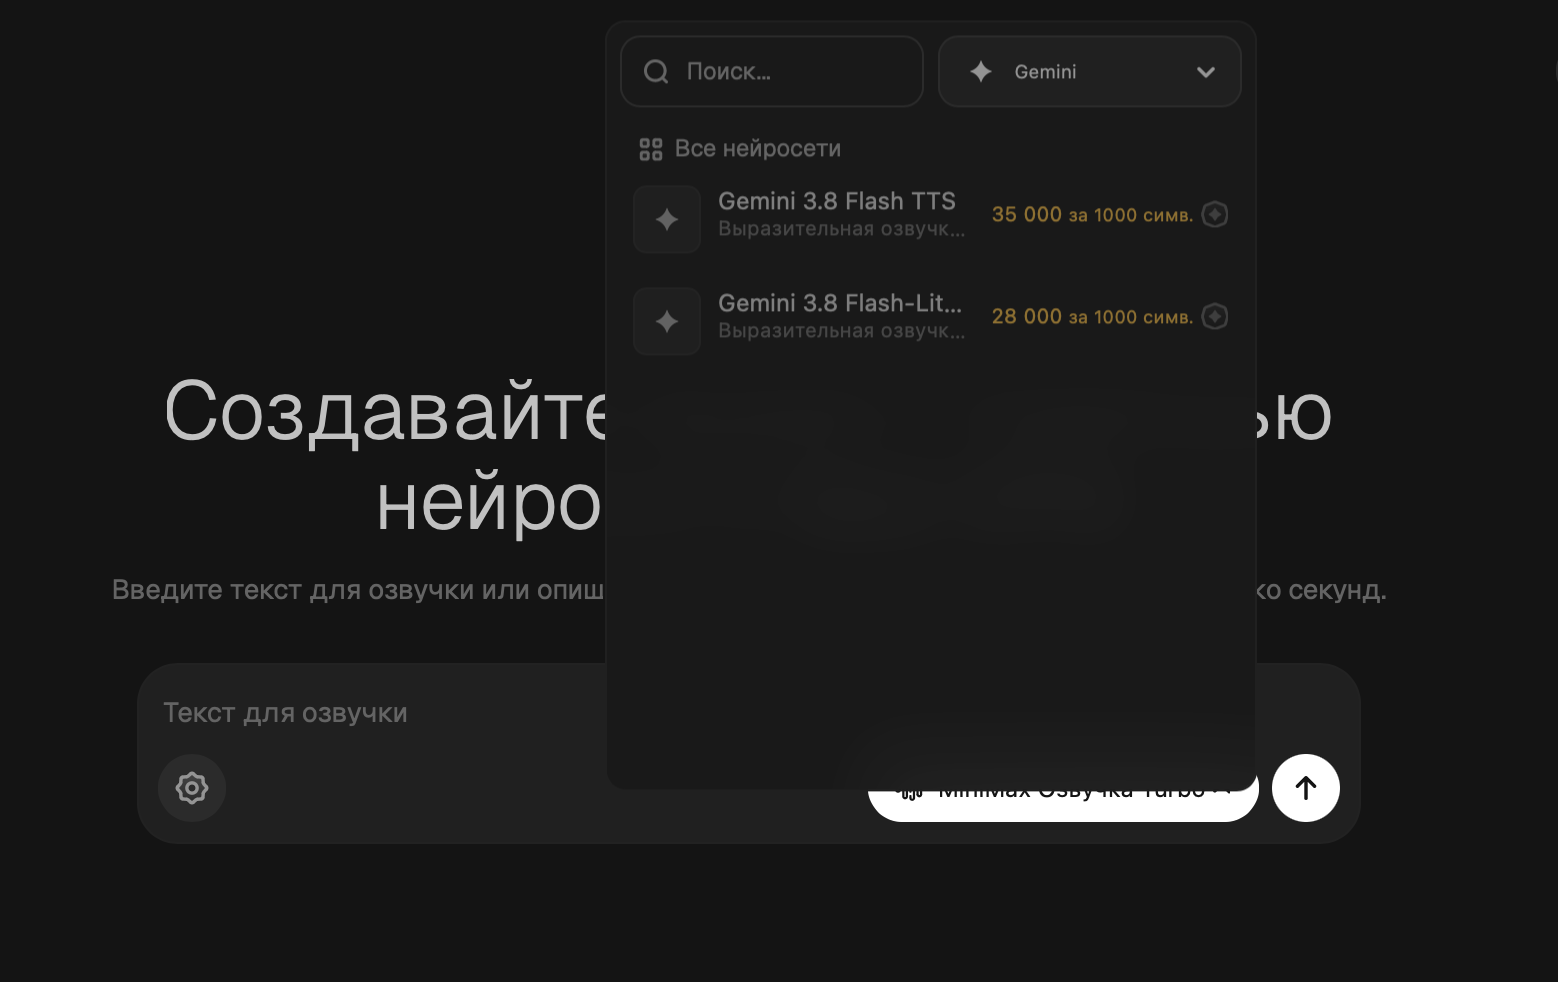
Gemini – семейство ИИ-моделей Google, включающее инструменты для работы с текстом и генерации речи. Для преобразования письменного материала в аудио предназначены специализированные модели Gemini Flash TTS, способные учитывать текстовые инструкции о характере произношения.
Особенность технологии заключается в контекстном управлении речью. Модель может получать не только текст произведения, но и отдельные указания о голосе, темпе и интонации.
Это открывает интересные возможности для художественных произведений, где важно передавать настроение конкретной сцены. Например, одни и те же предложения можно прочитать сдержанно, задумчиво или с легким волнением.
Какие возможности есть у Gemini Flash TTS
В линейке представлены разные поколения моделей, включая Gemini 3.8 Flash TTS и более легкую Gemini 3.8 Flash-Lite TTS. Первая ориентирована на высокое качество и выразительность речи, вторая – на более экономичную и быструю обработку.
Для аудиокниг особенно полезны следующие возможности:
-
генерация речи по предоставленному тексту;
-
выбор доступных голосовых профилей;
-
настройка стиля произношения через инструкции;
-
создание эмоционально окрашенных реплик;
-
работа с несколькими говорящими в поддерживаемых режимах;
-
генерация речи на русском и других языках.
Gemini Flash TTS отличается от обычного голосового ассистента. Технология предназначена именно для синтеза заданного текста, поэтому ее можно использовать для последовательного озвучивания литературных фрагментов.
Как управлять произношением через промпт
Важное преимущество Gemini – возможность задавать характеристики речевой подачи более гибким описанием. Например, для научно-популярного текста можно определить спокойный темп и ясную дикцию, а для художественного эпизода добавить определенное эмоциональное настроение.
Промпт для Gemini Flash TTS
Взрослый мужской голос, мягкий низкий тембр, спокойная повествовательная интонация. Умеренный темп, выразительные смысловые акценты, естественные паузы, ясное произношение русских слов, без чрезмерной драматичности.
Для отдельных сцен можно уточнять эмоциональную манеру. Например, сделать речь немного тише, добавить осторожность или усилить уверенность рассказчика, не меняя основной голосовой профиль.
Подходит ли Gemini для нескольких персонажей
Поддержка многоголосой генерации позволяет использовать отдельные голосовые профили для разных участников разговора. Это особенно интересно для литературных произведений с небольшим количеством действующих лиц.
Предположим, в книге постоянно общаются два героя. Одному можно назначить низкий размеренный голос, другому – более высокий и быстрый. При правильной подготовке диалога слушателю будет проще различать персонажей.
Однако многоголосая генерация не означает, что модель автоматически правильно разметит любой роман. Реплики желательно предварительно распределить между говорящими, а полученный результат проверить.
Когда стоит использовать Gemini Flash TTS
Gemini подойдет тем, кто хочет экспериментировать с интонацией и более подробно описывать особенности чтения. Его можно рассматривать для художественных отрывков, диалоговых сцен, образовательных аудиоматериалов и авторских рассказов.
Как выбрать нейросеть для озвучки конкретной книги
Универсального победителя среди голосовых генераторов нет. Одному пользователю требуется удобный редактор для нескольких сотен страниц, другому – эмоциональная озвучка короткого рассказа, а третьему важнее быстро подготовить аудиоверсию учебника. Поэтому лучшая нейросеть для озвучки текста определяется задачей, а не только реалистичностью демонстрационного голоса.
|
Критерий |
ElevenLabs |
MiniMax |
Gemini Flash TTS |
|
Основная сильная сторона |
Работа с аудиокнигами |
Гибкий синтез речи |
Управление стилем через инструкции |
|
Художественные произведения |
Хорошо подходит |
Хорошо подходит |
Хорошо подходит |
|
Настройка голоса |
Выбор и параметры моделей |
Голос, темп, тон, эмоции |
Голосовые профили и инструкции |
|
Диалоги |
Возможна работа с персонажами |
Зависит от режима |
Поддерживается многоголосый TTS |
|
Бесплатный доступ |
Ограниченный план |
Бесплатные возможности по условиям сервиса |
Бесплатные квоты в поддерживаемых режимах |
Если речь идет о полноценном романе, удобство организации глав может оказаться важнее дополнительных голосовых эффектов. Для короткого рассказа, напротив, интереснее экспериментировать с эмоциональной выразительностью.
Чтобы сравнение было объективным, используйте один и тот же фрагмент во всех трех сервисах. Прослушайте результаты на одинаковой громкости, а затем оцените произношение, темп, естественность и комфортность голоса.
Создание контента с помощью нейросетей Ranvik: генерация фото, видео, текстов и аудио онлайн
ИИ для генерации картинок и обработки фотографий позволяет создавать визуальный контент по текстовому описанию или изменять загруженные изображения. С помощью нейросети можно разрабатывать реалистичные фотографии, цифровые иллюстрации, рекламные креативы и графику для оформления сайтов.
Нейросеть для написания статей и создания текстов помогает готовить материалы для публикаций, бизнеса и личных проектов. Искусственный интеллект составляет информационные статьи, рекламные объявления, карточки товаров и сценарии, ориентируясь на заданную тему, стиль и структуру.
Создание видео нейросетью по текстовому запросу открывает возможности для генерации видеороликов без самостоятельной съемки. Достаточно описать будущую сцену, действия героев, расположение объектов и движение камеры, чтобы ИИ сформировал видеоряд.
Ranvik – сервис нейросетей для создания контента предоставляет доступ к инструментам генерации и редактирования материалов разных форматов. Пользователи могут работать с изображениями, создавать видеоролики, подготавливать тексты, озвучивать материалы и экспериментировать со звуковыми эффектами.
Генератор музыки на основе искусственного интеллекта подходит для создания оригинальных мелодий и аудиокомпозиций. В текстовом запросе можно обозначить музыкальное направление, ритм, набор инструментов и настроение, которое должна передавать готовая запись.
Анимация фото с помощью нейросети онлайн превращает неподвижные изображения в короткие динамичные сцены. Искусственный интеллект добавляет движение персонажам, природным элементам и предметам, помогая создавать необычный визуальный контент на основе фотографий.
Преобразование текста в речь с помощью ИИ позволяет создавать голосовую озвучку для видео, презентаций и информационных материалов. Пользователь загружает или вводит текст, настраивает доступные параметры синтеза и получает аудиофайл с произнесенным содержимым.
Примеры промптов для создания изображений нейросетью помогают подобрать идеи для фотогенерации и детально описать желаемый результат. Готовые текстовые запросы содержат рекомендации по композиции, стилистике, освещению и визуальным особенностям будущего изображения.
Готовые запросы для генерации ИИ-видео упрощают подготовку видеосцен с определенным сюжетом и атмосферой. Пользователи могут изучать примеры описания движения персонажей, работы камеры, световых эффектов и окружающего пространства.
Как составлять промпты для генерации голоса и озвучивания книг
Правильно настроенная голосовая модель способна передавать не только содержание текста, но и определенную манеру чтения. Для этого используются параметры синтеза, выбор подходящего голоса и, если модель поддерживает такую возможность, инструкции на естественном языке.
Здесь важно учитывать различие между обычным текстовым чат-ботом и специализированной TTS-системой. В последней не нужно писать длинные команды вроде «Представь, что ты профессиональный диктор, создай мне аудиокнигу». Достаточно описать характеристики голоса и требуемую подачу.
Какие параметры указывать в голосовом промпте
В качестве основы можно использовать пять характеристик:
-
Тембр. Низкий, средний, высокий, мягкий, бархатистый, звонкий или слегка хрипловатый.
-
Манера речи. Доверительная, спокойная, уверенная, повествовательная, разговорная или артистичная.
-
Темп. Размеренный, умеренный, динамичный либо немного замедленный.
-
Эмоциональная окраска. Теплая, тревожная, задумчивая, радостная, сдержанная.
-
Особенности произношения. Четкая дикция, естественные паузы, отсутствие чрезмерной театральности.
Лучше сочетать несколько совместимых характеристик, чем перегружать описание противоречивыми указаниями. Например, сочетание «очень быстрый темп, длительные паузы, полностью спокойная речь и постоянное эмоциональное напряжение» не дает модели понятной задачи.
Для более сложного звукового оформления можно использовать промпты для музыки и аудио ИИ. Они помогают находить подходящие описания тембра, настроения и звучания, которые затем можно адаптировать для голосовой генерации.
Готовые промпты для разных литературных жанров
Ниже представлены промты, которые можно использовать в полях управления голосом или стилем речи. В них достаточно заменить характеристики под конкретное произведение.
Промпт для современного романа
Зрелый мужской голос, естественный средний тембр, мягкая разговорная манера. Умеренная скорость, спокойное повествование, легкие интонационные изменения в диалогах, плавные переходы между предложениями.
Подобная настройка подойдет для продолжительных историй, где эмоциональное напряжение меняется постепенно. Главная задача – сделать рассказчика приятным для длительного прослушивания.
Промпт для приключенческой литературы
Молодой женский голос, чистое звонкое звучание, энергичная, но естественная подача. Среднебыстрый темп, выразительные смысловые акценты, живые интонации, четкое произношение имен и названий.
Такое описание можно использовать для динамичных историй, путешествий и приключенческих рассказов. При необходимости темп стоит немного снизить в описательных фрагментах.
Промпт для психологической прозы
Низкий мягкий голос, сдержанная эмоциональная манера, доверительный тон. Неторопливое повествование, небольшие паузы после значимых мыслей, естественное изменение громкости, без актерского преувеличения.
Здесь важнее создать ощущение близости рассказчика, чем добиться максимально яркой голосовой игры. Особенно хорошо подобная подача сочетается с внутренними монологами и размышлениями.
Промпт для научно-популярной книги
Нейтральный взрослый голос, уверенная интеллектуальная подача, четкая артикуляция. Ровный умеренный темп, логическое выделение важных терминов, небольшие паузы после определений, спокойная интонация.
Если требуется озвучить текст голосом ИИ для учебных целей, подобный шаблон можно дополнить указанием на особенно отчетливое произношение чисел, дат и иностранных фамилий.
Промпт для детской сказки
Теплый доброжелательный женский голос, мягкий средний тембр, ласковая повествовательная манера. Размеренное чтение, светлая эмоциональность, выразительные вопросы, небольшие паузы между событиями.
Для детской литературы полезно избегать слишком резких голосовых изменений. Даже сказка с необычными персонажами должна оставаться комфортной для восприятия.
Промпт для мистического рассказа
Глубокий мужской голос, приглушенный тембр, осторожная напряженная подача. Медленный ритм в описаниях, короткие паузы перед важными открытиями, сдержанная тревожная интонация, без крика и преувеличенного драматизма.
Такой вариант помогает поддерживать атмосферу неизвестности. Особенно уместен он для историй, в которых напряжение создается деталями, а не постоянными эмоциональными всплесками.
Как добиться качественной озвучки книг нейросетью на русском языке
Даже хорошая нейросеть для озвучки текста иногда ошибается. Она может неверно произнести фамилию, неожиданно ускорить реплику или сделать паузу там, где предложение должно звучать слитно. В подобных случаях не всегда нужно менять сервис. Нередко достаточно немного отредактировать исходный текст или скорректировать настройки.
Делите длинные главы на законченные эпизоды
Большую главу удобнее обрабатывать отдельными смысловыми частями. Для начала можно попробовать фрагменты продолжительностью несколько минут, если выбранный инструмент поддерживает такой объем.
Не стоит разрывать предложение посередине ради соблюдения приблизительного количества символов. Лучше завершить отрывок на окончании абзаца, после диалога или перед сменой места действия.
Разделение помогает решать сразу несколько задач. При ошибке достаточно повторно сгенерировать небольшой участок, а при изменении характера сцены можно настроить интонацию только для нужного эпизода.
Проверяйте ударения и необычные имена
Русский язык содержит немало слов, написание которых не позволяет однозначно определить ударение. Особенно сложны имена персонажей, вымышленные географические названия и профессиональные термины.
Если голос постоянно произносит одно слово неправильно, попробуйте воспользоваться словарем произношения, если он предусмотрен платформой. В других случаях можно проверить запись с выделенной ударной гласной или фонетической подсказкой.
Например, условное имя персонажа «Арвелин» можно проверить в варианте «АрвелИн», если именно такое произношение предполагает автор. Однако написание заглавной буквой не является универсальной командой для всех TTS-моделей.
Важно не превращать весь текст в набор фонетических подсказок. Используйте их только там, где проблема действительно обнаружена. После каждой правки проверяйте звучание слова внутри полноценного предложения.
Не перегружайте голос эмоциональными инструкциями
Чрезмерная выразительность – распространенная проблема автоматической литературной озвучки. Когда рассказчик придает драматическое значение каждому предложению, слушатель быстро устает.
Для обычных описаний лучше выбирать спокойную манеру. Эмоциональные изменения должны появляться там, где они действительно поддерживают сюжет: во время конфликта, неожиданного открытия или важного разговора.
Если модель постоянно усиливает интонации, уменьшите выраженность эмоций или используйте более нейтральный голос. Часто это помогает больше, чем добавление новых уточнений к промпту.
Адаптируйте числа, сокращения и даты для произношения
Некоторые записи понятны при чтении глазами, но неоднозначны для синтезатора речи. Например, сокращение «г.» может означать «год» или «город», а последовательность чисел – дату, номер документа или количественное значение.
При подготовке аудиоверсии полезно раскрывать неоднозначные сокращения и проверять, как модель произносит числа. Если вместо «в две тысячи двадцать пятом году» голос читает отдельные цифры, исходную запись стоит изменить.
То же относится к иностранным фамилиям и названиям компаний. Если термин постоянно встречается в учебной книге, лучше один раз подобрать правильное произношение и затем использовать его последовательно.
Сохраняйте характер рассказчика
При генерации ИИ аудио из большой книги важно не менять параметры без необходимости. Если для первой главы выбран определенный голос, его следует использовать и дальше, если произведение не предполагает смену рассказчика.
Полезно сохранить небольшой эталонный фрагмент. Перед обработкой новой главы прослушайте его и сравните с текущим результатом. Разница в громкости, скорости или характере произношения обычно становится заметной сразу.
Если же изменения необходимы по сюжету, корректируйте прежде всего эмоциональную подачу, а не сам тембр. Так персонаж останется узнаваемым даже в напряженной сцене.
Как подготовить диалоги и сохранить индивидуальность персонажей
Диалоги – одна из наиболее сложных частей литературной озвучки. На странице читатель видит тире и абзацы, поэтому легко различает участников разговора. В аудиоформате эти подсказки исчезают, а ответственность за понятность сцены переходит к голосу.
В небольшом рассказе часто достаточно одного рассказчика, который слегка меняет интонацию для разных героев. Но в произведении с большим количеством разговоров можно использовать несколько голосовых профилей.
Один рассказчик или несколько голосов
Оба варианта имеют преимущества. Один голос помогает сохранить ощущение традиционной аудиокниги. Слушатель привыкает к манере повествования и воспринимает произведение как цельную историю.
Многоголосая запись больше напоминает аудиоспектакль. Такой подход подходит произведениям с выразительными персонажами, однако требует дополнительной работы: распределения реплик, настройки голосов и согласования громкости.
При выборе стоит учитывать количество действующих лиц. Для рассказа с двумя основными героями раздельная озвучка вполне удобна. Если персонажей несколько десятков, управление голосами становится значительно сложнее.
Как сделать персонажей различимыми
Необязательно назначать каждому герою радикально другой тембр. Иногда достаточно небольших отличий в манере речи.
Например:
-
главный рассказчик – спокойный, уверенный голос со средним темпом;
-
молодой персонаж – более легкая и быстрая разговорная подача;
-
пожилой герой – размеренный голос с мягкой интонацией;
-
строгий руководитель – короткие четкие фразы без выраженной эмоциональности.
Для каждого важного персонажа полезно сохранить отдельное описание. Тогда в следующей главе можно использовать те же параметры, не подбирая голос заново.
При этом генерация голоса для аудиокниги не должна превращаться в бесконечный подбор эффектных тембров. Персонажи должны отличаться достаточно отчетливо, но оставаться естественными.
Как объединить аудиофрагменты в готовую книгу
После создания аудио из текста возникает следующая задача – собрать отдельные записи в последовательное произведение. Для этого можно использовать встроенный редактор платформы или стороннюю программу для монтажа звука.
Самое важное – проверить переходы между фрагментами. Если в конце одной записи остается длинная тишина, а следующая начинается резким звуком, слушатель будет постоянно замечать монтаж.
Какие параметры нужно проверить перед объединением
|
Параметр |
Что проверить |
Как исправить |
|
Громкость |
Нет ли резких перепадов |
Выровнять уровни записи |
|
Паузы |
Не слишком ли длинные переходы |
Удалить лишнюю тишину |
|
Темп |
Одинаково ли звучат соседние части |
Проверить настройки генерации |
|
Тембр |
Сохраняется ли голос рассказчика |
Использовать единый профиль |
|
Звуковые артефакты |
Нет ли щелчков и искажений |
Перегенерировать проблемный участок |
|
Начало и конец |
Не обрываются ли слова |
Добавить небольшие отступы |
Для большинства аудиокниг подойдет MP3, поскольку этот формат удобно воспроизводить на телефонах и компьютерах. Если планируется дополнительная обработка звука, лучше использовать WAV или другой поддерживаемый формат без потерь, когда такая возможность доступна.
Нужна ли музыка в аудиокниге
Музыкальное оформление может усилить атмосферу произведения, но оно необязательно. В традиционной аудиокниге главную роль играет голос рассказчика, поэтому постоянный музыкальный фон иногда мешает воспринимать содержание.
Если хочется добавить музыку, лучше использовать короткие вступления, переходы между крупными частями или отдельные атмосферные эпизоды. При этом громкость фоновой дорожки должна оставаться заметно ниже речи.
Как подготовить аудиокнигу для телефона
После объединения глав удобно сохранить каждую из них отдельным файлом с последовательной нумерацией. Большинство аудиоплееров смогут воспроизводить такие записи в нужном порядке.
Также стоит добавить понятные названия, информацию об авторе и обложку, если это поддерживается выбранным редактором. Для личной библиотеки можно использовать обычные MP3-файлы, а для публикации на специальных площадках необходимо учитывать их технические требования.
Частые ошибки при озвучивании книг искусственным интеллектом
Даже если голос звучит реалистично, несколько небольших недочетов способны испортить впечатление от готовой записи. Обычно проблемы обнаруживаются уже в процессе прослушивания, поэтому лучше заранее понимать, на что обращать внимание.
Ошибка 1. Использование неподходящего голоса. Низкий драматический тембр может эффектно звучать в коротком трейлере, но утомлять при чтении спокойного романа. Выбирайте голос по содержанию произведения и продолжительности прослушивания.
Ошибка 2. Генерация без предварительной проверки текста. Лишние символы, повторяющиеся заголовки и неправильно распознанные слова попадут в аудиозапись. Редактирование исходника обычно проще, чем исправление уже созданного файла.
Ошибка 3. Частая смена настроек. Если постоянно изменять скорость, высоту тона и голосовой профиль, главы начнут звучать по-разному. Сохраняйте базовые параметры и корректируйте только действительно необходимые детали.
Ошибка 4. Слишком длинные фрагменты без контроля. В большой записи можно не заметить неправильно произнесенное имя или пропущенное предложение. Удобнее проверять небольшие законченные эпизоды непосредственно после генерации.
Ошибка 5. Избыточные паузы и эмоции. Длинные остановки после каждого предложения делают речь неестественной. Лучше использовать умеренную выразительность и доверять обычной пунктуации там, где она работает правильно.
Ошибка 6. Отсутствие итогового прослушивания. Технически успешно созданный файл еще не означает готовую аудиокнигу. Перед публикацией необходимо проверить последовательность глав, качество переходов и отсутствие обрывов речи.
Именно поэтому озвучка текста реалистичным голосом – это не только выбор современной модели, но и внимательное отношение к итоговому звучанию.
Можно ли превратить текст в аудиокнигу бесплатно
Бесплатная генерация речи действительно доступна в ряде ИИ-сервисов. Однако важно различать возможность протестировать голос, озвучить небольшой рассказ и подготовить многочасовое произведение без оплаты.
Для короткого рассказа этого может оказаться достаточно. Но большой роман содержит сотни тысяч символов, а повторная генерация отдельных сцен дополнительно расходует доступный объем обработки.
Если требуется нейросеть для озвучки текста бесплатно, разумно начинать с небольшого произведения. Сначала проверьте качество одного голоса, затем подготовьте несколько фрагментов и оцените, сколько ресурсов расходуется на выбранный формат.
Важно также учитывать условия использования аудиозаписей. Например, бесплатный план ElevenLabs предназначен для некоммерческих задач, а для коммерческого применения предусмотрены отдельные условия. Поэтому перед публикацией готовой аудиокниги следует проверить правила выбранного сервиса.
Как сократить количество повторных генераций
Самый эффективный способ – исправлять причины ошибок до обработки большого объема текста. Если голос неправильно читает название города, проверяйте исправление на одном предложении, а не на целой главе.
Также полезно заранее определить голосовой профиль, проверить сложные слова и подготовить исходник. Чем меньше изменений потребуется после начала основной генерации, тем экономнее окажется весь процесс.
FAQ: популярные вопросы об озвучке книг через нейросеть
1. Можно ли сделать аудиокнигу из PDF без копирования текста вручную?
Да, некоторые сервисы позволяют загружать PDF непосредственно. Например, такая возможность предусмотрена в инструментах ElevenLabs для аудиокниг. Если PDF состоит из сканированных страниц, может потребоваться предварительное распознавание текста. После импорта желательно проверить порядок абзацев и заголовков.
2. Какая нейросеть лучше подходит для озвучки книг на русском языке?
Стоит сравнить ElevenLabs, MiniMax и Gemini Flash TTS на одинаковом русском отрывке. Оценивайте не только приятность тембра, но и правильность ударений, чтение имен, естественность пауз и стабильность интонаций. Лучший вариант зависит от содержания произведения и предпочтений слушателя.
3. Можно ли озвучить книгу собственным голосом без записи всех страниц?
Да, некоторые голосовые платформы поддерживают клонирование голоса по образцу аудио. После создания голосового профиля система может использовать его для синтеза новых предложений. Качество зависит от исходной записи, модели и доступных функций.
4. Как сделать так, чтобы ИИ правильно читал сложные фамилии?
Сначала проверьте произношение фамилии в отдельном предложении. Если модель ошибается, используйте доступный словарь произношения или фонетическую подсказку. Особенно удобно заранее подготовить список повторяющихся имен и терминов, чтобы сохранять одинаковое произношение на протяжении всей книги.
5. Можно ли публиковать и продавать аудиокниги, созданные нейросетью?
Да, если у вас есть необходимые права на исходное произведение и соблюдены условия голосового сервиса. Для собственной книги обычно проще решить вопросы авторских прав. Если используется чужой текст, потребуется учитывать права правообладателя, а для коммерческого распространения также проверить лицензию на синтезированную речь.
Заключение
Современная нейросеть для озвучки текста позволяет превратить электронную книгу в аудиоформат, подобрать естественный голос рассказчика и управлять характером его произношения. ElevenLabs удобен для организации полноценных литературных проектов, MiniMax предлагает гибкие инструменты синтеза речи, а Gemini Flash TTS интересен возможностями контекстной настройки интонаций.
Чтобы получить качественную аудиокнигу, начните с небольшого отрывка, подберите подходящий тембр, подготовьте текст и проверьте произношение сложных слов. После этого можно последовательно озвучивать главы, сохранять единый стиль рассказчика и объединять записи в готовое произведение для комфортного прослушивания.
ссылка на оригинал статьи https://habr.com/ru/articles/1106224/