В прошлых двух статьях я рассказывал, как запустить Qwen3.8-Flash-Next (125 млрд параметров) на старом железе и как снять программный потолок FP16 на видеокартах. Обе статьи были про железо и про то, что можно взять готовое и заставить работать. Эта — другая. Я залез внутрь самого движка (Strata), построил живую визуализацию того, что он делает с экспертами модели под капотом, попробовал ответить на вопрос “а эксперты реально специализируются по темам?” — и на середине пути поймал себя на методологической ошибке, которая чуть не привела к красивому, но неверному выводу. Расскажу как есть, с цифрами и без приукрашивания.
Что такое Strata и при чём тут эксперты
Strata — движок инференса для MoE-моделей (Mixture-of-Experts): вместо одной плотной сети у модели есть десятки экспертов на каждый слой, и на каждый токен активируется лишь небольшое подмножество (top-K). У Qwen3.8-Flash-Next, с которой я работал всю эту серию статей, это 48 слоёв по 512 экспертов — то есть 24576 отдельных “узлов”, из которых на каждом шаге реально считает лишь небольшая часть.
Проблема в том, что весь набор экспертов (сотни гигабайт) физически не влезает в 8ГБ VRAM моей GTX 1070. Strata решает это адаптивным кэшем: часть экспертов постоянно живёт в VRAM (самые “горячие”), остальные читаются из RAM или SSD по мере надобности, и кэш сам решает, кого держать резидентно, а кого вытеснять — на основе decayed-счётчика обращений к каждому эксперту.
Вся эта механика раньше была для меня чёрным ящиком: я видел только агрегированные цифры в мониторинге (сколько экспертов в VRAM, hit rate). Захотелось увидеть её изнутри.
Строю живую карту экспертов
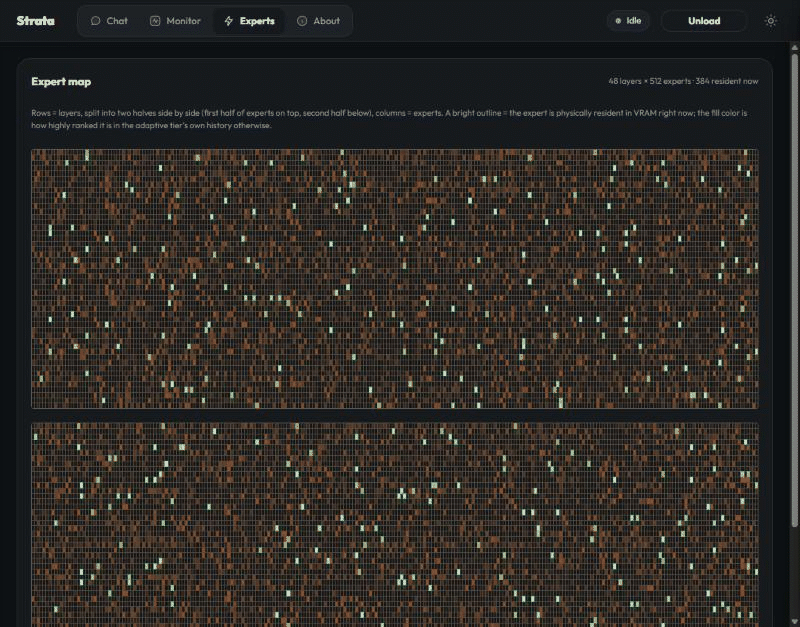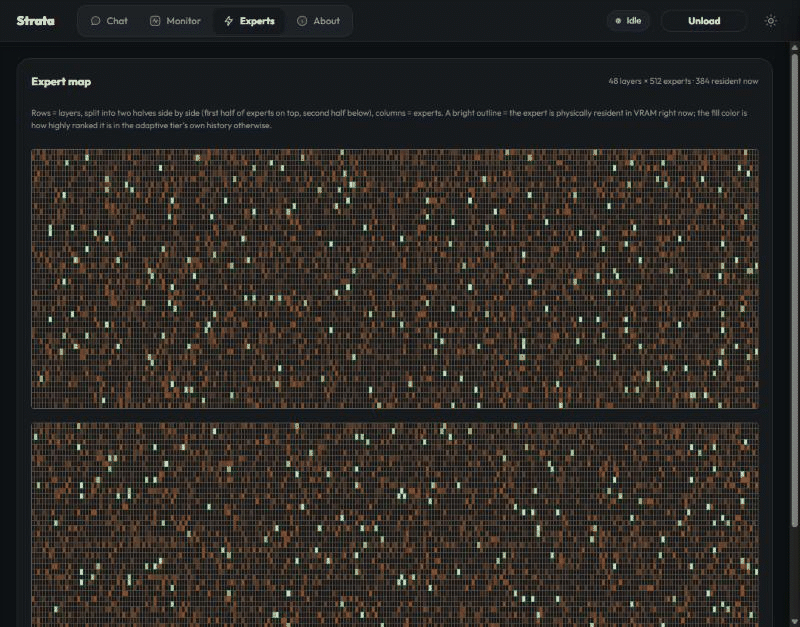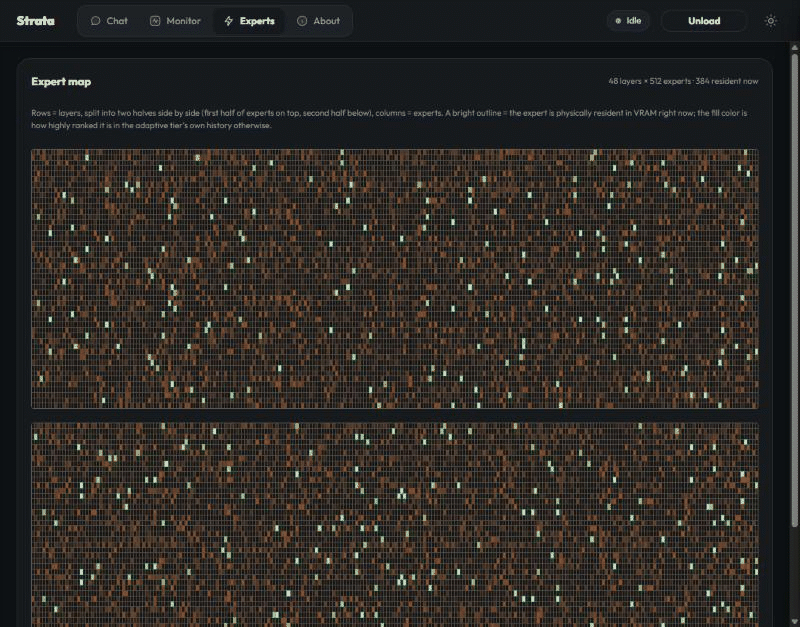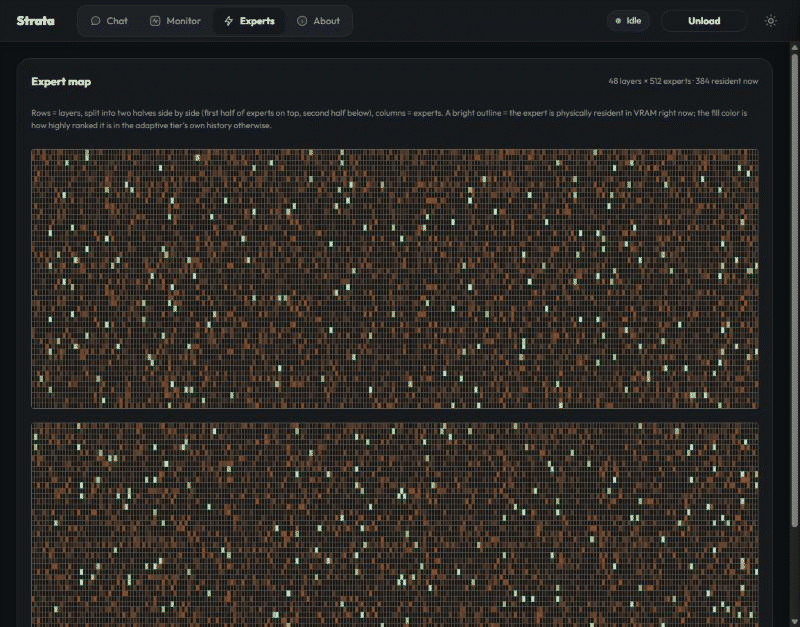
У Strata уже была опциональная фича — --expert-profile-save: движок умеет периодически сохранять на диск, какой ранг (место в истории обращений) у каждого из 24576 (слой, эксперт)-узлов, и какие из них сейчас физически резидентны в VRAM. Этим пользуется механизм “запомнить профиль между перезапусками”, но посмотреть на эти данные вживую было нельзя — только пересчитанные агрегаты в UI.
Я написал парсер этого бинарного формата и небольшую HTML-страницу: сетка 48×512, цвет клетки — историческая “теплота” эксперта, яркая рамка — физически резидентен в VRAM прямо сейчас. Сначала это был отдельный скрипт на отдельном порту — рабочий прототип, но не часть самого приложения.
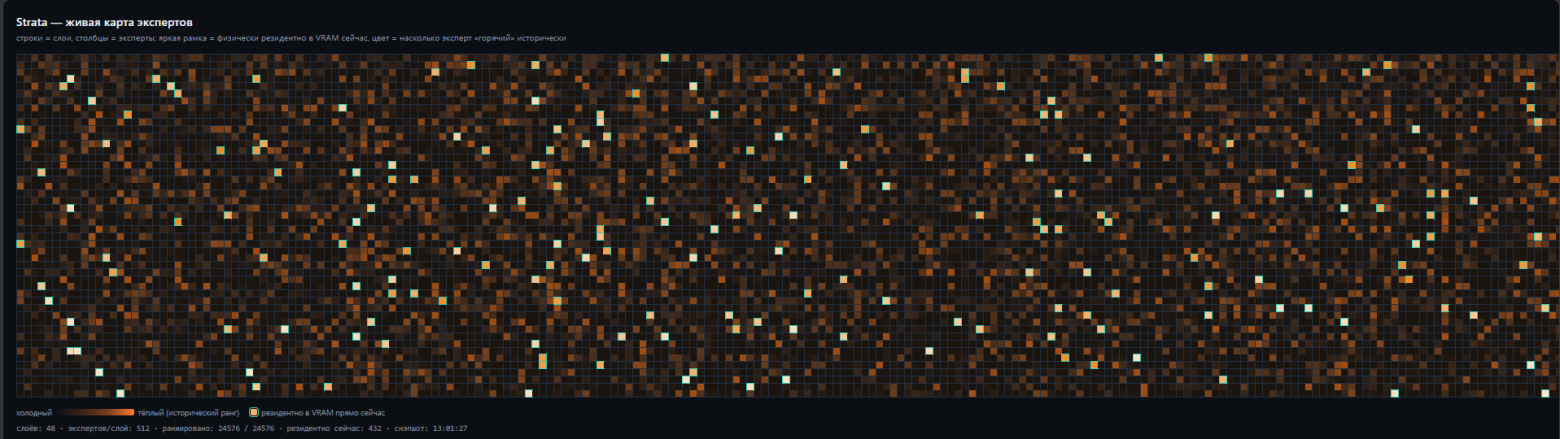
Дальше довел до полноценной вкладки прямо в веб-интерфейсе Strata — рядом с Chat/Monitor/About появилась вкладка “Experts”, на той же дизайн-системе, с поддержкой светлой и тёмной темы. Важная деталь: фича не потребовала ни строчки правок в движке — она просто читает файл, который --expert-profile-save и так пишет сегодня, просто на уровне отдельных экспертов вместо одной агрегированной цифры.
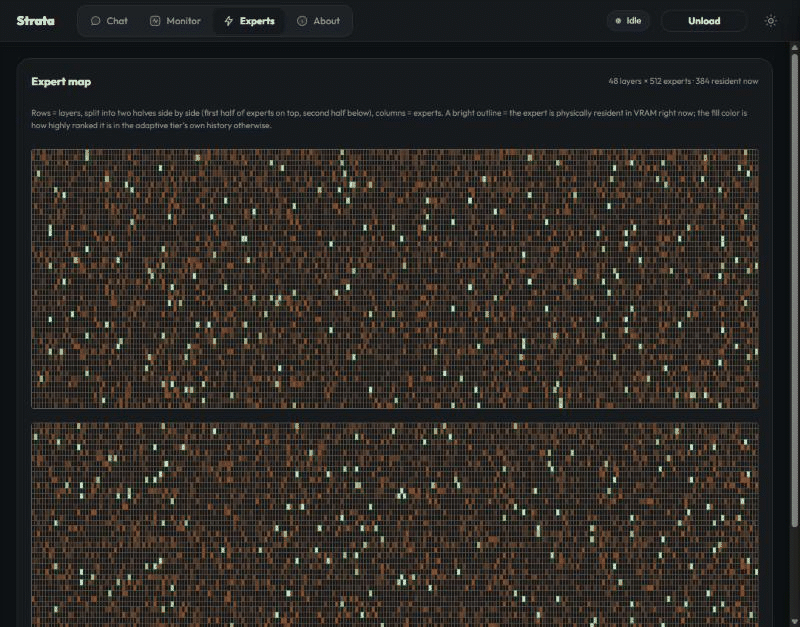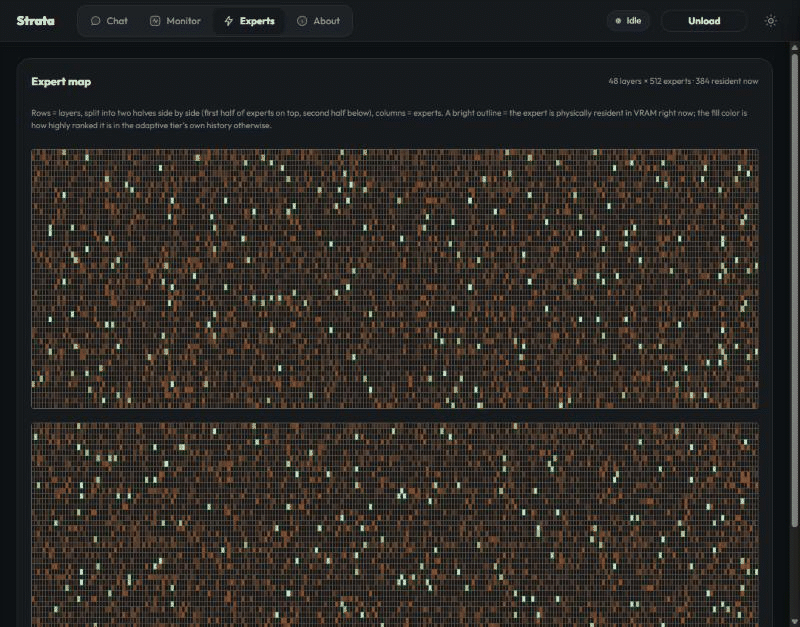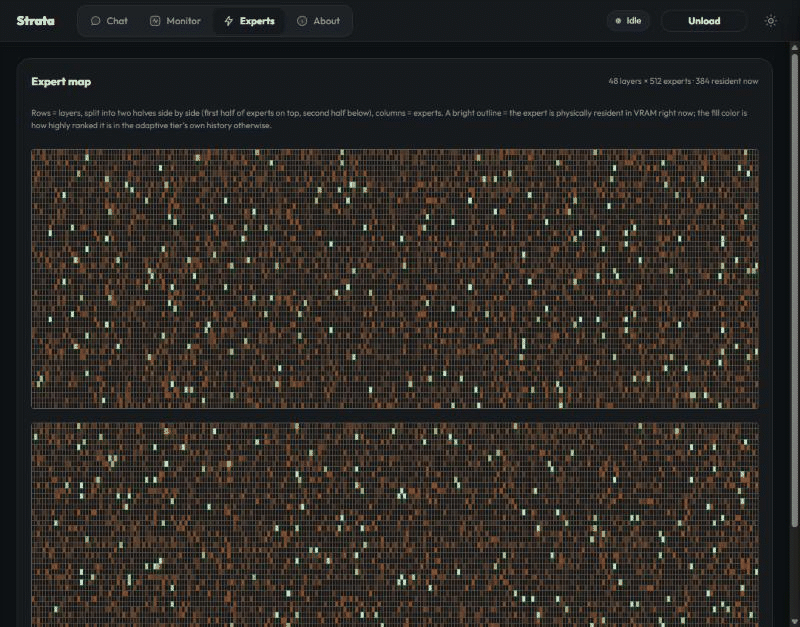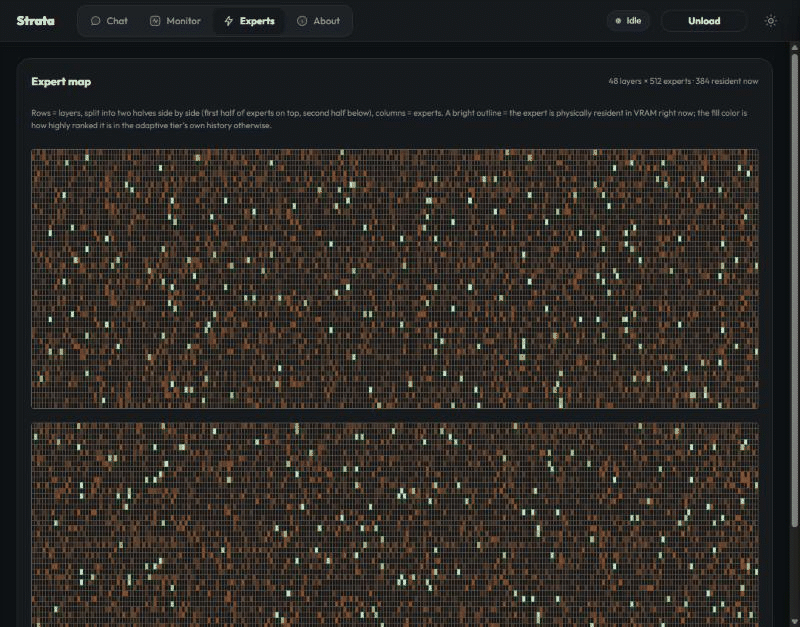
Ниже — две гифки, снятые прямо с живой вкладки (тёмная тема, по 10 кадров, карта обновляется в реальном времени по мере обработки запросов). Первая — на разнородных задачах:
-
Стихотворение про осенний дождь
-
Основы договорного права одним предложением
-
Объяснение нейросети по-немецки
-
Рассказ про большую панду
-
Форматирование JSON
-
Python-функция чисел Фибоначчи
-
Шутка в кэжуал-стиле
-
Симптомы простуды
-
Хайку про океан ночью
-
Перевод “доброе утро” на пять языков
А вторая — на однородных задачах, все про программирование (разные языки и подзадачи, но один домен):
-
Python-функция для разворота строки
-
JavaScript-функция с debounce
-
Сложность quicksort одним предложением
-
SQL-запрос на поиск дублирующихся строк
-
Исправление off-by-one бага в цикле
-
Python-декоратор, логирующий время выполнения функции
-
Разница между mutex и semaphore
-
Регулярное выражение для email
-
Rust-функция наибольшего общего делителя
-
Объяснение race condition
Разница на глаз честная, но скромная: при смене домена от кадра к кадру тёплые клетки скачут по всей карте заметнее, а внутри одного домена — чуть спокойнее. Не драматический контраст (это вкладка показывает ранг, а не сырую теплоту — ниже объясню, почему это важно), но направление то же, что количественно показывает UMAP-анализ дальше в статье.
Смотрю на вкладку живьём — и натыкаюсь на ту же ловушку второй раз
Решил проверить предположение до конца и прогнал вживую ещё два крайних случая: 30 разнородных запросов подряд, и 30 запросов с одним и тем же промптом без единой вариации (“Write a Python function that reverses a string.”, буквально одна и та же строка каждый раз).
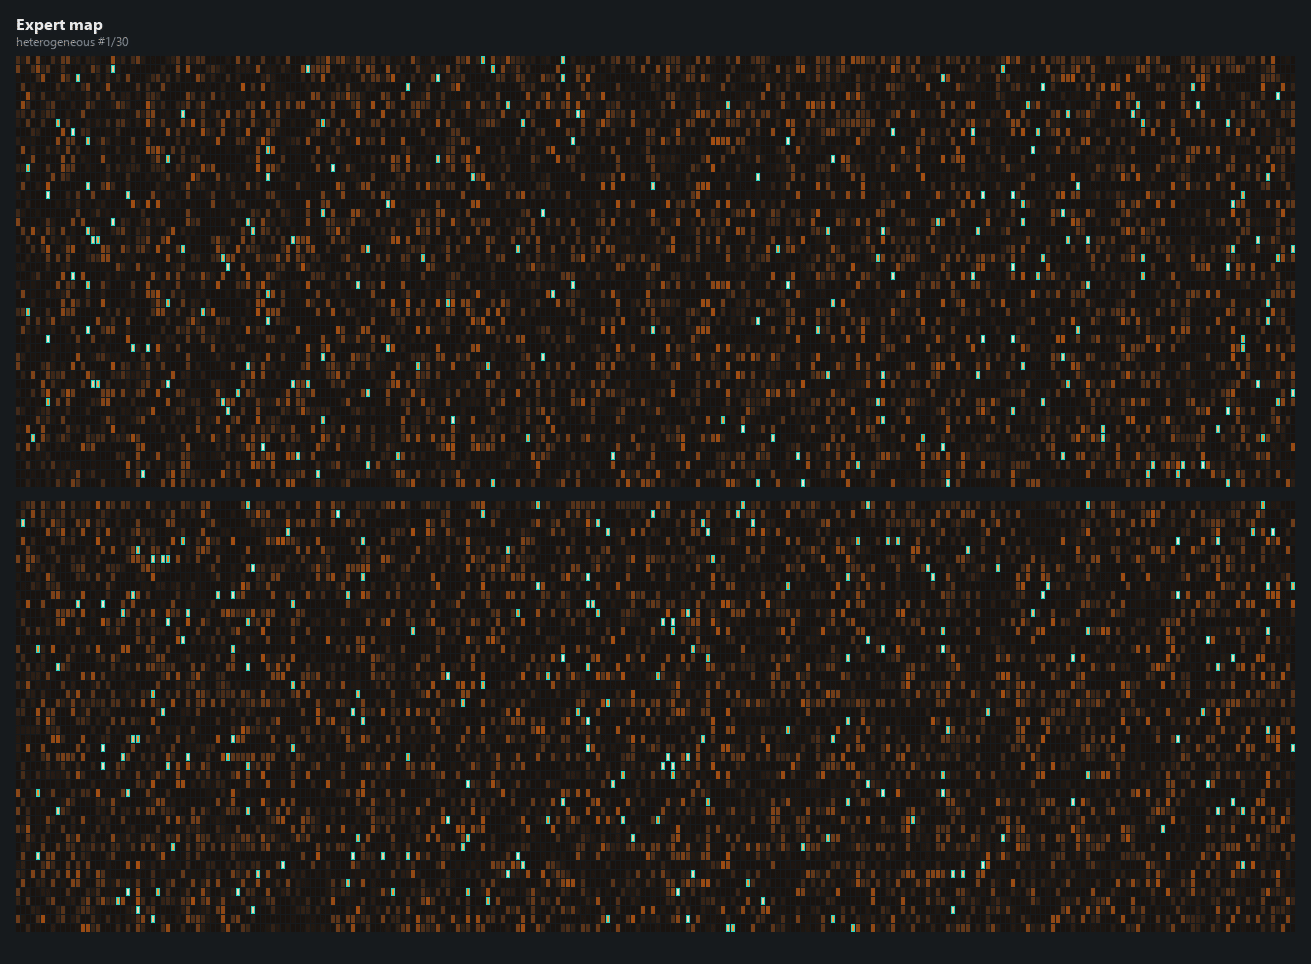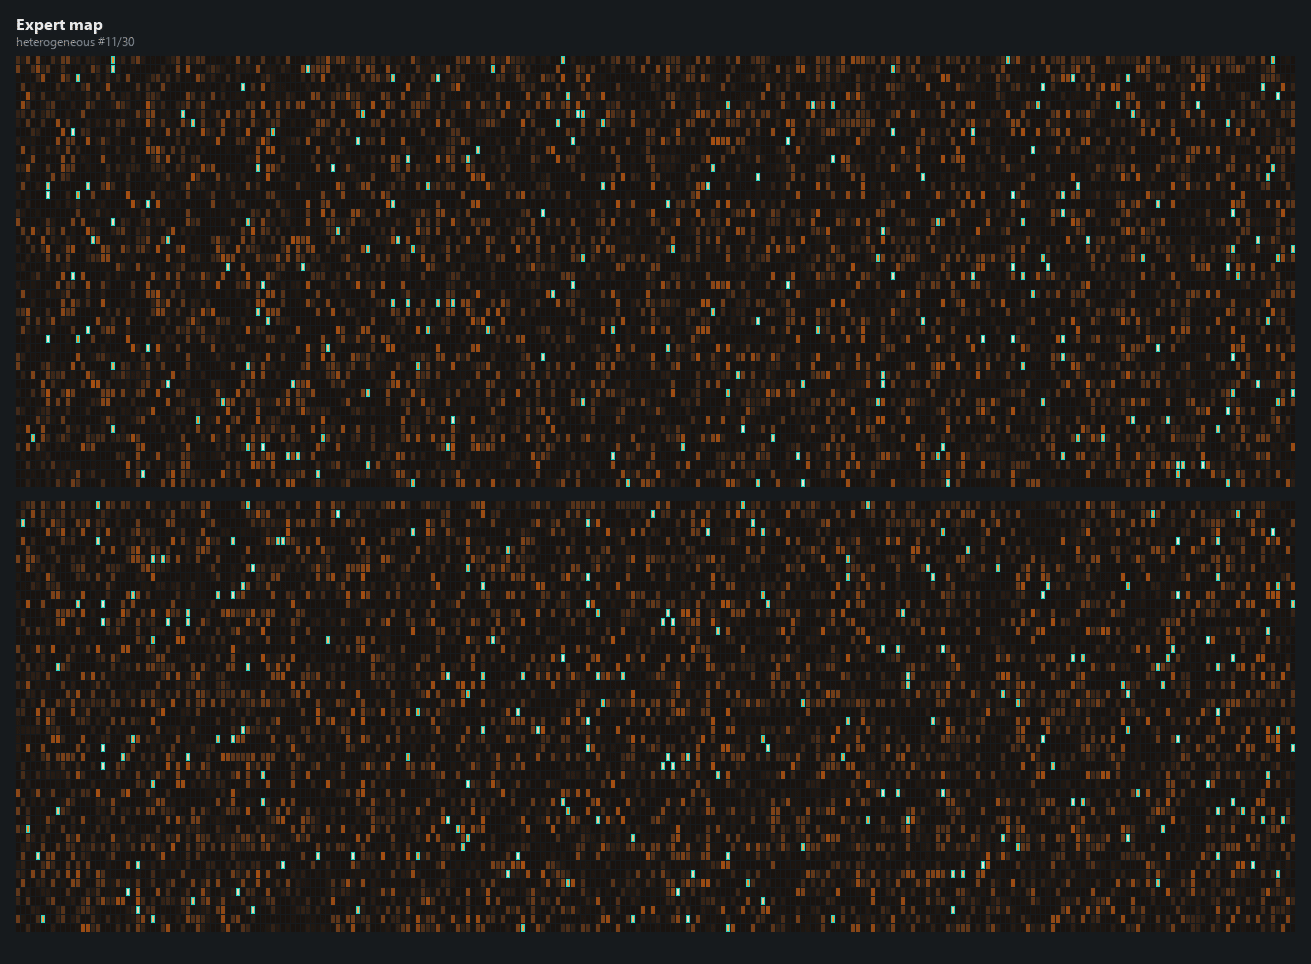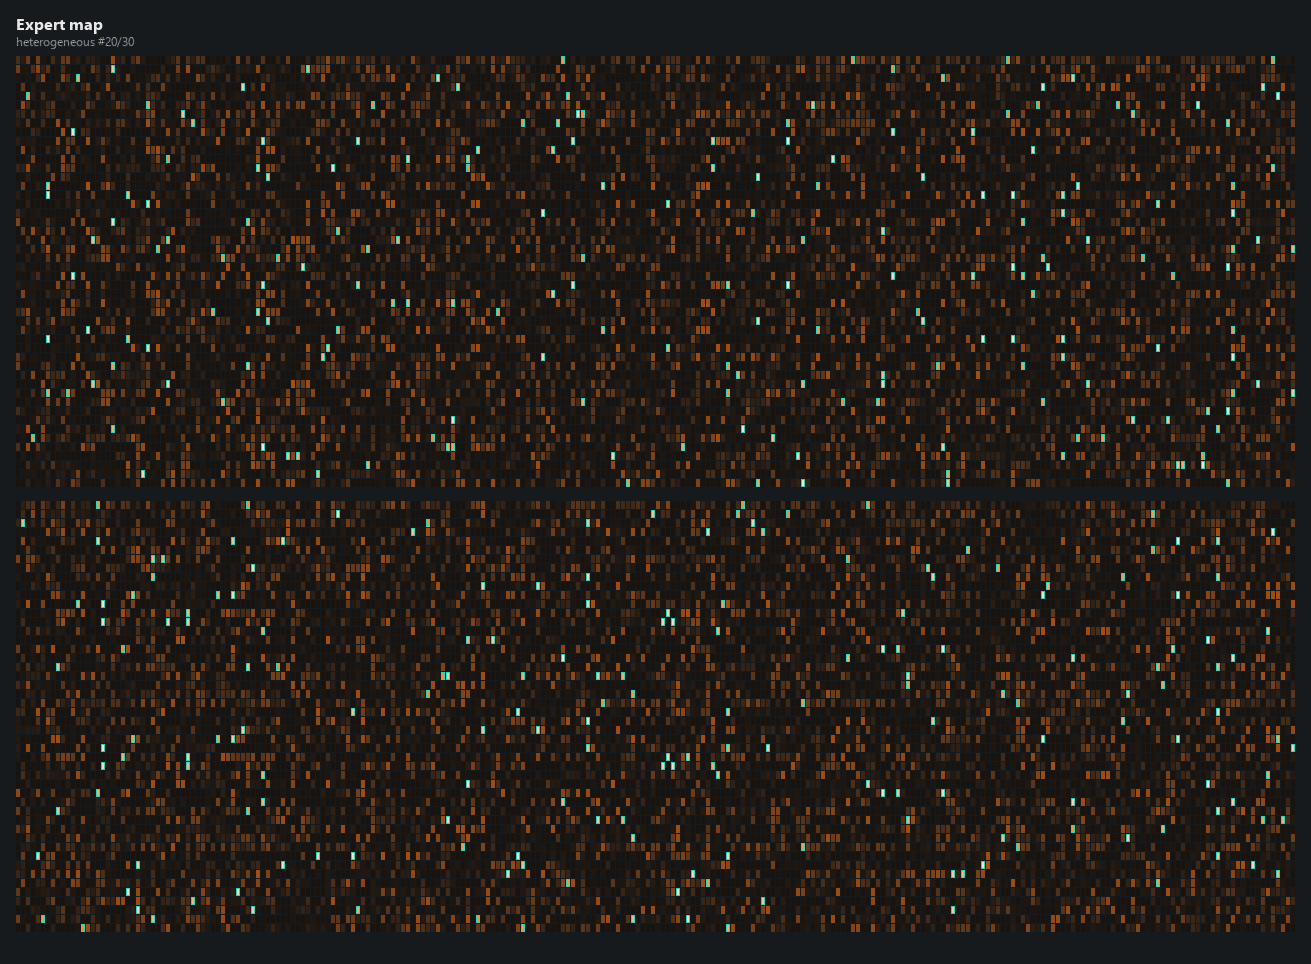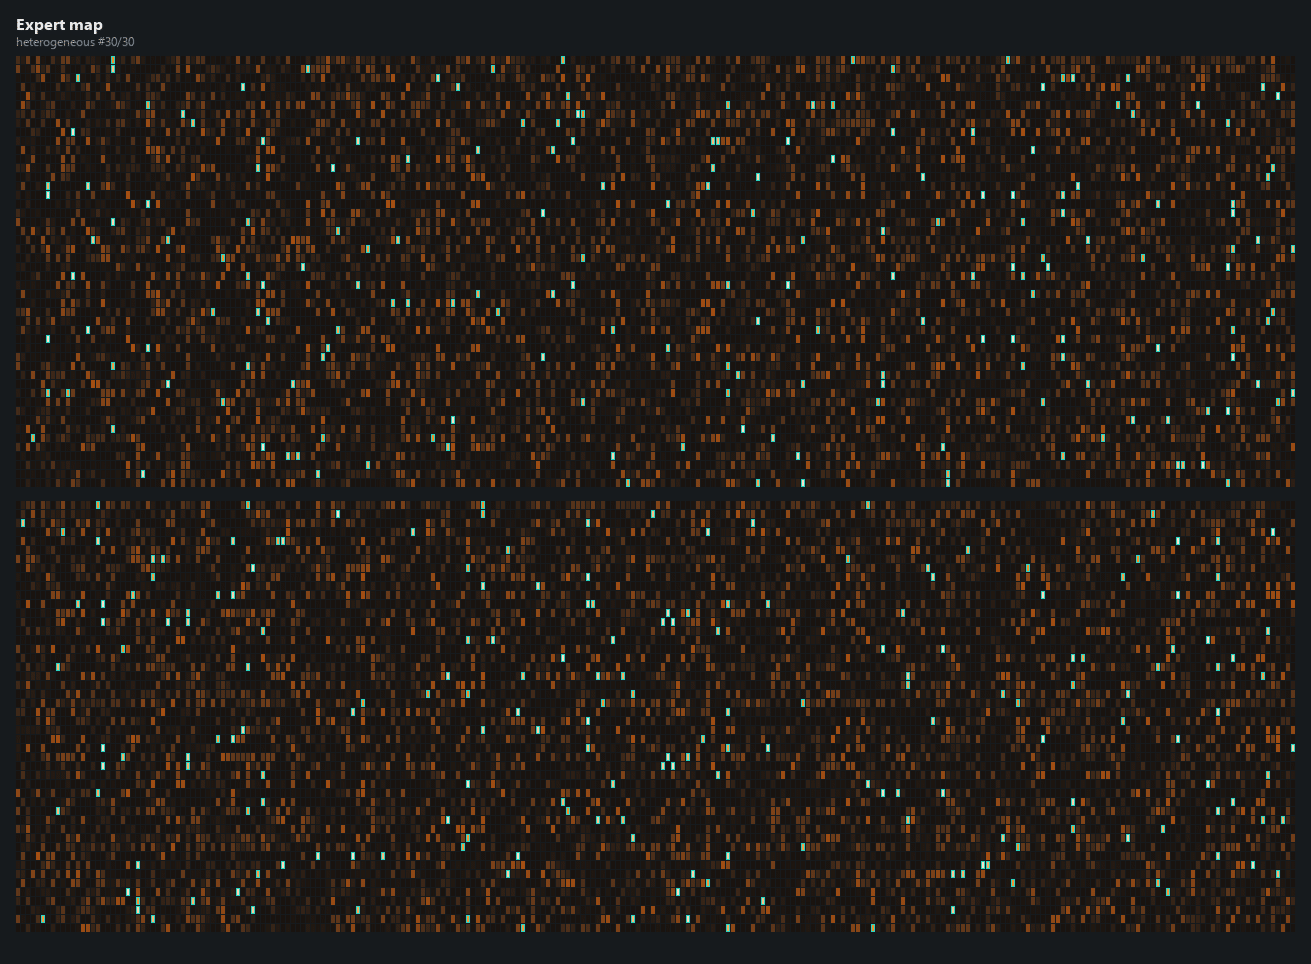
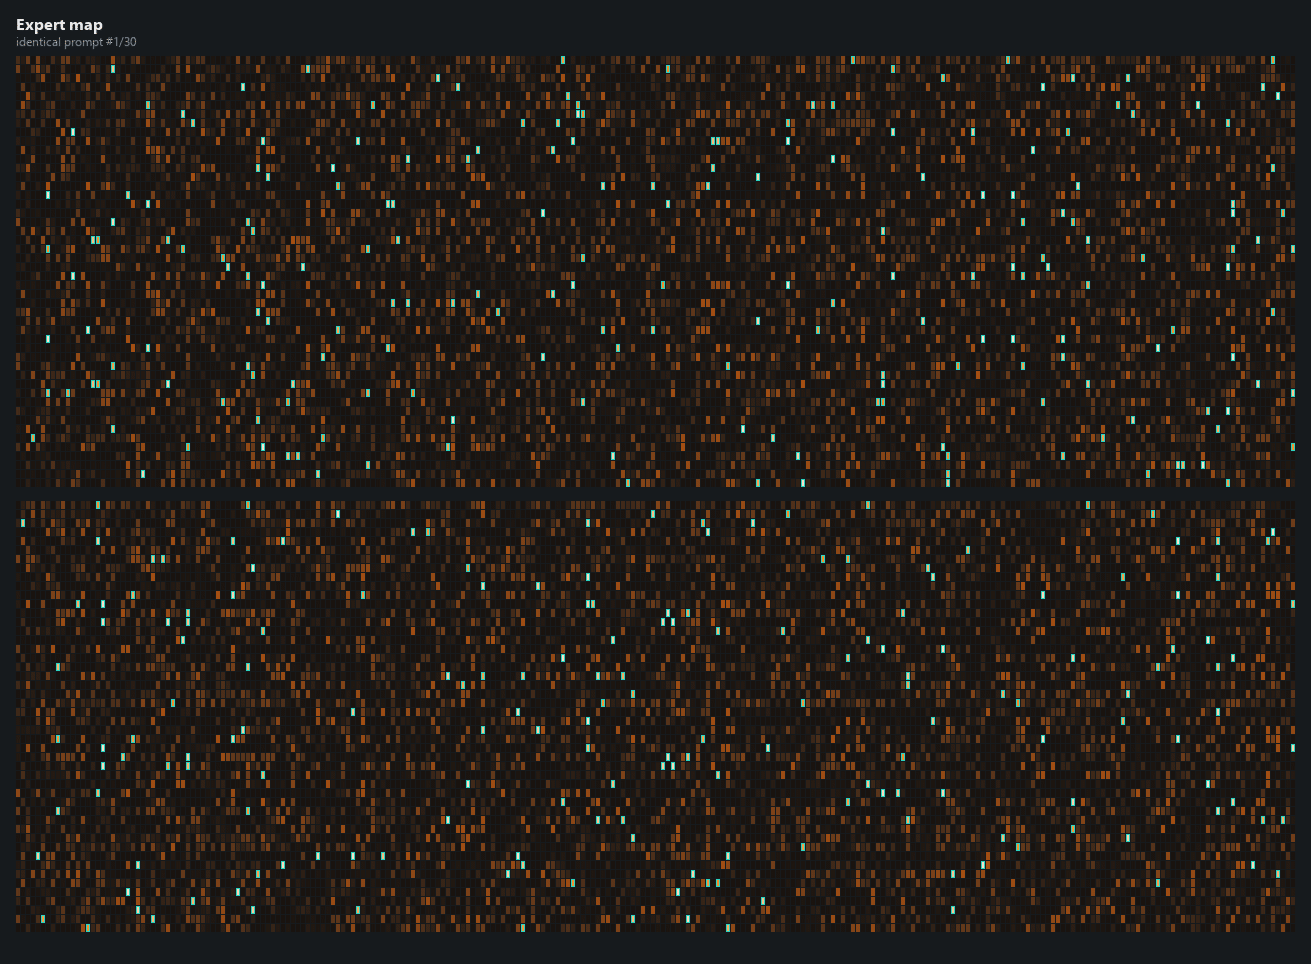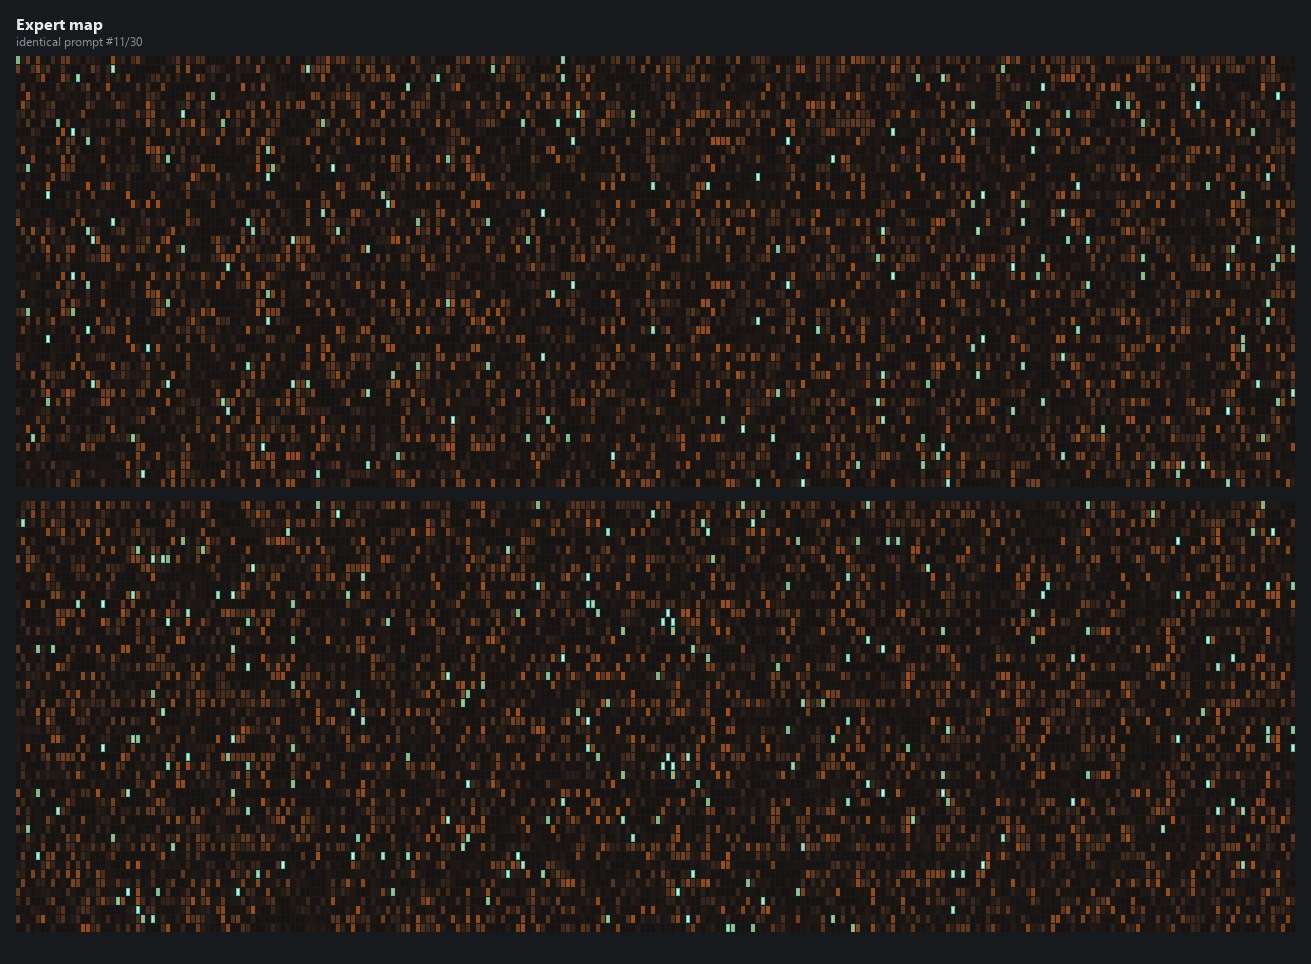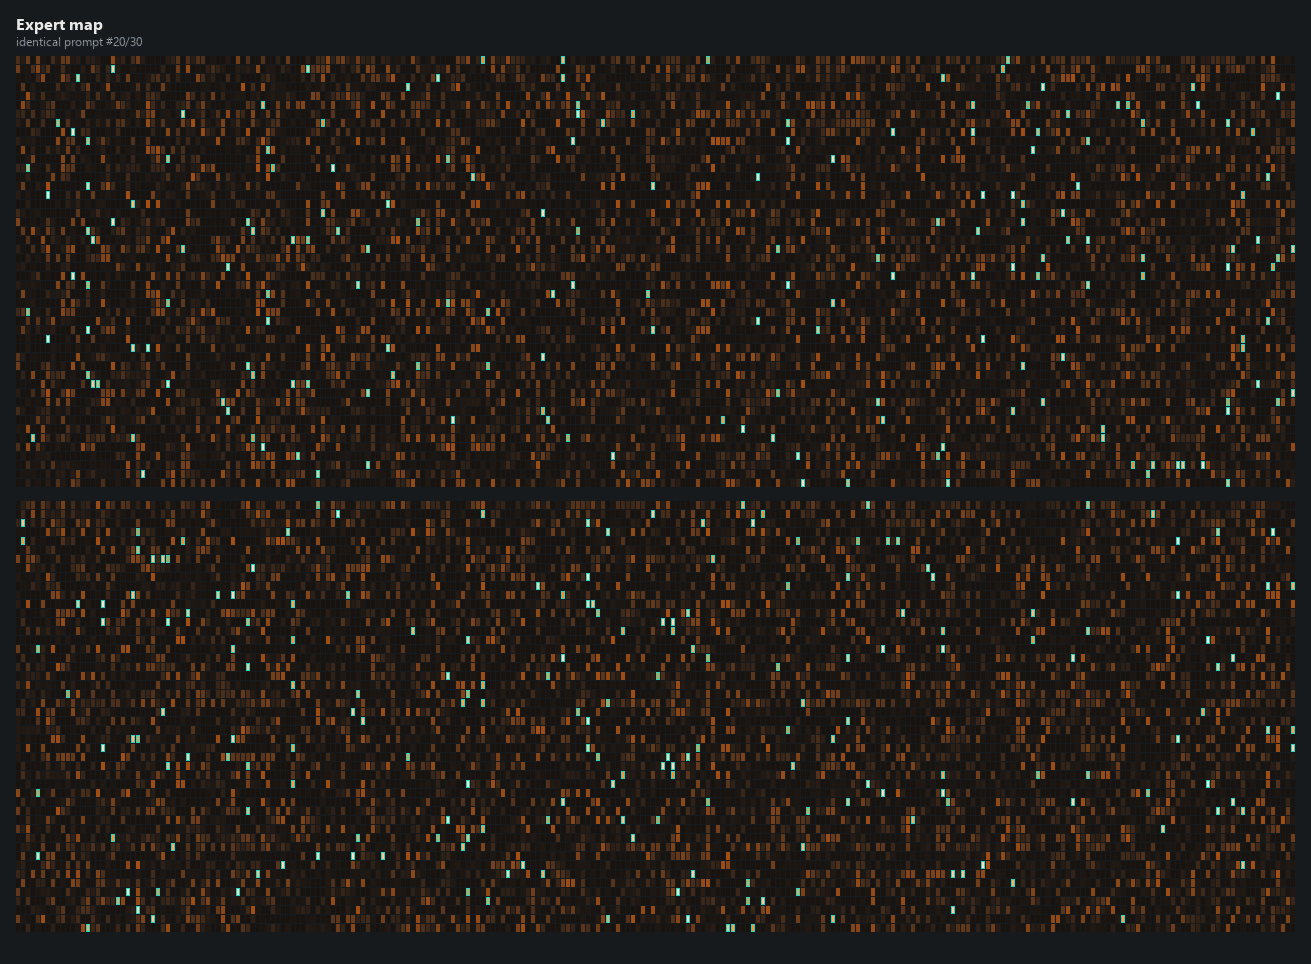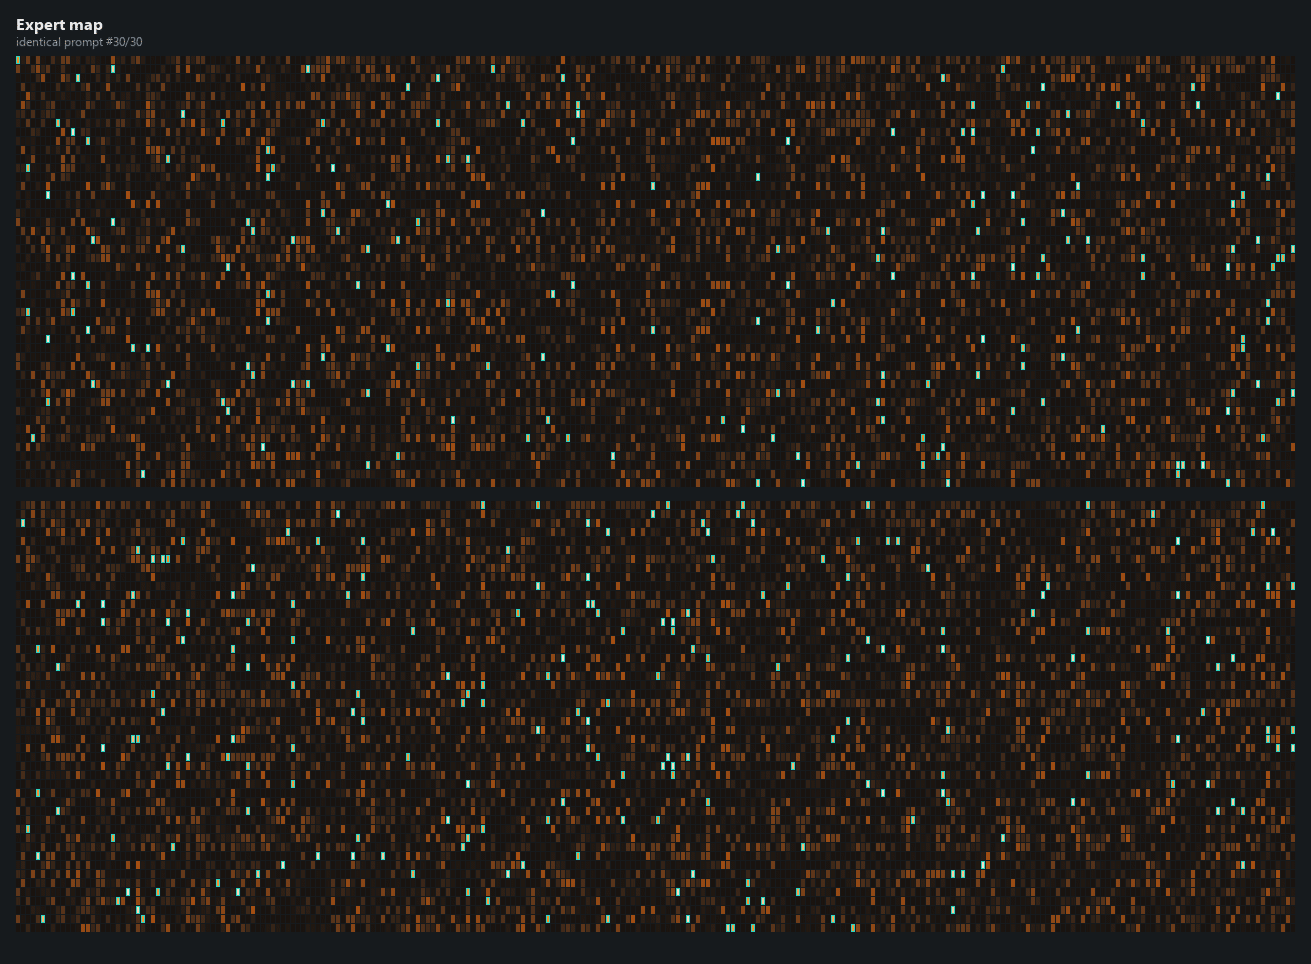
На втором ролике — том, где промпт не меняется вообще — ожидал почти неподвижную картинку. На деле видно ровно то же, что и на разнородных задачах, только слегка приглушённее: есть стабильное, постоянно горячее ядро клеток, а вокруг него остальные перемешиваются кадр от кадра почти как в тасовке карт.
Разобрался, почему, и тут — снова та самая методологическая ловушка, что и в начале статьи, просто в новом месте:
-
Ядро — это “рабочие лошадки” из более раннего анализа: ~38% узлов срабатывают почти на каждом запросе независимо от содержания. Именно они и образуют стабильную горячую сердцевину на карте.
-
Периферия “тасуется” по двум причинам. Во-первых, генерация не детерминирована: промпт одинаковый, но модель каждый раз семплирует новый ответ, а роутинг считается по каждому сгенерированному токену — разный хвост ответа даёт реально разный набор задействованных периферийных экспертов, это не рендер-артефакт. Во-вторых — и это главное — вкладка красит клетки по рангу, а не по сырой теплоте, то есть по той самой производной, шумной метрике, которую я уже один раз поймал на вранье в начале статьи (рухнувшей с 19.03 до 0.49 при перемешивании). У редко используемых клеток абсолютная теплота почти не меняется, но из-за decay их относительный ранг среди всех 24576 соседей гуляет туда-сюда даже без реальной активности.
Так что да — можете сами в этом убедиться за полминуты, просто последив за вкладкой: стабильное ядро видно сразу, а шумную пляску вокруг него теперь можно объяснить, а не просто “ну, наверное, так и должно быть”.
Добавляю во вкладку второй режим — и проверяю ядро по-настоящему
Раз живая вкладка красит клетки по рангу, а не по честному сигналу, решил добавить ей второй режим прямо в интерфейсе: “Residency stability” — вместо мгновенного ранга копит с момента открытия вкладки (или с кнопки “Reset window”), как часто каждая клетка была физически резидентна в VRAM, и красит по этой частоте. Стабильное ядро сразу видно как ровные яркие пятна, а шумная периферия — как тусклое мерцание, без необходимости лезть в DevTools или держать в голове историю.
С этим режимом стало можно честно проверить то, что напрашивалось само: если прогонять один домен подолгу, а не дёргаться между темами каждый запрос, должно ли ядро резидентности отличаться между доменами? Сбросил окно, прогнал 18 промптов подряд только про Python-код, снял “всегда резидентное” ядро; сбросил снова, прогнал 18 промптов подряд только про поэзию, снял ядро второй раз:
|
|
ядро (всегда резидентно из 384) |
|---|---|
|
Только код |
207 (53.9%) |
|
Только поэзия |
193 (50.3%) |
|
Пересечение |
169 (87.6% от меньшего ядра) |
|
Только у кода |
38 экспертов |
|
Только у поэзии |
24 эксперта |
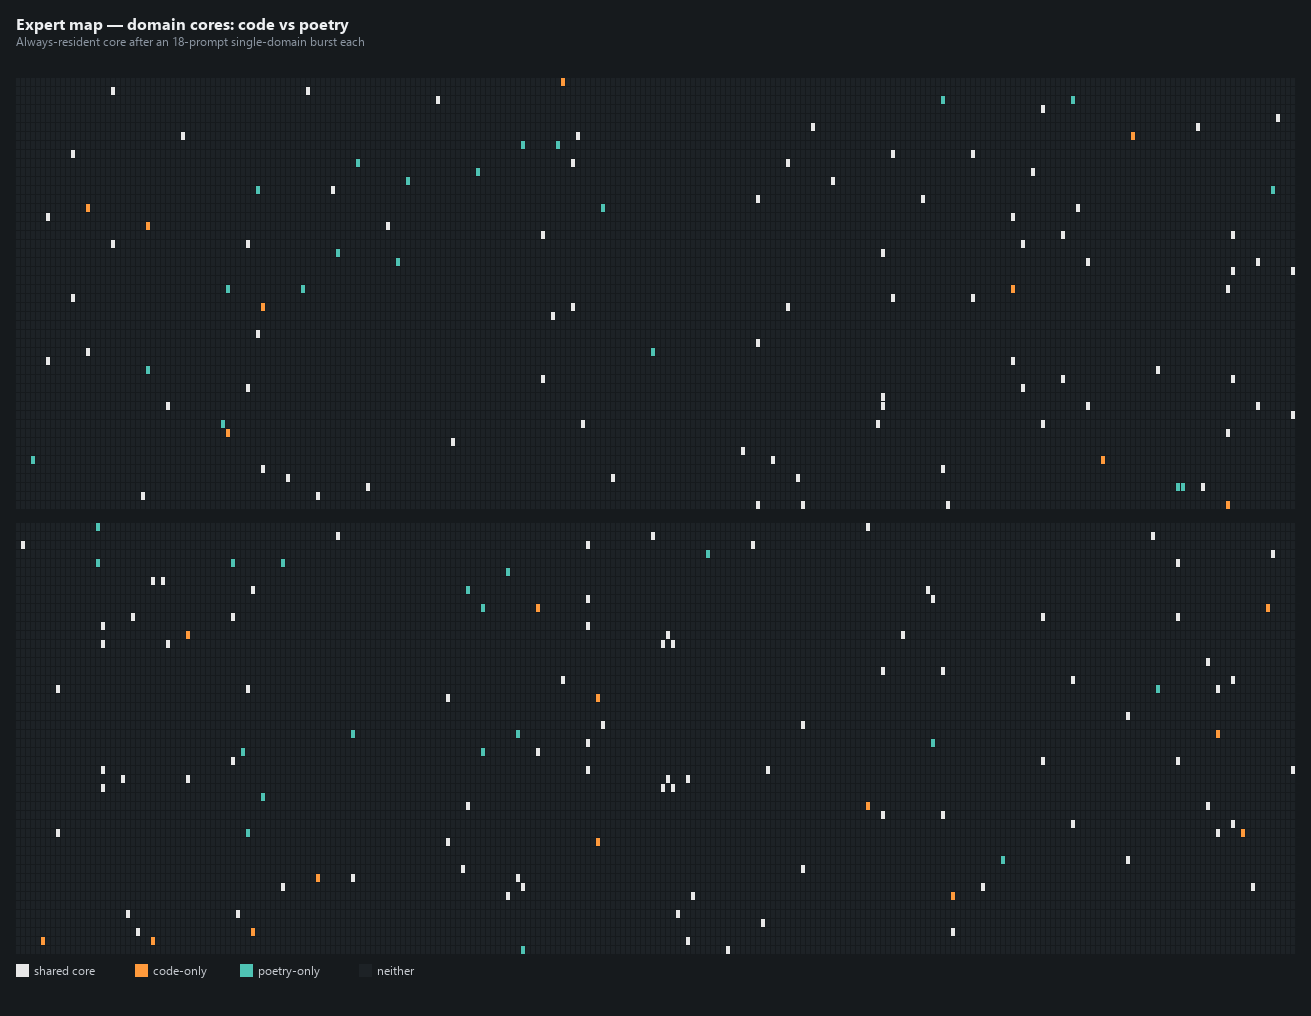
Два вывода. Первый — ожидаемый: ядра реально разные, 38 экспертов стабильно резидентны при коде и не резидентны при поэзии (и наоборот 24) — доменная специализация видна прямо в физической резидентности VRAM, а не только в офлайн-UMAP на кумулятивном отпечатке. Второй — неожиданный: ядро выросло почти вдвое по сравнению с прошлым замером (53.9%/50.3% против 27.6%/28.4% на вперемешку/одинаковых-но-с-паузами промптах) — резидентному кэшу нужен “разогрев” на одном домене, чтобы сойтись; быстрое чередование тем мешает ему устояться, и поэтому раньше ядро казалось меньше, чем оно есть на самом деле.
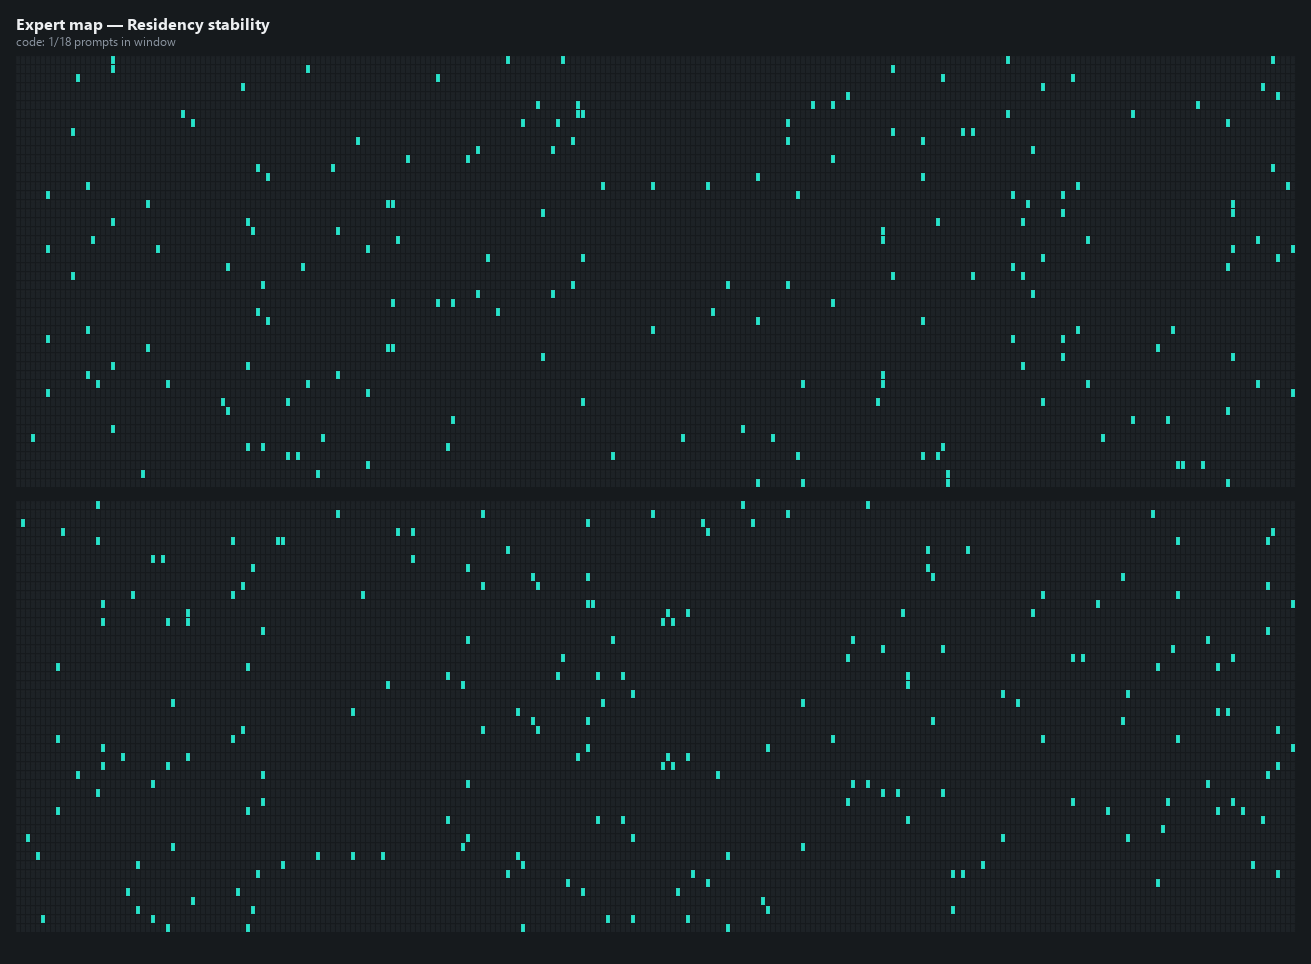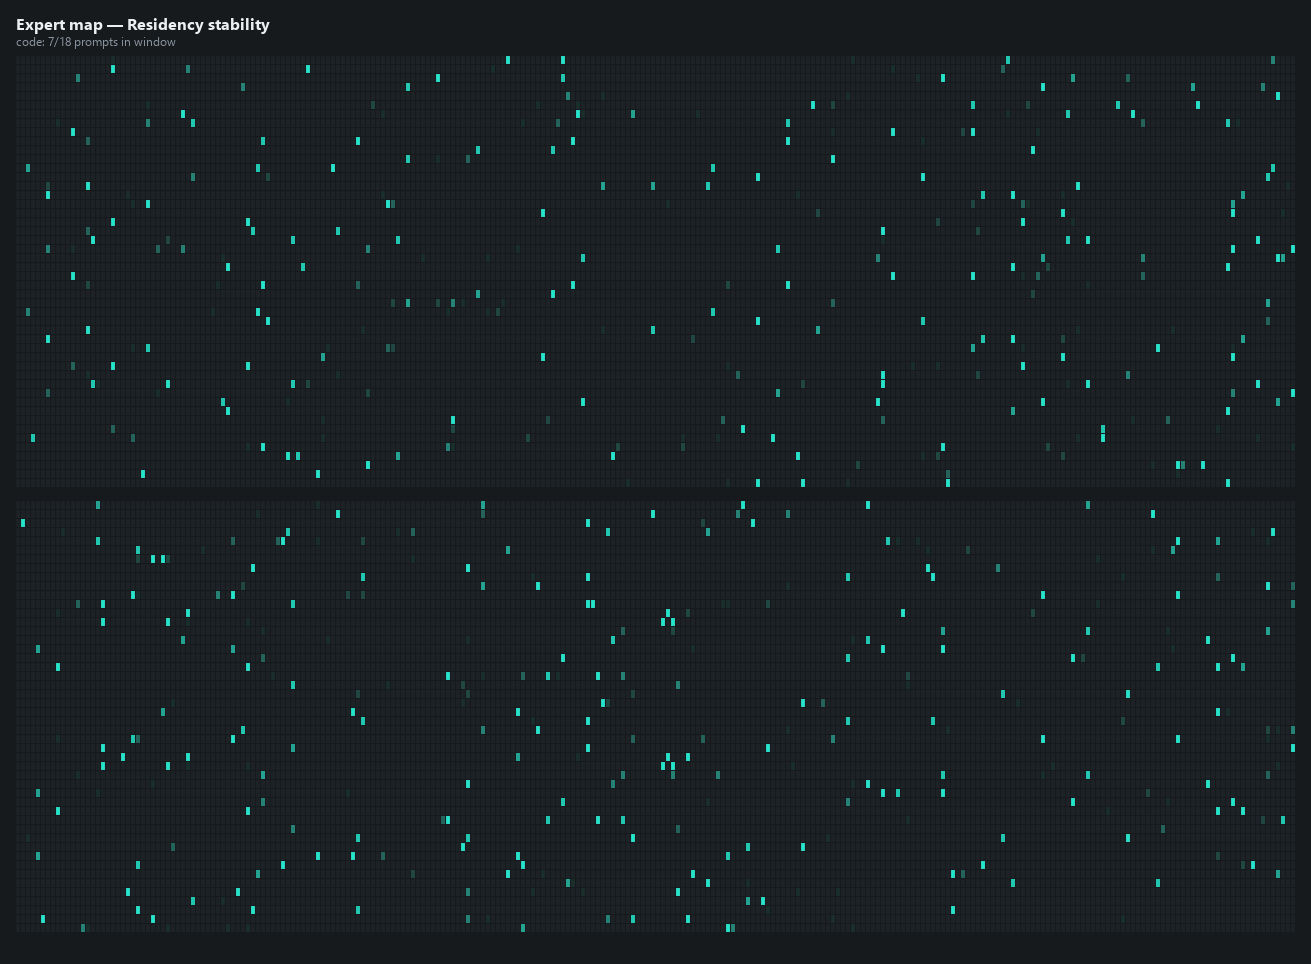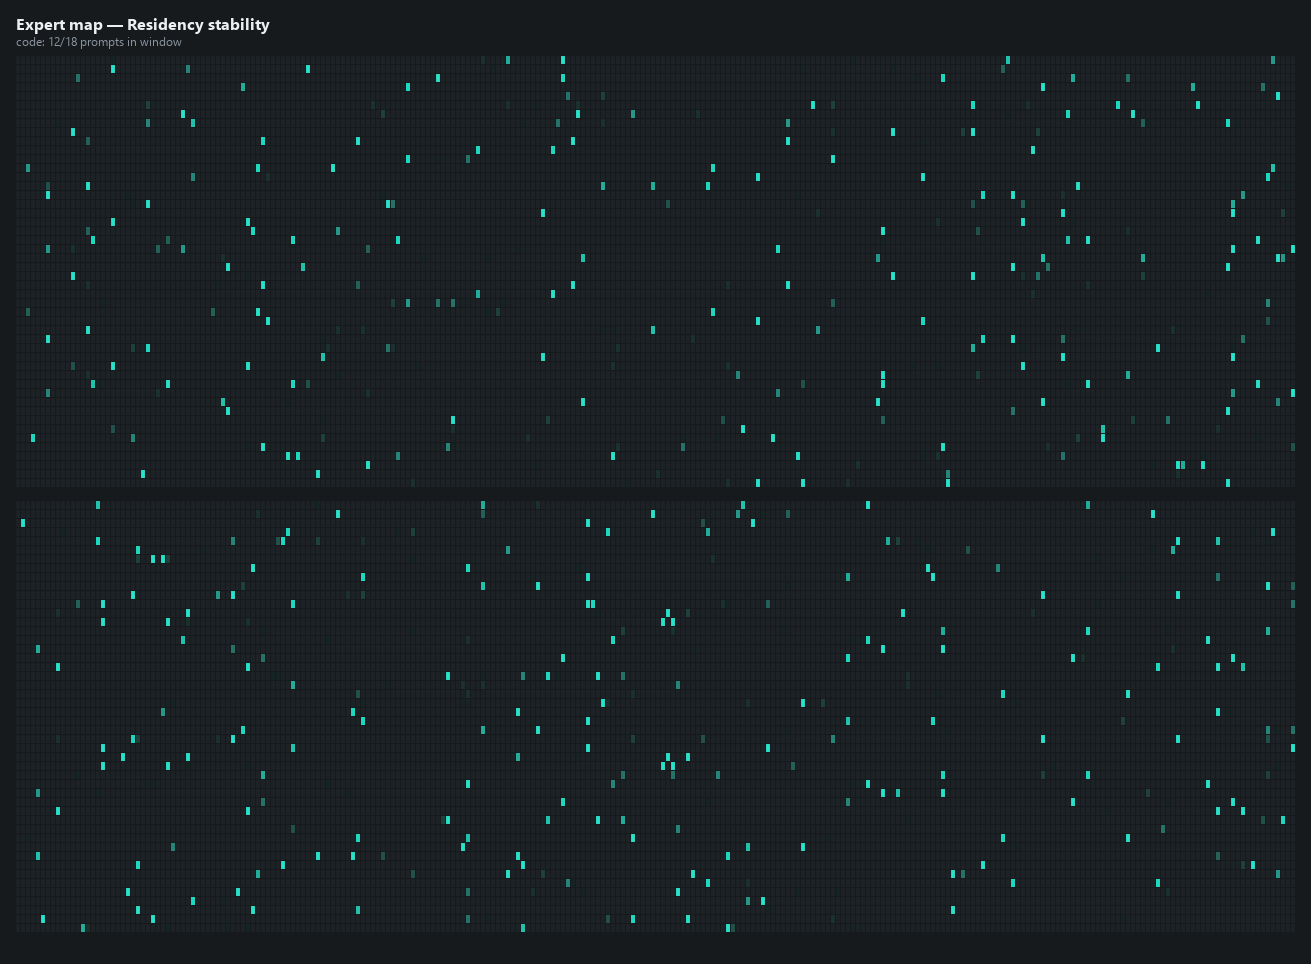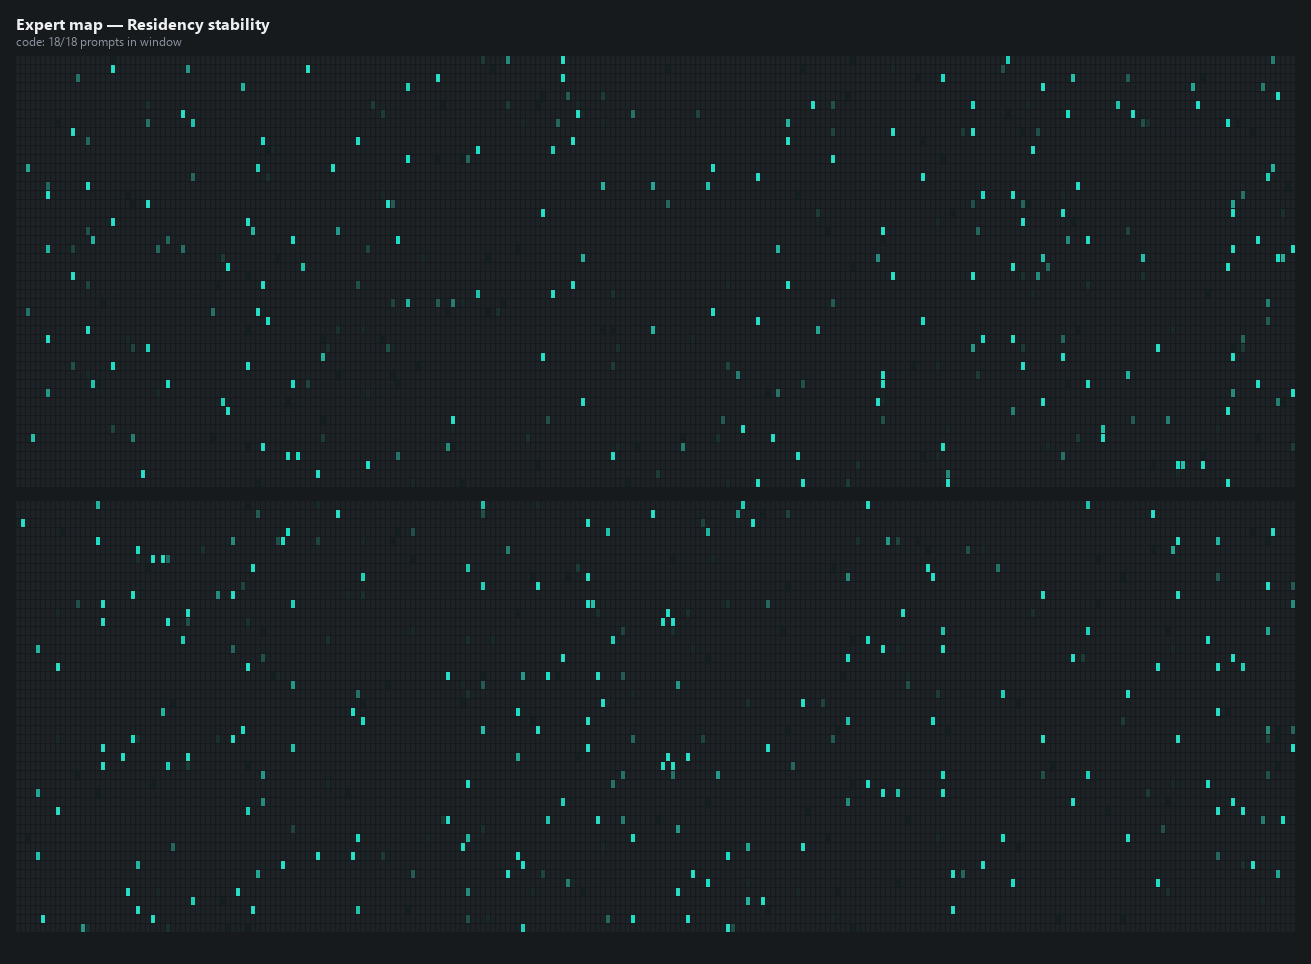
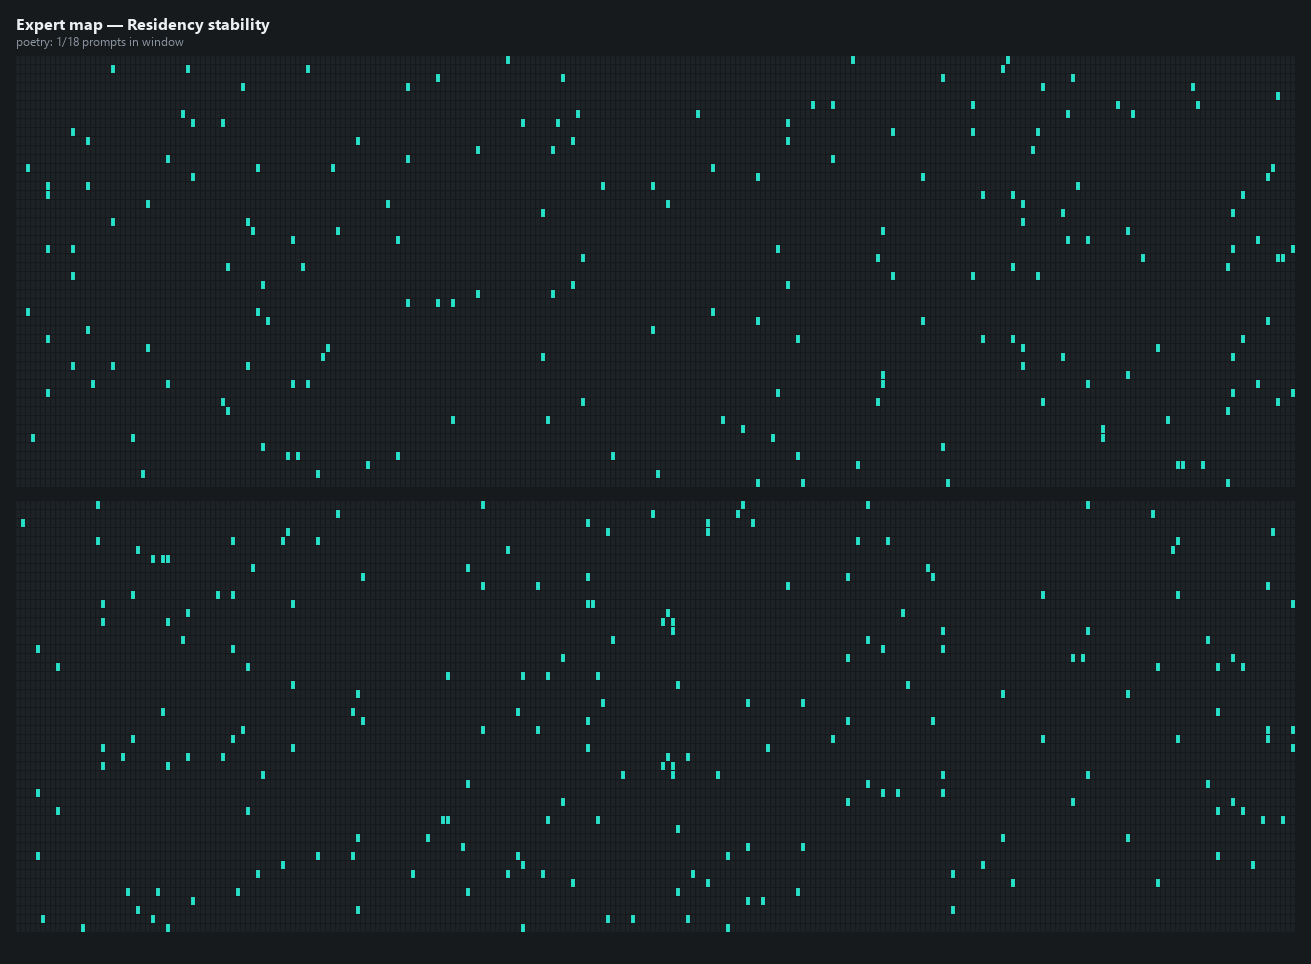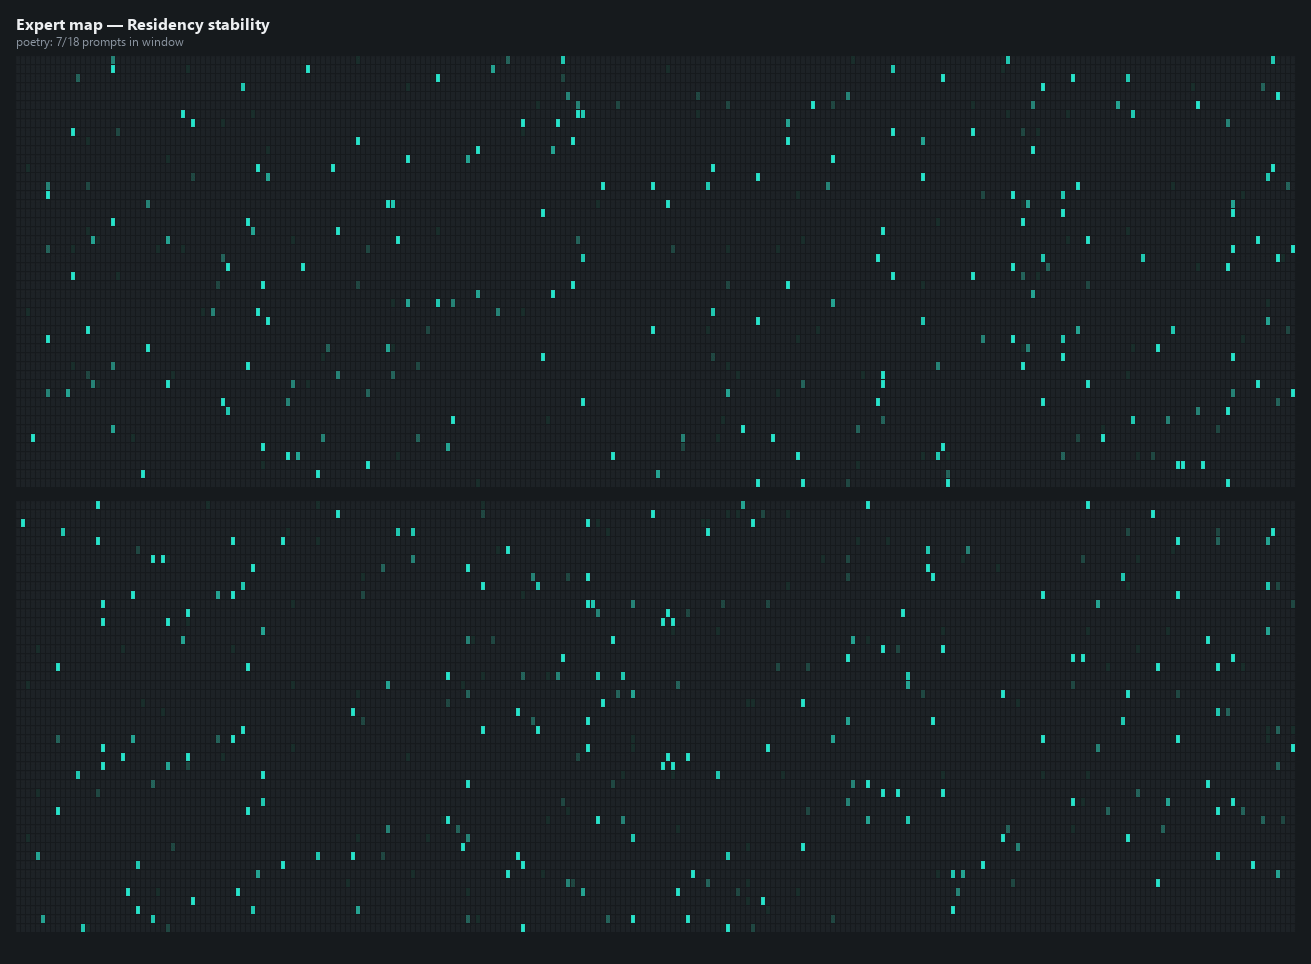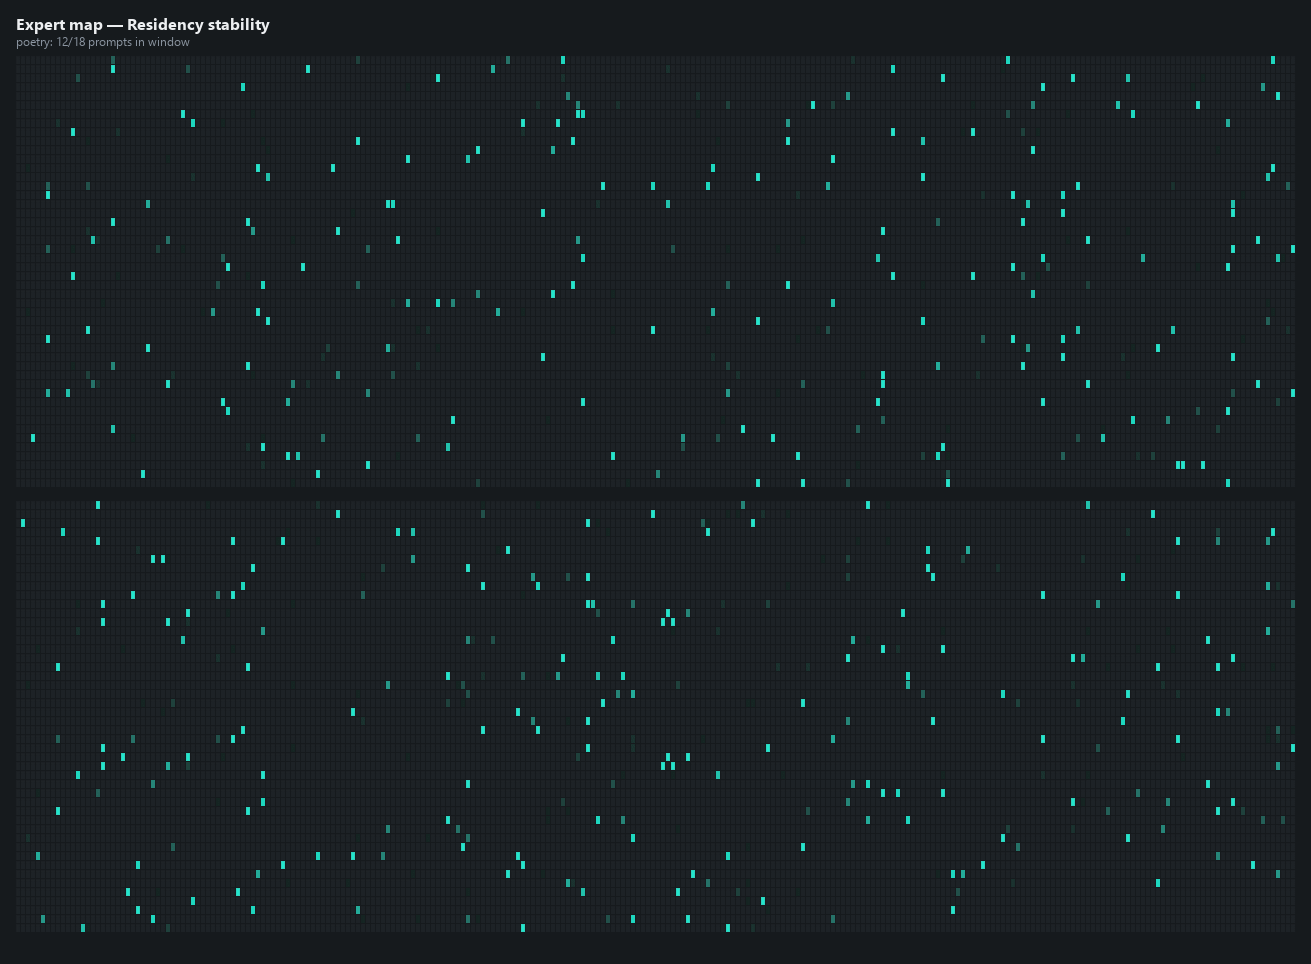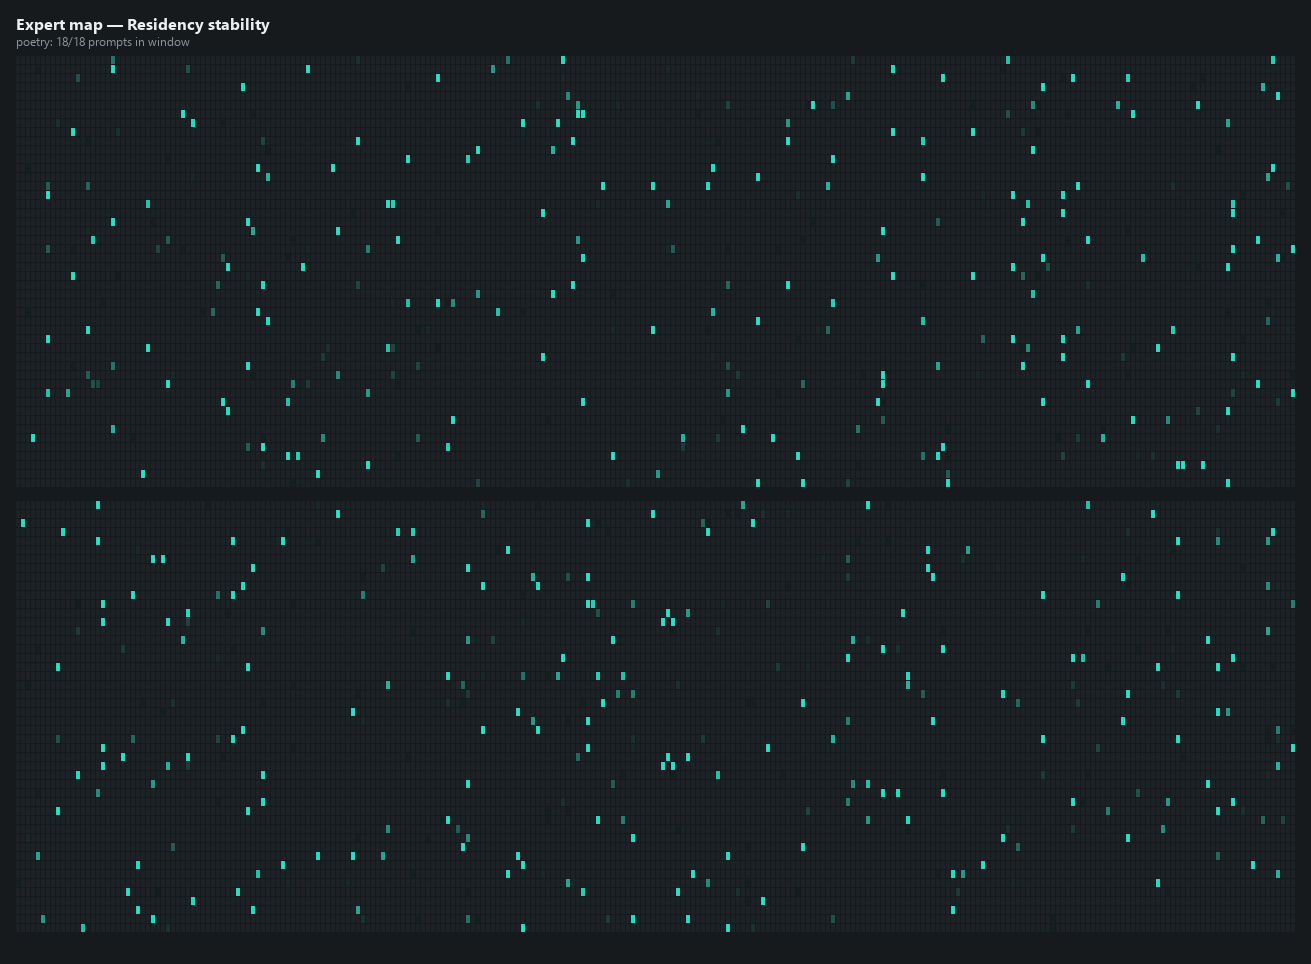
А если наложить итоговые “всегда резидентные” ядра обоих прогонов друг на друга — разница видна глазами, не только в таблице:
Патч уже оформлен — issue в апстриме (жду решения мейнтейнеров по скоупу, как велит их CONTRIBUTING.md) и форк с готовым релизом, который можно накатить на свою копию прямо сейчас, не дожидаясь апстрима.
А эксперты реально специализируются по темам?
Карта — это красиво, но захотелось ответить на содержательный вопрос: действительно ли разные эксперты в этой модели специализируются на разных темах/языках (как это иногда показывают в интерпретируемости MoE-моделей), или это просто равномерный шум роутинга?
Первый, наивный заход
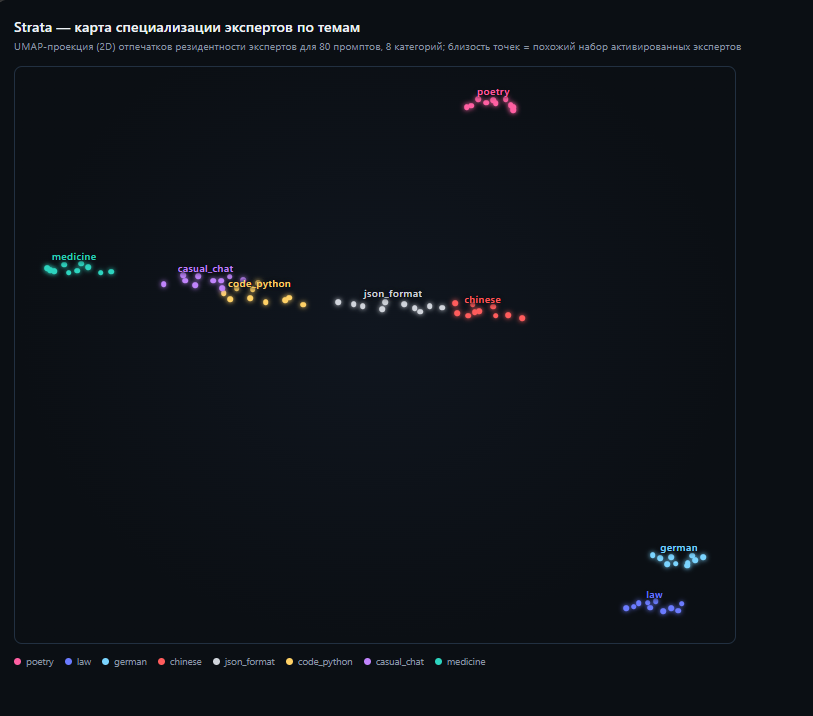
План: взять 80 промптов на 8 разных тем (поэзия, право, немецкий, китайский, JSON, Python-код, кэжуал-чат, медицина), прогнать через модель, после каждого снять снэпшот профиля экспертов как “отпечаток” запроса, свернуть 24576-мерные отпечатки в 2D через UMAP и посмотреть, кластеризуются ли темы.
Получилось красиво. Каждая категория легла в свой чёткий, плотный кластер — коэффициент межкластерного расстояния к внутрикластерному разбросу вышел 19.03, что выглядело как явное подтверждение гипотезы.
Проверка на вшивость
Но был нюанс: промпты отправлялись блоками (все 10 “poetry” подряд, потом все “law” и так далее). А “теплота” эксперта в этом формате — это кумулятивный счётчик с начала сессии, который естественным образом дрейфует во времени. Красивые кластеры могли быть не про тему, а про то, когда промпт отправили.
Проверил честно: перемешал все 80 промптов в случайном порядке и прогнал заново. Разделение рухнуло до 0.49 — то есть кластеров не осталось вообще, точки внутри одной темы оказались дальше друг от друга, чем центры разных тем. Красивая картинка из первого прогона была почти целиком артефактом порядка отправки, а не темы.
Честный сигнал
Проблема была в самих данных: файл профиля хранит только производный ранг (целое число — место в очереди), а не сырую величину счётчика. Ранг — это огрубление: два эксперта могут сильно отличаться по реальной “теплоте”, но быть соседними по рангу, и наоборот.
Внутри движка, впрочем, уже существовал нужный сигнал — вектор heat (std::vector<double>, кумулятивные decayed-счётчики по каждому (слой, эксперт)), который просто не экспортировался наружу. Я добавил в движок маленькую функцию-сиблинг существующего экспортёра — write_expert_heat_raw() — которая пишет этот сырой вектор в отдельный файл рядом с обычным профилем. Правка минимальная: ни один существующий CUDA-кернел роутинга не тронут, просто ещё один файловый дамп уже посчитанных чисел.
С новым сигналом (разница сырых счётчиков до/после каждого запроса вместо абсолютного ранга) повторил оба прогона:
|
|
ratio |
|---|---|
|
Блоками (по теме) |
33.11 |
|
Перемешано (seed=42) |
17.2 |
Разделение просело, но осталось — кластеры по-прежнему чётко разделены даже в случайном порядке отправки. Небольшая просадка честная: decay никогда не бывает мгновенным, какой-то остаточный эффект порядка неизбежен. Но принципиальная разница с первым прогоном (0.49, то есть “ничего нет”) налицо.
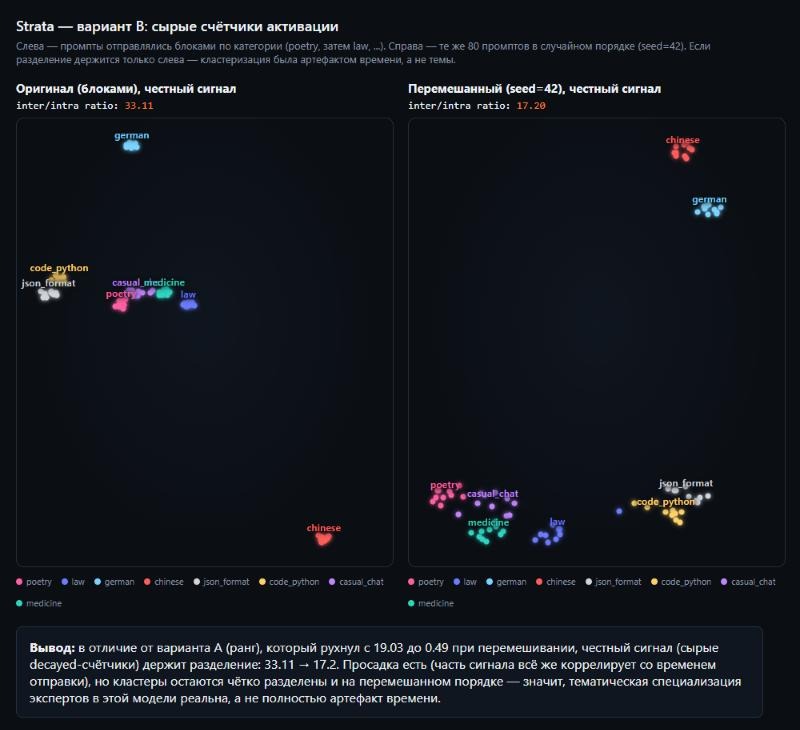
Вывод: судя по этому эксперименту, Qwen3.8-Flash-Next действительно демонстрирует наблюдаемую тематическую/языковую специализацию экспертов — и это пережило честную проверку, а не было фокусом с порядком данных.
Что ещё нашлось при более глубоком разборе
Дальше — без привязки к моим субъективным категориям тем, чисто по статистике активации за те же 160 промптов (оба честных прогона вместе):
-
3.5% из 24576 (слой, эксперт)-узлов ни разу не сработали за всю сессию.
-
38.1% — “рабочие лошадки”, срабатывают почти в каждом промпте, ровно, без всплесков.
-
4.0% — редкие, но при срабатывании резко более активные (cv ~12.5), похоже на настоящих “специалистов”.
По слоям доля таких специалистов неравномерна: у слоя 8 она почти вдвое выше среднего (7.6% против среднего 4.0% по всем 48 слоям) — выраженный, статистически заметный выброс.
И отдельная находка — матрица косинусного сходства между всеми парами слоёв показала резкий, изолированный пик на дистанции Δ=16: в среднем слой N использует набор экспертов, очень похожий на слой N+16 (0.887 против ровного фона ~0.80 на соседних дистанциях). Интересно, что это не чистая тройная периодичность на 48=3×16 слоёв, как можно было бы ожидать: Δ=32 почти не выделяется на фоне шума (0.814, едва выше базового уровня). То есть связь “слой N похож на N+16” сильная и системная, а “слой N похож на N+32” — нет.

Честные оговорки
Выборка — 160 промптов на одной модели (Qwen3.8-Flash-Next, квант UD-IQ4_XS) и одном GPU. Это не академическое исследование с контрольными группами, а любительское ковыряние с реальным железом в свободное время. Данные открыты, методика описана — кто захочет проверить на другой модели или с бóльшей выборкой, велком.
Что можно пощупать прямо сейчас
-
Issue в апстриме Strata — предложение фичи, обсуждение скоупа.
-
Форк с готовым патчем — накатить на свою копию и посмотреть на карту своей собственной модели.
ссылка на оригинал статьи https://habr.com/ru/articles/1106322/