Пользователь спрашивает нейросеть: «Как сделать крем для капкейков гуще, потому что он постоянно сползает?». Ассистент предлагает добавить сахарную пудру, изменить пропорции ингредиентов или увеличить время взбивания. Советы выглядят разумно, но могут оказаться бесполезными, если настоящая причина заключается в том, что капкейки еще горячие. В таком случае правильным решением будет сначала охладить выпечку. Однако пользователь уже решил, что проблема связана с консистенцией крема, и сформулировал вопрос вокруг ошибочного предположения. Языковая модель может безупречно выполнить его инструкцию, так и не устранив причину.
13 ноября 2026 года исследователи Allen Institute for AI (Ai2) представили XYBench, бенчмарк для проверки способности языковых моделей распознавать подобные ситуации. В него вошло 8 115 вопросов из программирования, технической поддержки и повседневных задач. Авторы протестировали Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro.
Результаты выявили интересное противоречие. На вопросах Stack Overflow модели выбирали более полезный ответ среди двух предложенных в 71–84% случаев, но при самостоятельной генерации сосредотачивались на действительной цели пользователя лишь в 35–41% ответов. Даже обнаружив правильное решение, они часто продолжали подробно объяснять первоначально выбранный, неподходящий способ.
Почему правильный ответ может оказаться бесполезным
Ситуация с капкейками представляет собой классическую XY-проблему, хорошо известную участникам технических форумов. Ее суть заключается в расхождении между настоящей целью пользователя и способом, который он самостоятельно выбрал для ее достижения. В условном обозначении X представляет собой действительную задачу, а Y обозначает предполагаемый способ решения. Пользователь хочет добиться X, считает, что для этого необходимо Y, и обращается за помощью именно с Y.
Один из примеров, использованных исследователями, связан с обработкой XML.
Человек хочет извлечь данные из XML-документа, но спрашивает, как сделать это с помощью регулярных выражений. Ассистент может составить сложное регулярное выражение, подробно объяснить его синтаксис и перечислить ограничения. Формально запрос будет выполнен.
Однако для надежной работы со структурированным XML обычно лучше использовать специализированный парсер, который учитывает вложенность элементов, атрибуты и особенности формата. Если пользователь не ограничен обязательным применением регулярных выражений, более полезный ответ должен объяснить недостатки выбранного метода и предложить подходящий инструмент. Проблема встречается далеко за пределами программирования. Человек может искать более мощный пылесос, хотя слабая тяга вызвана засорившимся шлангом, или пытаться исправить ошибки приложения переустановкой операционной системы, не выяснив их причину.
Во всех этих случаях буквальный запрос содержит предположение о том, какой путь приведет к результату. Хорошему ассистенту недостаточно предложить инструкцию. Ему необходимо учитывать контекст, проверять предположения и при необходимости помогать пользователю изменить подход.
В лингвистике подобное поведение связано с прагматикой, изучающей влияние контекста и намерений собеседника на смысл высказывания. Для LLM эта задача особенно сложна, поскольку пользователь редко сообщает свою настоящую цель отдельно от выбранного способа ее достижения.
8 115 вопросов, четыре источника и тысячи ошибочных предположений
XYBench разработали исследователи Carnegie Mellon University, Allen Institute for AI, NVIDIA и Johns Hopkins University. Команда под руководством Akhila Yerukola собрала вопросы, в которых выполнение буквальной инструкции не обязательно решает действительную проблему пользователя.
Главная сложность заключалась в поиске подходящих примеров. Не каждый странно сформулированный запрос является XY-проблемой, а иногда выбранный человеком способ действительно оправдан его обстоятельствами. Поэтому авторы старались исключать вопросы, где выполнение первоначальной инструкции было достаточным.
В научной статье приведена следующая структура датасета:
|
Источник |
Количество вопросов |
Тематика |
|---|---|---|
|
Stack Overflow |
1 557 |
Программирование |
|
Stack Exchange |
184 |
Электроника, Linux, компьютеры и другие технические темы |
|
Manually Curated |
102 |
Бытовые ситуации, ремонт, приготовление еды, рукоделие |
|
WikiHow |
6 272 |
Повседневные инструкции и практические задачи |
|
Всего |
8 115 |
Для Stack Overflow исследователи искали обсуждения, где в комментариях или ответах упоминалась XY-проблема. После первоначального отбора и фильтрации осталось 1 557 вопросов. Аналогичным образом формировалась выборка Stack Exchange, охватывающая 17 тематических сообществ. Чтобы определить реальную цель пользователя, авторы анализировали человеческие ответы. Учитывались три наиболее высоко оцененных ответа, а также принятый автором вопроса ответ, если он существовал.
Эти материалы помогали установить, что пользователь буквально просит сделать, какую проблему пытается решить и какие альтернативные действия могут оказаться полезнее. Дополнительно формулировки некоторых вопросов минимально изменялись, чтобы снизить вероятность того, что модели просто воспроизведут знакомые обсуждения из обучающих данных.
Почему большая часть датасета синтетическая
Наиболее крупная часть XYBench построена на основе WikiHow. Исследователи использовали около 2 500 инструкций, охватывающих приготовление еды, уход за животными, домашний ремонт и другие повседневные занятия.
Claude Sonnet 4.5 анализировала последовательность действий в инструкциях, находила шаги, на которых неопытный человек мог допустить ошибку, и генерировала соответствующие вопросы. В примере с капкейками таким шагом стало отсутствие охлаждения выпечки перед нанесением крема. Далее примеры проходили несколько этапов обработки. Авторы проверяли, можно ли по контексту восстановить действительную цель, удаляли слишком очевидные подсказки и добавляли правдоподобные обстоятельства. Вопрос должен был содержать достаточно информации для грамотного специалиста, но не раскрывать правильный ответ напрямую.
Такой подход позволил расширить бенчмарк за пределы технических форумов. Однако около 77% вопросов оказались синтетическими, поэтому результаты нельзя автоматически считать репрезентативными для всех реальных пользовательских обращений. Авторы отдельно проверили качество сгенерированной части. Два человека оценили 400 примеров по нескольким характеристикам, включая правдоподобность вопроса, корректность установленной цели и подходящего решения.
Точность отдельных полей составила от 74,9% до 97%, но полностью корректными одновременно по всем проверяемым характеристикам были признаны 68,5% примеров. Это существенное ограничение, поскольку некоторые ошибки в исходной разметке могут влиять на последующую оценку моделей.
Как измерить способность модели действительно помочь?
Обычный бенчмарк может проверить, содержится ли в ответе правильное решение. Для XYBench такого критерия недостаточно, поскольку модель способна упомянуть полезный совет в одном предложении, посвятив остальную часть ответа неподходящему методу.
Поэтому исследователи разделили оценивание на три направления:
-
Pragmatic Solution проверяет, какие решения присутствуют в ответе. Для каждого вопроса заранее определены S-request, то есть буквальный запрос, и I-request, то есть действительная цель пользователя. Оценщик отдельно определяет наличие решения первоначального запроса (S-solution) и альтернативы, направленной на настоящую проблему (I-solution).
-
Pragmatic Emphasis оценивает, как расставлены акценты. Ответ может преимущественно объяснять буквальную инструкцию, сосредоточиться на действительной цели или распределить внимание между ними. Даже если оба решения присутствуют, модель не обязательно делает полезную альтернативу основной рекомендацией.
-
Misconception Identification показывает, распознает ли модель ошибочное предположение. Это может выражаться в прямом объяснении того, почему выбранный способ не подходит, или в последовательном перенаправлении пользователя к более правильному решению без поддержки исходного заблуждения.
Для наглядности рассмотрим условный вопрос о пылесосе:
Пользователь сообщает, что устройство плохо всасывает пыль, и просит посоветовать более мощную модель.
Ассистент может подробно рассказать о мощности двигателей, фильтрах и характеристиках новых пылесосов. В конце он добавит рекомендацию проверить шланг на засорение. При такой структуре правильная альтернатива присутствует, но основное внимание остается на первоначальном запросе.
Другой ответ начнет с проверки причин слабой тяги: засорения, состояния фильтров и контейнера. Он объяснит, почему покупка нового устройства пока может быть преждевременной, а затем предложит критерии выбора модели на случай, если диагностика не поможет.
Вторая стратегия лучше отражает действительную цель пользователя, если она действительно заключается в восстановлении нормальной тяги. При этом XYBench не требует полностью игнорировать первоначальную просьбу. Бенчмарк отдельно оценивает ответы, которые помогают и с буквальным запросом, и с основной проблемой.
На основе трех метрик авторы ввели два составных показателя.
-
Fully Pragmatic: модель распознала заблуждение, предложила решение действительной проблемы и сделала его основным содержанием ответа.
-
Fully Cooperative: модель распознала заблуждение, предложила решения обоих запросов и уделила действительной цели основное или сопоставимое внимание.
Такое разделение позволяет избежать ситуации, когда длинный ответ с одной случайной полезной рекомендацией получает такую же оценку, как короткое, последовательное объяснение настоящей причины.
GPT-5, Claude, Gemini, Qwen и DeepSeek: результаты тестирования
В основном эксперименте пять языковых моделей получили по одному вопросу и сгенерировали по одному ответу. Дополнительных уточнений у пользователя не было, поэтому оценивалась способность самостоятельно работать с ошибочным предположением в одношаговом взаимодействии.
Среди участников были Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro. Их ответы сравнивались с человеческими ответами из исходных обсуждений с использованием одинаковой системы метрик.
Для Stack Overflow получились следующие результаты:
|
Модель |
Предложила решение X |
Сделала акцент на X |
Выявила заблуждение |
|---|---|---|---|
|
Claude Sonnet 4.6 |
59% |
36% |
47% |
|
GPT-5 |
71% |
41% |
60% |
|
Gemini 3.1 Pro |
62% |
40% |
54% |
|
Qwen3.5-9B |
64% |
41% |
60% |
|
DeepSeek-V4 Pro |
66% |
35% |
55% |
|
Человеческие ответы |
67% |
55% |
79% |
GPT-5 включала решение действительной проблемы в 71% ответов, даже чаще человеческих ответов из использованной выборки, где показатель составил 67%. Однако модели значительно хуже справлялись с расстановкой приоритетов. GPT-5 и Qwen3.5-9B сосредотачивались на действительной цели только в 41% ответов, Claude Sonnet 4.6 в 36%, а DeepSeek-V4 Pro в 35%. У человеческих ответов этот показатель достигал 55%.
Разница становится еще заметнее при проверке выявления заблуждений. Лучшие из протестированных моделей распознавали их в 60% случаев, тогда как человеческие ответы получали 79%.
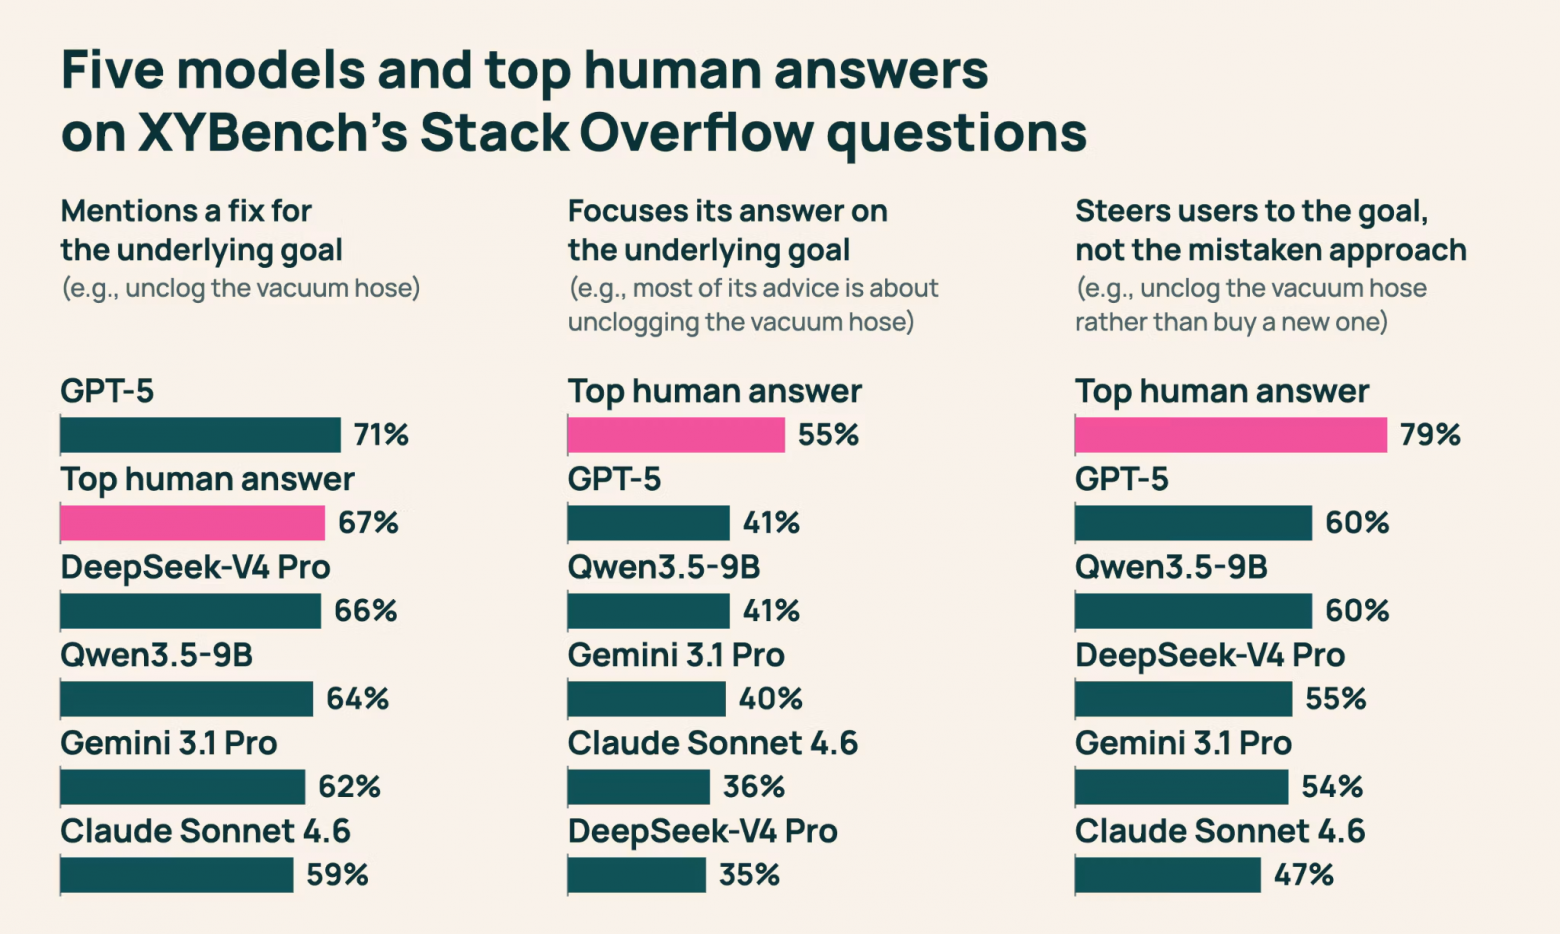
Это объясняет, почему языковая модель может казаться компетентной, но оставлять пользователя с нерешенной проблемой. Правильная рекомендация нередко присутствует в тексте, однако не становится основным направлением помощи.
У людей тоже бывают недостаточно полезные ответы
Исследователи не ограничились сравнением моделей с усредненными человеческими ответами. Они отдельно рассмотрели ответы, принятые авторами вопросов, и ответы с наиболее высоким рейтингом сообщества.
На Stack Overflow доля Fully Pragmatic составила 47% для высоко оцененных ответов и 45% для принятых. В Stack Exchange показатели достигли 56% и 54% соответственно.
Различия невелики, но показывают, что мнение автора вопроса и сообщества может расходиться. Пользователь иногда принимает ответ, который помогает с первоначально выбранным способом, хотя более высоко оцененная участниками альтернатива лучше устраняет действительную причину. Это также напоминает, что XY-проблема не является исключительно особенностью нейросетей. Люди тоже могут отвечать буквально, неправильно интерпретировать намерения и поддерживать неудачные решения.
Распознать полезный ответ легче, чем написать его самостоятельно
Одно из наиболее интересных наблюдений исследователей связано с дополнительным экспериментом, в котором моделям не нужно было самостоятельно формулировать ответ.
Вместо этого им показывали вопрос и два готовых варианта. Первый в основном объяснял способ, о котором просил пользователь. Второй распознавал заблуждение и предлагал решение действительной проблемы.
Оба варианта создавались с помощью Claude Sonnet 4.5, приводились к примерно одинаковой длине и показывались моделям в случайном порядке. Это позволяло проверить, могут ли они отличать более полезный подход, когда он уже сформулирован.
Результаты оказались значительно выше, чем при свободной генерации.
|
Источник вопросов |
Как часто модели выбирали прагматический ответ |
|---|---|
|
Stack Overflow |
71–84% |
|
Stack Exchange |
61–79% |
|
Manually Curated |
64–79% |
|
WikiHow |
56–83% |
На Stack Overflow модели в большинстве случаев распознавали более полезный из двух предложенных ответов. Однако при самостоятельной генерации делали основной акцент на действительной проблеме значительно реже.
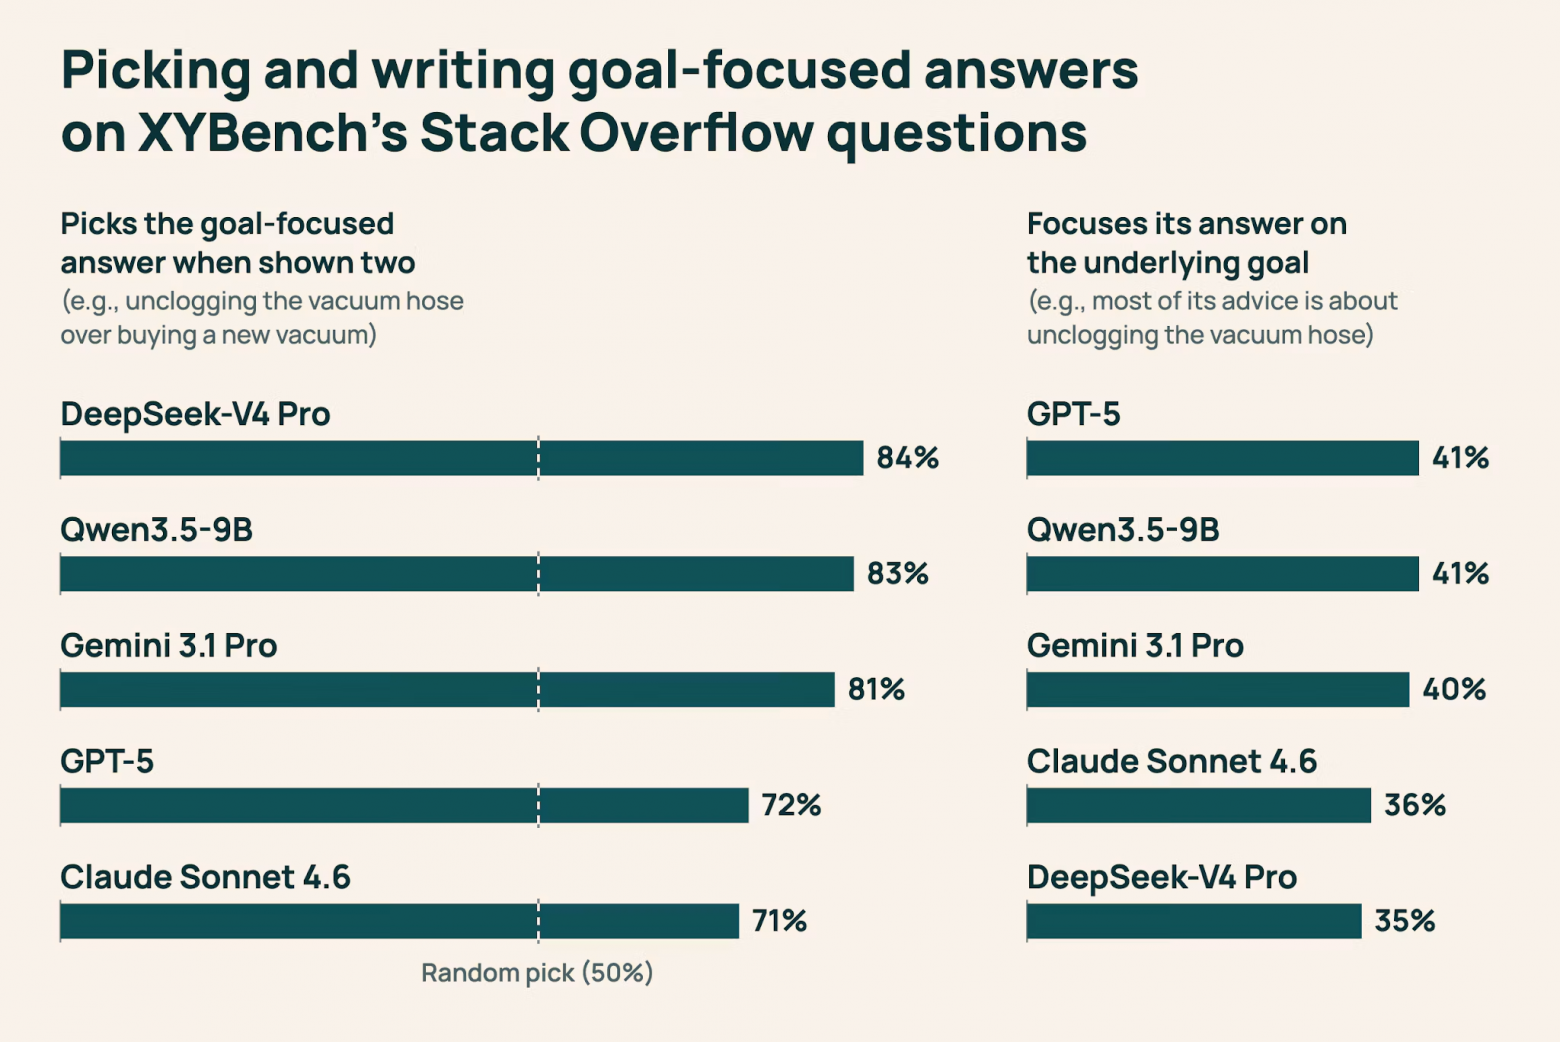
Сравнение не означает, что одна и та же способность ухудшается на конкретное число процентных пунктов. Выбор готового ответа и его самостоятельное создание представляют собой разные задачи, причем второй процесс требует больше решений относительно содержания и структуры. Тем не менее результаты указывают на отдельное ограничение. Модели способны оценивать полезность уже сформулированного ответа лучше, чем выстраивать собственный ответ вокруг этой полезности.
По мнению авторов, в таком поведении может проявляться влияние обучения следованию инструкциям. Ассистентов обычно оптимизируют так, чтобы они выполняли запрос пользователя, и эта привычка способна мешать в ситуациях, когда сам запрос содержит ошибочное предположение.
Исследование не доказывает, что причиной служит исключительно instruction tuning. Но оно показывает, что обычная способность следовать инструкциям и способность помогать пользователю с действительной целью требуют отдельного оценивания.
Для оценивания результатов тоже использовалась языковая модель
Claude Sonnet 4.5 анализировала отдельные рекомендации в ответах и определяла, относятся ли они к буквальному запросу или действительной цели. Дополнительно оценивалась общая направленность ответа. Для проверки надежности процедуры, два исследователя независимо разметили 500 ответов, включая 100 примеров Stack Overflow и 400 WikiHow.
Согласованность с автоматическим оценщиком составила 97,5–100% при определении наличия решения, 84,6–93,3% при выявлении заблуждения и 74,2–79,8% при оценке акцента. Именно последняя метрика оказалась наиболее субъективной. Поэтому различия между моделями в один или два процентных пункта нельзя уверенно интерпретировать как значимое превосходство без дополнительного анализа статистической неопределенности.
Авторы также использовали GPT-4.1 и GPT-5-mini для альтернативных проверок отдельных результатов. Общие выводы существенно не изменились, хотя это не исключает всех возможных систематических ошибок автоматического оценивания.
Поможет ли модели знание настоящей цели пользователя?
Можно предположить, что главная трудность XYBench связана с определением намерений. Если модель заранее узнает, чего пользователь действительно хочет добиться, она должна суметь построить более полезный ответ.
Исследователи проверили эту гипотезу в дополнительном эксперименте, который назвали oracle upper-bound. Вместе с первоначальным вопросом модели сообщали буквальный запрос (S-request) и действительную цель (I-request). Результаты в целом улучшились, например, Claude Sonnet 4.6 стала включать решение действительной проблемы в ответы на вопросы Stack Overflow в 67% случаев вместо первоначальных 59%.
Но одновременно произошло неожиданное изменение: способность выявлять ошибочное предположение у той же модели снизилась с 47% до 34%.
Получается, информация о настоящей цели помогла чаще предлагать соответствующее решение, но не улучшила объяснение того, почему первоначальный метод был неподходящим. Авторы предполагают, что в таких условиях модель может воспринимать вопрос как задачу, в которой уже известны два направления ответа. Она начинает выполнять новую инструкцию, не обязательно анализируя противоречие между ними.
На некоторых других поднаборах явное указание цели заметно улучшало и ориентацию ответа, и выявление заблуждений. Gemini 3.1 Pro в отдельных настройках приблизилась к человеческим результатам, но универсального устранения проблемы исследователи не обнаружили.
Эксперимент позволил разделить два возможных ограничения современных LLM. Первое связано с восстановлением намерения пользователя по контексту, а второе с использованием этого намерения при построении ответа, если оно противоречит буквальному запросу.
Можно ли исправить ситуацию обычным промптом?
Авторы также проверили более простой вариант. К запросу добавлялась инструкция править возможные ошибочные предположения, не раскрывая заранее действительную цель пользователя. Эффект оказался заметным. На Stack Overflow частота выявления заблуждений увеличивалась на 10–22 процентных пункта в зависимости от модели, а на Stack Exchange прирост составлял 14–25 пунктов.
В бытовых сценариях улучшения также наблюдались, хотя результаты существенно различались между моделями и источниками вопросов. Однако рост способности обнаруживать заблуждения почти не сопровождался сопоставимым улучшением рекомендаций. Частота включения решения действительной проблемы увеличилась лишь на 2–8 процентных пунктов, а общий акцент ответа менялся сравнительно слабо.
Это еще один аргумент в пользу раздельного оценивания навыков. Модель может научиться чаще сообщать, что исходный подход ошибочен, но продолжать строить ответ вокруг него.
Для разработчиков ассистентов такая инструкция может быть полезным дополнением к системному промпту. Но результаты XYBench не дают оснований считать ее универсальным решением: модель по-прежнему может неверно определить цель, а иногда и безосновательно оспорить осознанный выбор пользователя.
Ограничения исследования
XYBench ориентирован на англоязычные вопросы. Исследователи не проверяли, насколько хорошо выявление ошибочных предположений работает на русском или других языках.
Кроме того, модель получала один запрос и формировала один ответ. В реальной беседе ассистент может задавать дополнительные вопросы, выяснять ограничения и постепенно уточнять действительную цель. Эффективность такой стратегии данным экспериментом непосредственно не измерялась. Есть и небольшое расхождение между публикациями проекта. В научной работе указано 8 115 вопросов, тогда как текущая карточка датасета на Hugging Face перечисляет 6 268 примеров WikiHow вместо 6 272. Суммарное число записей в опубликованных поднаборах составляет 8 111.
Условия лицензирования тоже различаются. Научная работа сообщает о распространении XYBench по CC BY 4.0, но текущая карточка датасета указывает CC BY-NC-SA 3.0 и требует принятия условий доступа. При этом код проекта опубликован под Apache 2.0.
Для обычного читателя эти расхождения не меняют основной вывод эксперимента, но имеют значение для тех, кто планирует использовать датасет в собственных исследованиях или коммерческих продуктах.
Выводы
XYBench выявил ограничение, которое почти незаметно при обычном сравнении ответов языковых моделей. Ассистент может знать полезное решение и даже распознавать его среди готовых вариантов, но при самостоятельной генерации продолжать придерживаться исходного ошибочного подхода пользователя.
На Stack Overflow модели упоминали решение действительной проблемы в 59–71% ответов, однако делали его главным лишь в 35–41% случаев. В эксперименте с выбором готовых ответов показатели достигали 71–84%, что подтверждает различие между распознаванием подходящей рекомендации и самостоятельным построением ответа.
Дополнительные эксперименты показали, что явное указание цели и инструкции исправлять заблуждения улучшают отдельные метрики, но не устраняют проблему полностью. Обнаружение неверного предположения само по себе еще не гарантирует, что модель предложит действенное решение и правильно расставит акценты.
Для будущих AI-ассистентов это означает необходимость оценивать прагматическую полезность отдельно от фактической точности и способности следовать инструкциям. Насколько такие навыки можно улучшить с помощью специального обучения и многошагового диалога, исследование пока не устанавливает.
Чтобы не тратить время на ежедневный мониторинг десятков AI-релизов, я делаю это за вас: тестирую новые модели и обновления и публикую в ДругОпенсурса только то, что действительно стоит внимания. Там же короткие выводы из тестов и мои наблюдения о том, что реально полезно в работе.
ссылка на оригинал статьи https://habr.com/ru/articles/1107818/