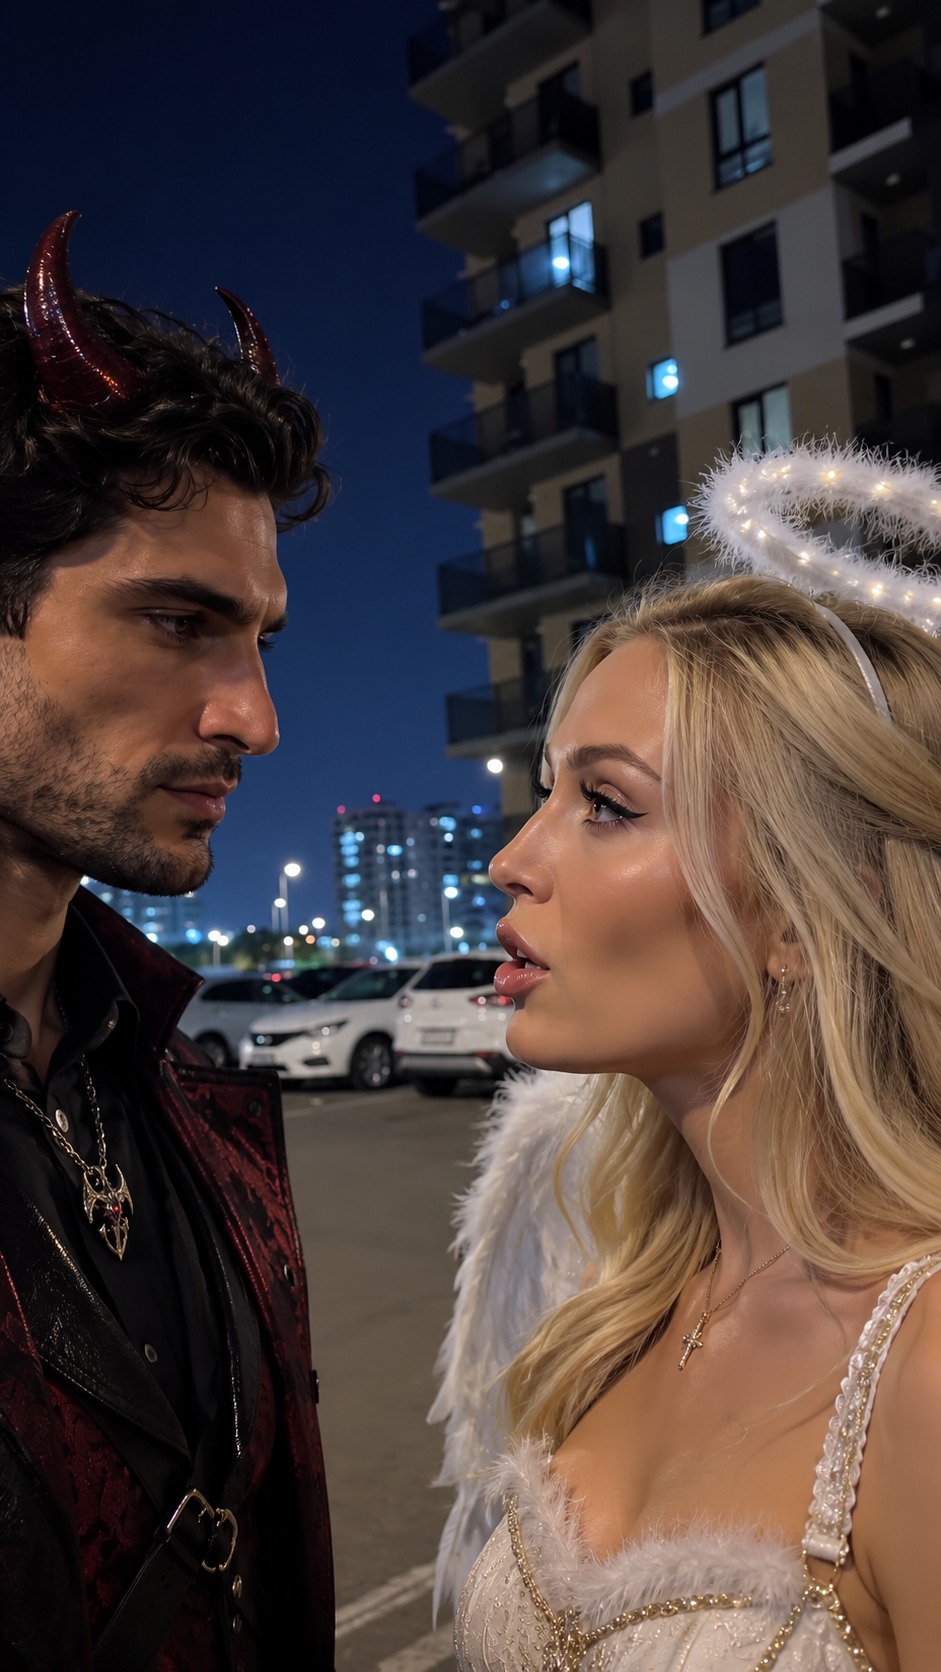
В ноябре 2026 года в коротких видео снова зазвучала песня Светы «Мои слёзы». Только теперь вместо обычных клипов пользователи создают с помощью нейросетей целые мини-сцены: двое стоят друг напротив друга на ночной парковке, вокруг многоэтажки, машины и свет фонарей.
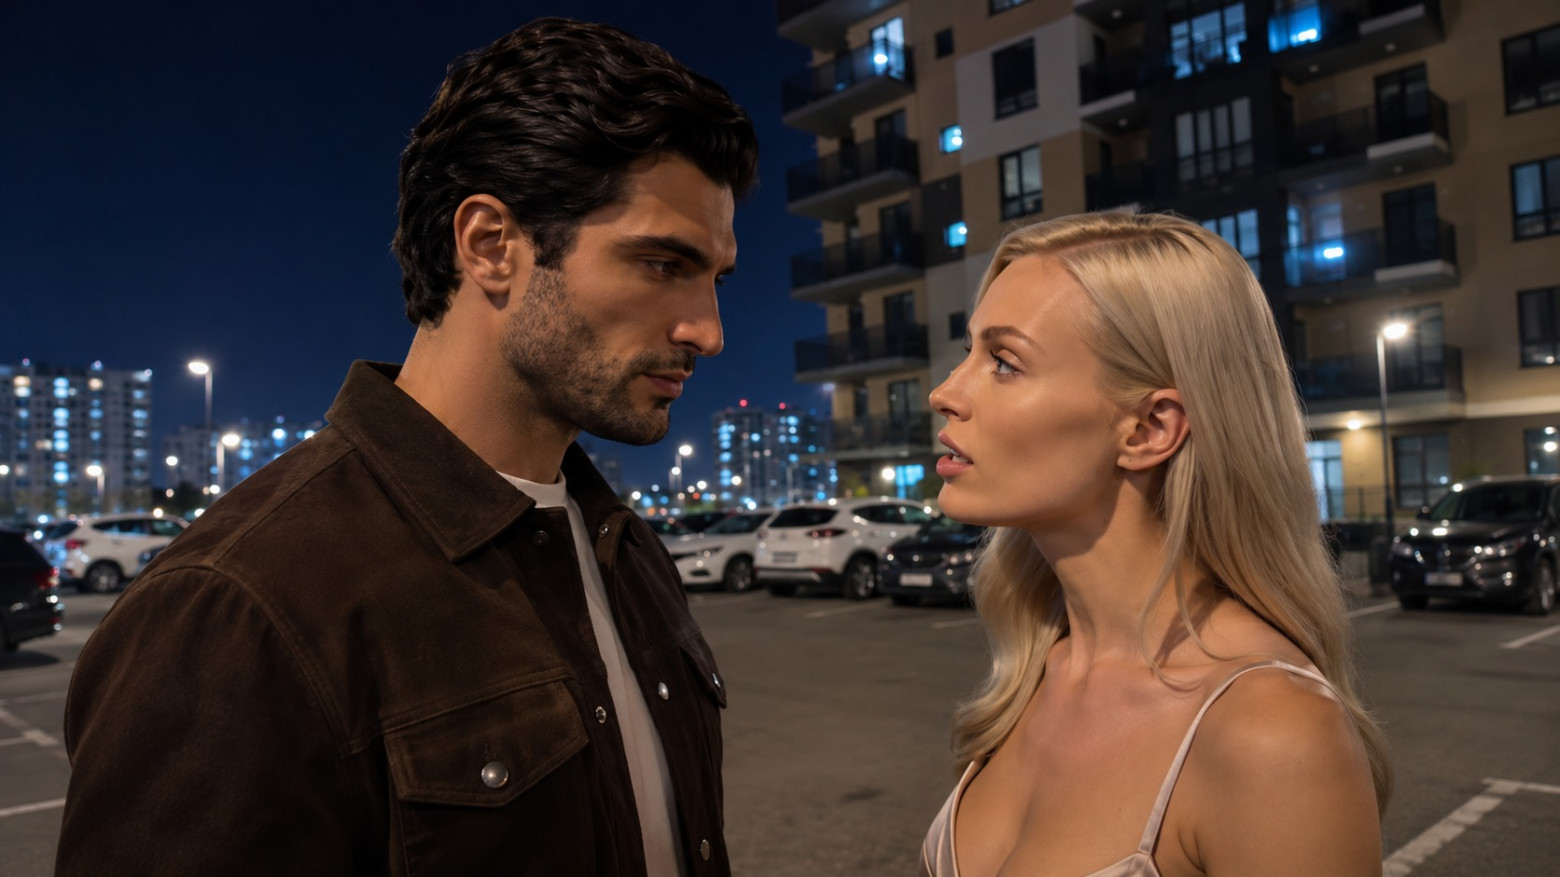
Выглядит так, будто герои действительно встретились поздним вечером ради серьёзного разговора. На практике для создания подобного видео необязательно выходить из дома, искать подходящую локацию или осваивать видеомонтаж.
Разберём, как устроен тренд «Мои слёзы не помогут», почему нейросетям непросто создавать сцены с двумя людьми и как повторить такой ролик с помощью готового пресета «Разговор под фонарями» в SpeShu.AI.
Что за тренд «Мои слёзы не помогут»
Основой тренда стала песня «Мои слёзы» певицы Светы, вышедшая в 2002 году. Спустя более двадцати лет композиция вернулась в короткие видео, а её эмоциональный припев превратился в сопровождение для нейросетевых сцен.
Сюжет большинства роликов узнаётся практически мгновенно.
Действие происходит ночью в обычном жилом районе. На заднем плане видны многоквартирные дома с освещёнными окнами, припаркованные автомобили и уличные фонари. В центре кадра стоят два человека, которые смотрят друг на друга и эмоционально разыгрывают музыкальный диалог.
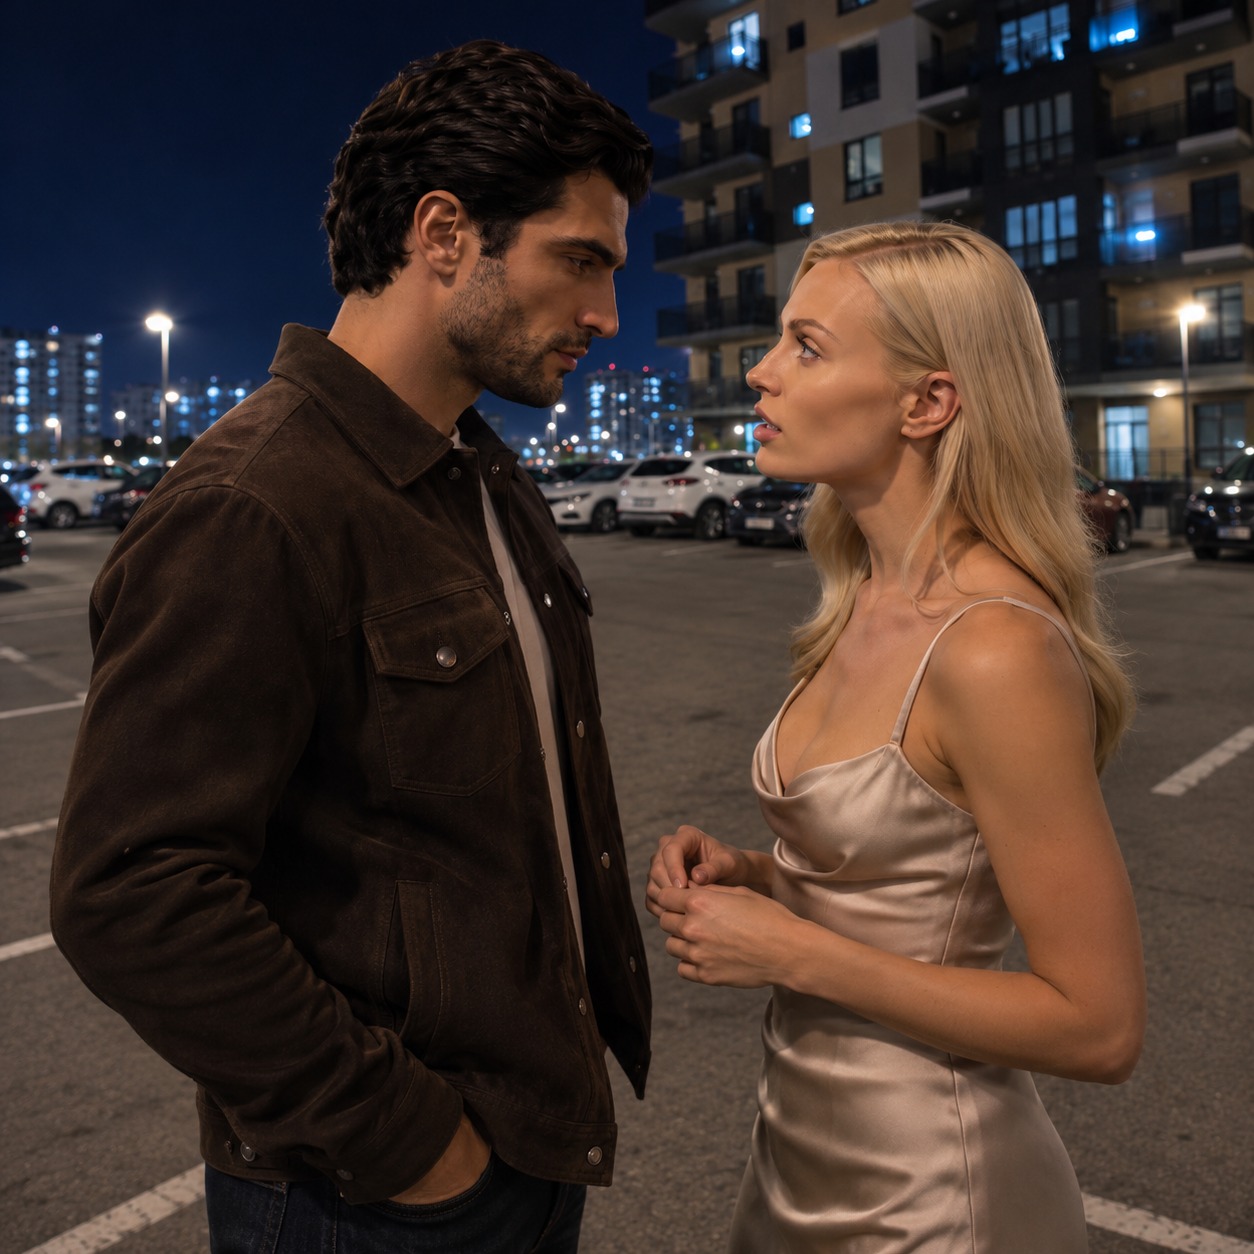
При этом участниками могут стать совершенно разные люди: друзья, влюблённые, родственники или коллеги. Меняются лица и обстоятельства, но сама постановка остаётся узнаваемой.
Главная особенность тренда заключается в контрасте. Музыкальная композиция звучит максимально драматично, а действие разворачивается на самой обычной парковке. Именно это сочетание позволяет использовать один сценарий как для романтического ролика, так и для ироничного видео с другом.
Почему генерация видео с двумя героями сложнее обычного оживления фото
Современные видеомодели умеют превращать статичные изображения в движущиеся сцены. Пользователь загружает фотографию, задаёт действие, после чего модель генерирует последовательность кадров.
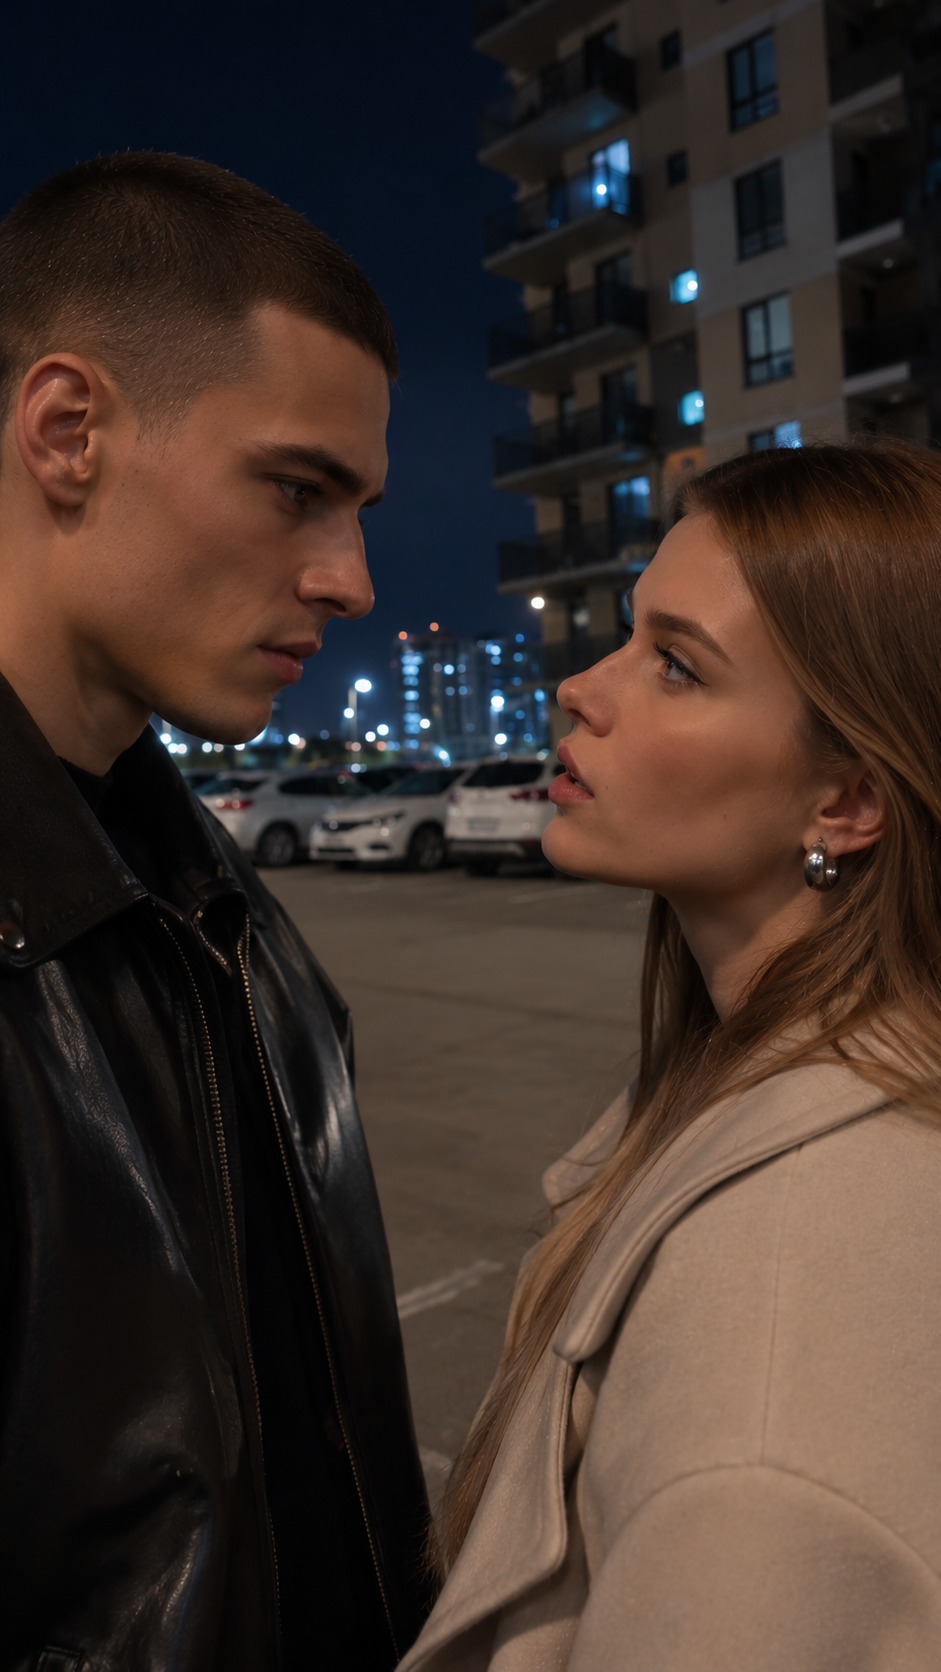
Но когда персонажей становится двое, задача усложняется.
Первая проблема: сохранение внешности.
Нейросеть должна поддерживать узнаваемость каждого человека на протяжении всего видео. При изменении ракурса модель фактически достраивает те части лица, которых не было видно на исходном снимке.
Из-за этого могут меняться форма носа, линия подбородка или причёска. Особенно заметны такие ошибки в сценах, где камера переходит от одного персонажа к другому.
Вторая проблема: согласованность движений.
Персонажи должны вести себя естественно и одновременно взаимодействовать между собой. Например, один человек произносит эмоциональную реплику, а другой продолжает смотреть на него.
Если действия недостаточно точно заданы, модель может заставить обоих двигаться синхронно или добавить неестественные жесты.
Третья проблема: синхронизация губ.
В музыкальных сценах недостаточно просто заставить персонажа открывать рот. Движение губ должно соответствовать ритму аудиодорожки.
Для этого применяются модели или отдельные механизмы синхронизации речи с изображением. Без такой обработки персонаж может выглядеть убедительно на отдельных кадрах, но его исполнение не будет совпадать с музыкой.
Поэтому короткий ролик, в котором два человека просто стоят друг напротив друга, может оказаться технически сложнее видео с одним танцующим персонажем.
Пресет «Разговор под фонарями»: готовый сценарий для генерации
При ручном создании подобной сцены необходимо самостоятельно продумать несколько параметров:
-
Расположение двух персонажей и их действия.
-
Ночное окружение, освещение и композицию.
-
Движение виртуальной камеры и последовательность кадров.
Кроме того, потребуется подобрать подходящую видеомодель и составить подробный промпт.
Другой вариант — использовать готовый пресет.
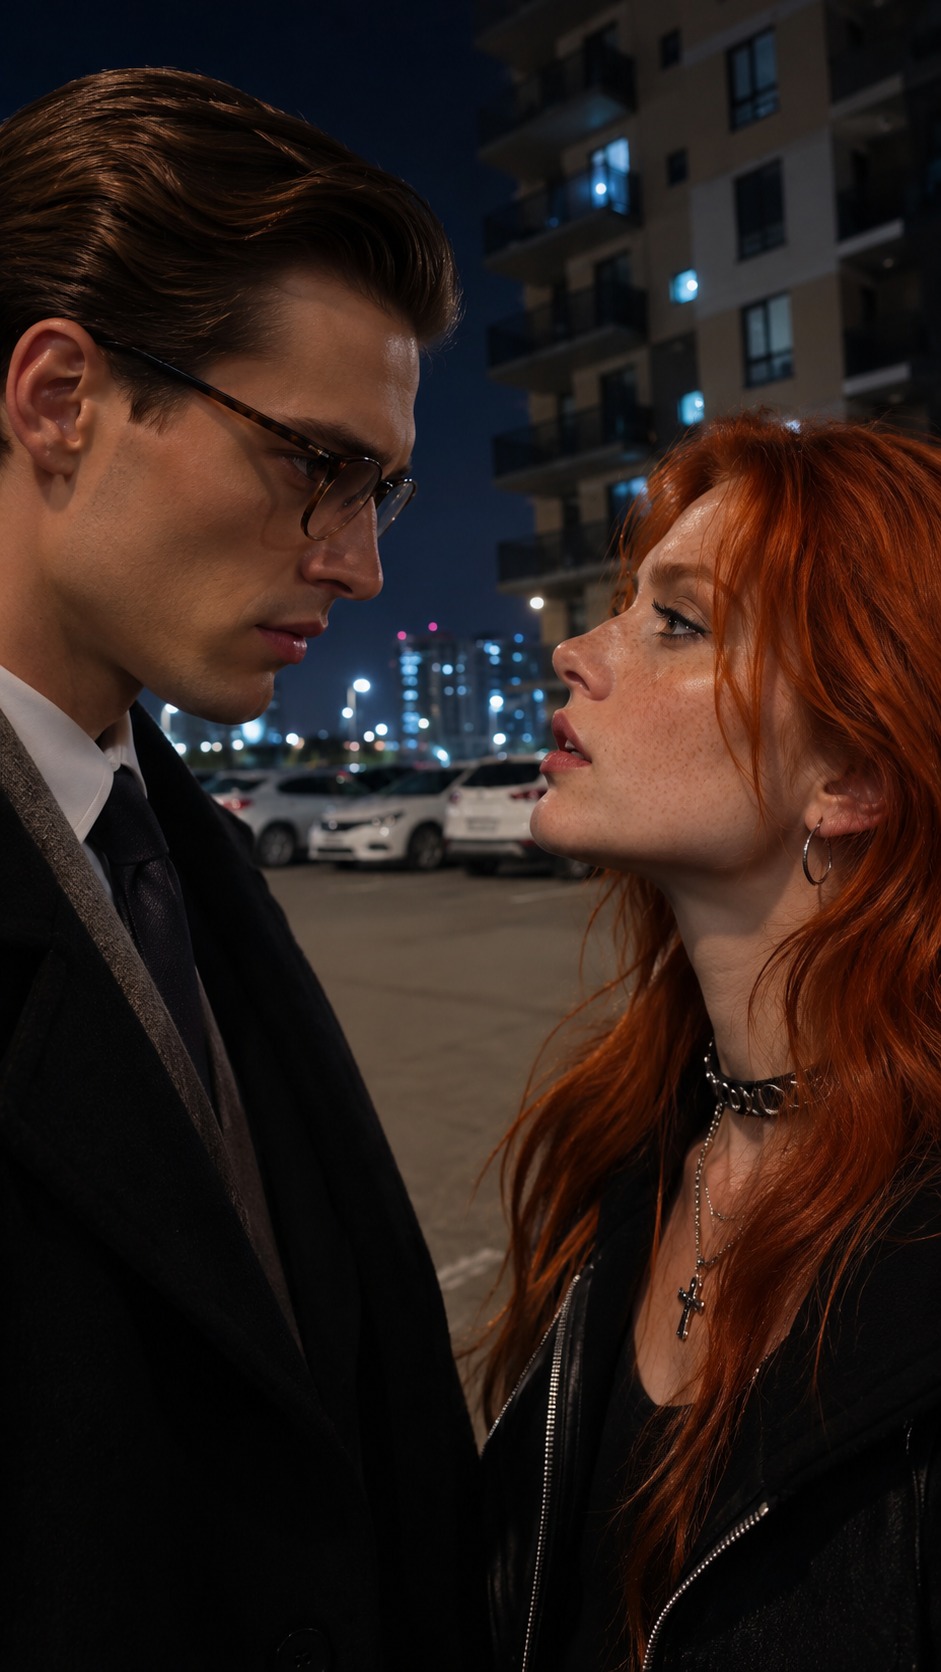
В SpeShu.AI есть пресет «Разговор под фонарями» из категории «Тот самый тренд». Он предназначен для создания ИИ-видео по фотографии и воспроизводит узнаваемую ночную сцену с двумя персонажами.
В основе сюжета находится парковка рядом с жилыми многоэтажками. Герои стоят лицом друг к другу, а освещение и работа камеры создают атмосферу эмоционального разговора.
Главное отличие пресета от обычного текстового запроса заключается в том, что сценарий уже подготовлен. Пользователю не нужно самостоятельно описывать ночной двор, расположение персонажей и каждое движение камеры.
Готовый шаблон особенно удобен для повторения конкретного тренда, когда важны не эксперименты с постановкой, а узнаваемый результат.
Как сделать ИИ-видео «Мои слёзы не помогут» по фотографии
Процесс генерации с готовым шаблоном можно разделить на четыре этапа.
Шаг 1. Найдите подходящий пресет
Откройте SpeShu.AI и перейдите в раздел пресетов. В категории «Тот самый тренд» найдите сценарий «Разговор под фонарями».
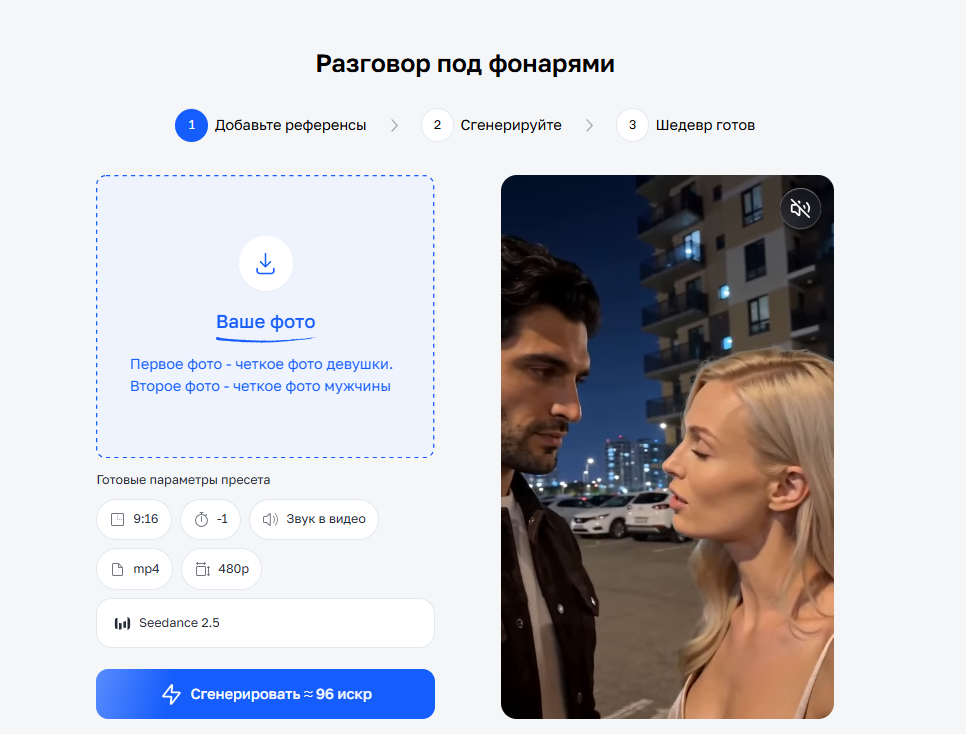
Перед запуском посмотрите демонстрационный ролик. Он поможет понять, как расположены герои и какие движения предусмотрены в готовой сцене.
Шаг 2. Подготовьте фотографии
Для генерации с узнаваемыми лицами желательно выбирать чёткие фотографии без сильной ретуши.
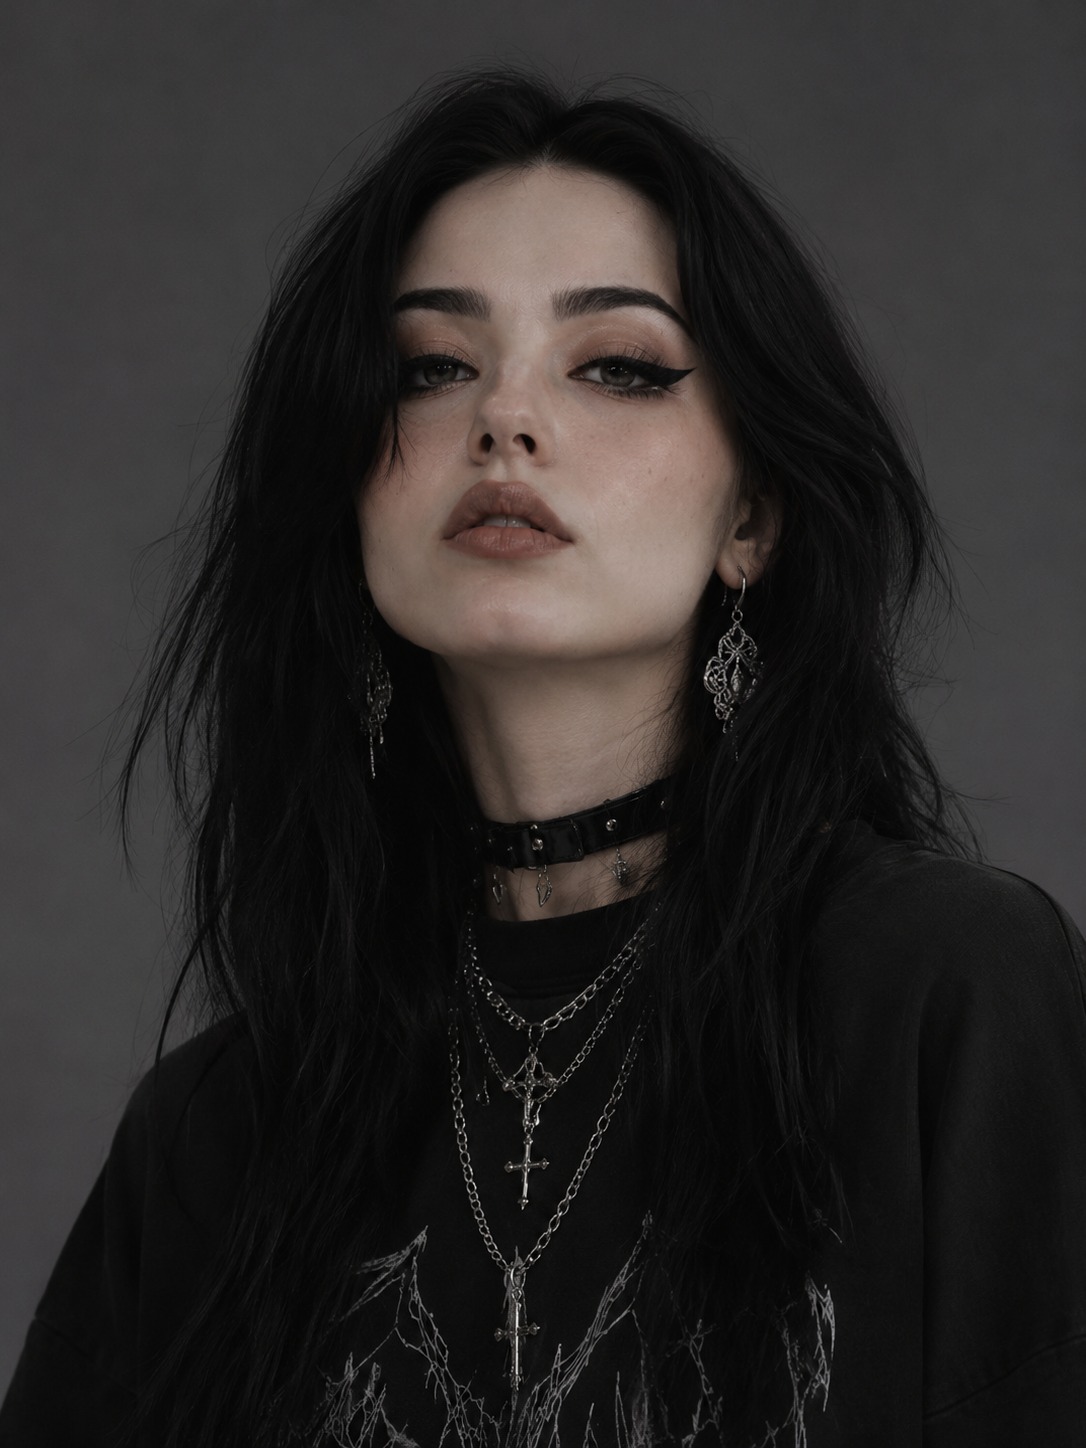
Лучше всего подходят портреты, на которых хорошо различимы глаза, нос, линия подбородка и причёска. Желательно, чтобы лицо находилось анфас или было немного повёрнуто.
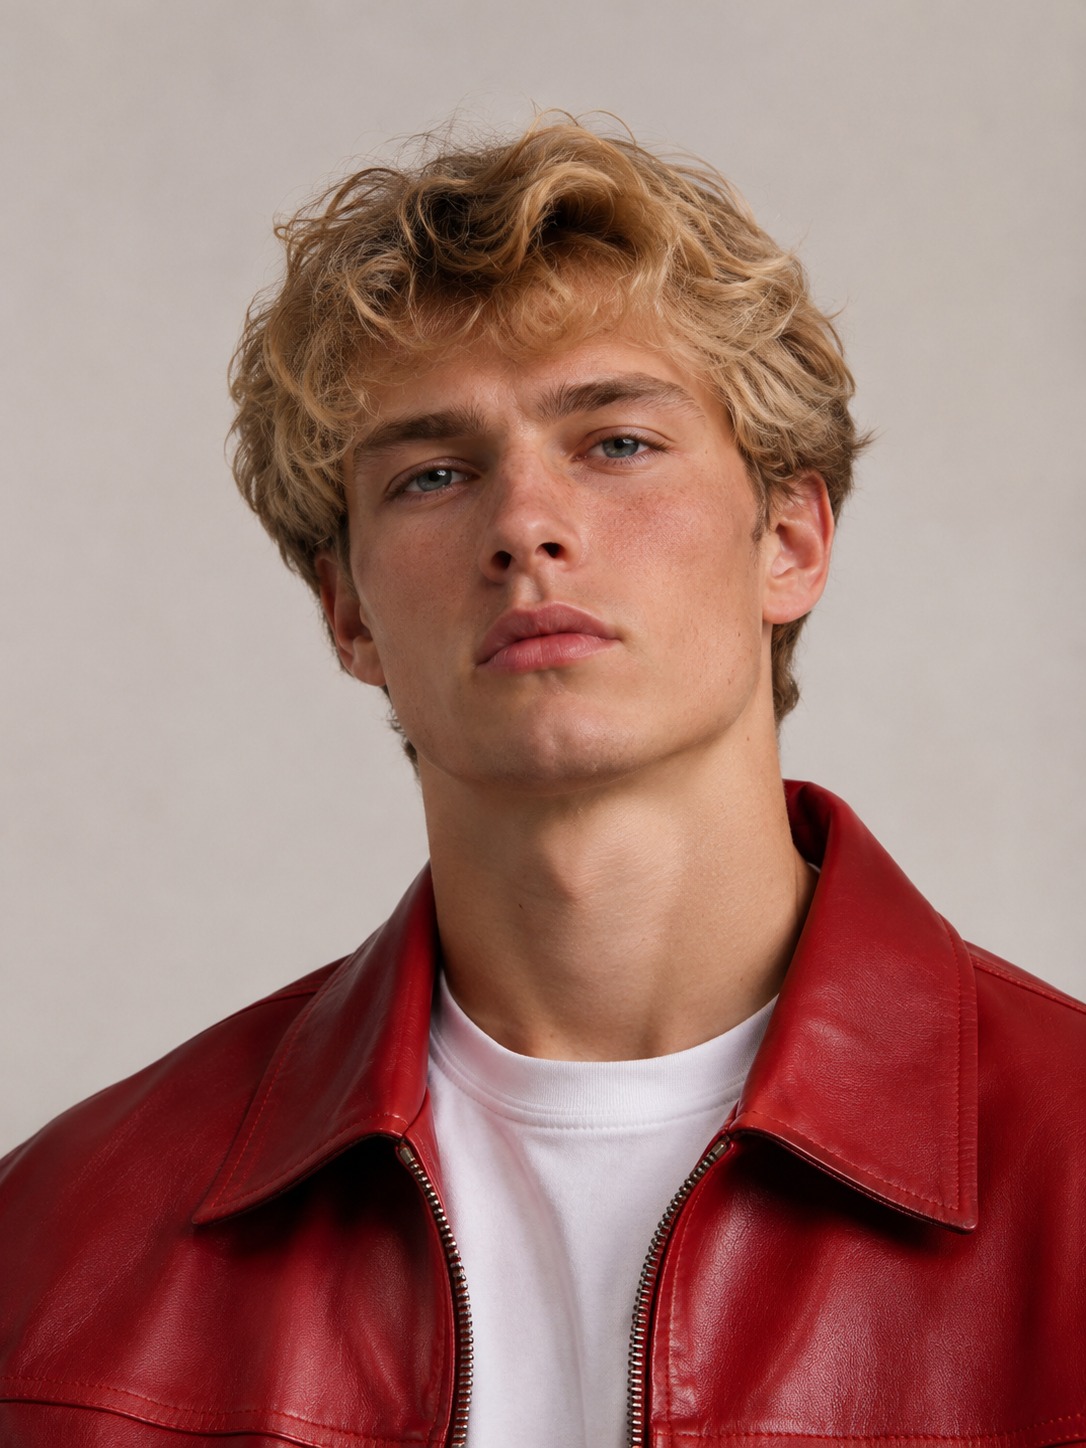
Количество и расположение загружаемых изображений определяются полями конкретного пресета.
Шаг 3. Запустите генерацию
Загрузите необходимые изображения в соответствующие поля и проверьте параметры ролика.
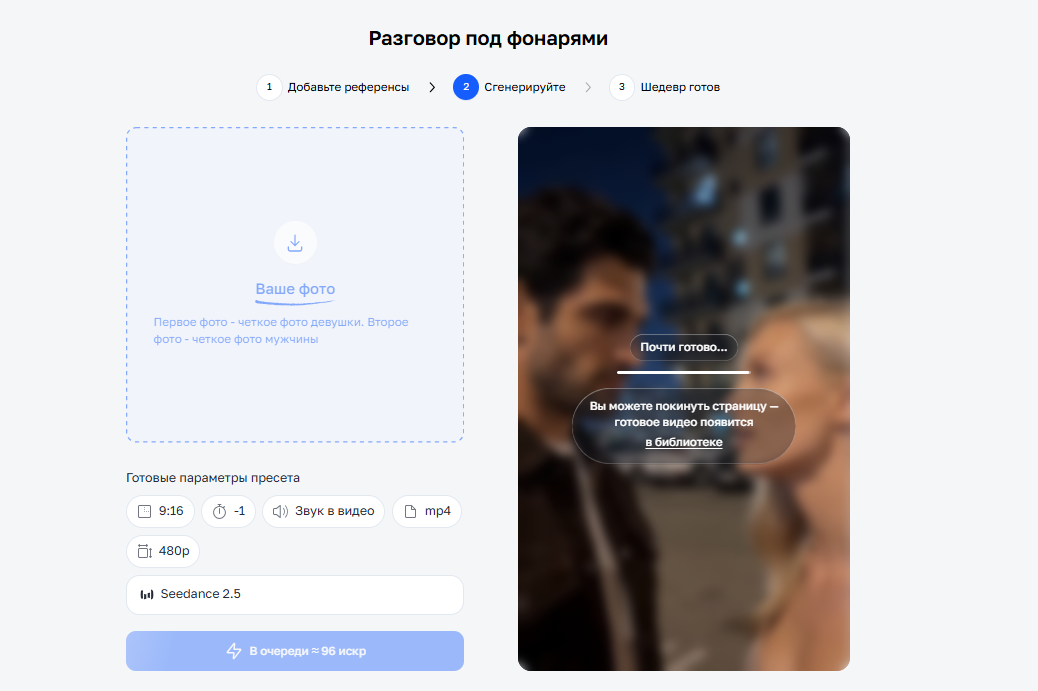
Основная постановка уже предусмотрена сценарием. Остаётся запустить генерацию и получить готовое видео.
Шаг 4. Проверьте результат
Перед публикацией посмотрите ролик целиком. Обратите внимание, сохраняется ли внешность персонажей, не появляются ли лишние объекты и насколько естественно выглядят их движения.
Особенно внимательно стоит проверить моменты поворота головы и перехода камеры между героями.
Если модель заметно изменила лицо, имеет смысл попробовать другой исходный снимок. Повторная генерация с тем же изображением не всегда решает проблему.
Какие ошибки чаще всего возникают в таких роликах
Даже при хорошем исходнике видеогенерация не всегда получается с первого раза.
Персонажи меняются лицами. Такое может произойти, если модель недостаточно хорошо различает два референса. При ручной генерации стоит явно указать, какой персонаж находится слева, а какой справа.
Лицо деформируется при повороте. Чем сильнее поворот относительно исходного снимка, тем больше деталей нейросети приходится восстанавливать самостоятельно. Для первых попыток лучше выбирать умеренные движения.
Герои двигаются одинаково. Когда промпт не разделяет действия персонажей, модель может анимировать их слишком похоже. Помогает отдельное описание поведения каждого человека.
Камера двигается слишком резко. Сложные движения камеры увеличивают вероятность визуальных ошибок. Для эмоционального диалога обычно достаточно плавного приближения или небольшого бокового движения.
Пропадают детали окружения. Автомобили, фонари и окна могут менять форму между кадрами. Уменьшить вероятность таких ошибок помогает простая композиция без большого количества движущихся объектов.
Готовые пресеты сокращают объём ручной настройки, но не отменяют этих ограничений полностью. Качество фотографии и особенности используемой модели по-прежнему влияют на результат.
Как подготовить ролик к публикации
После генерации важно проверить не только изображение, но и звуковую дорожку.
Если в готовом файле нет нужной песни, её можно добавить через официальную музыкальную библиотеку платформы, на которой планируется публикация. Это позволяет использовать доступный для соответствующей площадки аудиофрагмент с учётом её правил.
Для публикации стоит также проверить формат кадра: вертикальные видео удобнее для Reels, Shorts и VK Клипов, тогда как горизонтальная версия может потребовать отдельного кадрирования.
Не забывайте и о согласии участников. Если в ролике используется фотография другого человека, особенно при создании реалистичной сцены, лучше заранее согласовать её использование и публикацию.
Итог
Тренд «Мои слёзы не помогут» показывает, что для выразительного ИИ-видео необязательно создавать сложные спецэффекты. Иногда достаточно двух персонажей, знакомой локации, нескольких движений камеры и музыкального сопровождения.
При этом технически такая сцена требует согласованной работы сразу с несколькими элементами: сохранением внешности, движениями двух героев, освещением и синхронизацией губ.
Для ручной генерации можно последовательно создать изображение по референсам, анимировать его и добавить звук. Такой подход даёт больше свободы для изменения сюжета.
Если же задача состоит именно в повторении узнаваемого тренда, проще воспользоваться готовым сценарием.
В SpeShu.AI для этого есть пресет «Разговор под фонарями», позволяющий превратить фотографию в короткую ночную сцену без самостоятельного написания сложного промпта.
Остаётся выбрать подходящий исходник, запустить генерацию и проверить получившееся видео.
ссылка на оригинал статьи https://habr.com/ru/articles/1107884/