Какое видео можно получить в Gemini Omni 1.2 Flash? Нейросеть прошла реальные тесты с разными задачами: оцениваем качество изображения, речь, движение и работу с референсами. Показываю удачные результаты и неудачные попытки, объясняю процесс доработки и делюсь промптами.
Gemini Omni 1.2 Flash — видеонейросеть Google, которая создаёт ролики до 15 секунд с речью, музыкой и звуковыми эффектами. Она работает с текстом и визуальными референсами, помогает оживлять фотографии, собирать новые сцены и редактировать готовое видео.
Модели можно задать движение камеры, реплики и действия персонажей, а внешность, одежду и окружение передать изображениями. Это удобно для короткой рекламы, говорящих героев, демонстрации товаров и атмосферных сюжетов с собственным звуком.
Разберём, как пользоваться Gemini Omni 1.2 Flash, где начать работу и сколько стоит генерация. На трёх моих видео покажу сильные стороны модели, полезные промпты и приёмы, которые помогли справиться со сложными сценами.
📹 Попробовать Gemini Omni 1.2 Flash из России
Что умеет Gemini Omni 1.2 Flash и что я проверял
Gemini умеет генерировать видео, а не только писать сценарии для него. В семействе Google за это отвечает в том числе Gemini Omni 1.2 Flash — модель, вышедшая 5 ноября 2026 года. Она создаёт изображение в движении вместе с речью, музыкой и звуковыми эффектами, работает с визуальными исходниками и позволяет дорабатывать видео текстовыми инструкциями.
|
Характеристика |
Что доступно |
Практический смысл |
|
Длительность |
Генерация от 3 до 15 секунд, шаг — одна секунда |
Можно выделить время на реплику, действие и финальную реакцию |
|
Исходники |
Текст, изображения, поддерживаемые видеореференсы |
Необязательно придумывать внешность и окружение заново в каждом запросе |
|
Звук |
Речь, музыка и окружающие звуки |
Реплики и звуковое оформление можно получить вместе с видео |
|
Формат |
Горизонтальное 16:9 и вертикальное 9:16 |
Обложечный ролик, короткая реклама, вертикальный сюжет |
|
Разрешение |
360p и 720p; вывод 1080p и 4K с повышением разрешения |
Сначала можно проверить сцену, затем подготовить более крупную версию |
|
Доработка |
Редактирование по инструкции и продолжение клипа |
Менять отдельные свойства сцены или развивать уже найденную идею |
У отдельных режимов и интерфейсов свои пределы. Например, в API переход между первым и последним кадрами рассчитан на 3–10 секунд, а продление добавляет 3–10 секунд за один шаг, до 30 секунд суммарно. Поэтому «модель делает 15 секунд» ещё не означает, что любой режим в любом тарифе даст такой хронометраж.
Я выбрал задачи, в которых легко отличить красивую картинку от выполненного задания:
-
Маяк: русская речь, лицо девушки, чашка и раскрытие большого пространства движением камеры.
-
Тренировка: объединение нескольких исходников и выполнение заданного упражнения.
-
Бой: смена планов, эмоции, быстрые движения, расстояние между персонажами и контакт оружия с телом.
Это три практических кейса, а не статистическое исследование. По ним можно понять рабочий процесс и увидеть конкретные сложности.
Девушка на маяке: ради такой русской речи модель уже стоит попробовать
Первый опыт генерации видео в Gemini Omni 1.2 Flash я строил вокруг простого раскрытия. В начале — девушка крупным планом, в руках горячий чай. Она произносит короткую фразу, делает глоток, а камера отдаляется: оказывается, девушка стоит на верхней площадке высокого маяка, расположенного на отдельной скале среди воды. На горизонте восход.
Здесь сама смена масштаба работает как маленькая история. Сначала мы видим человека и слышим голос, затем понимаем, где он находится. Не нужно добавлять десять событий, чтобы ролик смотрелся кинематографично.
Какие изображения я подготовил
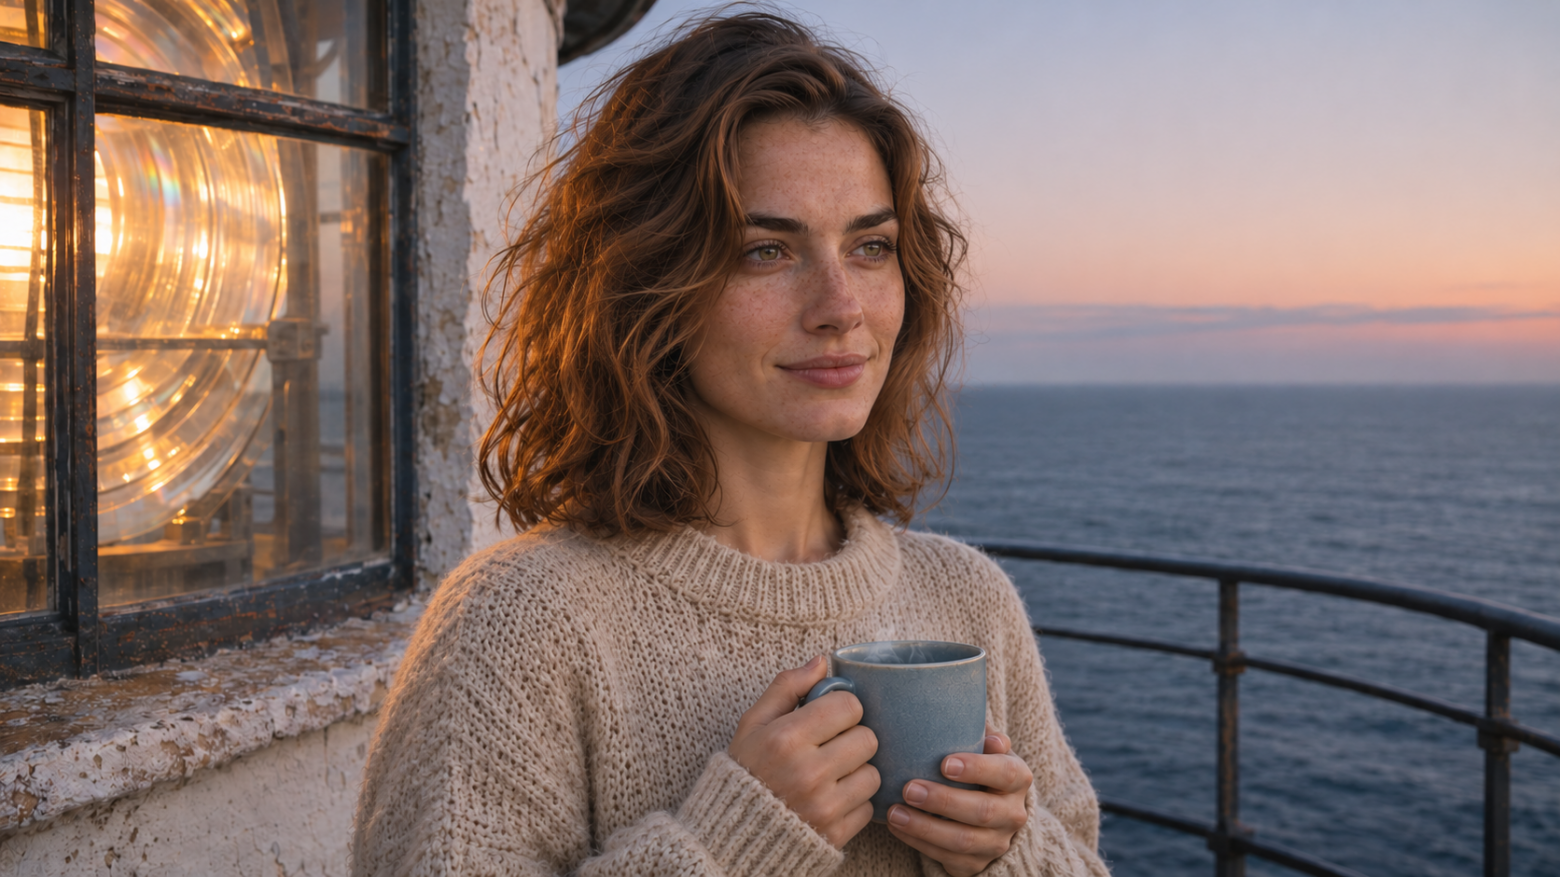
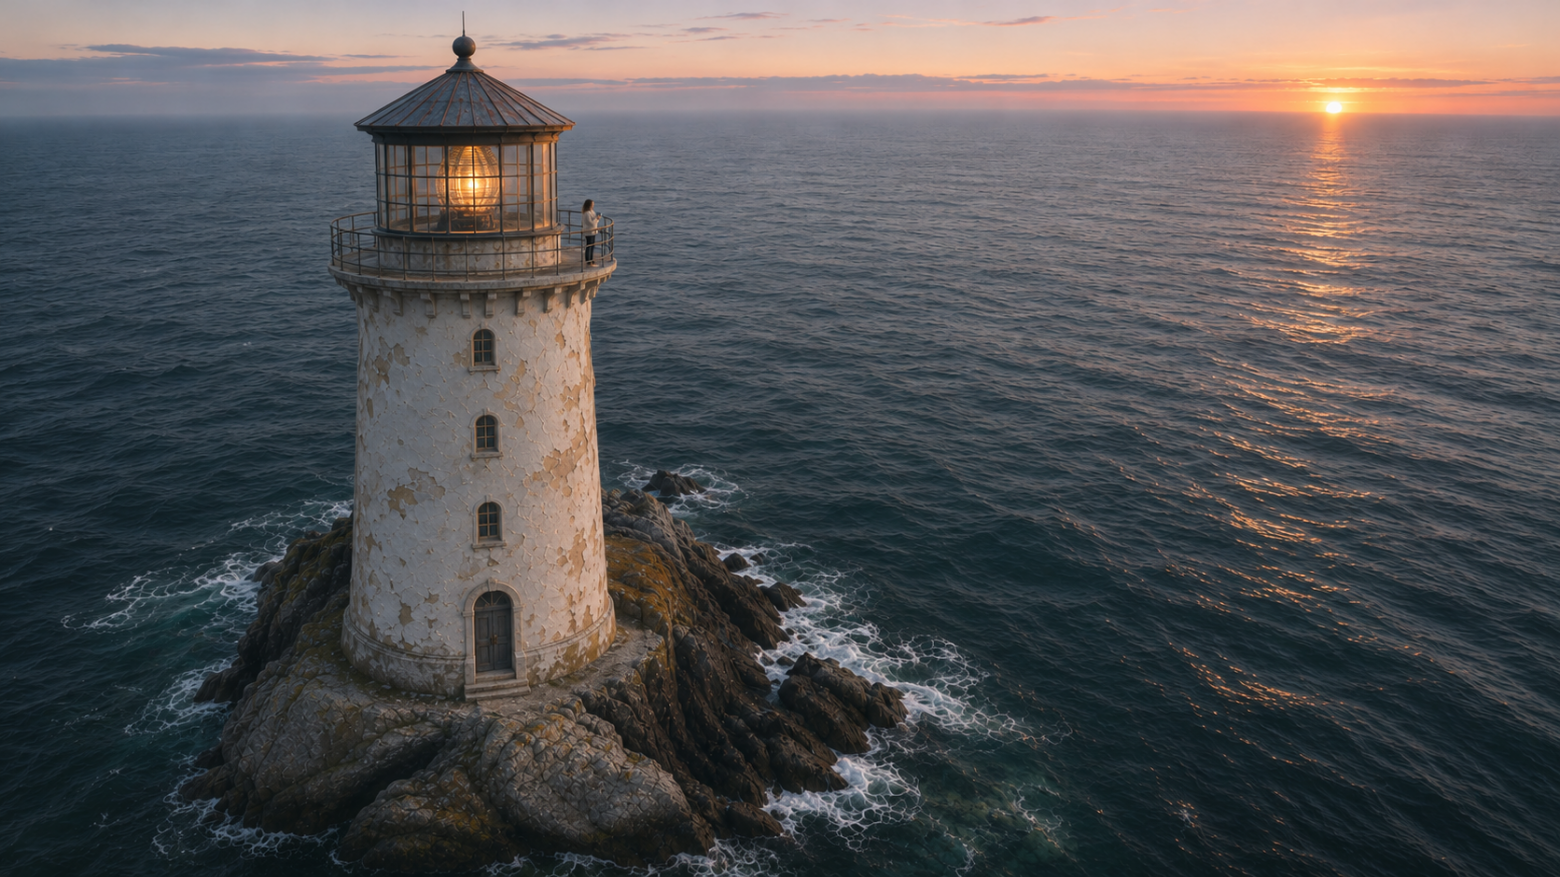
Референсы я сгенерировал в GPT Image 2.6. Один показывал девушку с чашкой, второй — высокий маяк на скале, море и восход. Первый отвечал за внешность и близкий план, второй помогал задать пространство для отдаления камеры.
Референс — изображение, на которое модель ориентируется. Он может задавать персонажа, одежду, место или внешний вид всей сцены. Это не всегда первый кадр: роль исходника зависит от выбранного режима и инструкции.
Исходники из GPT Image 2.6: близкий план и окружение для раскрытия сцены
Как выглядело задание
В статье я привожу промпты в компактном рабочем изложении: сохраняю действия и условия, убираю повторы из промежуточных правок.
Создай фотореалистичное кинематографическое видео длительностью 15 секунд, одним непрерывным планом.РОЛИ ИЗОБРАЖЕНИЙ@image1 — точный стартовый кадр. Сохрани внешность девушки, лицо, причёску, одежду, чашку, положение рук и начальное освещение.@image2 — референс окружающего пространства: высокий маяк на отдельной скале, со всех сторон окружённой морем, его архитектура, верхняя площадка и расположение восходящего солнца. Используй его, чтобы последовательно раскрыть окружение при отдалении камеры. Не вставляй @image2 отдельным кадром и не переходи к нему склейкой.Это одна девушка и один маяк в едином пространстве. Девушка всё время остаётся на той же верхней открытой площадке.0–5 секунд.Начни точно с @image1: девушка крупным планом держит чашку ниже лица. Камера почти неподвижна. Она смотрит в сторону от камеры и спокойно, тепло, тихо и нежно произносит по-русски:«Люблю это время. Будто весь мир ещё принадлежит только тебе».Естественный женский голос, разговорный темп, небольшая пауза между предложениями. Точная синхронизация губ. Она заканчивает говорить до того, как подносит чашку ко рту.5–7 секунд.Девушка делает один небольшой глоток, естественно наклоняя чашку, затем опускает её до уровня груди и слегка улыбается. Сохрани форму чашки, пальцы и черты лица. Камера пока остаётся рядом.7–10 секунд.Камера плавно отлетает назад и поднимается, постепенно переходя от портрета к общему воздушному плану. Движение непрерывное, с мягким ускорением и замедлением в конце. Раскрой высокий маяк целиком, его основание на отдельной скале и воду вокруг. Архитектура и окружение соответствуют @image2. Девушка естественно уменьшается в кадре и остаётся на верхней площадке. В финале маяк — главный объект композиции, вокруг видно море, на горизонте — восход. Волны спокойно накатывают на скалу.СВЕТ И ЗВУКСохрани направление света и предрассветную палитру референсов. Мягкое золотистое солнце, прохладные морские тени, естественная кожа. Тихий прибой и лёгкий ветер слышны с начала. Во время реплики голос отчётливый, окружающие звуки приглушены. После реплики прибой становится немного заметнее. Без музыки.Без склеек, смены сцены, внезапного скачка масштаба, пролёта сквозь стены, дополнительных людей, субтитров и надписей. Маяк и скала не меняют форму.
Что получилось
Видео получилось отлично, особенно русская речь. Для меня это самый убедительный результат тестирования: удачный визуальный сюжет и голос работают вместе, а не существуют отдельно друг от друга.
При подготовке я специально разделил речь, глоток и отдаление. Если одновременно попросить говорить, пить и быстро менять ракурс, модель должна согласовать слишком много движений лица и рук. Здесь каждое действие получило своё короткое окно.
Два изображения-референса, русская реплика и раскрытие пространства от портрета до общего вида
Такой приём можно перенести на рекламный ролик, туристическую сцену или короткую историю о персонаже. Начать с человека или предмета, дать зрителю зацепку, затем показать окружение — понятная задача и для автора, и для модели.
Человек, одежда и зал из разных изображений: собираем тренировку
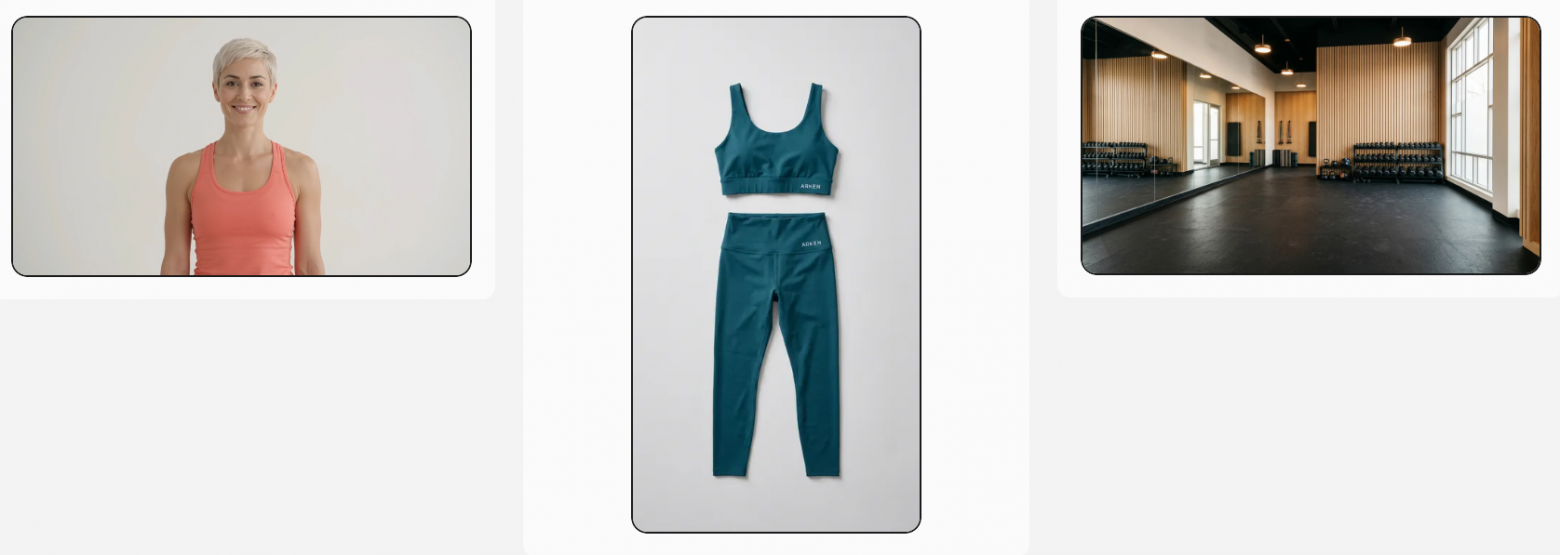
Во втором тесте я загрузил отдельно портрет женщины, спортивную одежду и изображение тренажёрного зала. Задача — поместить эту женщину в заданное помещение, одеть в загруженный комплект и показать упражнение с гантелями.
Это уже другой способ создания видео в Gemini: исходники задают не один готовый кадр, а составляющие будущей сцены. Для контента о товарах такая возможность интереснее абстрактного «красивая девушка занимается спортом»: можно принести конкретный образ, комплект и интерьер.
Как распределить роли референсов
-
Первое изображение: внешность женщины.
-
Второе: спортивный комплект, его цвета и надпись.
-
Третье: помещение, свет и расположение оборудования.
Если просто прикрепить три файла и написать «сделай тренировку», часть решений останется на усмотрение модели. Явное распределение ролей помогает объяснить, что именно брать из каждого изображения.
Промпт для тренировки
Ниже — переформулированный вариант моего задания с тем же смыслом. В нём указаны именно изображения: портрет не нужно называть видеореференсом.
Use image 1 as the identity reference for the instructor, preserving her facial features and hairstyle. Put her in the activewear shown in image 2, retaining the garment colors and the original wordmark. Set the scene in the training studio from image 3, with its mirrored wall behind her.In a single continuous take, she faces the camera and performs a controlled dumbbell squat followed by an overhead press. The camera moves slowly sideways throughout the exercise. She brings the dumbbells down, finishes the movement and gives a brief confident nod.Sound: an energetic electronic workout beat, subtle dumbbell clinks and a short audible exhale with each press. No spoken dialogue or on-screen captions.
Сцена собрана из отдельных изображений женщины, спортивной одежды и тренажёрного зала
В результате у меня появился ролик тренировки, построенный на конкретных исходниках. Это полезная основа для демонстрации спортивного комплекта, визуализации занятия или короткого контента для студии.
Но здесь проверять нужно не только лицо. В таком видео я отдельно смотрю на хват гантелей, согласованность движения рук, отражение в зеркале и сохранение надписи на одежде. Удачный общий образ ещё не заменяет проверку деталей товара и упражнения.
Бой с монстром: почему я перестал пытаться получить всё одним запросом
Третий сюжет был самым амбициозным. Девушка с мечом стоит на мрачном кладбище перед огромным рогатым существом. Монстр атакует, она уклоняется, произносит короткую реплику и контратакует. Хотелось быстрых движений, выразительной камеры и реализма — маленького фрагмента фэнтезийного фильма.
Сначала я пытался сделать всю сцену одной генерацией. Потом уточнял направление взгляда, движения камеры, последовательность удара и отскока. Несколько ошибок повторялись, несмотря на всё более подробные инструкции.
Что именно ломалось
-
Визуальная подача. Ранние варианты без изображений выглядели слишком гладко, словно игровая катсцена. Перечисление пор кожи, грязи и царапин само по себе этого не исправляло.
-
Внимание героини. В отдельных кадрах она смотрела в сторону, хотя перед ней уже замахивался противник.
-
Свет между планами. В одном из дублей начало заметно отличалось от заданной картинки, после склейки появлялся кадр, гораздо ближе повторяющий референс.
-
Контакт. Удар по каменной плите выглядел неубедительно. В других попытках рука попадала в девушку вместо того, чтобы пройти перед ней после уклонения.
-
Скорость и расстояние. Движения становились вязкими, отскок — слишком маленьким, а меч иногда доставал монстра, хотя между ними оставалось слишком много пространства.
Это самый удачный вариант из моих попыток, всего их было 6. Ошибки на видео увидите сами, первая сцена выпадает из общего стиля, удар в конце немного скомканный, реакции монстра на него нет. Но, стоит заметить, что сцена с крупным планом очень хорошая, идеальная речь, мимика, липсинк — идеально.
Здесь полезно смотреть не на количество слов в промпте, а на число зависимых действий. Для правильного удара модель должна согласовать замах, траекторию руки, положение девушки, отскок, дистанцию и момент контакта. Если одно звено смещается, вся схватка перестаёт выглядеть убедительно.
Что я изменил в процессе
Вместо одной большой генерации я разделил эпизод на три самостоятельных плана. Для каждого подготовил свой стартовый кадр: общий вид противостояния, крупный план девушки и положение перед атакой. Потом соединил готовые фрагменты.
Важный поворот: я перестал заново описывать внешность поверх готового изображения. Если лицо, причёска, одежда и свет уже есть в стартовом кадре, промпту полезнее объяснять, что должно произойти дальше. Лишние новые характеристики только создают дополнительные варианты трактовки.
-
Сначала добился нужной визуальной основы на изображении.
-
Выделил отдельный план для приближения монстра.
-
Отдельно сгенерировал лицо, эмоцию и русскую реплику.
-
Контактную схватку оставил самостоятельной задачей.
-
Выбрал подходящие фрагменты и собрал итоговое видео монтажом.
Промпты для отдельных планов
Каждый план начинается со своего кадра: модель получает готовое визуальное решение
План 1. Приближение угрозы
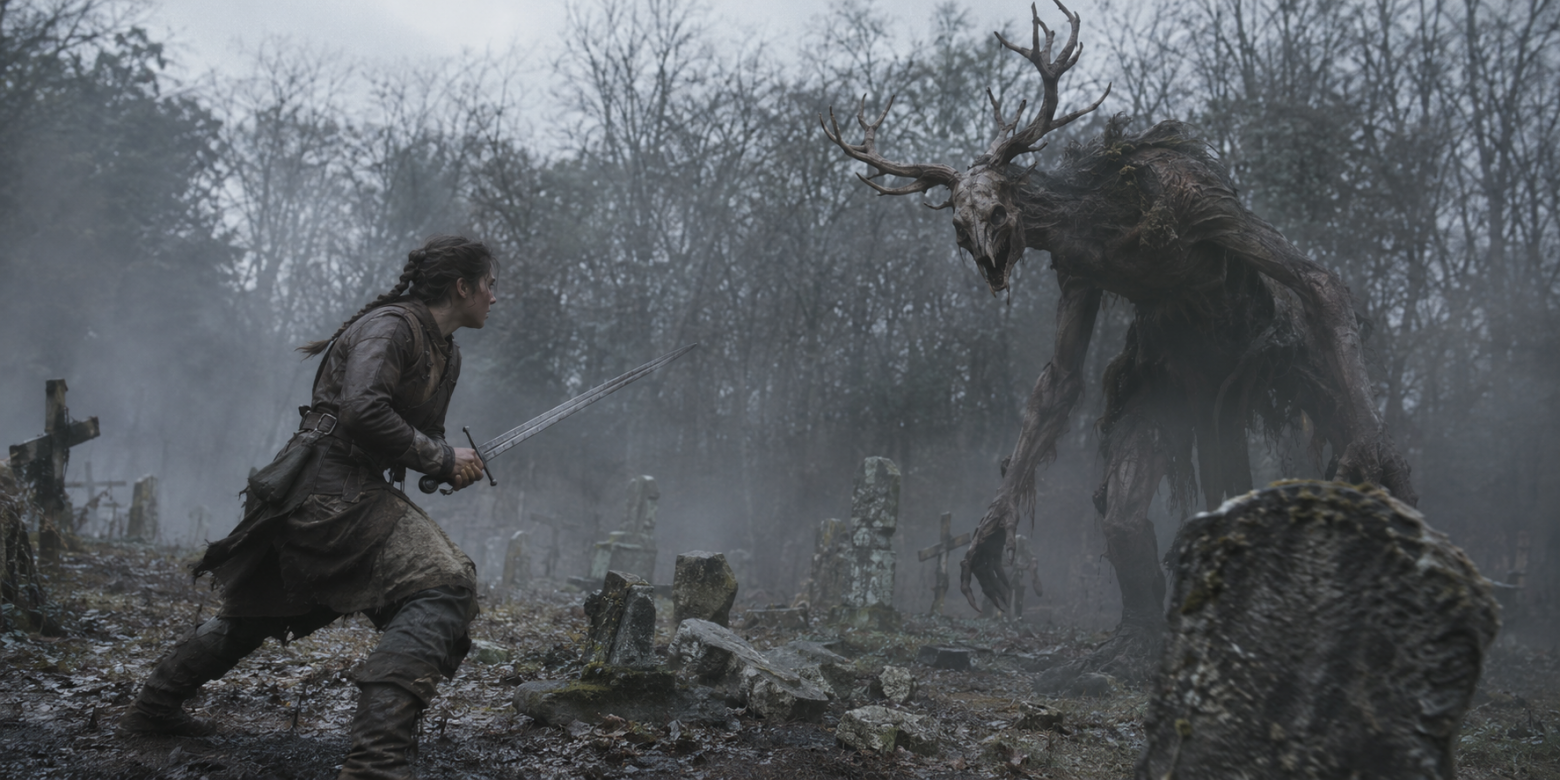
Оживи изображение как точный первый кадр. Сохрани персонажей, окружение, освещение и фотографическую фактуру.Существо делает один тяжёлый шаг к девушке. Переносит вес вперёд, ставит ногу в мокрую землю; плечи и голова подаются следом. Девушка крепче сжимает меч, слегка сгибает колени и переносит вес назад. Голова и внимание направлены на существо.Камера плавно приближается из-за её плеча. Ближние надгробия смещаются относительно дальних деревьев. Туман проходит между могилами, одежда слегка движется от ветра.Звук: тяжёлый шаг, скрип кожи, дыхание и низкий выдох существа. Без речи и музыки. Один непрерывный план.
План 2. Крупный план и русская реплика
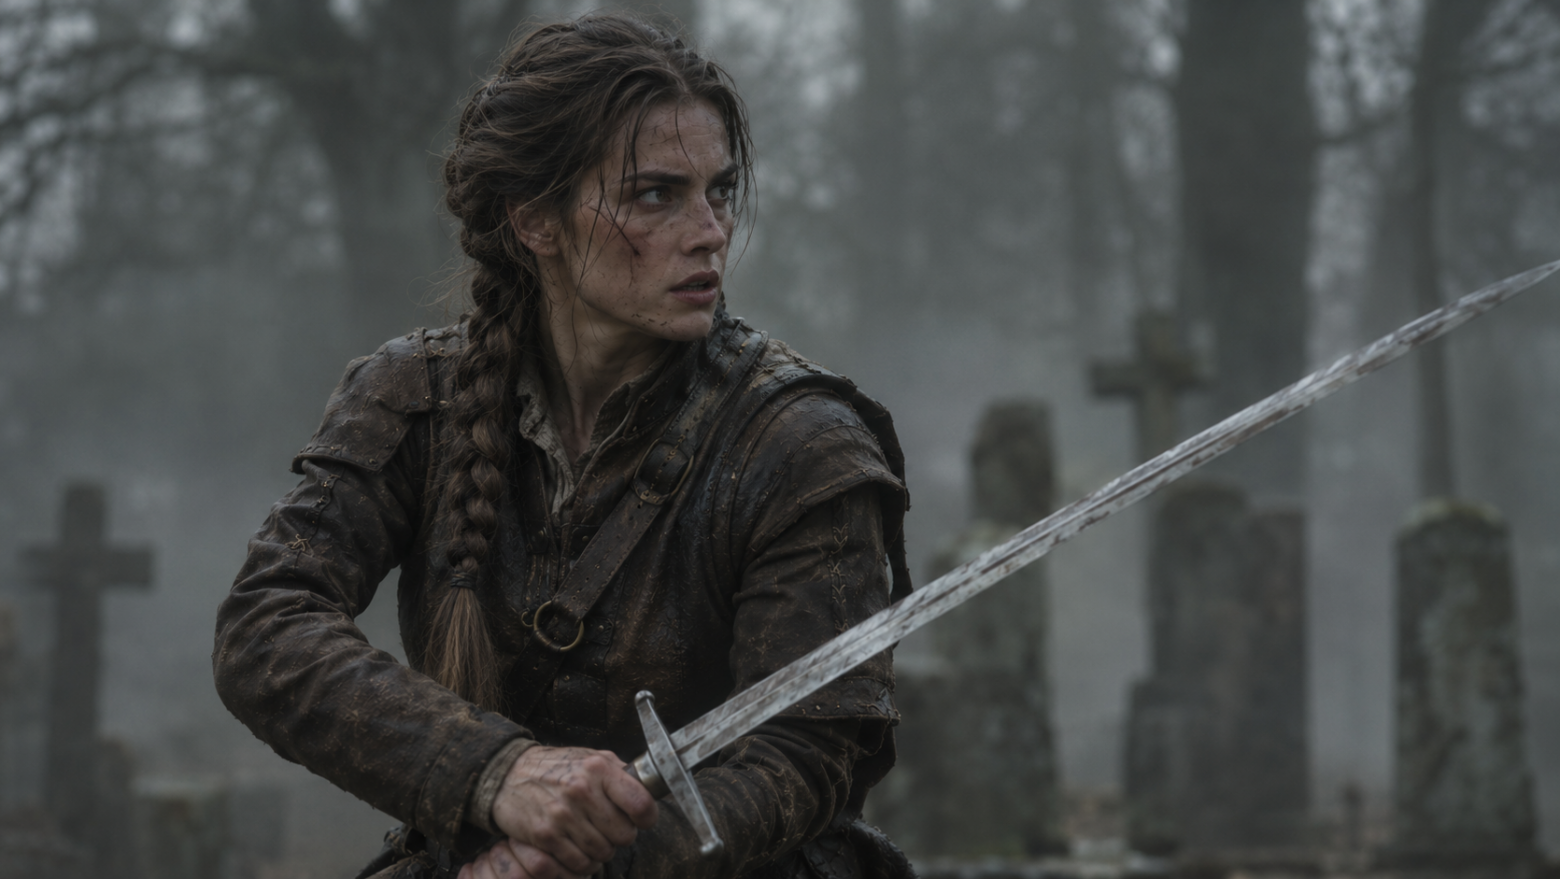
Оживи изображение как точный первый кадр. Сохрани лицо, причёску, одежду, направление взгляда, освещение и фон.Девушка коротко втягивает воздух. На мгновение в глазах появляется испуг, затем взгляд становится жёстким и сосредоточенным. Брови едва сходятся, челюсть напрягается. Она удерживает взгляд в направлении исходного изображения.На выдохе тихо и зло произносит по-русски: «Иди сюда, сволочь».Сдержанная угроза, естественный негромкий голос с лёгкой хрипотцой. Точная синхронизация губ. После реплики губы смыкаются, следует короткий вдох, выражение остаётся решительным.Камера едва заметно приближается. Глаза резкие, фон мягкий, плечи слегка двигаются от дыхания. Без музыки, других голосов и надписей.
План 3. Уклонение и контратака
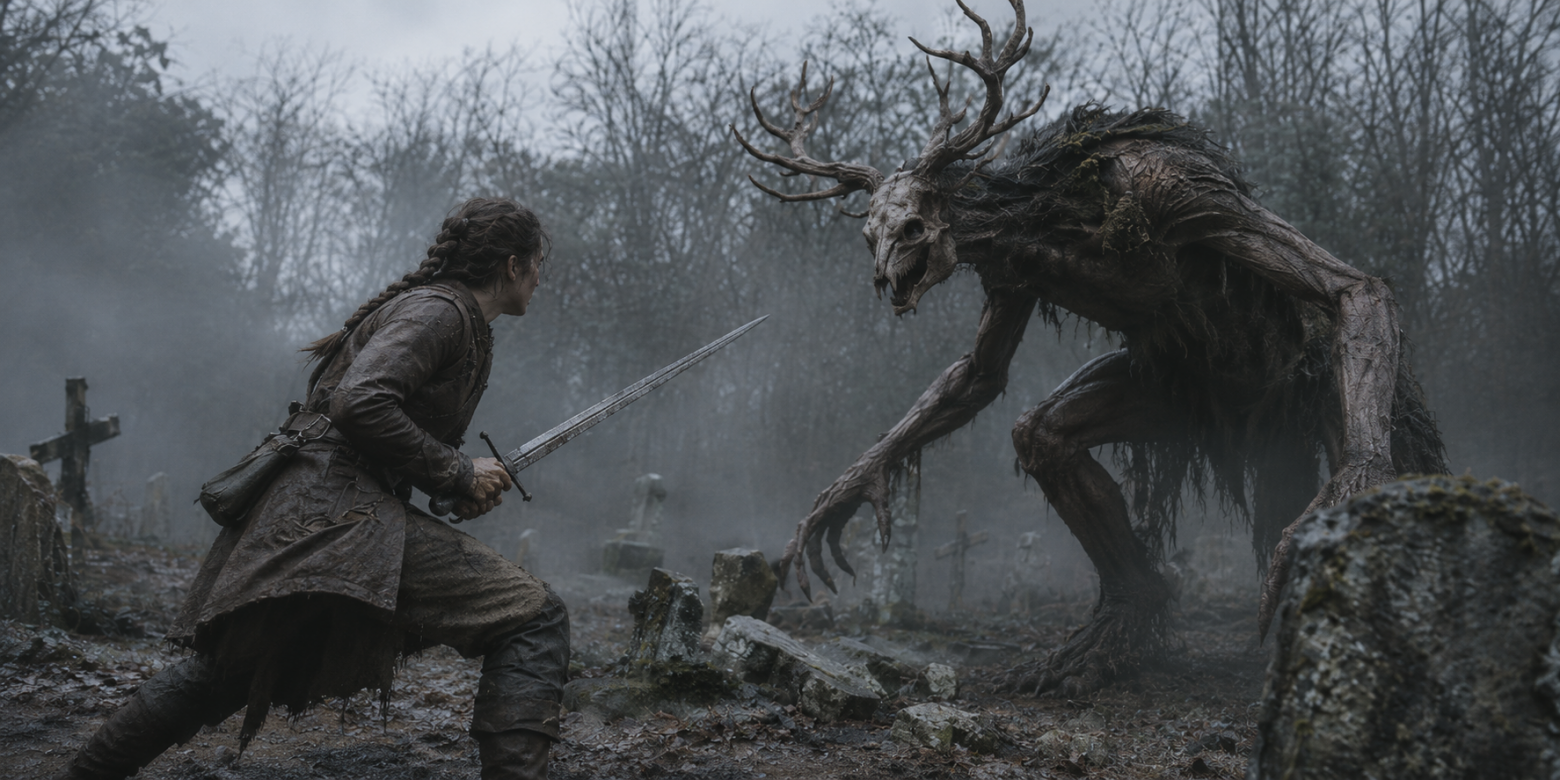
Оживи изображение как точный первый кадр. Сохрани персонажей, оружие, окружение, свет и фотографическую фактуру. Стремительная схватка в реальном времени, один непрерывный план.Монстр резко шагает вперёд, разворачивает плечи и наносит размашистый горизонтальный удар рукой на уровне груди девушки. Рука пересекает место, где она стоит.За мгновение до попадания девушка отскакивает назад. Когти проходят перед ней. Едва коснувшись земли согнутыми ногами, она немедленно отталкивается обратно к противнику, занося меч двумя руками над правым плечом.Во время прыжка вперёд она разворачивает корпус и наносит диагональный рубящий удар по груди монстра. Попадание происходит до приземления и только после реального сокращения расстояния. Клинок продолжает движение по диагонали. Монстр отшатывается и издаёт мощный мучительный рёв.Камера снимает сбоку, коротко отъезжает при уклонении и движется вперёд за контратакой. Связка быстрая и слитная, без зависания в воздухе и замедления. Звук: шаг, свист руки, боевой выдох, попадание клинка и рёв. Без музыки и крупных планов раны.
Итог: сцена состоялась, но отдельные планы получились разного уровня
Первые два фрагмента получились очень хорошими. Крупный план особенно порадовал: выражение лица и русская речь даже лучше того, что удавалось получить внутри перегруженного общего задания. Финальная схватка осталась средней по качеству, но оказалась пригодной для итоговой сборки.
Я соединил фрагменты и получил законченный эпизод. Ниже именно смонтированное видео, а не одна непрерывная генерация: для понимания возможностей модели это существенная деталь.
Итоговая сцена смонтирована из трёх отдельных генераций. Первые два плана удачнее контактного боя
Самый ценный вывод из этой истории — разделение задач действительно помогло. Оно не сделало механику боя безупречной, зато позволило сохранить удачную атмосферу, получить хороший диалоговый план и довести сюжет до результата.
Попробуйте сделать свое видео в Gemini Omni 1.2 Flash
Как пользоваться Gemini Omni Flash: подход, который я оставил после тестов
После этих трёх сюжетов я начинаю работу с выбора исходников и масштаба действия. Вопрос «как сделать видео в Gemini» слишком общий, пока не понятно, нужно оживить готовый кадр, собрать новую сцену или продолжить существующую.
Шаг 1. Выберите, что именно задаёт изображение
-
Стартовый кадр. Видео начинается с конкретной композиции. Подходит, когда уже нравятся свет, лица и расположение объектов.
-
Референс персонажа или предмета. Нужно сохранить человека, одежду или товар, но снять новую сцену.
-
Референс окружения. Изображение задаёт помещение, пейзаж или визуальную подачу.
-
Первый и последний кадры. Нужно связать два состояния. Здесь особенно важно проверить лимит выбранного режима.
Обозначения вроде @image1 зависят от интерфейса. Если сервис вставляет такие метки, используйте их. В другом интерфейсе достаточно указать «первое изображение» и «второе изображение». Главное — правильно назначить файл в самом режиме генерации.
Шаг 2. Опишите изменение, а не повторяйте всё изображение
Для оживления портрета достаточно задать взгляд, эмоцию, реплику, небольшое движение камеры и звук. Заново перечислять форму носа, цвет волос и каждую деталь одежды обычно незачем: это уже видно на исходнике.
А при генерации видео Gemini по одному тексту, наоборот, нужны описание героя, место и свет. Именно отсутствие визуальной опоры в моих ранних фэнтезийных попытках оставляло модели больше свободы в оформлении.
Шаг 3. Дайте действию время
Реплика, глоток и отдаление камеры хорошо раскладываются на последовательность. Бой с уклонением и контратакой требует гораздо более точного совпадения движений. Не стоит считать эти задачи одинаковыми только потому, что обе помещаются в десять секунд текста.
Если несколько движений зависят от точного момента контакта, я теперь рассматриваю отдельные планы заранее. Чем раньше принято это решение, тем меньше попыток уходит на спасение слишком сложной сцены.
Шаг 4. Задайте камеру и звук конкретно
Вместо «сделай кинематографично» полезнее написать: «камера медленно отдаляется от лица до общего вида», «движется вбок вдоль тренировки» или «слегка приближается к лицу во время реплики». Это разные задачи, и они дают понятный критерий проверки.
Если нужен непрерывный план, укажите это. Если нужны склейки, опишите планы отдельно. От одного слова «динамично» модель не узнает, хотите вы бегущую камеру или монтаж из четырёх ракурсов.
Со звуком та же история: язык, точная реплика, характер голоса и фон. В сцене на маяке голос должен оставаться впереди прибоя; в тренировке уместны музыка и выдохи; в бою — шаги, движение оружия и рёв.
Шаг 5. Проверяйте не только красоту
Перед скачиванием финала я смотрю видео целиком со звуком, а затем проверяю спорные моменты на паузе:
-
сохранились ли лицо, одежда и предметы;
-
совпадает ли русская реплика с заданием;
-
не меняется ли свет при смене плана;
-
смотрит ли герой туда, где находится объект его внимания;
-
соответствует ли попадание оружия реальному расстоянию;
-
сохраняется ли ощущение веса и нормальной скорости.
Такой просмотр быстро отделяет удачный ролик от красивого фрагмента с ошибкой, которая мешает использованию.
Какие видео можно создавать, кроме наших трёх примеров
Gemini Omni полезна не только для атмосферных сцен. Её сильная практическая сторона — сочетание визуальных исходников, движения и звука в одном рабочем процессе.
|
Сценарий |
Как подойти к задаче |
Что проверить |
|
Ролик о товаре |
Загрузить предмет, задать окружение и движение камеры |
Форму, логотип, материал и мелкие детали |
|
Образ или спортивный комплект |
Разделить референсы человека, одежды и места |
Посадку одежды, цвета, надписи и поведение ткани |
|
Говорящий персонаж |
Использовать портрет, короткую реплику и определённую эмоцию |
Произношение, движения губ и естественные паузы |
|
Архитектура и путешествия |
Показать пространство одним понятным маршрутом камеры |
Геометрию здания, масштаб и непрерывность движения |
|
Объясняющий ролик |
Разделить мысль на несколько визуальных событий |
Правильность содержания и читаемость надписей |
|
Доработка готовой сцены |
Попросить конкретное изменение фона, света или объекта |
Не изменились ли удачные части вместе с правкой |
Последовательное редактирование позволяет продолжать работу с полученным клипом: например, менять освещение или предмет в сцене. Но возможность сделать правку не равна гарантии сохранить каждый пиксель. После неё тоже нужен просмотр.
Работу со звуком стоит разделять на две вещи. Получить новую речь вместе с видео и загрузить образец собственного голоса — разные функции. В моих примерах использовалась генерация русской речи по тексту. Доступ к голосовым референсам и аватарам зависит от продукта; обычную загрузку аудио нельзя считать универсальной возможностью любого интерфейса Omni.
Бенчмарки Gemini Omni 1.2 Flash: где модель находится относительно конкурентов
Мой опыт объясняет, как модель ведёт себя в конкретных сценах. Для более широкого сравнения полезны слепые попарные оценки: зрители выбирают понравившийся результат, а из голосов формируется рейтинг.
В доступном срезе Arena с датой обновления 8 ноября 2026 года Omni 1.2 Flash занимает первую строку и в Text-to-Video, и в Image-to-Video. На момент подготовки статьи 16 ноября обе оценки новой модели отмечены как предварительные.
|
Модель |
Text-to-Video |
Image-to-Video |
|
1540 ± 16 |
1503 ± 12 |
|
|
Gemini Omni 1.1 Flash |
1513 ± 15 |
1487 ± 11 |
|
Seedance 2.5, 720p |
1479 ± 8 |
1494 ± 8 |
|
1456 ± 8 |
1493 ± 6 |
|
|
1476 ± 12 |
1482 ± 11 |
У Omni 1.2 в этом срезе 1714 голосов в генерации по тексту и 2666 — по изображению. Это рейтинговые баллы, а не проценты правильно выполненных заданий. Интервалы неопределённости пересекаются, особенно в Image-to-Video, поэтому небольшую разницу нельзя превращать в обещание превосходства в любом сюжете.
Что изменилось относительно 1.1
Во внутренних попарных сравнениях Google версия 1.2 чаще выигрывает у 1.1 по нескольким практическим критериям:
-
Визуальная согласованность генерации по тексту: 62% побед против 38%.
-
Сохранение идентичности референса в Image-to-Video: 60% против 40%.
-
Общее предпочтение в Reference-to-Video: 63% против 37%.
Это доли побед в конкретном сравнении двух версий. Если сказать — «качество выросло на 63%» это было не отражало реальную ситуации. Чтобы понять смысл лучше скажу так: новая версия чаще даёт предпочтительный результат, особенно в задачах согласованности, но по-прежнему нуждается в проверке сложного действия.
Мои ролики хорошо иллюстрируют эту разницу. Сохранение визуального образа и хорошая речь могут сочетаться с ошибками контакта в схватке. У модели нет одной универсальной оценки «умеет всё одинаково хорошо».
Gemini Omni: официальный сайт, регистрация и выбор способа работы
Отдельный аккаунт именно для Omni создавать не нужно: это модель внутри продуктов. Основные официальные входы — приложение gemini.google.com, видеосреда flow.google.com, Google Vids и Google AI Studio. Для разработчиков доступна работа через API.
Как зарегистрироваться и запустить первое видео
-
Войдите в аккаунт Google. Если его нет, создайте аккаунт на этапе входа в выбранный продукт.
-
Выберите интерфейс. Для работы со сценами удобно начать с Flow, для генерации в чате — с Gemini.
-
Проверьте доступ к видео и активную модель. Наличие обычного текстового чата само по себе не определяет доступный видеорежим.
-
Выберите способ генерации. По тексту, из стартового кадра или по референсам.
-
Установите формат и длительность. До запуска посмотрите стоимость или расход кредитов.
-
Загрузите исходники и отправьте промпт. После генерации проверьте движение, звук и соответствие заданию, затем скачайте результат.
В приложении Gemini для личного аккаунта нужен план Google AI. Доступная длина зависит от подписки: до 10 секунд либо до 15 секунд на Ultra. Функция предназначена для пользователей от 18 лет. В Flow условия отличаются: у платных планов доступны более длинные генерации и дополнительные операции.
Какой вариант рассмотреть пользователю из России
При выборе официального продукта сначала проверьте доступность для своей страны и аккаунта, а также способ оплаты. Регистрация Google не гарантирует, что конкретный видеорежим окажется доступен.
Ещё один путь — агрегатор с подключённой моделью. Например, Gemini Omni 1.2 Flash есть в Study AI. Перед запуском смотрите на точное название версии (в этом агрегаторе очень много разных генераторов видео, не перепутайте).
Сколько стоит создание видео в Gemini Omni Flash 1.2
Базовая стоимость видеовывода в Gemini API составляет примерно $0,07 за секунду 720p — примерно на 30% ниже, чем у версии 1.1. Полный счёт зависит также от входных данных и других учитываемых токенов, поэтому цена ниже — ориентир именно для видеовывода.
|
Режим вывода |
Около за секунду |
Видео на 10 секунд |
Видео на 15 секунд |
|
360p |
$0,023 |
$0,23 |
$0,35 |
|
720p |
$0,070 |
$0,70 |
$1,04 |
|
1080p, повышение разрешения |
$0,104 |
$1,04 |
$1,56 |
|
4K, повышение разрешения |
$0,209 |
$2,09 |
$3,13 |
Значения округлены; расчёт опирается на токенизацию вывода, поэтому 15 секунд 720p дают около $1,04, а не ровно $1,05. Подписки Google, кредиты Flow и тарифы агрегаторов считаются отдельно — переносить цену API на их интерфейсы нельзя.
Для меня после боя главный показатель — стоимость пригодного фрагмента. Один недорогой дубль не так интересен, если до него пришлось сделать несколько неудачных. Когда речь и лицо уже получились, выгоднее сохранить этот план и отдельно работать над действием.
Можно ли попробовать бесплатно
В Google Vids предусмотрено до трёх 15-секундных видео в месяц без дополнительной платы для пользователей с аккаунтом Google. Доступ зависит от региона и условий аккаунта. В API у Omni 1.2 Flash бесплатного уровня генерации нет.
Бесплатные возможности разных продуктов не объединяются в один общий лимит «Gemini». Перед началом проверьте, в каком именно приложении вы работаете и какой режим выбран.
Для каких задач я оставлю Gemini Omni в работе
После этих тестов мне хочется использовать Gemini Omni прежде всего для коротких сцен с человеком, русской речью, выразительным окружением и подготовленными исходниками. Маяк — хороший пример: ролик держится на голосе, лице и раскрытии пространства, а не на количестве эффектов.
Второе направление — сборка сцены из человека, одежды и места. Тренировка показала полезный принцип: вместо длинного описания всего мира можно загрузить нужные составляющие и объяснить их роли.
Сложный экшен я теперь планирую по кадрам. Бой удалось довести до пригодного результата, причём первые два плана получились очень хорошо. Но контактный удар потребовал больше работы и остался слабее. Для меня это не повод отказываться от модели — это причина правильно выбирать объём задачи на одну генерацию.
Начните с одной сцены, где понятно, что должно произойти. Подготовьте изображение, задайте действие, камеру и звук. Если хороший момент уже получился, сохраните его: следующую сложную часть можно сделать отдельно, как я в итоге и поступил с боем.
ссылка на оригинал статьи https://habr.com/ru/articles/1108742/