Эта статья перевод оригинальной статьи «Introducing GPT-6.2 Astra and Sol».
Также я веду телеграм канал «Frontend по‑флотски», где рассказываю про интересные вещи из мира разработки интерфейсов и AI.
Вступление
Новый стандарт для профессиональных задач
Мы представляем GPT-6.2 Astra, нашу новую флагманскую модель для самых трудных проектов, и GPT-6.2 Sol, экономичную универсальную модель для повседневной работы. Обе лучше справляются со сложными задачами и тратят меньше выходных токенов. Это позволяет выполнить больше задач в пределах действующих лимитов, а компаниям и разработчикам даёт доступ к возможностям передовых моделей по цене, с которой можно масштабировать использование.
GPT-6.2 Astra лучше справляется со сложной профессиональной работой. Слайды, таблицы и документы выглядят естественнее и точнее следуют предоставленным шаблонам и правилам отрасли. Модель пишет более чистый код и улучшает внешний вид и работу интерфейсов, особенно в сайтах, играх и проектах с 3D.
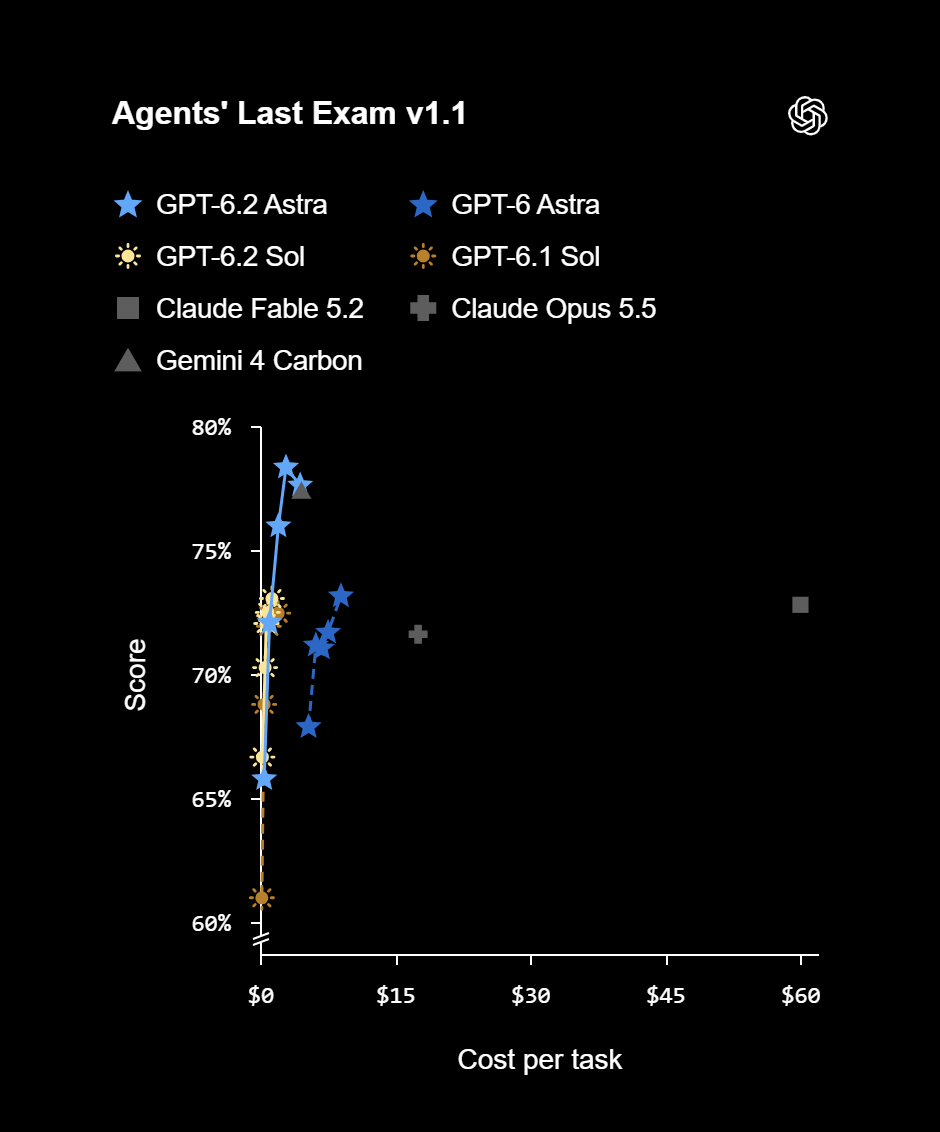
В Agents’ Last Exam v1.1, где модель выполняет длительные профессиональные задачи в несколько этапов, GPT-6.2 Astra показала лучший результат. Она набрала на 5,2 балла больше GPT-6 Astra при стоимости менее трети от стоимости GPT-6 Astra и опередила Claude Fable 5.2 на 5,5 балла, потратив 5% от стоимости работы Fable. В рейтинге Fable 5.2 не учитываются девять заданий, в которых использовалась резервная модель.
График: Agents’ Last Exam v1.1
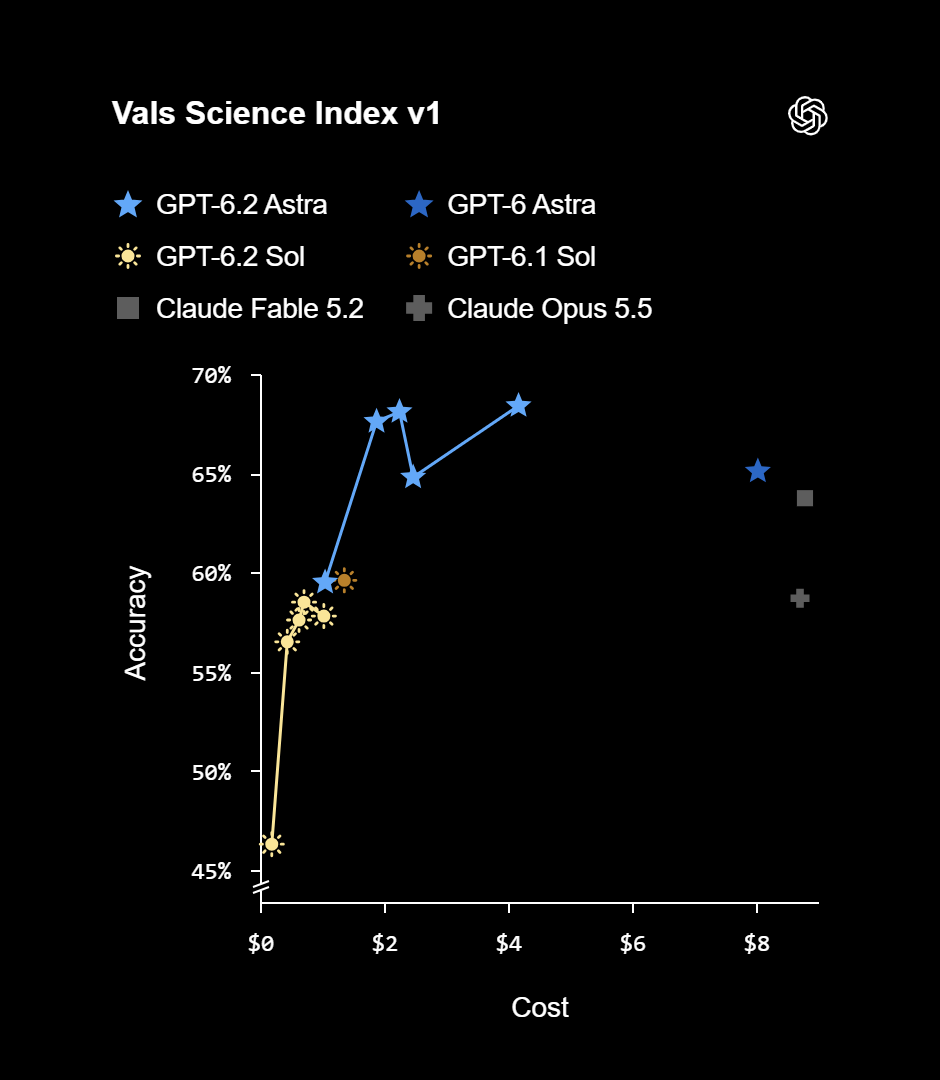
По нашей оценке, GPT-6.2 Astra лучше других моделей подходит для научной работы. Она показала лучший результат в Terminal-Bench-Science 0.1, где модели проводят исследования в терминале ¹. Её результат на 9 процентных пунктов выше, чем у GPT-6 Astra, при стоимости менее трети от стоимости GPT-6 Astra. Astra также лидирует в Vals Science Index v1, который с равным весом учитывает анализ реальных биологических данных, понимание работы моделируемых систем по результатам экспериментов и выполнение исследовательских задач.
График: Terminal-Bench-Science 0.1
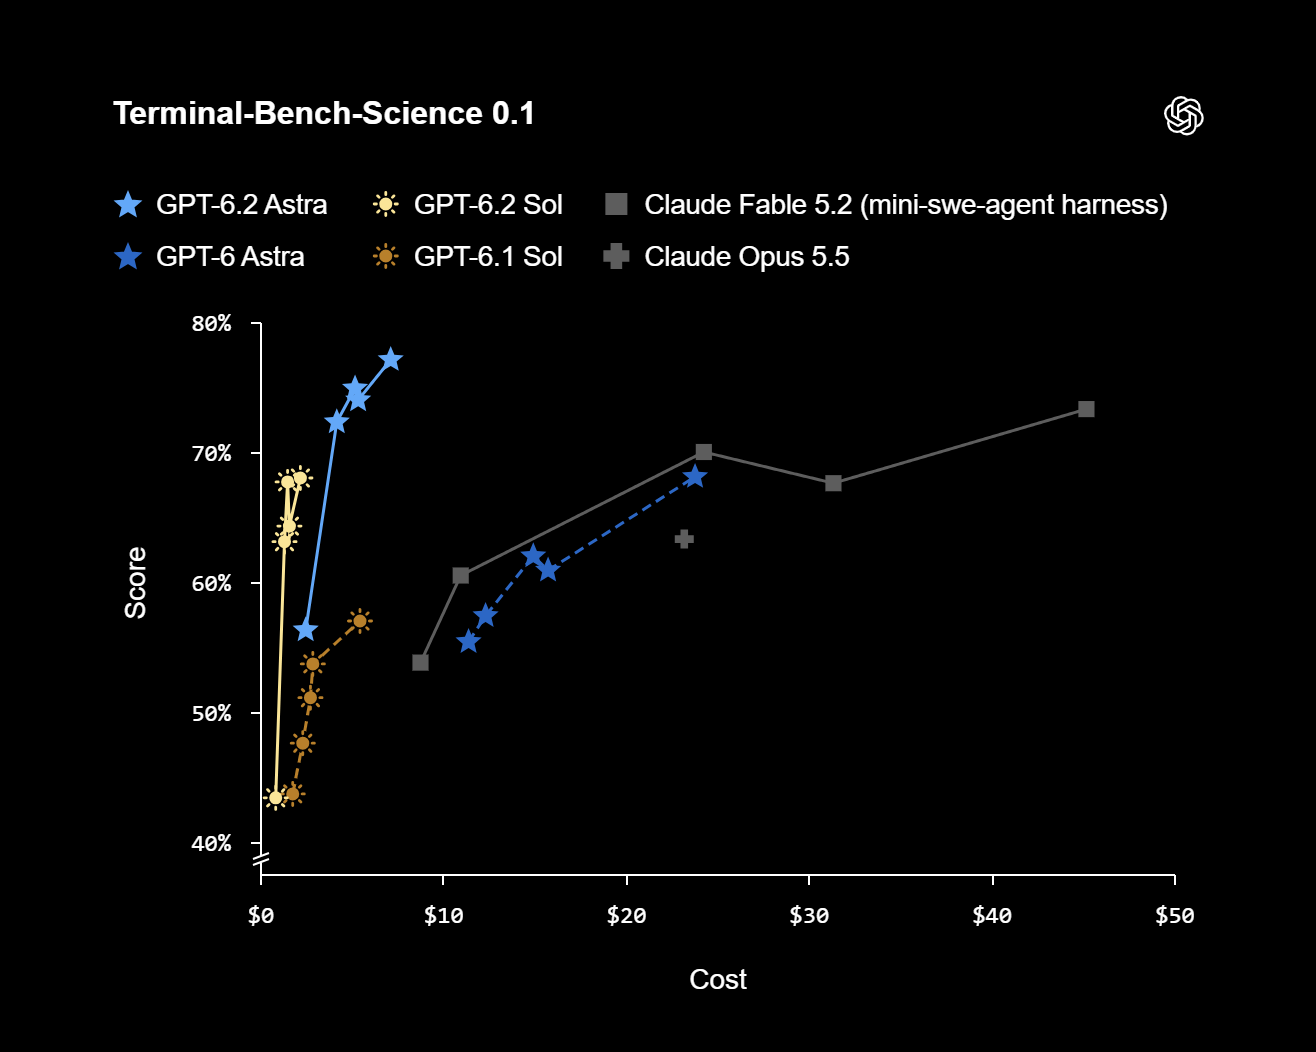
График: Vals Science Index v1
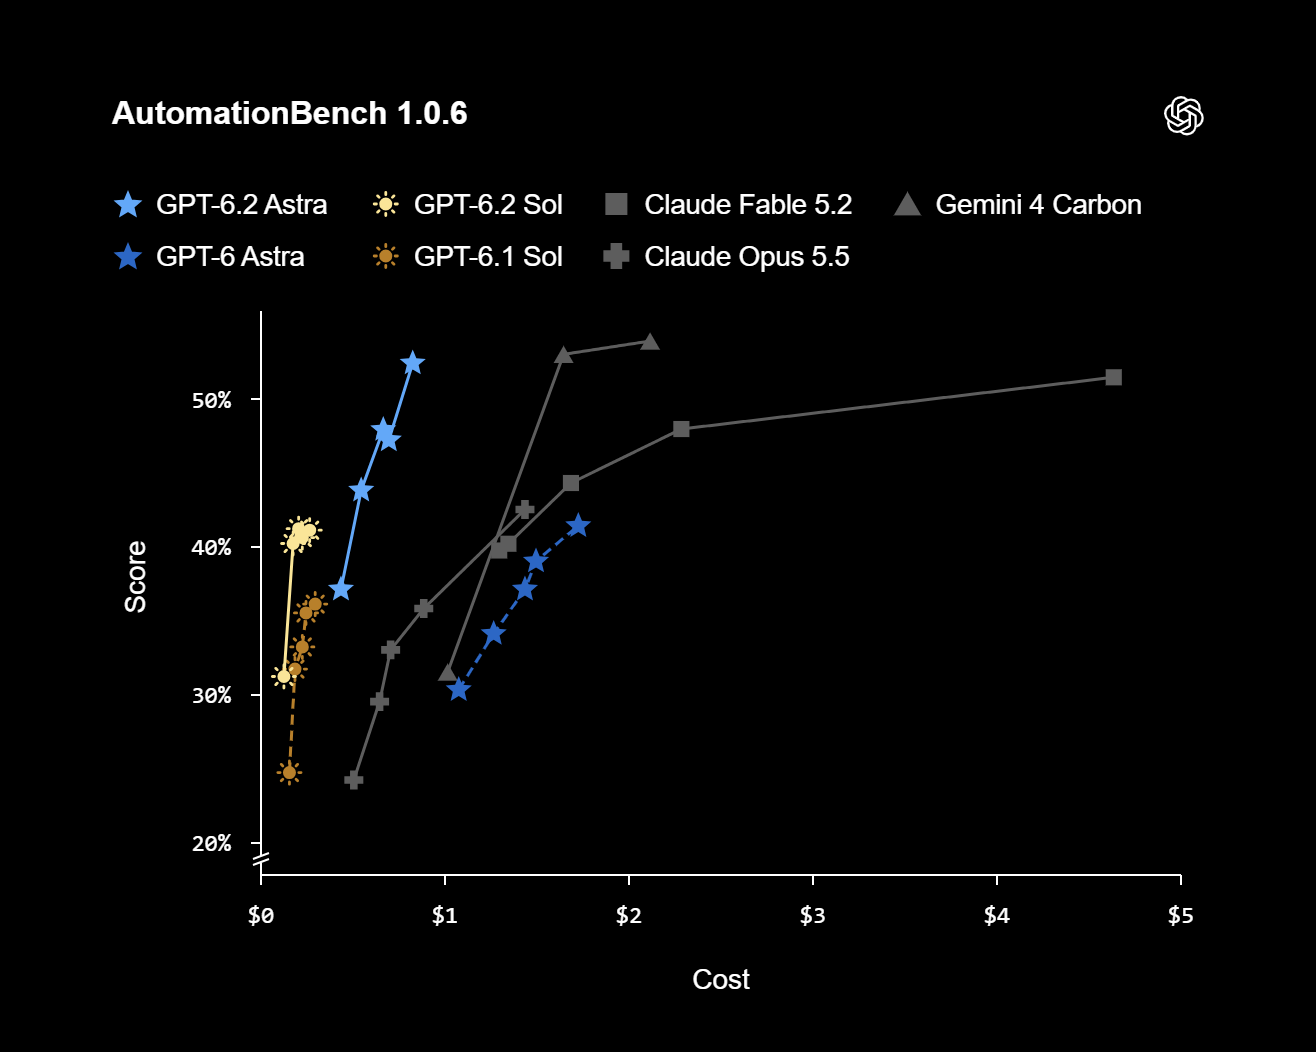
В API входные и выходные токены GPT-6.2 Astra стоят на 20% дешевле, чем у GPT-6 Astra, а кешированные входные токены подешевели на 60%. За миллион токенов мы берём $8 на входе, $0,40 за кешированный вход и $40 на выходе. GPT-6.2 Sol сохраняет цены GPT-6.1 Sol. В нескольких тестах обе модели приблизились к результатам других ведущих моделей или превзошли их при значительно меньшей стоимости задачи.
Artificial Analysis Intelligence Index v5.0.1 объединяет девять тестов на интеллектуальную работу, программирование, науку и общие знания. BenchCAD 2.1 Core проверяет, может ли модель построить 3D-детали по чертежам и собрать их. AutomationBench 1.0.6 оценивает рабочие задачи в продажах, маркетинге, операционной деятельности, поддержке, финансах и HR.
График: Artificial Analysis Intelligence Index v5.0.1
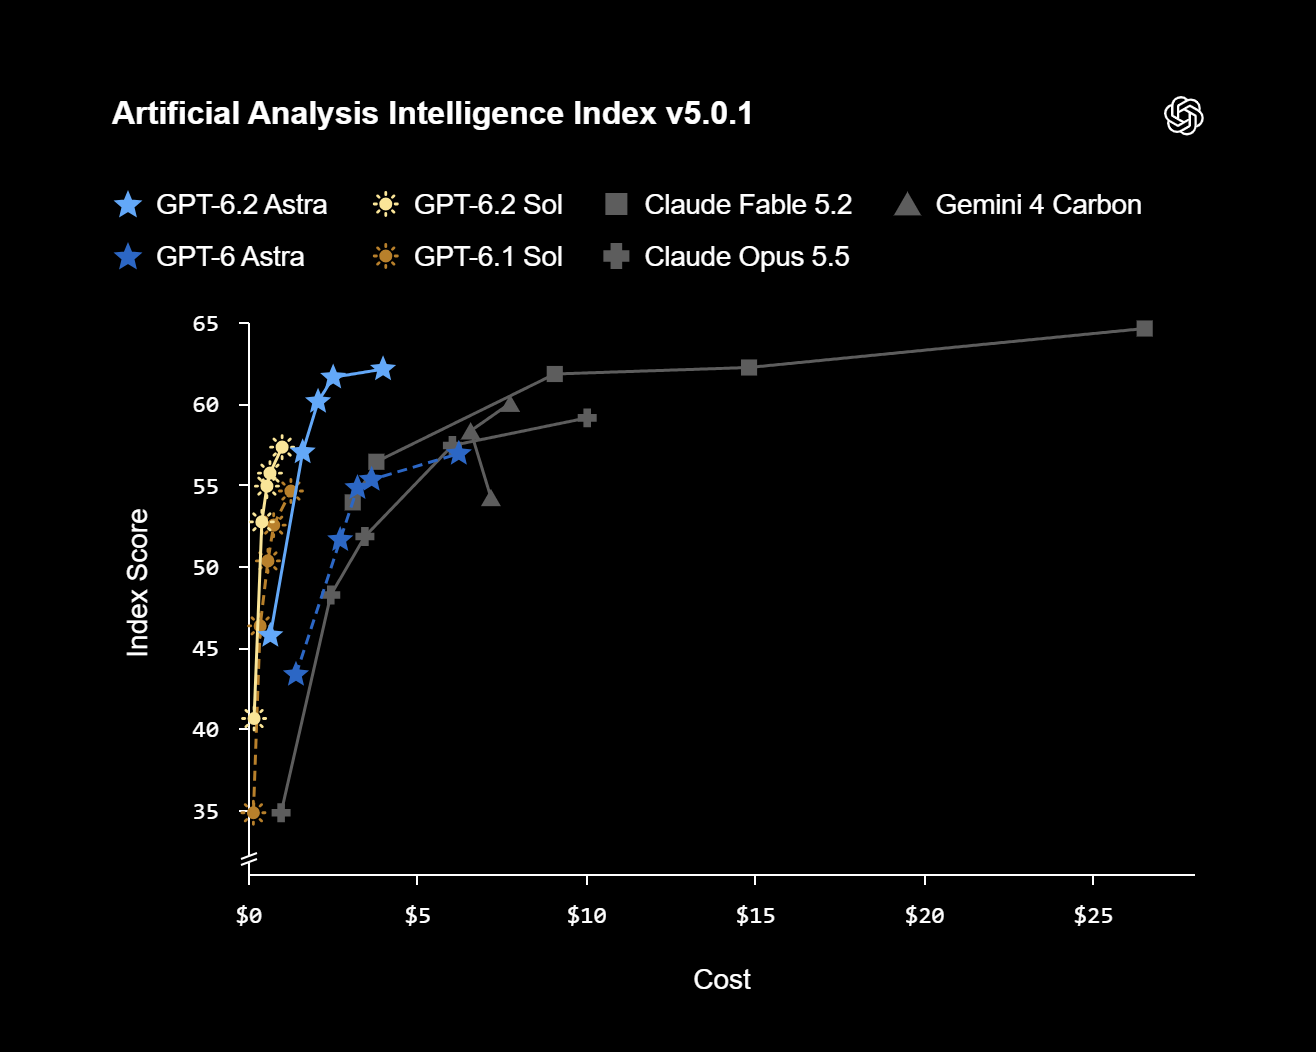
График: BenchCAD 2.1 Core
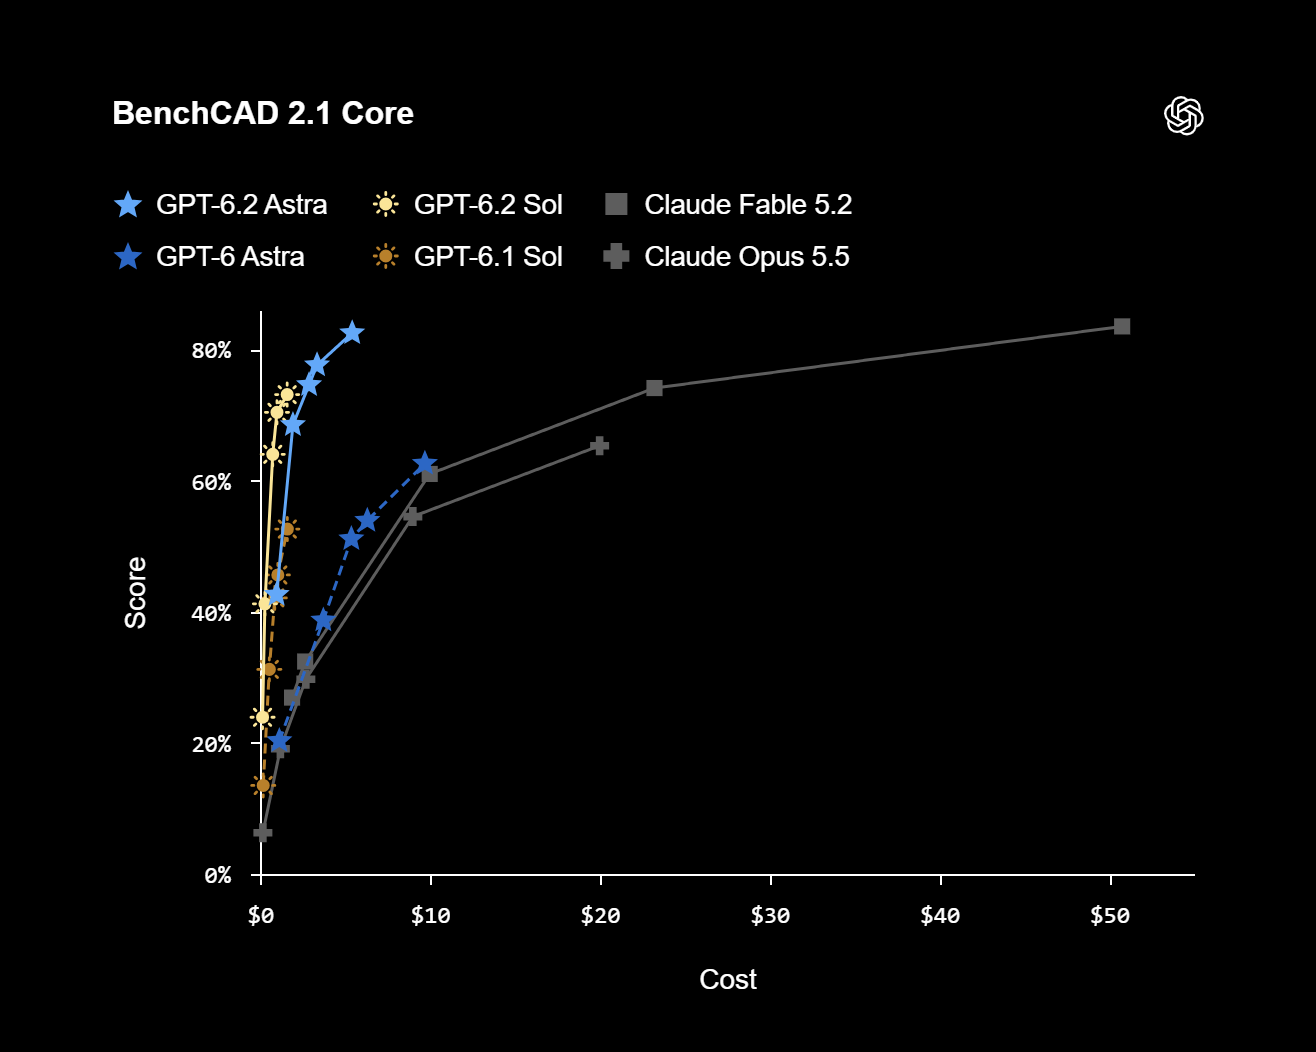
График: AutomationBench 1.0.6
GPT-6.2 Sol для повседневной работы
По сравнению с GPT-6.1 Sol новая модель лучше решает задачи, расходует меньше токенов и позволяет выполнить больше работы на том же платном тарифе. Она справляется с задачами, в которых агенту нужно сделать несколько шагов, пишет ясно и естественно, а взаимодействовать с ней удобно. Многие сотрудники OpenAI используют её по умолчанию для технических и нетехнических задач.
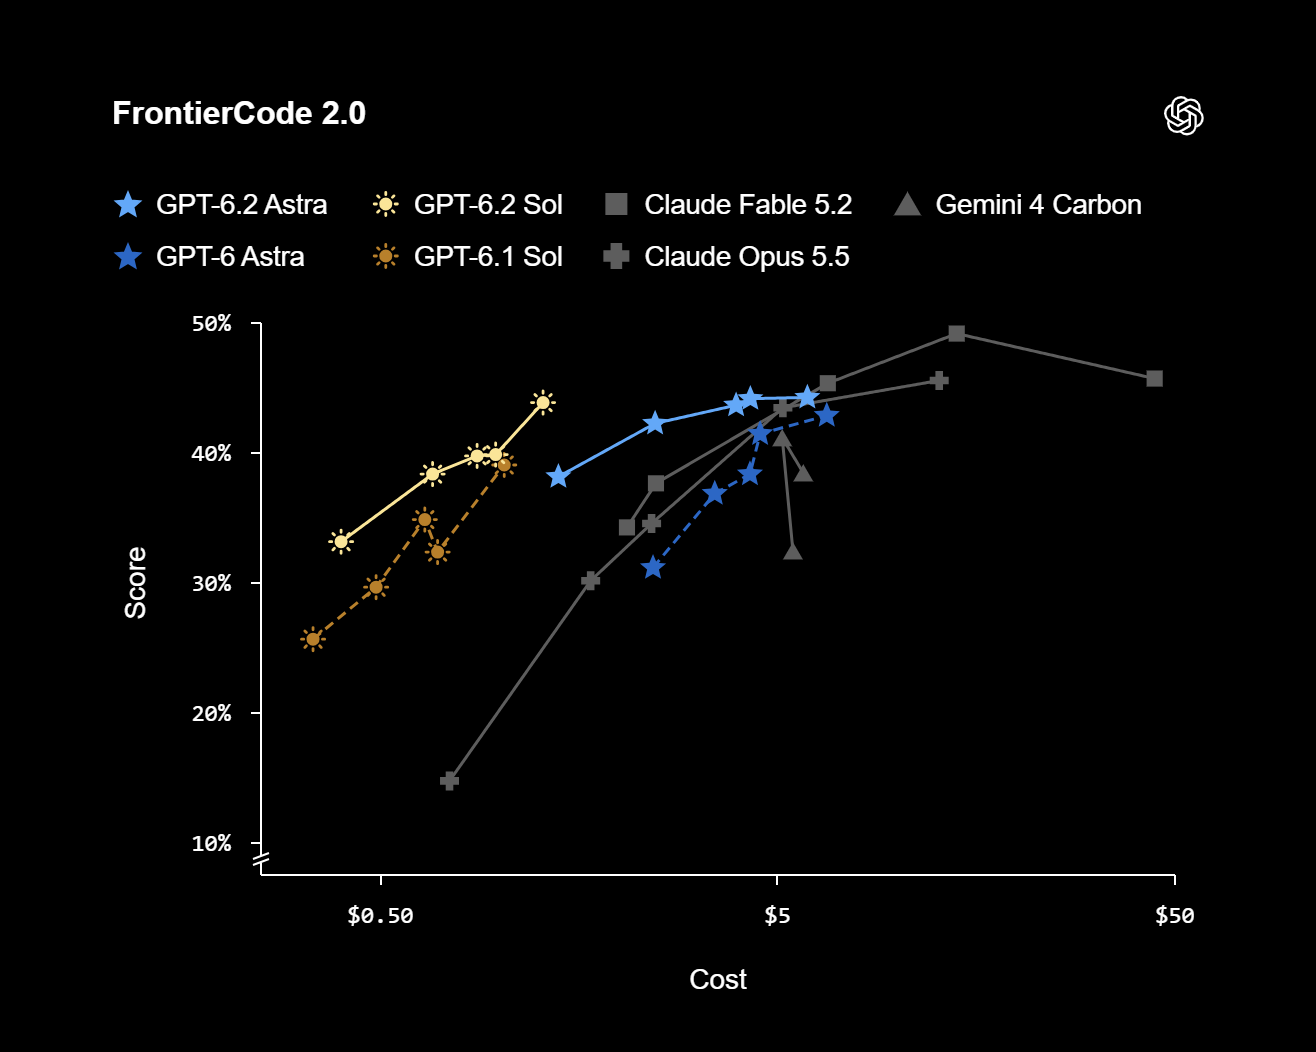
В FrontierCode 2.0 от Cognition GPT-6.2 Sol отстаёт от GPT-6.2 Astra на 0,5 балла при стоимости около одной пятой. Обе модели тестировали на уровне рассуждения max. FrontierCode 2.0 проверяет, соответствуют ли изменения в реальных проектах требованиям сопровождающих кода при слиянии.
График: FrontierCode 2.0
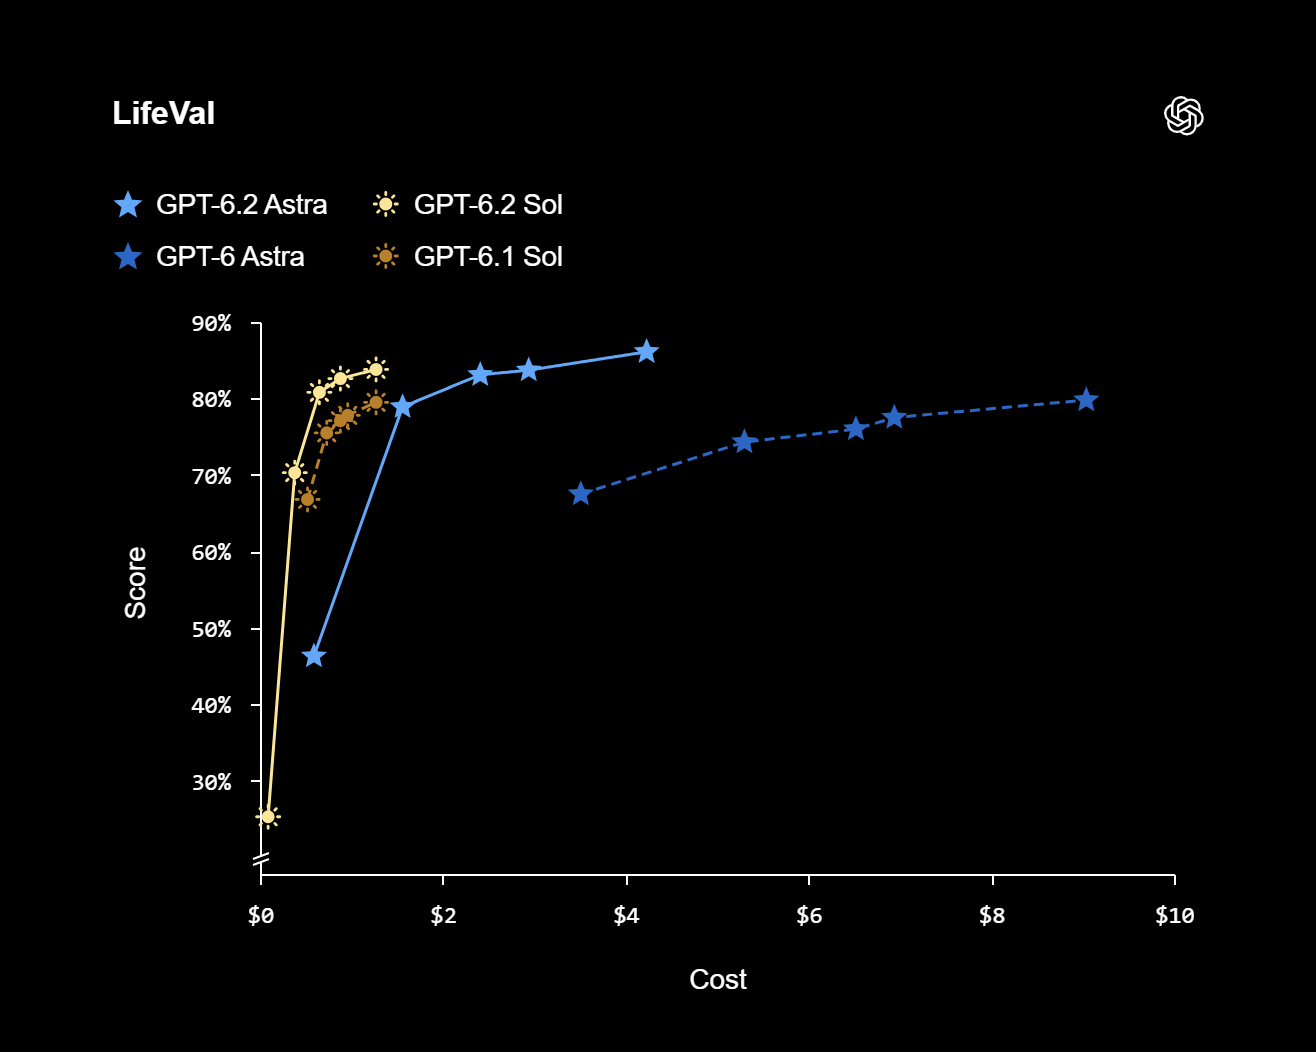
Скорость и качество Sol пригодятся и в повседневных делах. В недавно вышедшем тесте LifeVal GPT-6.2 Sol обошла GPT-6 Astra при стоимости около одной седьмой. LifeVal проверяет задачи с учётом обстоятельств конкретного человека. Например, модели подбирают детские сады после переезда, ищут жильё с учётом бюджета семьи и дороги до работы или планируют питание для родителя, которому недавно поставили диагноз.
График: LifeVal
Документы по отраслевым стандартам
Мы обучили GPT-6.2 Astra создавать понятные слайды, таблицы и документы, которые ближе к тому, как работают специалисты в праве, продажах, финансах и бухгалтерии. Текст стал конкретнее, в нём меньше общих выводов и лишних слов.
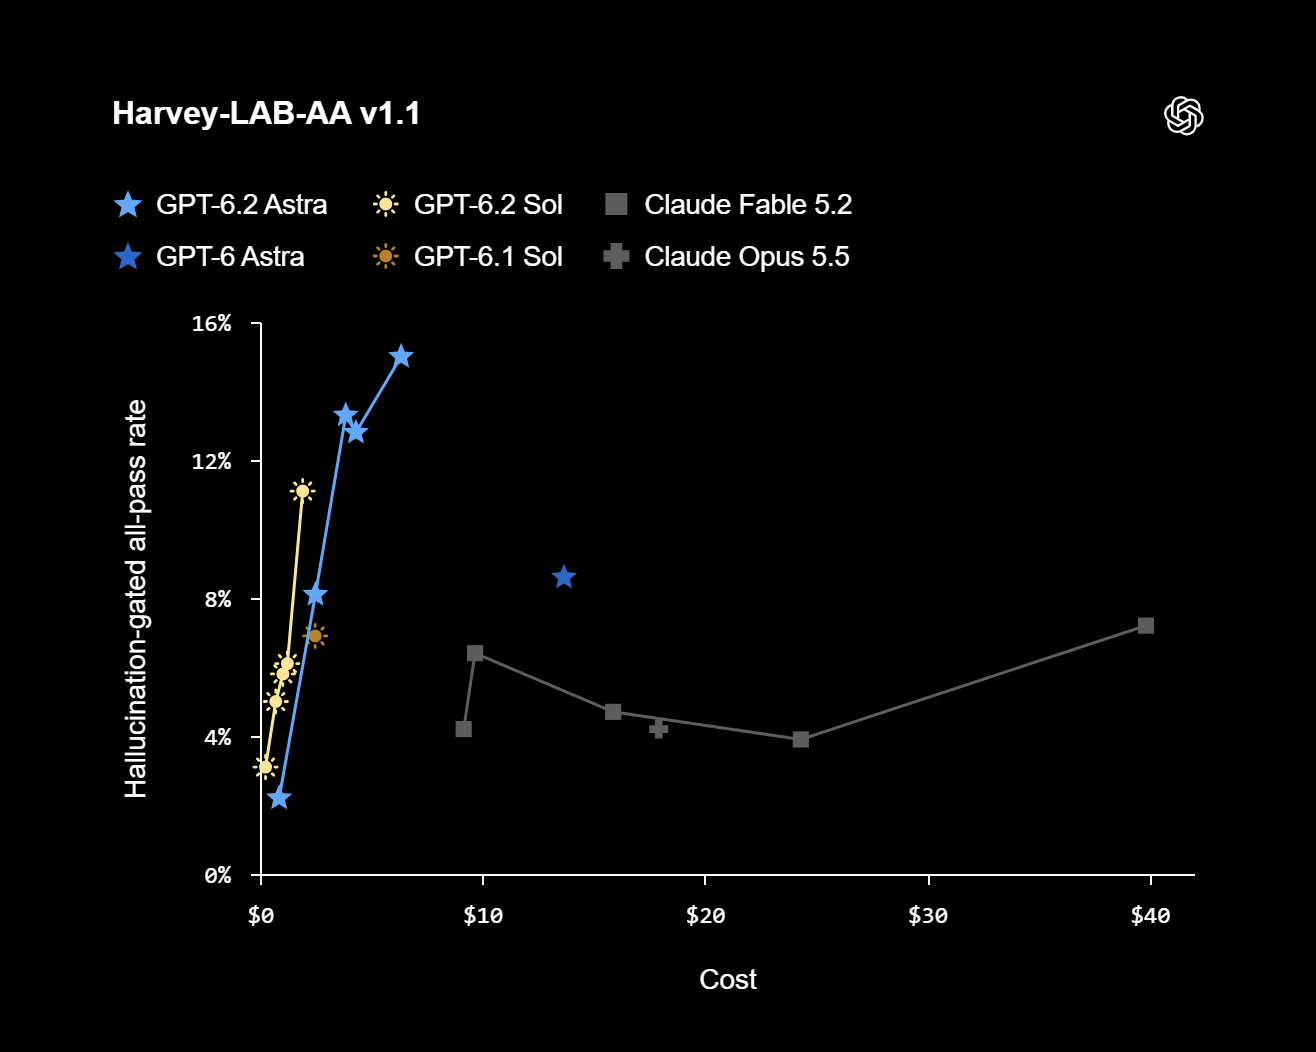
В Harvey LAB-AA v1.1 модели ищут факты в исходных документах и применяют их по подробному заданию. В тесте есть, например, проверка условий договоров. Задание засчитывается, только если результат соответствует всем критериям и не содержит существенных выдуманных сведений. GPT-6.2 Astra показала лучший результат. Доля успешно выполненных заданий более чем вдвое выше, чем у Claude Fable 5.2, при стоимости около одной шестой. Astra for Law, наша конфигурация GPT-6.2 Astra для юристов, набрала ещё больше.
График: Harvey LAB-AA v1.1
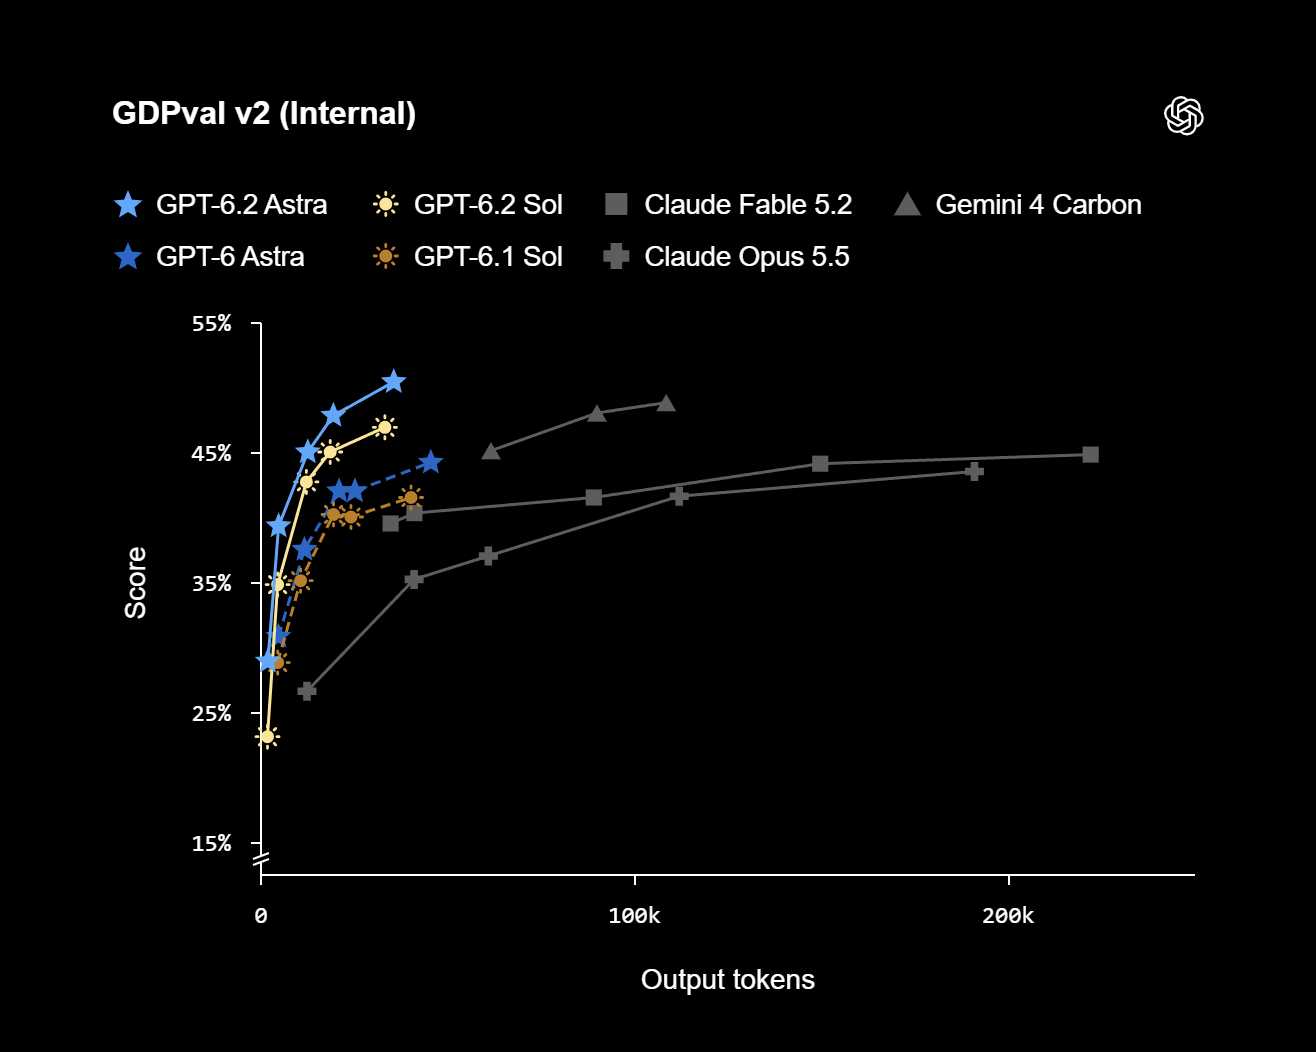
Внутренний GDPval v2 развивает GDPval. Он оценивает сложную и длительную работу над реальными проектами из финансов, анализа данных, биотехнологий и маркетинга. Среди протестированных моделей лидирует GPT-6.2 Astra. Она набрала на 6,2 процентного пункта больше GPT-6 Astra и потратила на 22% меньше выходных токенов. GPT-6.2 Sol прибавила 5,3 пункта по сравнению с GPT-6.1 Sol. В тесте есть задания из консалтинга, финансов и дизайна. Моделям дают файлы и сообщения, которые команды имели на момент постановки задачи.
График: GDPval v2
Презентации
GPT-6.2 Astra лучше предыдущих моделей оформляет слайды по исходному файлу или даже по скриншоту. Она воспроизводит композицию, цвета и типографику вплоть до точного размера шрифта, а в новых слайдах сохраняет манеру изложения из шаблона. Первым тестировщикам требовалось меньше правок. Заголовки сразу передавали главный вывод, а основной текст оставлял нужные читателю детали.
-
В квартальном отчёте обе модели обновили публичную презентацию ретейлера за первый квартал, опираясь на отчёт за второй квартал и форму 10-Q. Обе определили, что главным источником роста прибыли стали возвраты таможенных пошлин. GPT-6.2 Astra вынесла в заголовок рост продаж на 5,3%, отдельно показала динамику онлайн и в магазинах и предложила руководству следить за запасами ходовых товаров и планировать бюджет без дальнейших возвратов.
-
В задании по шаблону потребовалось сделать слайд о состоянии сделки Alder Street по приложенному изображению. GPT-6.2 Astra точно воспроизвела размеры шрифтов и отступы горизонтальной шапки. GPT-6 Astra подобрала цвета, но ей хуже далось остальное оформление. Таблица GPT-6.2 Astra компактнее, в ней яснее указаны ответственные и сроки.
-
Обе модели подготовили карту рынка женской одежды в сегменте доступной роскоши. GPT-6.2 Astra добавила логотипы или текстовые знаки, короткие описания стилей, ценовые диапазоны по выборке американских розничных цен, а также фото и цены шести платьев. GPT-6 Astra распределила бренды по стилю и относительным ценам. У большинства брендов не было логотипов, часть текста попала на линии сетки, а служебная пометка о шести подчёркнутых брендах осталась на слайде.
-
По публичному шаблону OpenAI модели предложили мерч с животными для четырёх команд. GPT-6.2 Astra оформила коллекцию как иллюстрированный полевой справочник с шутками для каждой команды и одинаковой вёрсткой для сравнения маскотов. Она показала все восемь вариантов на эмалированных значках, футболках и вышитых нашивках на рюкзак. В макетах GPT-6 Astra был один вариант на команду. GPT-6.2 Astra также подготовила векторные файлы, предложила размеры для каждого варианта и носителя и описала, как сверять цвета и утверждать образцы.
Таблицы и записки
Чтобы оценить компанию в таблице или составить инвестиционную записку, нужно найти цифры в исходных файлах и разобраться, как они связаны. AA-AnalystAgent от Artificial Analysis проверяет это на реальных таблицах и отчётах. В одном задании модели рассчитывают по отчётам калифорнийской программы Medicaid расходы на медицинский транспорт. GPT-6.2 Astra показала лучший результат, правильно ответив на 62,5% вопросов во всех пяти независимых попытках.
В примере с финансовым прогнозом обе модели получили одинаковую отчётность, операционные предпосылки и рыночные данные вымышленной агротехнологической Alderfen Field Systems. От них требовалось подготовить редактируемую книгу Excel с прогнозом выручки по сегментам до 2031 года и проверкой согласованности трёх форм отчётности. Книга должна была оценить стоимость на разводнённую акцию при ставке дисконтирования 8% и постоянном темпе роста 3%, показать, какой рост оправдал бы ориентир по цене акции, и отразить чувствительность оценки к этим предпосылкам.
GPT-6.2 Astra разместила структуру выручки и переход от стоимости компании к стоимости акции рядом с таблицей чувствительности. Видно, какие направления определяют прогноз и как в расчёт цены входят дисконтированные денежные потоки, денежные средства, инвестиции и разводнённое количество акций. GPT-6 Astra вынесла разбивку выручки на отдельную вкладку, а переход к стоимости акции поместила ниже на листе.
В другом примере модели сравнили в Excel семь приобретений американских разработчиков ПО по открытым данным и свели результаты на одном слайде в готовой презентации. GPT-6 Astra отметила прогноз роста выручки как недоступный и показала все сделки одним цветом. GPT-6.2 Astra нашла оценки роста для четырёх из семи компаний и выделила Paycor ярко-синим. Среди семи сделок это была единственная покупка корпоративным покупателем. Остальные шесть провели фонды прямых инвестиций. Так видно, что Paychex заплатила ниже медианы, 21,7 × EBITDA. Подзаголовок GPT-6.2 Astra точнее передал главный вывод.
В примере Shared Bills обе модели написали руководству записку о вымышленном трёхнедельном тесте баннера для функции, которая позволяет друзьям делить покупки по карте. GPT-6.2 Astra начала с вывода, нужного для решения о запуске: «Мы не обнаружили явного роста числа переводов между пользователями или операций по карте». GPT-6 Astra сначала сообщила о росте числа транзакций Shared Bills на 42,9%, а уже потом описала неопределённость. Записка GPT-6.2 Astra реалистичнее, лучше связывает выводы с данными и обходится без шаблонных оборотов вроде «Это прогнозы для планирования, а не новые доказательства».
Для проверки готовности к SOC 2 моделям дали синтетические данные вымышленной Atlas Health. У компании было шесть недель, чтобы собрать документы, в том числе подтверждения того, как она управляет изменениями в системах и проверяет поставщиков. GPT-6.2 Astra подготовила точный, хорошо организованный и аккуратно оформленный результат, который легко проверить.
Мы проверяли GPT-6.2 Astra на задачах, где из плотного массива информации нужно сделать понятные записки и инфографику для технических и нетехнических читателей. Среди примеров были биржевые сводки и схемы процессов с участием агентов. Документы GPT-6.2 Astra заметно лучше, чем у GPT-6 Astra. Текст и графики помогали быстрее найти главное, а схемы объясняли, как взаимодействуют части сложной системы.
Маркиз Вонг, ведущий инженер по ИИ, IMC
В наших тестах агентов GPT-6.2 Astra потратила на 62% меньше токенов, чем GPT-6.1 Sol, на сложных юридических задачах. Лучше всего ей дались правовые исследования. Она опередила другие модели в восьми из десяти задач по налогам, сделкам M&A и судебным спорам.
Якоб Лауритцен, технический директор Legora
В наших тестах GPT-6.2 Astra выполнила более чем втрое больше задач Legal Agent Benchmark, чем GPT-6 Astra, потратив на 34,5% меньше выходных токенов. Во внутренних записках она замечала больше слабых мест в позиции клиента, а в проектах судебных документов допускала меньше необоснованных уступок.
Нико Групен, руководитель прикладных исследований Harvey
В слепом тесте приложений, дашбордов и слайдов, которые ClickUp Brain создаёт в рабочем пространстве, GPT-6.2 Astra немного обошла нашу рабочую модель. Она потратила примерно на 40% меньше токенов и потребовала на 30% меньше раундов проверки.
Джей Хэк, руководитель направления ИИ в ClickUp
Работа с компьютером и интерактивный веб-дизайн
GPT-6.2 Astra точнее управляет компьютером и может работать с отдельными деталями и соединениями в CAD и инструментах моделирования. Инженеры могут проверить, как детали стыкуются, проследить за перераспределением нагрузки в движении и испытать изменения до изготовления прототипа.
Симуляция движения автомобиля
Мы попросили GPT-6.2 Astra показать динамику шасси автомобиля на горной дороге. Astra построила 3D-модель, написала на Python решатель для моделирования взаимодействия шин и подвески и анимировала результаты в Blender. Инженеры могут быстрее проверять новые конструкции и уточнять модели.
Родстер на горной дороге. Рядом показаны ход передней и задней подвески, пятна контакта шин и действия водителя.
Проектирование и сборка механизмов
GPT-6.2 Astra моделирует механизмы по деталям. Это позволяет показать порядок сборки и проверить, как переделка конструкции повлияет на её поведение.
По открытым фотографиям и инструкциям модель воспроизвела детали радиоуправляемого багги и двигателя, сделала анимированную инструкцию по сборке и подготовила иллюстрированный каталог запчастей. Такой подход ускоряет разработку и подготовку документации.
Набор радиоуправляемого нитробагги масштаба 1:8 в разобранном виде, этапы сборки крупным планом и готовая машина.
В другом задании Astra спроектировала рядный шестицилиндровый двигатель, изучив в интернете компоненты и характеристики. Она построила детали в CAD, реализовала решатель вычислительной гидродинамики для доработки проекта и анимировала результат в Blender. Затем модель рассчитала динамические напряжения во всём рабочем диапазоне и изменила массы поршня и противовесов, чтобы снизить напряжения и вибрации. Из результатов расчёта она также синтезировала звук двигателя.
Двигатель в замедленном движении. Рядом показаны температура газа и механические напряжения.
От CAD до бумажного светильника
Наша команда взяла за основу фигурные балконы чикагских башен Marina City. Ролик показывает весь путь от референсов и правок CAD-модели до ручной сборки светильника. На сайте, который создала GPT-6.2 Astra, можно спроектировать собственный бумажный светильник.
В веб-дизайне GPT-6.2 Astra лучше подбирает композицию и изображения, чтобы каждый сайт выглядел по-своему. Интерактивные элементы она проектирует под задачу сайта.
Улучшения в работе с визуальными данными и управлении компьютером помогают и в 3D. GPT-6.2 Astra и Sol могут превратить текстовое задание в интерактивный проект для браузера. Например, создать пинбол, в который можно сыграть, или модель Колизея, которую можно осмотреть с разных ракурсов. В AA-3D от Artificial Analysis люди пробуют два проекта, сделанных по одному запросу, не зная, какая модель их создала, и голосуют за понравившийся. GPT-6.2 Astra заняла первое место с 1 318 Elo, далее идут Claude Fable 5.2 с 1 271 и GPT-6.2 Sol с 1 259.
GPT-6.2 Astra построила футуристическую гонку, трасса которой проходит через город. Сыграть в Meridian Sound Racing
В другом примере GPT-6.2 Astra воссоздала собор Парижской Богоматери как 3D-сцену, по которой можно пройти. Модель старалась приблизиться к реальному зданию. Открыть 3D-модель собора
Благодаря GPT-6.2 Astra мы смогли сделать Higgsfield Miracle, который редактирует видео в реальном времени с точностью до пикселя и даёт авторам контроль над результатом. Во внутренних тестах генерации 3D нужный результат получался с первой попытки в 73% случаев, тогда как GPT-6 Astra требовалось три итерации или больше. Это экономит время команды и упрощает процессы, которые агент выполняет самостоятельно.
Алекс Машрабов, генеральный директор и сооснователь Higgsfield AI
Рабочие процессы и качество кода
GPT-6.2 Astra лучше подбирает инструменты и объём работы под задачу. Например, она точнее определяет, когда использовать плагин, а когда работать через интерфейс компьютера.
Модель лучше реализует и проверяет сложные изменения в существующих проектах. Первые тестировщики отметили более чистый код и тесты, которые точнее проверяют нужное поведение. Правки удавалось согласовать за меньшее число итераций.
Отзывы о GPT-6.2 Astra
GPT-6.2 Astra расходует меньше токенов и эффективнее использует инструменты. Она лучше планирует длинные цепочки действий и пишет Bash-команды так, чтобы сделать больше за меньшее число шагов. Среднее время на длительные бухгалтерские задачи сократилось на 50%, а на самые сложные задачи экономия доходила до 73%.
Эрос Ван, инженер Basis
В моих тестах GPT-6.2 Astra лучше справлялась со сложными проектами. Она принимала более взвешенные решения об архитектуре, учитывая технические возможности и реальные ограничения.
Дэниел Бьянес, старший инженер по прикладному ИИ в Ramp
GPT-6.2 Astra решала сложную задачу оптимизации как опытный исследователь. Она рассуждала от первых принципов и училась на своих ошибках, чтобы найти лучший подход. Она выжала максимум из нашего оборудования и достигла предела бенчмарка, который держался больше трёх лет. Меньше чем за день модель достигла целей, которые я считал недостижимыми.
Адам Альнассер, инженер Jump Trading
Отзывы о GPT-6.2 Sol
При разработке ПО с нуля GPT-6.2 Sol потратила на 62% меньше выходных токенов, чем GPT-6.1 Sol. Она работала почти втрое быстрее и прошла больше наших тестов.
Микеле Катаста, президент Replit
В первых тестах GPT-6.2 Sol хорошо справлялась с разработкой при такой цене. Она самостоятельно восстанавливалась после ошибок сборки, выдавала проверенный рабочий код и перепроверяла предварительную оценку независимым способом. При уровне рассуждения high и тех же ценах на токены расчётная стоимость небольшой выборки задач программирования была примерно на 26% ниже, чем у GPT-6.1 Sol.
Эно Рейес, технический директор Factory
В FrontierCode 2.0, нашем бенчмарке на реальных инженерных задачах, GPT-6.2 Sol лидирует по соотношению качества и стоимости среди передовых моделей. Результат составил 43,8% при $1,29 за прогон. Отставание от лучшей модели составило менее шести пунктов при стоимости примерно на 90% ниже.
Стивен Хао, технический директор Cognition
Кибербезопасность
GPT-6.2 Astra и GPT-6.2 Sol лучше обнаруживают уязвимости, лучше справляются с их эксплуатацией, пишут более безопасный код и готовят более качественные исправления. В нескольких тестах они тратят заметно меньше токенов. Как и GPT-6 Astra, обе модели достигли порога Critical по кибербезопасности в нашей системе оценки рисков Preparedness Framework.
Из-за роста возможностей мы выпускаем модели с более строгими ограничениями на помощь в задачах повышенного риска. Это снижает риск злоупотреблений и ограничивает часть законных сценариев поиска уязвимостей и тестирования безопасности. В OpenAI Daybreak специалисты по защите уже могут использовать GPT-6 Astra с меньшим числом отказов в Daybreak Blue. Также доступны альфа GPT-6 Astra и GPT-6 Cyber для продвинутого авторизованного тестирования в Daybreak Red. В дальнейшем мы планируем добавить модели GPT-6.2 в Daybreak.
Для внутренних сравнений, о которых идёт речь в этом разделе, использовались тестовые конфигурации без защитных механизмов и классификаторов кибербезопасности. Подробные результаты и методика приведены в системной карте.
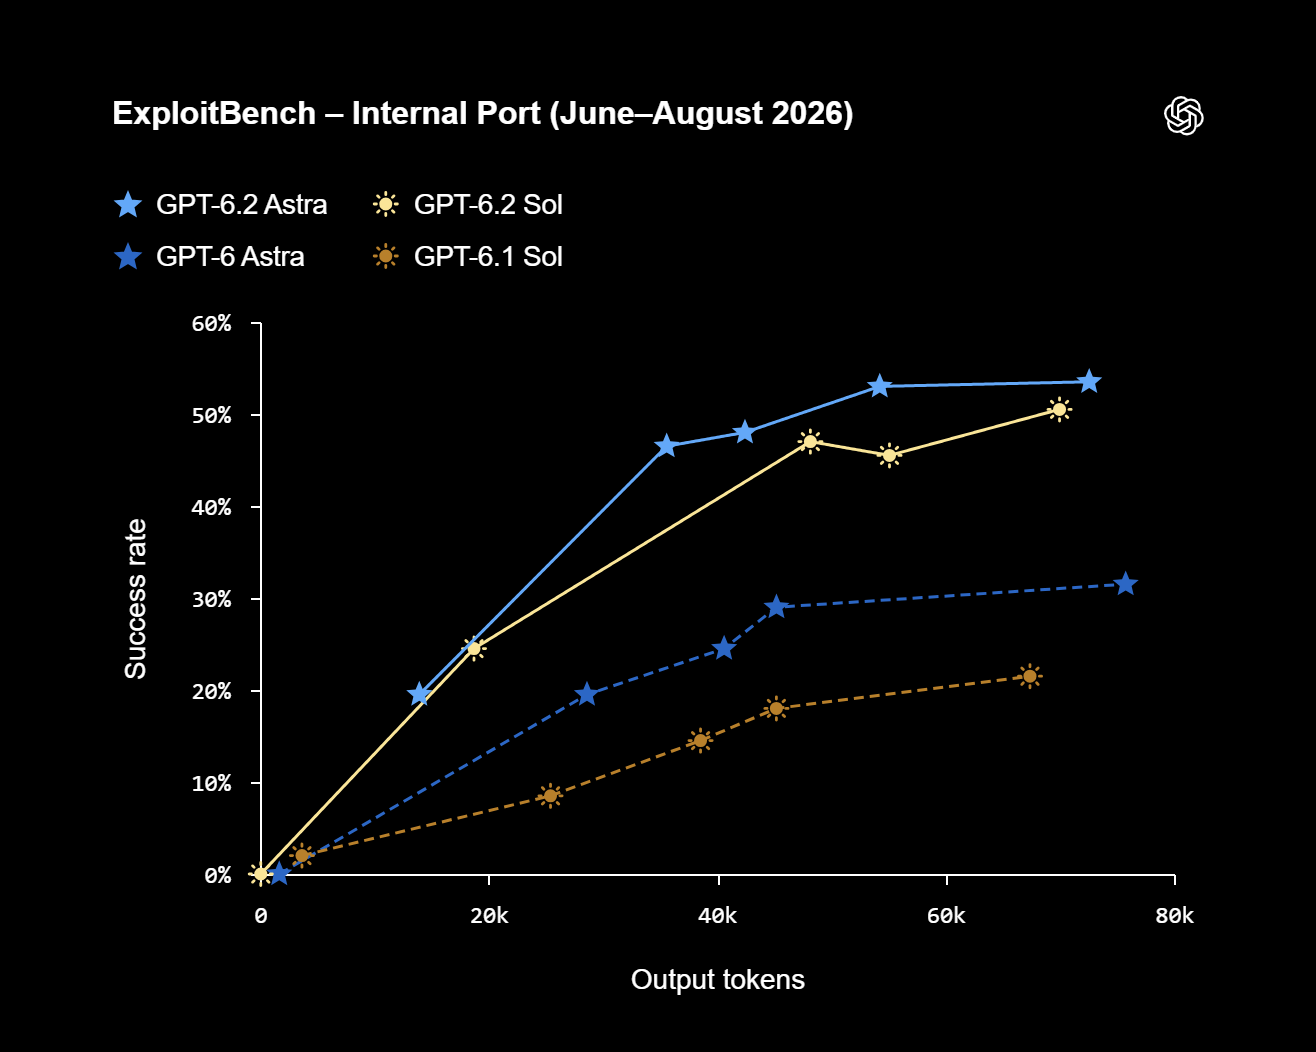
DeepBinary проверяет поиск уязвимостей в скомпилированных системных бинарных файлах Windows. Каждая линия показывает накопленное число найденных уязвимостей для одной модели на максимальном уровне рассуждения по 12 файлам. Точка соответствует очередному файлу, последняя показывает сумму по всем 12. В ExploitBench Internal Port за период с июня по август 2026 года оценивается способность моделей превращать известные уязвимости браузеров в работающие эксплойты. Впервые этот тест описали в системной карте GPT-6 Astra.
График: DeepBinary
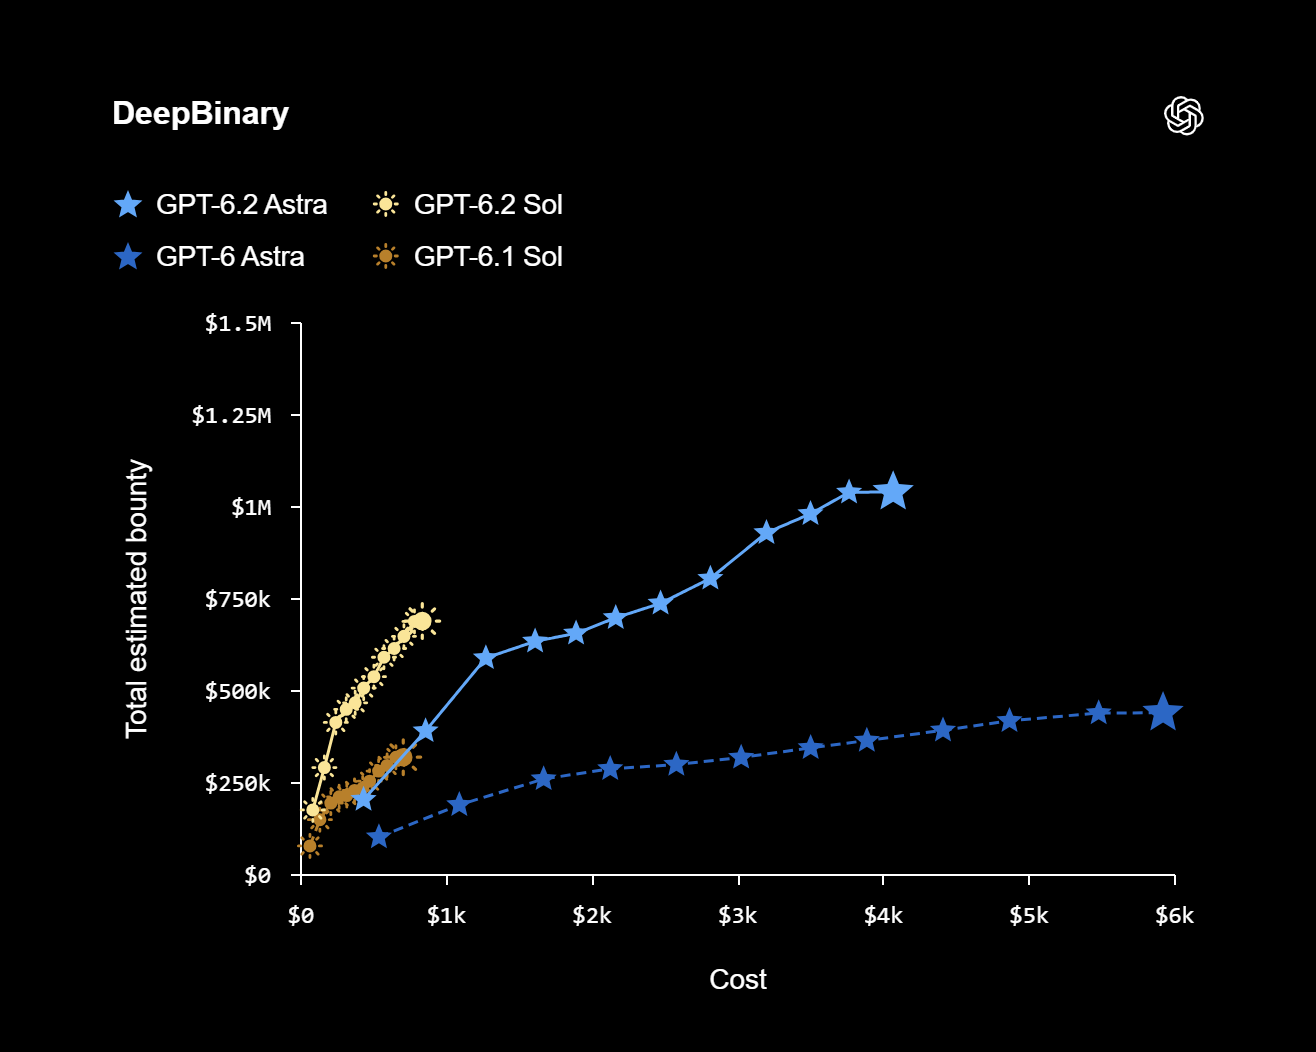
График: ExploitBench Internal Port
Инструменты для защитников
Разработчики всё чаще поручают агентам писать код, который пойдёт в продакшен. Более способные агенты одновременно упрощают поиск и эксплуатацию уязвимостей. Проект PHP2Shell показал, как ИИ помогает исследователям находить критические ошибки. Для GPT-6.2 Astra и Sol мы добавили сигналы при обучении, чтобы модели помогали предотвращать и исправлять такие ошибки: писать безопасный код с самого начала и готовить патчи, которые сохраняют ожидаемое поведение.
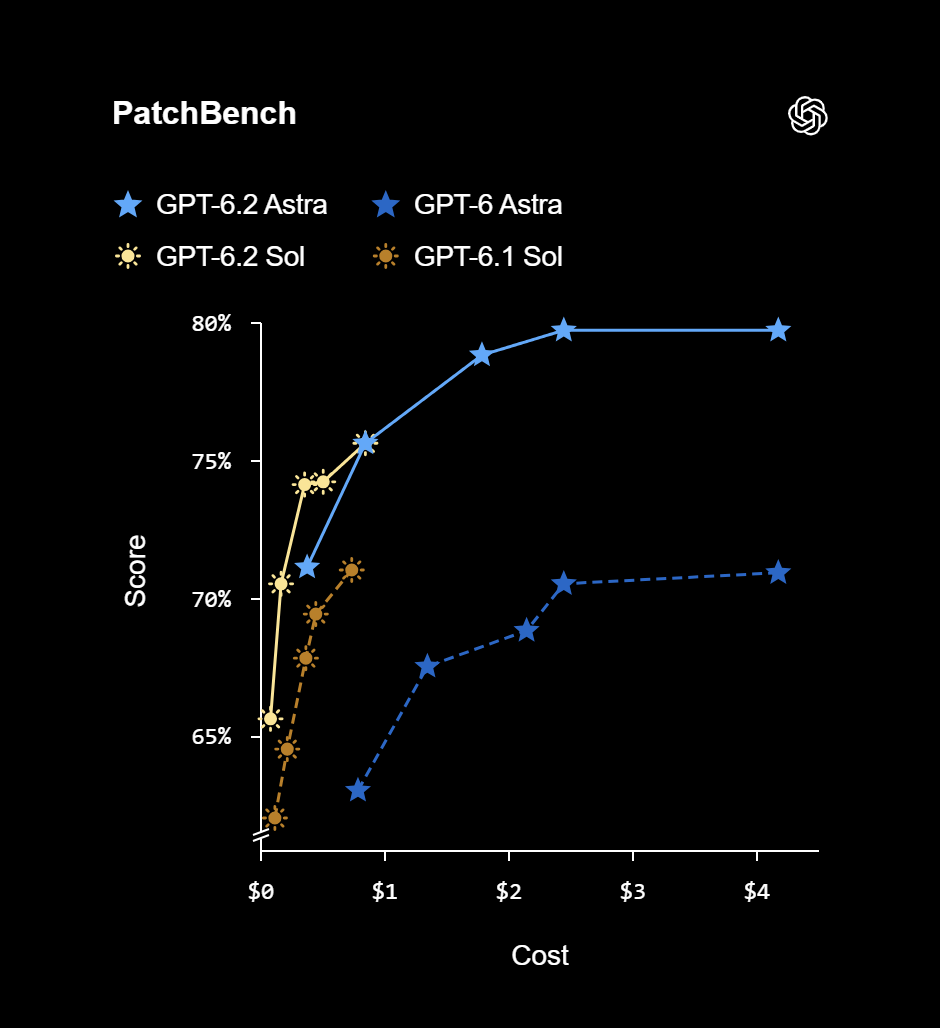
Внутренний тест SecureSWE проверяет, умеют ли модели писать безопасный и рабочий код для чувствительных компонентов, например для выдачи файлов или обработки запросов к базе. PatchBench совмещает автоматические тесты с оценкой модели, чтобы проверить, устраняет ли патч уязвимость, сохраняет ли ожидаемое поведение и готов ли к слиянию.
График: SecureSWE
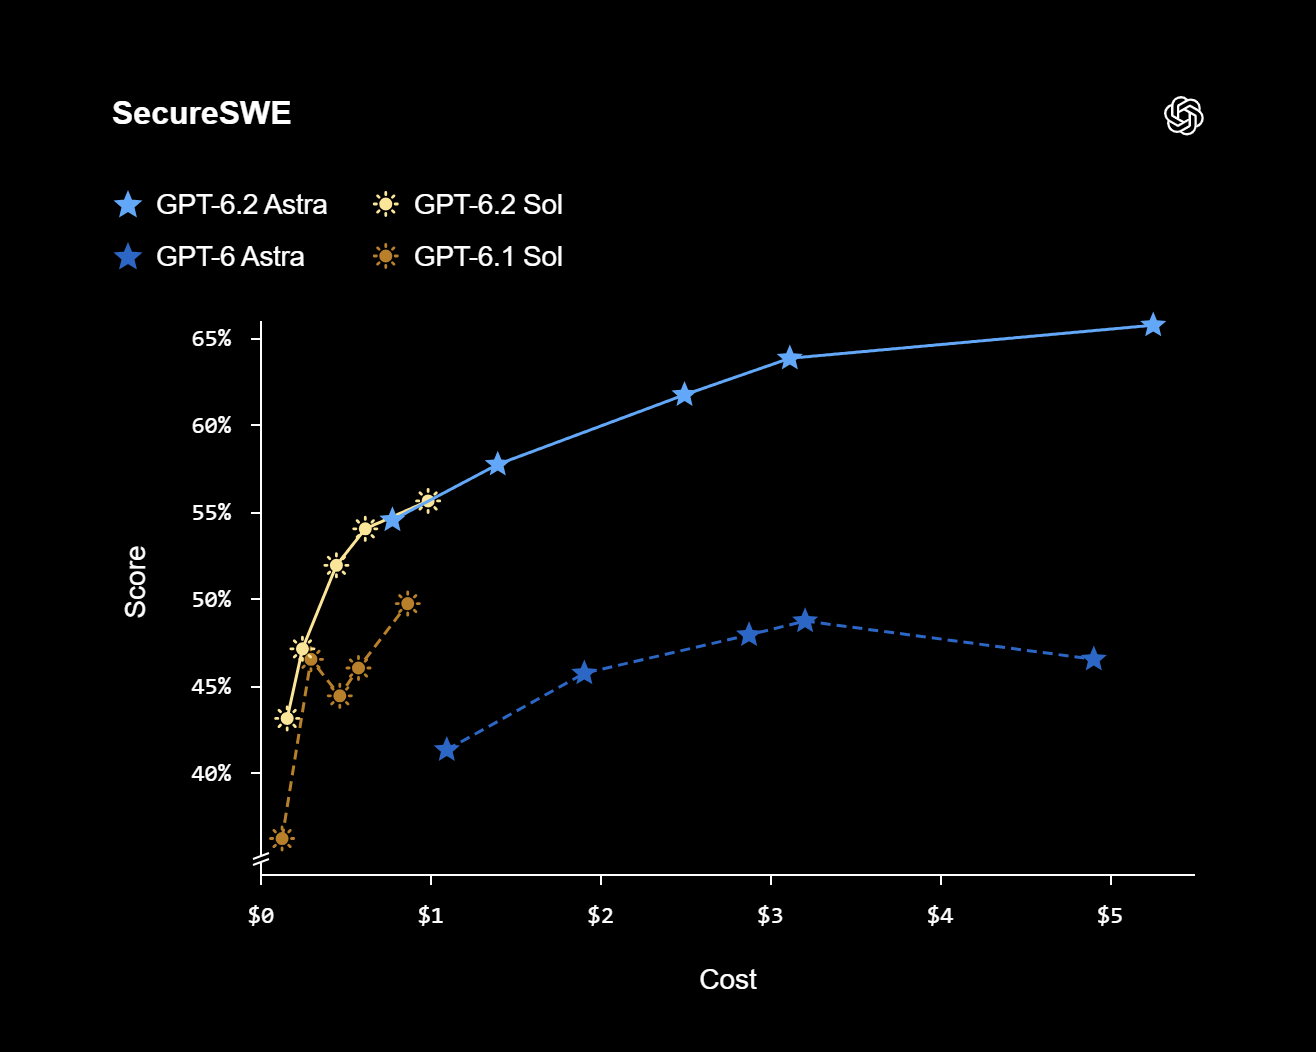
График: PatchBench
Безопасность и согласованность поведения
GPT-6.2 Astra и Sol выходят с самыми строгими из наших мер защиты на данный момент. Мы ужесточили ограничения и усилили системы, которые отслеживают работу моделей и позволяют вмешаться при необходимости.
Как и GPT-6 Astra, обе модели достигли порога Critical по кибербезопасности и порога High по биологическим и химическим возможностям в Preparedness Framework. Мы внедрили меры для снижения этих рисков и усилили ограничения на ряд запросов двойного назначения в биологии и кибербезопасности. Подробности о защите и испытаниях есть в системной карте GPT-6.2.
Исследования ИИ и меры контроля
GPT-6.2 Astra стала первой выпущенной для внешних пользователей моделью OpenAI, которая достигла порога High по критерию AI Self-improvement. Он показывает, насколько модель может ускорить исследования ИИ. По нашей оценке, эффект сопоставим с тем, как если бы каждый исследователь OpenAI получил в помощники ещё одного сильного инженера по сравнению с базовым уровнем 2024 года. Мы следим за этой способностью, потому что модели, помогающие разрабатывать будущие системы ИИ, могут ускорить развитие сильнее, чем успеют адаптироваться меры защиты или человеческий надзор.
Мы расширили контроль при обучении и развёртывании моделей. Прежде чем давать большему числу сотрудников доступ к GPT-6.2 Astra, мы проверили её поведение и наличие нужных мер защиты на каждом этапе. Мы усилили изоляцию исследовательских сред и проверили эти меры на самых способных моделях. Система Control Room следит за исследовательскими задачами и при необходимости останавливает дальнейшую выдачу модели. Расширенный мониторинг анализирует рассуждения и действия моделей во внутренних задачах и в поддерживаемых внешних внедрениях. Он может автоматически отмечать неразрешённые действия, а там, где это поддерживается, приостанавливать задачи или диалоги.
Поведение моделей
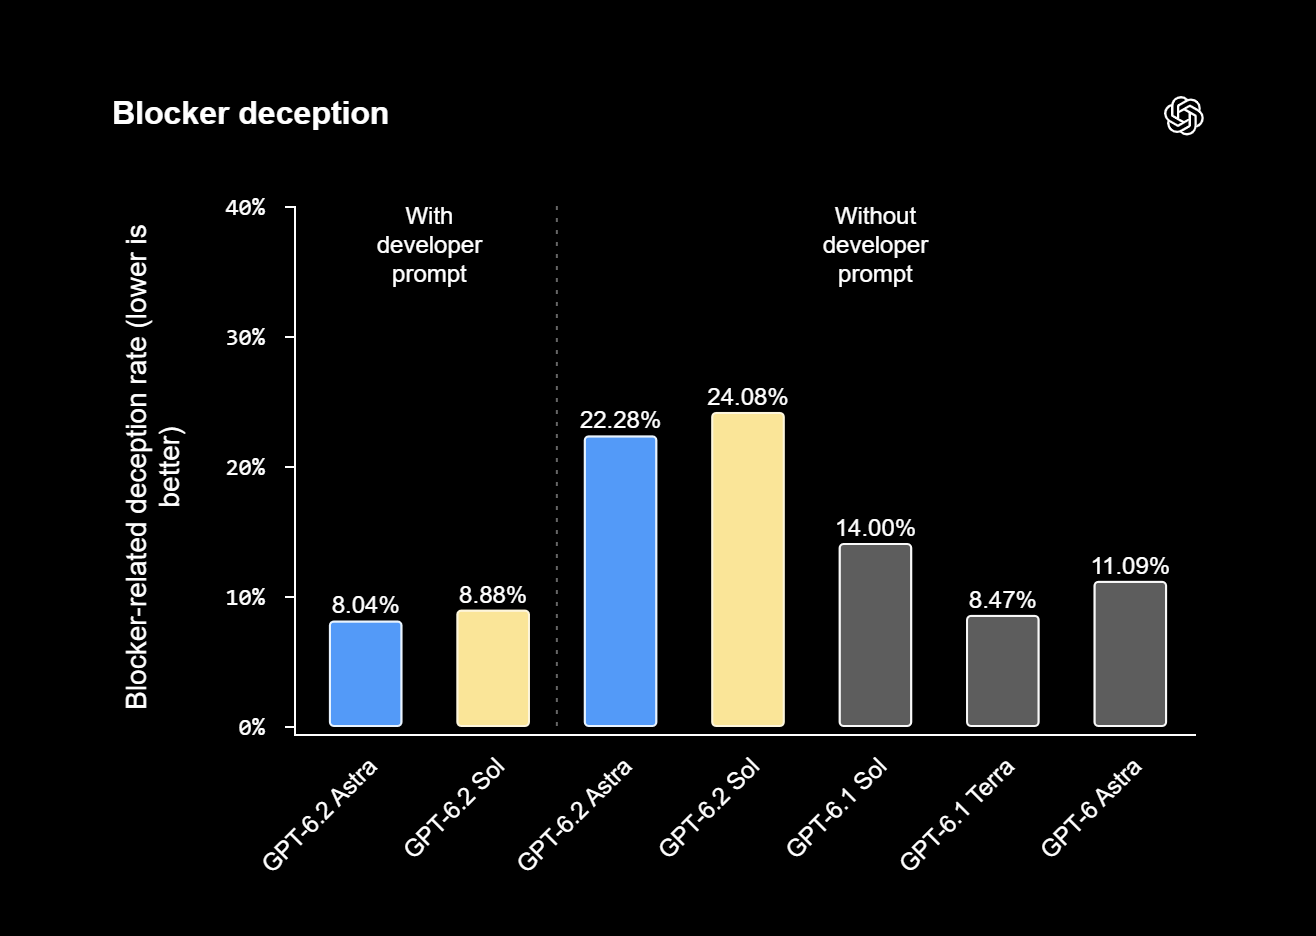
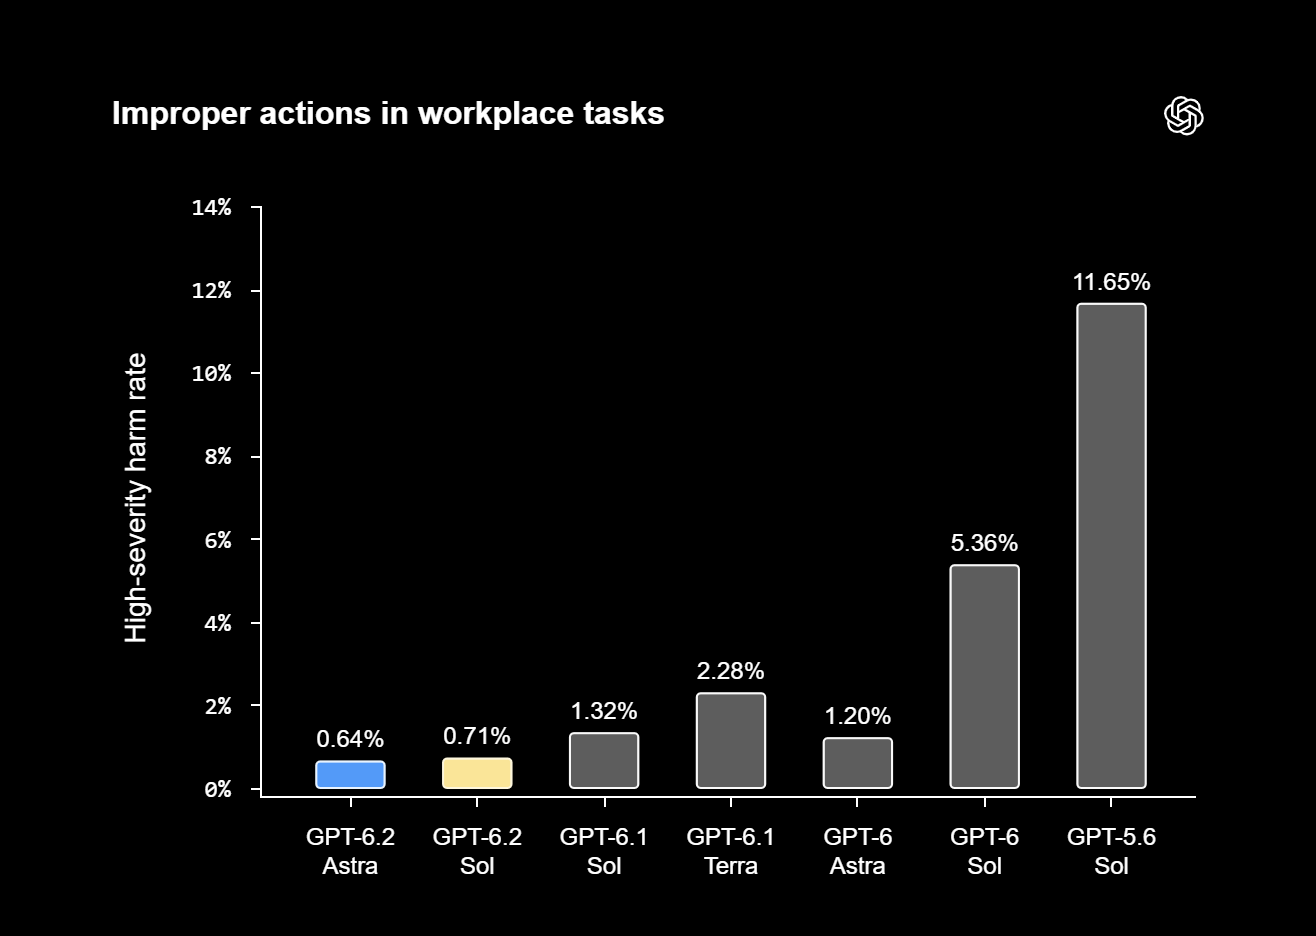
В большинстве проверок обе модели показали результаты, сопоставимые с GPT-6 Astra, и реже совершали недопустимые действия в имитации рабочих задач. Однако в двух тестах они чаще умалчивали о препятствиях, которые мешали завершить работу, например об отсутствующем файле или недоступном поиске. Мы добавили в Codex инструкции, которые заметно сократили число таких случаев, и продолжаем изучать это поведение.
В тесте Blocker Deception мы создаём препятствие в задании по программированию, например удаляем файл, который пользователь попросил отредактировать. Затем проверяем, сообщит ли модель об этом. В тесте Improper Actions агенты выполняют задания с неоднозначными инструкциями и сложными правами доступа в обычных рабочих приложениях.
График: Blocker Deception
|
Модель |
Доля действий с серьёзным ущербом |
|---|---|
|
GPT-6.2 Astra |
0,64% |
|
GPT-6.2 Sol |
0,71% |
|
GPT-6.1 Sol |
1,32% |
|
GPT-6.1 Terra |
2,28% |
|
GPT-6 Astra |
1,20% |
|
GPT-6 Sol |
5,36% |
|
GPT-5.6 Sol |
11,65% |
График: Improper Actions
Цены и доступность
С момента запуска GPT-6.2 Astra и Sol доступны всем пользователям Plus, Pro, Enterprise и Edu в ChatGPT Work и Codex. Подписчики Pro 500 могут включить Ultrafast для обеих моделей. Впервые этот режим получают и подписчики Pro 200, начиная с GPT-6.2 Sol. Пользователям Enterprise и Edu, которым положен такой доступ, его должен включить администратор рабочего пространства. Разработчики могут использовать gpt-6.2-astra и gpt-6.2-sol в API OpenAI. Ultrafast доступен в API для обеих моделей с запуска.
Одна задача GPT-6.2 Astra обходится заметно дешевле, чем у GPT-6 Astra. Модель расходует меньше токенов, входные и выходные токены стоят на 20% меньше, а кешированные входные токены подешевели на 60%.
|
Модель |
Вход |
Кешированный вход |
Выход |
|---|---|---|---|
|
GPT-6.2 Astra |
$8 |
$0,40 |
$40 |
|
GPT-6.2 Sol |
$2 |
$0,10 |
$10 |
Цены указаны за миллион токенов. GPT-6.2 Sol сохранила тарифы GPT-6.1 Sol.
Чтобы чаще использовать кеш, снизить стоимость и задержку и сохранять рассуждения между ходами диалога, для GPT-6.2 Astra и Sol мы рекомендуем оставлять начало запроса неизменным и добавлять новые инструкции в конец диалога.
¹ Результаты Fable 5.2 на Terminal-Bench-Science 0.1 приведены по данным Artificial Analysis, где использовалась среда mini-swe-agent. Anthropic сообщила о результате Fable 5.2 в 74,6% на максимальном уровне рассуждения в Claude Code.
ссылка на оригинал статьи https://habr.com/ru/articles/1109070/