Привет! Меня зовут Владислав Суханов. Я руководитель направления Риски в Центре развития искусственного интеллекта в Ингосстрахе. Сегодня расскажу, чем промышленный ML отличается от учебного и как строить модели со стабильно высокими метриками качества.
В данной статье я НЕ буду рассматривать обработку пропусков, работу с категориальными переменными, константами в признаках и тд, так как по данным темам уже написано много работ и в целом проблемы являются решёнными.
Здесь рассмотрим, как работать с Data Drift и Concept Drift при обучении моделей.
Всего написано 2 статьи по выстраиванию промышленного ML:
-
Не набрасывайся на ROC AUC или как обучать промышленные ML-модели
-
Мониторинг ML-моделей в Рисках
Технический стэк
Алгоритмы градиентного бустинга на решающих деревьях: LightGBM, CatBoost.
Кейс
Вы закончили обучение по Data Science, проработали 1-2 года в отрасли, научились строить модели и знаете архитектуру LightGBM и CatBoost. В какой-то момент вы понимаете, что делаете всё, как вас учили, получаете приемлемые метрики качества, но наблюдаете одну из 3 проблем:
-
модели быстро деградируют на проде и их нужно регулярно переобучать.
-
метрики на проде отличаются от показателей на обучающей выборке.
-
вы хотите улучшить ваш скоринговый конвейер, но не понимаете куда расти.
Критерии качества
Сначала разберёмся с критериями качества моделей. В учебных проектах и хакатонах всё
просто – есть ROC AUC, который организатор считает на отложенной выборке. Чем выше метрика, тем лучше и не важно, как ты её достиг:
-
применил наиболее эффективную архитектуру или хакнул таргет,
-
правильно отобрал признаки или переобучился под конкретные сегменты выборки.
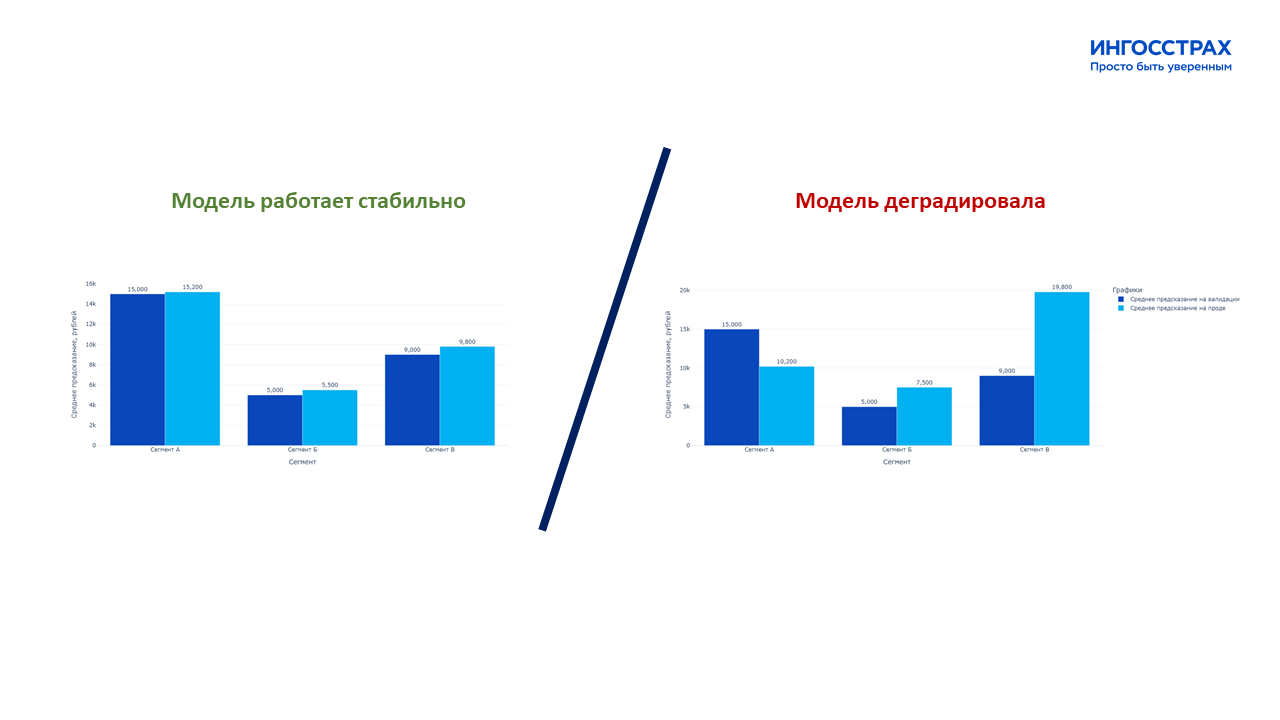
В промышленных проектах всё иначе, здесь мы смотрим одновременно на 2 показателя:
-
высокие метрики качества (ROC AUC, GINI)
-
стабильность метрик качества в течение продолжительного времени.
Почему важна стабильность?
В Рисках (банковских и страховых) мы предсказываем событие, которое случится в течение года после даты подачи заявки:
-
в страховой необходимо посчитать, какой убыток принесёт полис в течение всего времени действия договора (как правило, 1 год).
-
в банках таргет – это 90 дней просрочки на горизонте 12 месяцев.
Таким образом, для обучения модели, которую мы применим в октябре 2026 года, мы сделаем следующее:
-
для обучения мы возьмём договора, которые начались в 2024-01-01 – 2024-12-31
-
для валидации мы возьмём договора, которые начались в 2025-01-01 – 2025-09-31
Метрики должны оставаться стабильно высокими и в 2025 году, и в 2026. А сама модель должна проработать в течение 12 месяцев без необходимости переобучения. Другими словами, в промышленной эксплуатации ML-моделей мы совершаем trade off между стабильностью на долгом горизонте и высокими метриками качества в моменте.
Наша цель: добиться наилучшего сочетания этих показателей и показать прирост финансовых показателей компании.
Что мешает строить стабильные модели?
Качество модели всегда зависит от признаков, на которых она строится. На проде модель увидит только те зависимости между признаками и целевой переменной, которые есть на обучающей выборке. Однако существуют дрейфы в данных, которые меняют эти зависимости и ломают модели. Рассмотрим это влияние подробнее.
Data Drift – это ситуация в машинном обучении, когда со временем статистические свойства входных данных (признаков), на которых работает модель, начинают отличаться от тех, на которых она обучалась
Есть 2 вида дрейфа:
-
Data Drift – это изменения во входных данных при сохранении зависимости между признаком и целевой переменной.
-
Concept Drift – это изменение зависимости целевой переменной от признака. При этом распределение признака может оставаться тем же.
Архитектура решения в Ингосстрахе
Мы в Ингосстрахе внедрили решение, которое позволяет снизить влияние Data и Concept Drift на модели. Обучение моделей состоит из следующих этапов:
-
разделение на обучающую и валидационную выборки, разнесённые во времени.
-
оценка стабильности признаков: исключаем Data Drift и Concept Drift.
-
отбор наиболее значимых признаков.
Также рассмотрим индикаторы нестабильности – это косвенные показатели того, что модель обучилась некорректно.
Обучающая и валидационная выборки должны быть разнесены во времени
Это может быть очевидно для опытных Data Scientist, но давайте остановимся на этом пункте подробнее.
На курсах по ML или даже хакатонах обычно просто делают train_test_split, обучают модель на одних наблюдениях, предсказывают на другие и таким образом считают метрики на якобы отложенной выборке. Такого подхода иногда придерживаются и бизнес-заказчики для валидации моделей, которые вы им предоставляете. Тут возникает соблазн посчитать метрики на выборке, отложенной таким способом, получить хороший результат и радоваться жизни.
Что может пойти не так?
Если не разносить обучение и валидацию во времени, не получится отследить Data Drift. Мы обучаем модель на договорах, которые были заключены 1-2 года назад, а применять модель мы будем сейчас. Логично, что качество модели изменится, и наша ключевая задача – оценить насколько изменится качество модели относительно обучающей выборки.
В этом нам поможет разнесение во времени обучающей и валидационной выборок. Мы эмулируем отложенный период и оцениваем стабильность полученных метрик. Если качество остаётся высоким на отложенном периоде, значит модель можно применять на проде.
Оценка стабильности признаков: исключаем Data Drift и Concept Drift
Методология отбора стабильных признаков строится на анализе распределений признаков на обучающей и валидационной выборке. Распределения можно сравнить с помощью индекса CSI (Characteristic Stability Index).
Задача: отобрать признаки, распределение которых на обучающей и валидационной выборке совпадает.
Начнём с теории. CSI рассчитывается по формуле:
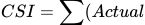
Где:
Actual% – доля наблюдений в i-м интервале (бин) на валидационной выборке.
Expected% – доля наблюдений в том же интервале i на обучающей выборке.
∑ – суммирование идёт по всем интервалам.
Если CSI>=0.25, значит изменения в распределении существенные и данный признак не стоит применять в модели.
1 этап. Расчёт CSI для оценки Data Drift
Цель: оставить признаки, распределение которых на обучающей и валидационной выборках совпадает.
Для каждого признака:
-
Разбейте значения признака на 10 бакетов на обучающей выборке и сохраните границы бакетов.
-
Разбейте значения признака на 10 бакетов на валидационной выборке, применив границы с обучающей выборке.
-
Посчитайте долю наблюдений в каждом бакете для обучающей и валидационной выборке по отдельности.
-
Рассчитайте CSI по формуле.
-
Сохраните признаки, у которых CSI<=0.25.
Это позволит удалить признаки с нестабильным распределением. Например, на обучающей выборке у нас были водители 20-30 лет, стаж 0-5 лет:
-
2% из Тверской области.
-
18% из Вологодской области
-
80% из Ярославской области.
На валидационной выборке у нас также водители 20-30 лет, стаж 0-5 лет, но теперь:
-
60% из Тверской области.
-
20% из Вологодской области
-
20% из Ярославской области.
В данном случае, признак «Регион водителя» не стоит использовать в качестве признака, так как распределение слишком сильно меняется от периода к периоду и у нас может не хватить статистики для отдельных регионов.
2 этап. Расчёт CSI для оценки Concept Drift
-
Разбейте значения признака на 10 бакетов на обучающей выборке и сохраните границы бакетов.
-
Разбейте значения признака на 10 бакетов на валидационной выборке, применив границы с обучающей выборке.
-
Если у вас НЕ бинарный таргет, необходимо сделать промежуточное вычисление и привести целевую переменную к 0 и 1. Это нужно для следующего шага.
-
Посчитайте средний таргет в каждом бакете для обучающей и валидационной выборке по отдельности.
-
Рассчитайте CSIпо формуле. Вместо доли наблюдений подставьте в формулу средний таргет с обучающей и валидационной выборки.
Сохраните признаки, у которых CSI<=0.25. Это позволит удалить признак, для которых поменялось влияние на целевую переменную. Вернёмся к нашему примеру.
На обучающей выборке у нас были водители 20-30 лет, стаж 0-5 лет:
-
у водителей из Тверской области вероятность страхового случая – 7%
-
у водителей из Ярославской области – 5%
На валидационной выборке у нас также водители 20-30 лет, стаж 0-5 лет, но теперь:
-
у водителей из Тверской области вероятность страхового случая – 2%
-
у водителей из Ярославской области – 1%
В данном случае, признак «Регион водителя» также не стоит использовать в качестве признака, так как влияние на целевую переменную сильно меняется от периода к периоду. Модель запомнит, что в Тверской области аварийные водители, а на самом деле их аварийность снизилась. Это значит, что вероятность страхового случая зависит не от региона, а от какой-то другой переменной, которую предстоит найти.
Выбор наиболее релевантных признаков
На момент построения скоринговой модели, скорее всего, у вас в команде уже сформирован Feature Store, в котором лежит от 1 000 до 10 000 признаков.
Секрет качественной модели в том, чтобы оставить 50-70 наиболее релевантных и стабильных признаков, которые хорошо объясняют целевую переменную. Это ускоряет обучение модели и делают её более устойчивой с течением времени.
Как отбирать признаки?
-
Выкидываем нестабильные признаки по CSI. В лучшем случае, у вас получится выкинуть 10-30% фичей и останется 700 – 7000 признаков.
-
Убираем признаки, которые плохо заполнены. Я рекомендую оставить признаки, которые заполнены в 1% и более случаях. Можно подобрать оптимальный для себя трешхолд, но не ставьте слишком высокие значения в 10-25-50%: так вы можете отсечь редкие события, которые сильно коррелируют с целевой переменной.
Например, в банковском скоринге вы можете посчитать признак «Есть ли просрочки по микрозаймам в кредитной истории?». В 0,1% случаев будет указан утвердительный ответ. В 1.9% случаев просрочки не будет. В 98% случаев будет стоять пропуск, так как клиент не обращался в МФО. Если мы выкинем такой признак из обучающей выборке, то упустим важную информацию о клиенте. -
Отбираем признаки, которые сильнее всего коррелируют с целевой переменной. Рекомендую MRMR (Minimum Redundancy Maximum Relevance) – это метод отбора признаков в машинном обучении, который стремится выбрать подмножество признаков, максимально информативных для целевой переменной (максимум релевантности), но при этом минимально коррелированных между собой (минимум избыточности).
Индикаторы нестабильности модели
Мы проделали большую работу по отбору признаков и теперь готовы построить baseline.
Обучаем модель с помощью кросс-валидации и получаем первые метрики (ROC AUC или MAPE в зависимости от задачи). Оценим нашу модель на предмет переобучения.
Индикатор 1. Метрики на отложенной выборке
Благодаря кросс-валидации мы получили для обучающей выборки out-of-fold скоры и можем посчитать на них метрики: ROC AUC для бинарной классификации или MAPE для регрессии.
Затем считаем метрики на отложенной валидационной выборке. Они не должны сильно снижаться относительно обучающей.
Индикатор 2. FeatureImportance
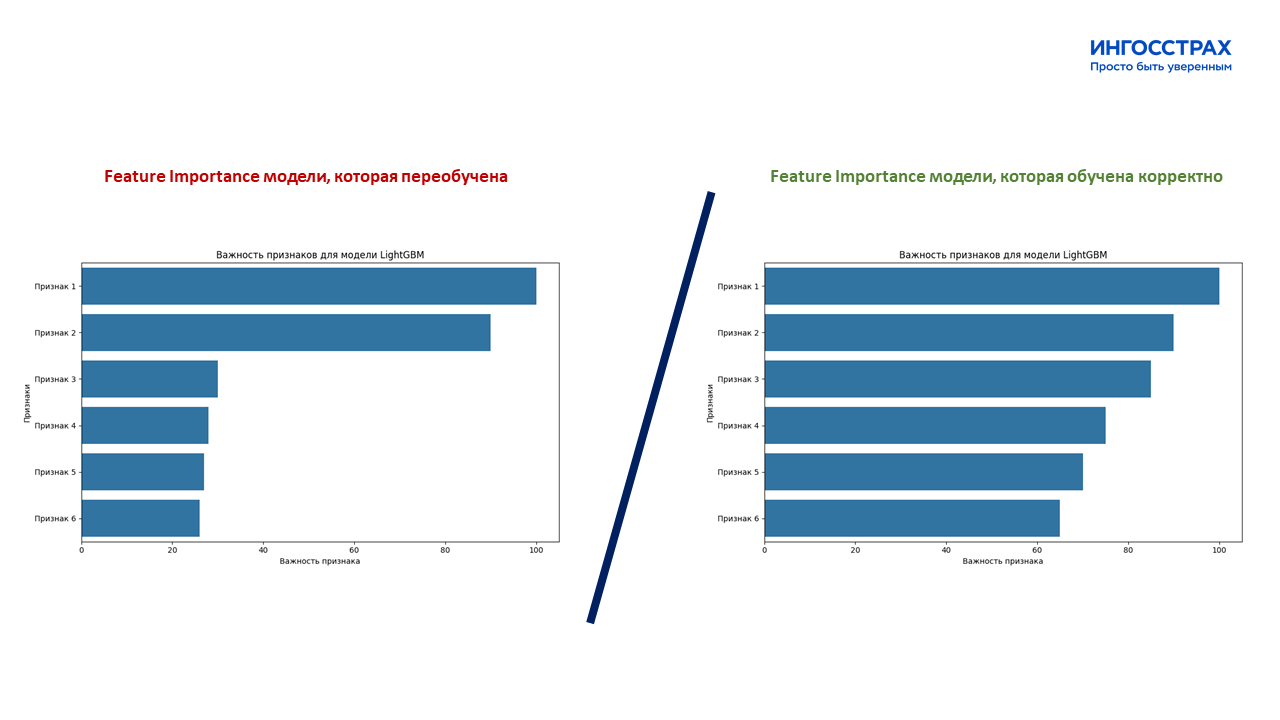
В хорошей модели важность признаков убывает плавно, есть около 10-20 признаков, которые вносят большой вклад в разделяющую способность.
В плохой модели есть топ-2-3, которые объясняют целевую переменную, а остальные признаки покрывают отдельные cornercase и в целом слабо влияют на модель.
Подведем итог
Снижение качества промышленных ML-моделей происходит из-за Data Drift и Concept Drift.
Чтобы снизить влияние дрейфов в данных на ML-модель обучение должно состоять из следующих этапов:
-
разделение на обучающую и валидационную выборки, разнесённые во времени.
-
оценка стабильности признаков: исключаем Data Drift и Concept Drift.
-
отбор наиболее значимых признаков.
Далее необходимо обучить baseline и посмотреть на индикаторы стабильности :
-
метрики out-of-fold и out-of-time должны быть примерно одинаковыми
-
на Feature Importance не должно быть явно доминирования 2-3 признаков. Важность признаков должна убывать плавно.
В следующей статье я расскажу, как выстроить мониторинг ML-моделей в Рисках и отслеживать Data Drift в продовых моделях.
ссылка на оригинал статьи https://habr.com/ru/articles/1109460/