Всем привет!
Ранее я уже рассказывал на Хабре о своём бесплатном курсе «SQL Введение», который опубликовал на платформе Stepik, а затем о выходе одноимённой бесплатной книги, подготовленной на основе материалов курса.
Тогда это были два самостоятельных образовательных продукта: курс с теоретическими материалами и практическими заданиями, а также книга, которую можно скачать и использовать в качестве учебного пособия.
Но на этом я решил не останавливаться.
Со временем появилась идея пойти дальше и создать полноценную образовательную экосистему вокруг SQL. Не просто ещё один курс или справочник, а целую платформу, в которой начинающий пользователь может последовательно изучать SQL, экспериментировать с запросами, выполнять практические задания, играть в образовательные игры и пользоваться различными инструментами, не устанавливая дополнительное программное обеспечение.
Так появился проект «SQL с нуля до результата»:
https://sql.sergeyromanenko.com/
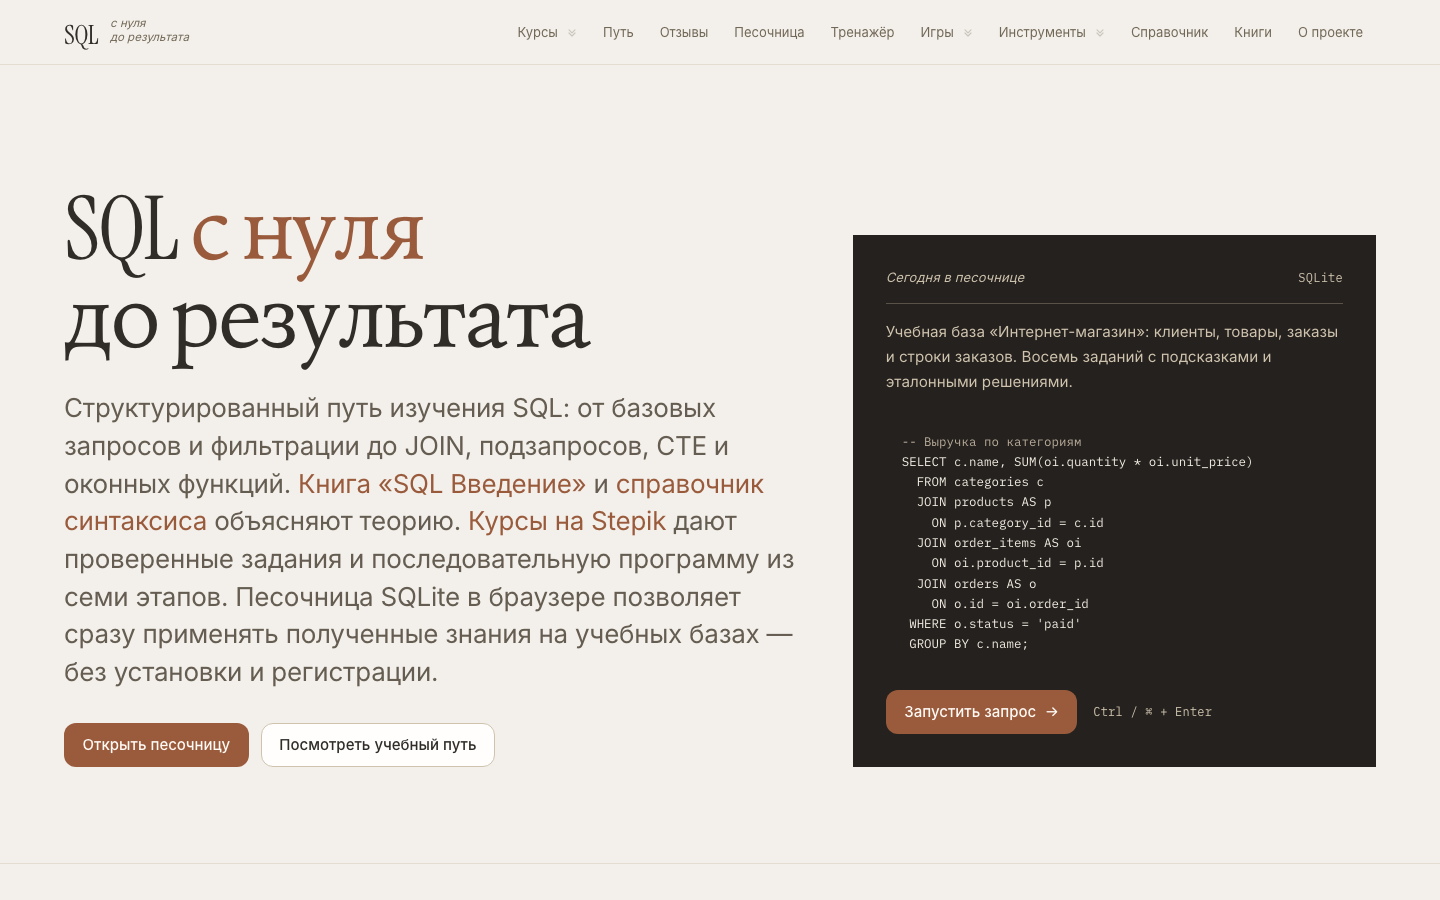
В этой статье хочу рассказать, как я пришёл к этой идее, что получилось в результате, какие технологии использовал.
1. С чего всё начиналось: бесплатный курс «SQL Введение»
Первым шагом стал бесплатный курс «SQL Введение» на Stepik.
https://stepik.org/course/290855
Идея курса появилась из наблюдения за тем, как люди начинают изучать базы данных. Довольно часто начинающие сталкиваются с избыточно сложными объяснениями уже на первых этапах обучения. Вместо последовательного знакомства с принципами работы реляционных баз данных они сразу получают большое количество терминов, теории и особенностей конкретных СУБД.
Мне хотелось сделать более доступную точку входа в SQL.
Поэтому курс был построен по принципу «от простого к сложному». Он включает теоретические уроки, тестовые задания и практические упражнения, которые помогают постепенно разобраться в устройстве таблиц, научиться писать первые запросы, выбирать и фильтровать данные.
Когда я впервые рассказывал о курсе на Хабре, его начали проходить более 400 студентов.
С момента создания курса 24 июня 2026 года аудитория заметно выросла. По состоянию на 19 ноября 2026 года курс насчитывал уже 3 324 учащихся, имел рейтинг 4,92 на основании 108 отзывов.
Для бесплатного вводного курса это стало хорошим подтверждением того, что такой формат обучения востребован.
2. Следующим шагом стала книга
После публикации курса я решил подготовить полноценную книгу с тем же названием.
Причина была достаточно простой: во время обучения многим удобно иметь не только последовательность уроков на образовательной платформе, но и единый материал, к которому можно вернуться в любое время.
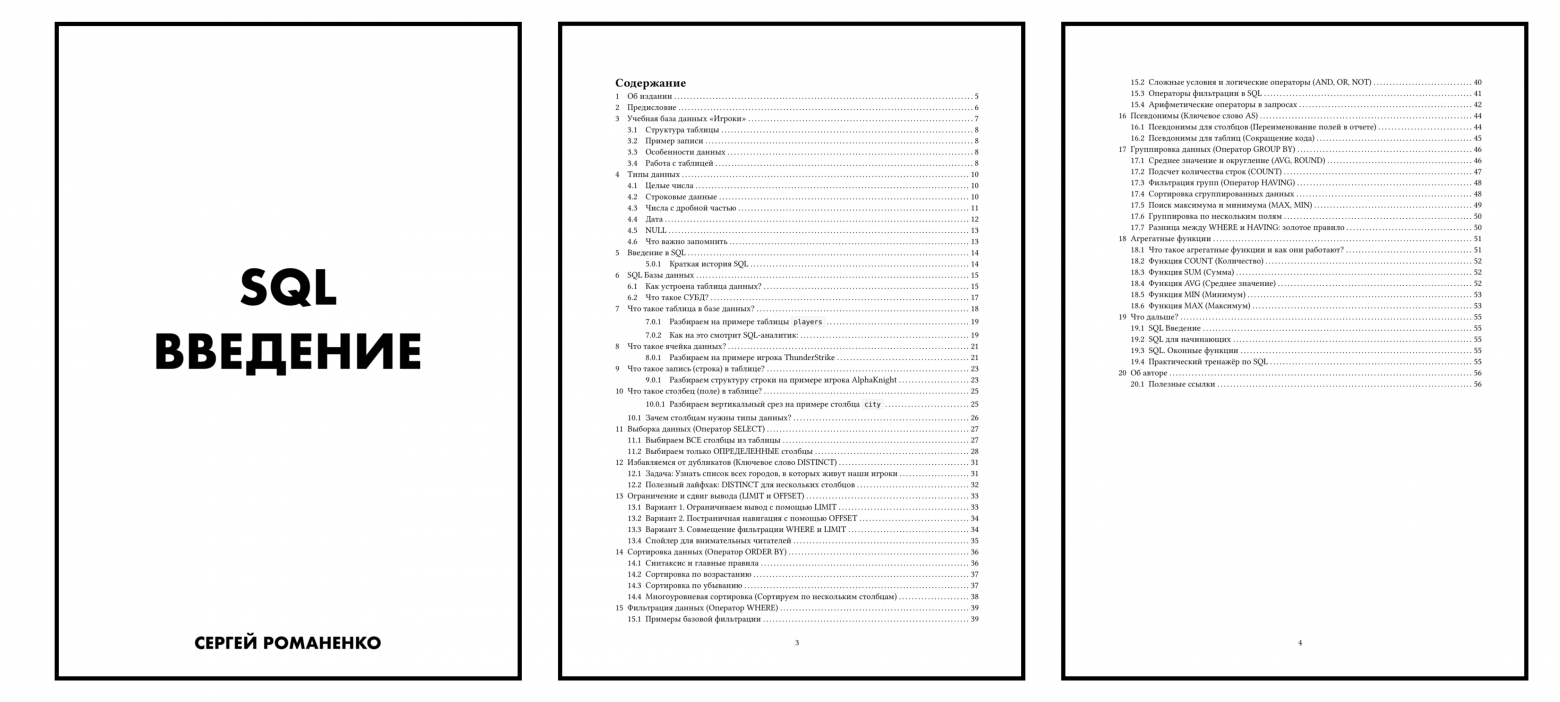
Так появилась бесплатная книга «SQL Введение».
Она повторяет структуру курса и может использоваться как самостоятельное учебное пособие, справочник или дополнительный материал во время выполнения практических заданий.
Книга распространяется бесплатно в форматах PDF и EPUB.
Исходные материалы и выпуски опубликованы на GitHub:
https://github.com/Awilum/sql-introduction
Последняя версия доступна в разделе Releases:
https://github.com/Awilum/sql-introduction/releases
По данным статистики проекта на 19 ноября 2026 года, количество скачиваний книги превысило 1 500.
На этом этапе у меня уже было два взаимосвязанных образовательных продукта: курс и книга. Но постепенно я начал замечать, что для комфортного изучения SQL этого недостаточно.
Можно прочитать главу, посмотреть объяснение и понять принцип работы оператора SELECT. Но как только человек закрывает книгу, ему всё равно необходимо найти подходящую среду для практики, подготовить базу данных, создать таблицы и написать запрос.
Мне захотелось убрать этот барьер.
3. От книги и курса к образовательной экосистеме
Основная идея заключалась в том, чтобы объединить все необходимые инструменты для изучения SQL в одном месте.
Я не хотел превращать проект в обычный каталог ссылок на курсы и полезные материалы. Каждая функция должна была решать конкретную задачу обучения.
Так постепенно сформировалась структура платформы.
Сегодня проект включает несколько самостоятельных направлений.
Учебный маршрут
Вместо того чтобы оставлять пользователя один на один с большим количеством материалов, я разработал последовательную программу обучения из семи этапов.
Она начинается с самых основ SQL и постепенно приводит к более сложным конструкциям и аналитике данных.
Каждому этапу соответствует определённая цель и подходящие образовательные материалы.
SQL-песочница
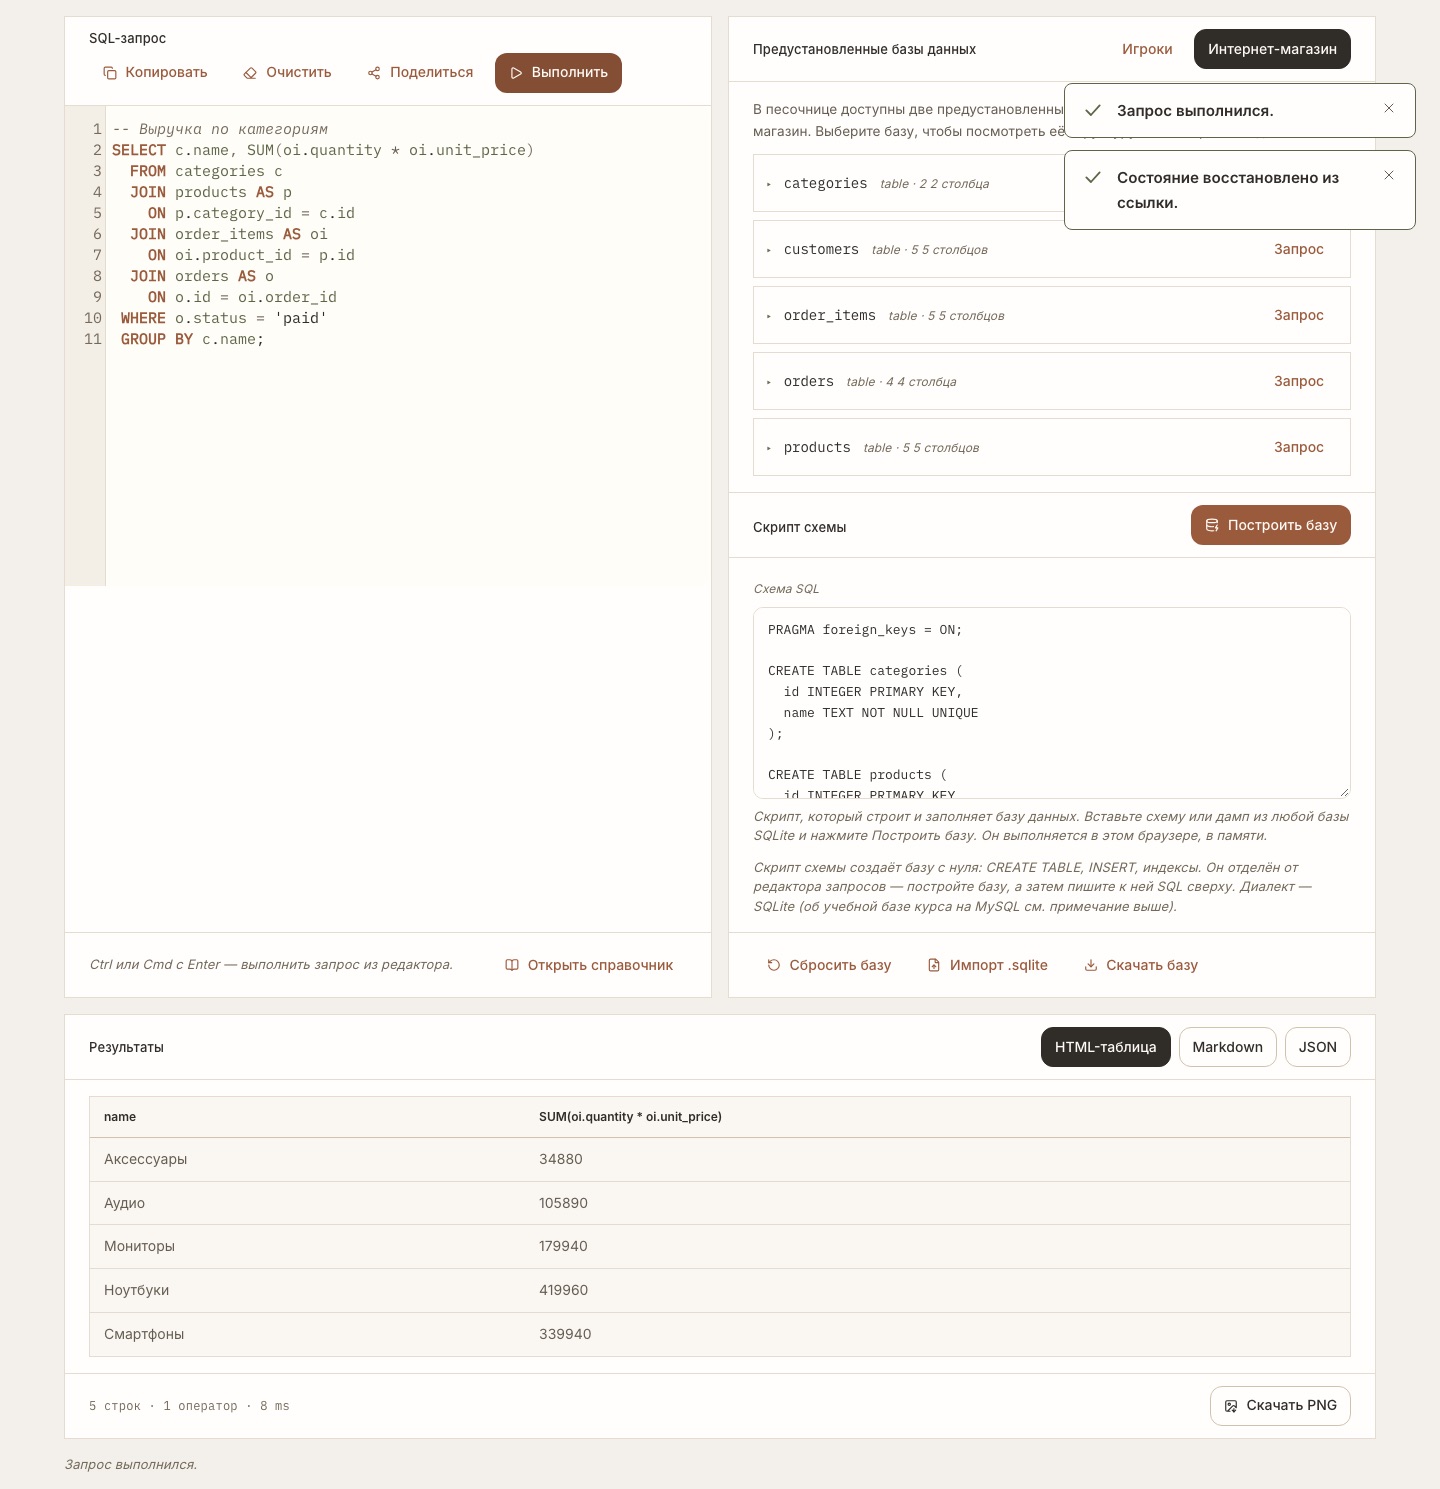
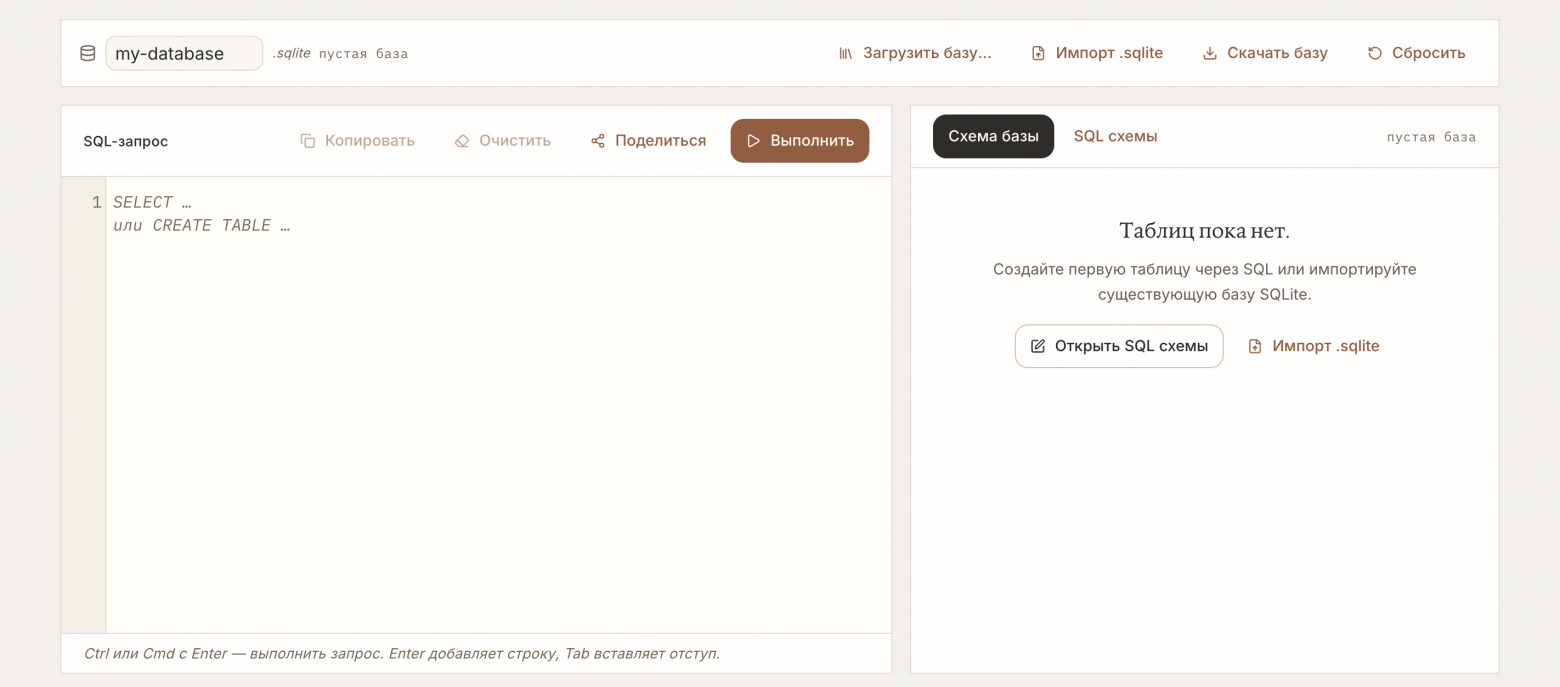
Один из основных инструментов платформы — интерактивная SQL-песочница.
Пользователь может открыть страницу, выбрать учебную базу данных, написать SQL-запрос и сразу получить результат.
Ничего устанавливать не требуется. Не нужно самостоятельно разворачивать базу данных или настраивать окружение.
В качестве движка используется SQLite, работающая непосредственно в браузере через WebAssembly.
Интерактивный тренажёр
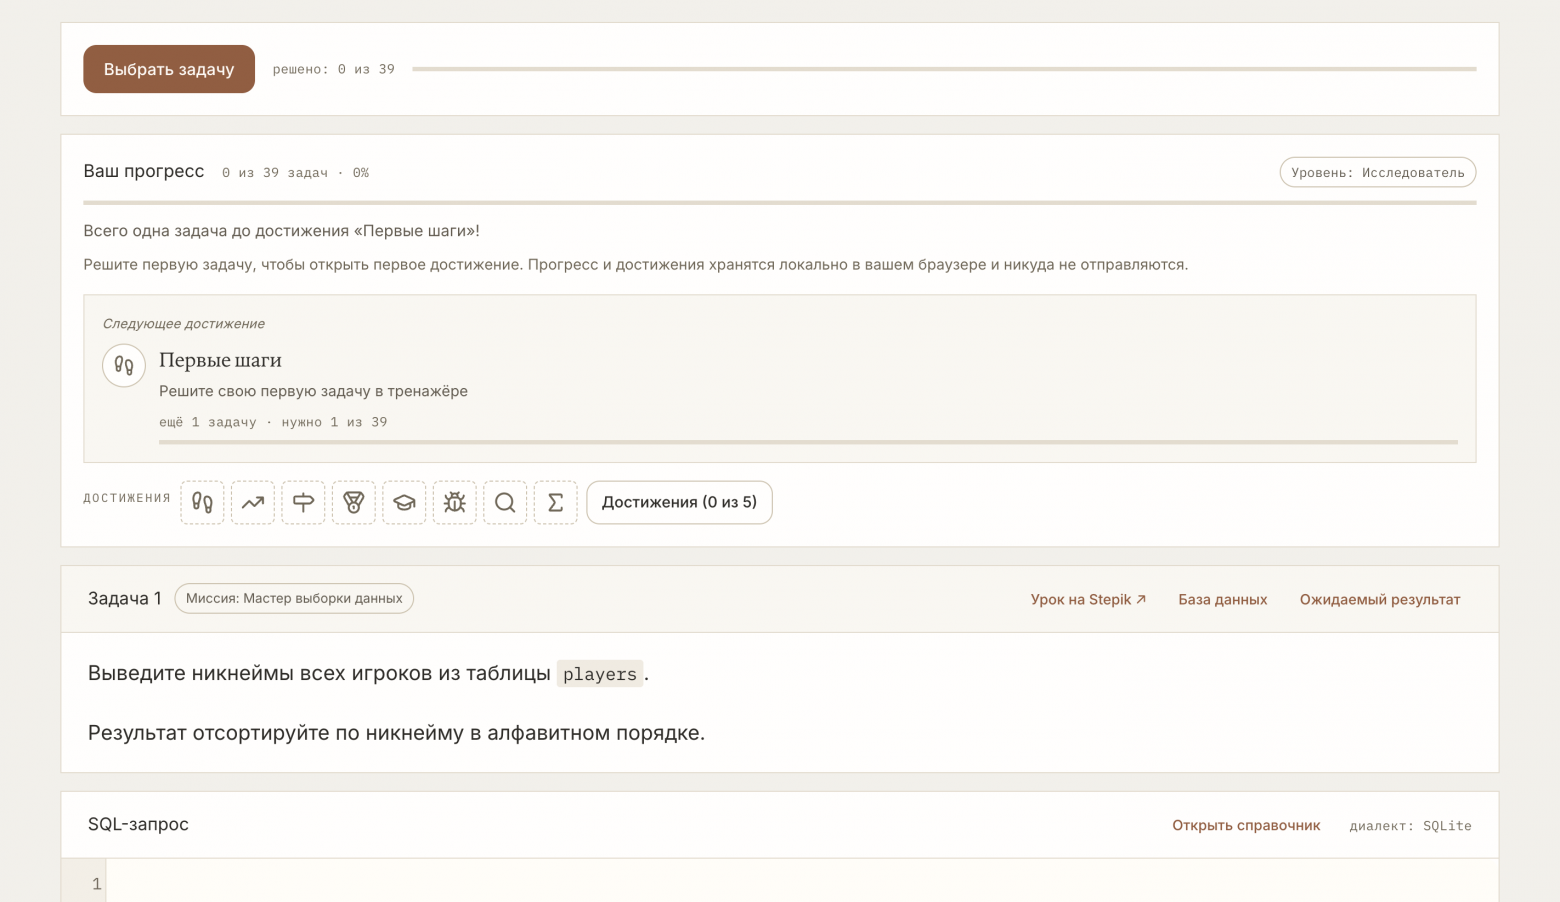
Следующим компонентом стал SQL Trainer.
Я перенёс в него практические задания из собственного курса «SQL Введение». Сейчас тренажёр содержит 39 заданий с автоматической проверкой результатов.
Принцип работы отличается от обычного тестирования, где достаточно выбрать правильный вариант ответа.
Пользователь самостоятельно пишет SQL-запрос, а система выполняет его и сравнивает полученный результат с эталонным.
Таким образом, проверяется не совпадение текста запроса, а корректность результата выполнения.
В тренажёре также реализованы уровни, достижения, контроль прогресса и дополнительные механики мотивации.
Образовательные игры
Отдельное направление платформы — образовательные игры.
Мне хотелось сделать изучение SQL менее однообразным и предложить альтернативные способы закрепления материала.
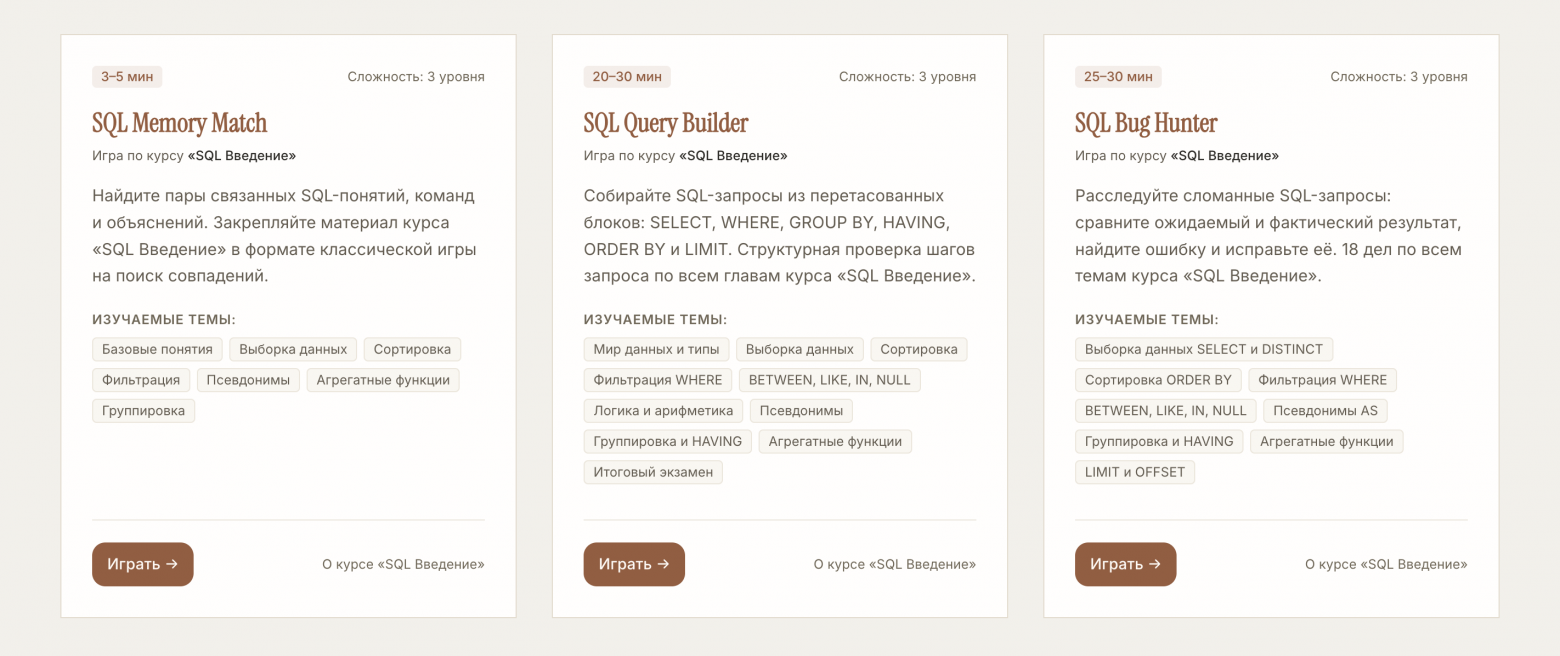
На данный момент реализованы три игры.
-
SQL Memory Match — игра на запоминание и сопоставление SQL-конструкций. Включает 26 пар карточек.
-
SQL Query Builder — конструктор SQL-запросов. Пользователь собирает запросы из отдельных блоков, выбирает правильные конструкции и учится находить ошибки. Игра включает 74 задания в 10 тематических модулях.
-
SQL Bug Hunter — игра, в которой необходимо искать и исправлять ошибки в SQL-запросах. Сейчас доступно 18 игровых сценариев.
Мне было важно, чтобы эти игры были не просто декоративными элементами сайта. Они должны помогать закреплять реальные знания и давать возможность взаимодействовать с SQL в разных форматах.
Набор SQL-инструментов
Помимо непосредственно учебных компонентов, я разработал отдельный раздел инструментов.
Сейчас он включает:
-
SQL Editor — интерактивный SQL-редактор для работы с базами данных SQLite, выполнения запросов и экспорта результатов.
-
SQL Explainer — инструмент для структурного разбора SQL-запросов и объяснения их элементов на русском языке.
-
SQL Formatter — инструмент форматирования SQL-кода.
Отдельно стоит отметить SQL Editor. В нём реализована система экспорта результатов в 25 представлений и форматов, включая JSON, CSV, YAML, Markdown, HTML, XML, XLSX и другие варианты.
Это делает редактор полезным не только для новичков, но и для тех, кто уже работает с SQL и хочет быстро преобразовать результаты запросов в нужный формат.
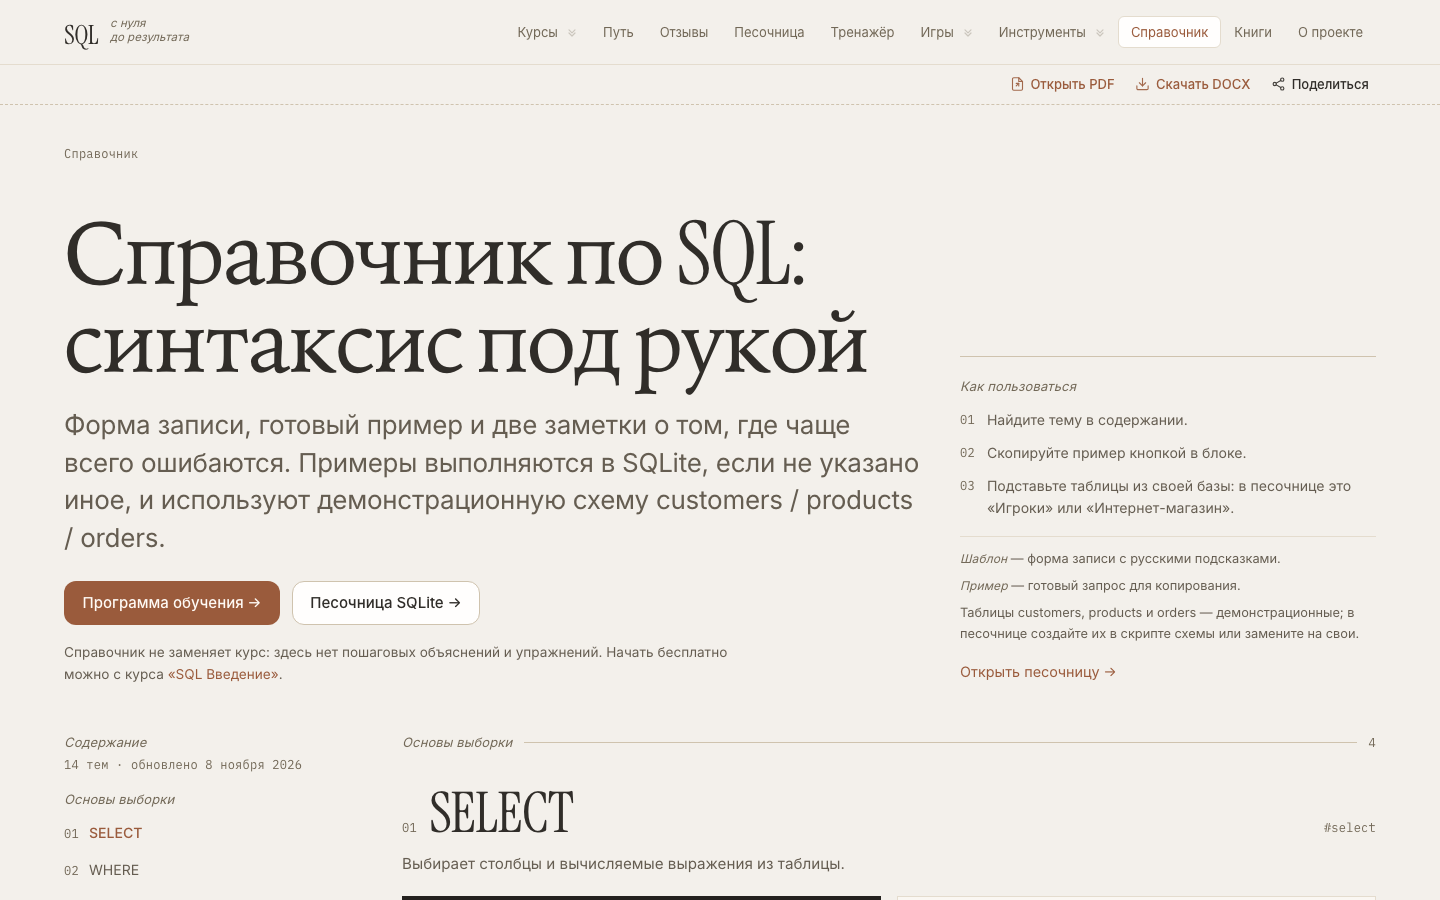
Кроме того, на платформе есть справочник SQL, онлайн-версия книги, каталог курсов, система сертификатов и статистика образовательных материалов.
Всё это постепенно превращается в единую систему, где каждый инструмент дополняет остальные.
4. Техническая реализация: почему я выбрал именно такую архитектуру
Теперь немного о технической стороне проекта.
Одна из главных особенностей реализации заключается в том, что платформа не использует традиционную серверную архитектуру с отдельным backend для выполнения SQL-запросов.
Мне хотелось сделать инструменты максимально доступными: открыл страницу и сразу работаешь.
В результате значительная часть функциональности реализована непосредственно на стороне браузера.
Основной технологический стек:
-
Astro 7
-
TypeScript
-
Vue 3
-
Tailwind CSS 4
-
SQLite через sql.js и WebAssembly.
-
CodeMirror 6.
Для меня было важно разделить обычные страницы и интерактивные инструменты.
Astro отвечает за генерацию статического HTML, а Vue-компоненты подключаются там, где действительно нужна интерактивность.
Таким образом, обычные информационные страницы не требуют загрузки полноценного клиентского приложения.
А тяжёлые интерактивные компоненты загружаются только на тех страницах, где они необходимы.
SQLite и WebAssembly непосредственно в браузере
Одним из наиболее интересных технических решений стало использование sql.js.
Это реализация SQLite, скомпилированная в WebAssembly.
Благодаря этому пользователь может создавать таблицы, выполнять запросы, изменять данные и получать результаты непосредственно в браузере.
Никакой отдельный сервер базы данных для этого не требуется.
При этом я решил использовать две демонстрационные базы данных из своих курсов: «Интернет-магазин» и «Игроки».
Они позволяют выполнять упражнения и экспериментировать с запросами на заранее подготовленных наборах данных.
Есть и важный нюанс: основной учебный материал курса ориентирован на MySQL, тогда как браузерный движок использует SQLite. Это разные СУБД, поэтому некоторые синтаксические особенности и возможности отличаются. Я явно обозначаю это ограничение на страницах инструментов.
Как работает проверка заданий
Для меня было принципиально важно, чтобы тренажёр действительно проверял SQL, а не просто сравнивал введённый текст с готовым ответом.
Поэтому при выполнении задания создаётся отдельная база данных, в неё загружается начальное состояние, запускается пользовательский запрос, а затем результат сравнивается с результатом эталонного запроса.
Это позволяет принимать разные SQL-запросы, если они действительно возвращают правильные данные.
Подобный подход применяется и в игровых механиках: ожидаемые результаты формируются на основе работы SQL-движка, а не задаются произвольными текстовыми значениями.
5. Работа без backend: состояние, сохранение и обмен данными
Отказ от традиционного backend потребовал продумать несколько интересных решений.
На платформе нет пользовательских аккаунтов, серверного хранилища прогресса и базы данных для индивидуальных сессий.
Прогресс тренажёра и игр сохраняется локально в браузере с использованием localStorage.
Это упрощает инфраструктуру, но имеет очевидное ограничение: данные не синхронизируются между разными устройствами и браузерами.
Отдельная интересная задача — возможность поделиться результатом работы.
Например, пользователь может подготовить SQL-запрос в редакторе и передать ссылку, по которой другой человек откроет соответствующее состояние инструмента.
Для этого используется фрагмент URL, содержащий сериализованное и сжатое состояние.
Перед передачей данные сжимаются с помощью pako и кодируются в base64url.
Таким образом, серверу не требуется хранить пользовательские запросы или создавать отдельные идентификаторы сессий.
При этом предусмотрены ограничения на размер передаваемых данных и размер распакованного содержимого, чтобы не допускать чрезмерных нагрузок на браузер.
Подобный подход используется не только для обмена состоянием инструментов, но и в системе формирования сертификатов.
6. Единый контент в нескольких форматах: HTML, Markdown, PDF и DOCX
Ещё одна интересная часть проекта, которая может быть полезна не только образовательным платформам, — система публикации материалов в нескольких форматах.
Мне не хотелось поддерживать отдельные версии одного и того же материала для сайта, PDF и DOCX.
Это неизбежно приводит к расхождениям и дополнительной работе при каждом обновлении.
Поэтому я реализовал конвейер генерации документов.
Основной принцип заключается в том, что содержимое страницы преобразуется в Markdown, который затем используется для формирования дополнительных представлений.
В результате из одного источника можно получать:
-
HTML-страницу на сайте;
-
Markdown-версию;
-
структурированный список материалов для языковых моделей через llms.txt;
-
PDF-документы с фирменным оформлением;
-
DOCX-документы для редактирования.
Для генерации PDF используется Playwright и Chromium, а для DOCX — библиотека docx.
Отдельно разработана система генерации Open Graph изображений для страниц сайта.
Таким образом, образовательные материалы можно использовать не только непосредственно на платформе, но и скачивать, сохранять, распространять и читать в привычных форматах.
На некоторых страницах сайта эта функциональность представлена непосредственно пользователю в виде кнопок открытия PDF и скачивания DOCX.
7. Статистика и работа с внешними источниками данных
На сайте есть отдельный раздел статистики образовательных материалов.
Здесь возникла ещё одна инженерная задача.
Я не хотел, чтобы сборка сайта напрямую зависела от доступности сторонних статистических API.
Поэтому данные из публичного API StepStat и статистика скачиваний книги с GitHub получаются на этапе обновления данных и сохраняются в репозитории в виде JSON-снимков.
Сайт использует уже подготовленные данные, а не обращается к внешним API при каждом открытии страницы.
Дополнительно на сайте есть отдельная страница, объясняющая методологию получения статистики.
Мне кажется важным не просто показывать красивые цифры, но и объяснять, откуда они взялись и когда были обновлены.
8. Что ещё предстоит сделать
На данный момент платформа уже включает достаточно много самостоятельных инструментов, но я не считаю её завершённым продуктом.
Есть несколько направлений, которые хотелось бы развить дальше.
В частности:
-
расширить интерактивную практику и количество заданий
-
продолжить развитие образовательных игр
-
развивать SQL-инструменты
9. Итоги
Если посмотреть на весь путь, то исходная задача была достаточно простой: сделать доступный бесплатный курс, который поможет человеку познакомиться с SQL.
Затем появилась книга, которая сделала учебные материалы удобнее.
Но постепенно стало понятно, что одного образовательного контента недостаточно. Человеку нужны инструменты для практики, обратная связь, возможность экспериментировать и разные способы закрепления знаний.
Так курс и книга стали основой для самостоятельного программного продукта.
Сегодня «SQL с нуля до результата» — это уже не просто страница с учебными материалами. Это образовательная экосистема, объединяющая учебный маршрут, интерактивную песочницу, тренажёр, игры, справочник, книгу и набор SQL-инструментов.
Для меня особенно интересно, что всё это удалось реализовать без отдельного backend и серверной базы данных, используя статическую архитектуру сайта и возможности современных браузеров.
Конечно, у такого подхода есть ограничения, но для поставленной задачи он оказался вполне оправданным.
Продолжу развивать проект, добавлять новые возможности и постепенно улучшать существующие инструменты.
Ссылки на проект и образовательные материалы:
-
Платформа «SQL с нуля до результата»: https://sql.sergeyromanenko.com/
-
Бесплатный курс «SQL Введение»: https://stepik.org/course/290855
-
Книга «SQL Введение» на GitHub: https://github.com/Awilum/sql-introduction
Буду рад обратной связи, замечаниям и предложениям. Особенно интересно узнать мнение разработчиков, преподавателей и тех, кто сейчас изучает SQL.
ссылка на оригинал статьи https://habr.com/ru/articles/1109962/