Рой дронов держит строй без GPS: адаптивный консенсус и цена его точности
Адаптивный закон настройки коэффициентов, который я взял из классической литературы по мультиагентным системам, удерживал строй роя из шести дронов лучше всех: при порыве ветра ошибка 0,36 м против 0,89 м у вручную настроенного регулятора. Но при этом 67 % времени хотя бы один аппарат работал на пределе тяги, а затраты на управление были в 3,5 раза выше. Коэффициенты регулятора подскакивали на каждом крупном манёвре и обратно уже не опускались. В статье разберу, откуда берётся этот эффект и как одна строчка в законе адаптации превращает его в управляемый компромисс между точностью и энергией.
Текст написан по мотивам нашей с научным руководителем В. В. Семеновым статьи и является частью моей выпускной работы на кафедре инженерной кибернетики НИТУ «МИСИС».
Задача: строй без глобальных координат
Группы небольших дронов летают на мониторинг местности, поисково-спасательные работы, ретрансляцию связи и картографирование. Несколько дешёвых аппаратов покрывают большую площадь, чем один дорогой, и переживают потерю отдельных участников [1, 2]. Многие такие задачи требуют полёта строем: фигуру нужно держать на манёврах, перестраивать по команде и не терять при порывах ветра.
Управлять строем с наземной станции можно, но такая схема плохо масштабируется и перестаёт работать вместе с каналом связи. Поэтому в групповом управлении обычно используют распределённый подход: каждый аппарат считает своё управление сам, по информации только от ближайших соседей [3, 4]. Математическая основа — консенсусные протоколы, в которых агенты приходят к согласованным координатам и скоростям через локальный обмен данными [5, 6].
Я добавил ещё одно ограничение: никакой спутниковой навигации. Каждый дрон знает только относительное положение и скорость соседей — например, от UWB-радиомодулей [7] или камер. Это не экзотика: рой микродронов уже летал в лесу на одних бортовых датчиках и относительной локализации [8].
Модель
Будем считать, что автопилот отрабатывает заданное ускорение. Тогда каждый из  аппаратов — двойной интегратор:
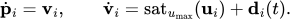
Здесь  и
 — положение и скорость,
 — командное ускорение,
 ограничивает его величину значением
 , а
 — неизвестное возмущение, например ветер.
Кто кого видит, задаёт граф связи с матрицей смежности  :
 , если аппараты
 и
 измеряют взаимное положение и скорость. Траекторию строя задаёт виртуальный лидер с номером 0, но видят его не все, а только агенты с
 . Строй — это набор смещений
 относительно лидера, а ошибка строя -го аппарата равна
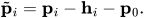
Нужно, чтобы эта ошибка сходилась к нулю, строй перестраивался по команде и переживал обрыв части каналов. И чтобы коэффициенты регулятора и затраты на управление оставались ограниченными при шуме измерений и неизвестном ускорении лидера. Последнее требование окажется самым интересным.
Сразу оговорю две вещи, которые модель выносит за скобки. Во-первых, «видеть» виртуального лидера без GPS можно двумя способами. Либо лидер — реальный аппарат со своей навигацией, и соседи измеряют положение относительно него. Либо лидер — точка, заданная в системе бортовой одометрии агента (например, визуально-инерциальной), и тогда дрейф одометрии превращается в медленный дрейф всего строя. Во-вторых, относительные векторы от разных аппаратов складываются, только если выражены в общих осях, то есть дронам нужен согласованный курс. В модели оба условия считаются выполненными.
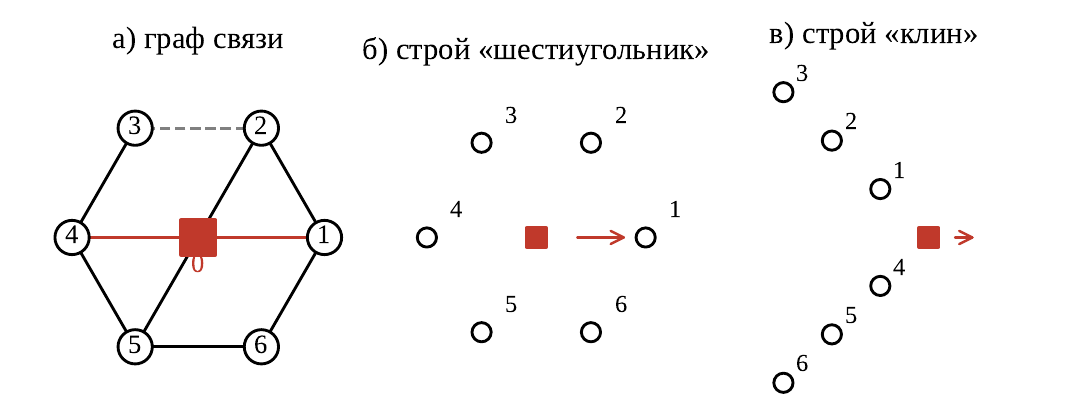
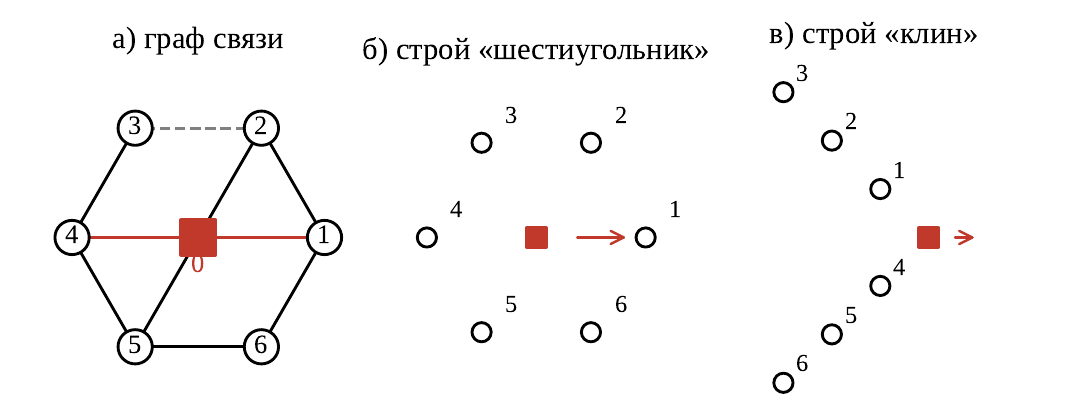
Рис. 1. Граф связи (штриховые рёбра обрываются в полёте, красным — связи с виртуальным лидером 0) и смещения агентов в двух строях
Консенсус на пальцах
Удобно работать в координатах строя. Для каждого аппарата берём вектор состояния из его смещённого положения и скорости. Тогда по каждой оси динамика линейная:
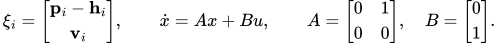
Матрицу усиления удобно взять из алгебраического уравнения Риккати. Для двойного интегратора у него есть решение в замкнутом виде, его легко проверить подстановкой:
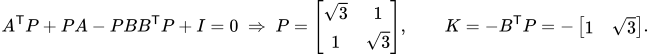
Сам протокол — это сумма рассогласований с соседями и лидером, умноженная на  :
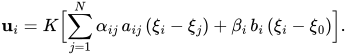
Каждый аппарат тянется к соседям и, если видит лидера, к лидеру. Коэффициенты  и
 говорят, насколько сильно. В простейшем варианте все они равны одному числу
 .
Какое выбрать? Сведём граф в матрицу 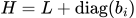 , где
 — лапласиан графа. Для связного графа, где лидера видит хотя бы один агент, она положительно определена. Система распадается на независимые моды по собственным числам
 матрицы
 , и для каждой моды характеристический многочлен равен
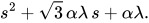
Все коэффициенты положительны, так что для двойного интегратора строй сходится при любом  , если не упираться в ограничение тяги. Известное условие
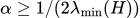 [9] нужно для общих линейных агентов, а здесь оно лишь достаточное. Для моего графа
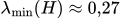 , и
 этому условию не удовлетворяет, но рой всё равно собирается.
Проблема в другом: от зависит качество. Малое даёт медленный строй с большой ошибкой, большое усиливает шум измерений и тратит энергию. Где лучшая точка, зависит от собственных чисел всего графа и от уровня шума. Отдельный дрон графа целиком не знает, а граф меняется при обрывах каналов.
Пусть коэффициенты подстраиваются сами
Чтобы обойтись без глобальной информации, коэффициенты каждого ребра и связи с лидером настраивают по локальной ошибке [10, 11]:
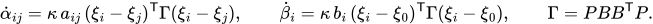
Здесь  — скорость адаптации, стартуют все коэффициенты с одного значения
 . Каждый аппарат считает этот закон по тем же относительным измерениям, что и управление. Чтобы и
 совпадали, оба конца ребра должны работать с одним и тем же измерением. Если каждый аппарат меряет сам, со своим шумом, коэффициенты на концах ребра начнут расходиться, и их придётся согласовывать по каналу связи.
У формулы простой смысл. Если подставить  , по каждой оси получится
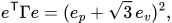
где  и
 — рассогласование по положению и скорости. В скобках стоит тот же сигнал, на который реагирует регулятор . Коэффициент растёт пропорционально квадрату «того, что регулятору не нравится»: большая ошибка — быстрый рост связи.
Для фиксированного связного графа, без шума и возмущений и при лидере с постоянной скоростью сходимость доказывается функцией Ляпунова
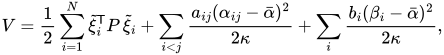
где  — ошибка относительно лидера, а
 — константа, не меньшая
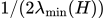 . Слагаемые с коэффициентами сокращаются, и производная получается не больше
 . Отсюда коэффициенты ограничены, а ошибки сходятся к нулю [10, 11]. Константа нужна только для доказательства, в реализации её нет.
Ловушка: коэффициенты только растут
Обратите внимание на оговорку «без шума и возмущений». В законе адаптации стоят только неотрицательные слагаемые, поэтому коэффициенты никогда не убывают. Любой большой переходный процесс — сборка роя, команда на перестроение — поднимает их, и опуститься обратно они уже не могут. А когда ошибка не обнуляется до конца из-за шума или неизвестного ускорения лидера, коэффициенты продолжают медленно ползти вверх. В адаптивном управлении это давно известный эффект — параметрический дрейф [12].
Против него есть стандартные средства: σ-модификация (утечка), зона нечувствительности и проекция [12, 13]. Для адаптивного консенсуса их тоже применяли, например в [14]. Модифицированный закон выглядит так:
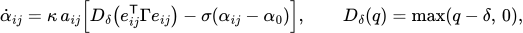
где  . Три изменения:
-
зона нечувствительности
 : маленькие рассогласования, на уровне шума, коэффициент не трогают;
-
утечка с коэффициентом
 : тянет коэффициент обратно к базовому , когда ошибка мала; постоянная времени возврата равна
 ;
-
проекция: коэффициент обрезается до отрезка
 .
Закон для меняется так же. Утечка добавляет в производную функции Ляпунова слагаемое, которое при больших коэффициентах отрицательно и растёт как 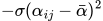 . Поэтому ошибки и коэффициенты остаются ограниченными при ограниченных возмущениях и шуме. Платить за это приходится остаточной ошибкой, которая растёт с . Меня интересовало, сколько именно стоит этот компромисс на дронах, поэтому дальше — численный эксперимент.
Как это выглядит в коде
Упрощённая иллюстрация одного шага протокола с робастной настройкой (на numpy, для наглядности, без векторизации по агентам и без шума):
import numpy as npSQ3 = np.sqrt(3.0)def s(e): """B^T P e по каждой оси. e[0] -- ошибка положения, e[1] -- скорости.""" return e[0] + SQ3 * e[1]def step(xi, xi0, adj, b, alpha, beta, dt, kappa=0.5, sigma=0.05, delta=0.05, a0=1.0, amax=50.0, umax=6.0): """Один шаг консенсусного протокола с робастной настройкой. xi -- (N, 2, 3): [p_i - h_i, v_i] по трём осям для каждого агента; xi0 -- (2, 3): положение и скорость лидера; adj -- (N, N) матрица смежности, b -- (N,) доступ к лидеру; alpha -- (N, N) коэффициенты рёбер, beta -- (N,) связи с лидером. """ n = len(xi) u = np.zeros((n, 3)) d_alpha = np.zeros_like(alpha) d_beta = np.zeros_like(beta) for i in range(n): acc = np.zeros(3) for j in range(n): if adj[i, j]: e = s(xi[i] - xi[j]) acc += alpha[i, j] * e q = e @ e # e^T Γ e по всем осям d_alpha[i, j] = kappa * (max(q - delta, 0.0) - sigma * (alpha[i, j] - a0)) if b[i]: e = s(xi[i] - xi0) acc += beta[i] * e q = e @ e d_beta[i] = kappa * (max(q - delta, 0.0) - sigma * (beta[i] - a0)) u[i] = -acc # K = -B^T P norm = np.linalg.norm(u[i]) if norm > umax: # насыщение u[i] *= umax / norm alpha = np.clip(alpha + dt * d_alpha, a0, amax) # проекция beta = np.clip(beta + dt * d_beta, a0, amax) return u, alpha, beta
Если подать на вход шесть аппаратов в случайных точках и лидера, летящего по прямой, рой собирается в шестиугольник, а коэффициенты сначала подскакивают, потом возвращаются вниз.
Эксперимент
Шесть дронов. Граф связи — кольцо и две диагонали, лидера видят агенты 1 и 4 (рис. 1). Сценарий на 80 секунд:
-
старт из случайного положения, сборка в правильный шестиугольник радиусом 5 м;
-
на 25-й секунде команда перестроиться в клин с эшелонированием по высоте;
-
лидер летит 4 м/с по прямой, с 30-й секунды — по окружности радиусом 50 м, его ускорение остальным неизвестно;
-
на 45-й секунде обрываются каналы 2–3 и 1–4, граф остаётся связным;
-
с 55-й по 65-ю секунду на всех действует порыв ветра около 2,2 м/с² с колебательной составляющей 0,5 Гц;
-
шум относительных измерений: СКО 0,05 м по положению и 0,025 м/с по скорости.
|
Параметр |
Значение |
|---|---|
|
Число агентов |
6 |
|
Шаг интегрирования / длительность |
0,01 с / 80 с |
|
Ограничение ускорения |
6 м/с² |
|
Начальный коэффициент |
1 |
|
Скорость адаптации |
0,5 |
|
Коэффициент утечки |
0,05 |
|
Зона нечувствительности |
0,05 |
|
Верхняя граница |
50 |
|
СКО шума положения / скорости |
0,05 м / 0,025 м/с |
Сравнивал четыре варианта протокола: фиксированный коэффициент ; фиксированный  , подобранный вручную перебором под этот сценарий; адаптивный закон без регуляризации (
 ); робастный закон (
 ). Начальные условия и реализация шума у всех одинаковые.
Метрики: время установления  (после него максимальная ошибка строя не превышает 0,5 м), СКО ошибки строя на развороте, после обрыва и при порыве, максимальная ошибка при порыве, доля времени в насыщении и затраты на управление
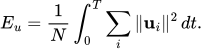
Вот как летит рой с робастным протоколом: собирается в шестиугольник, перестраивается в клин и держит его на развороте, после обрыва связей и при порыве ветра.
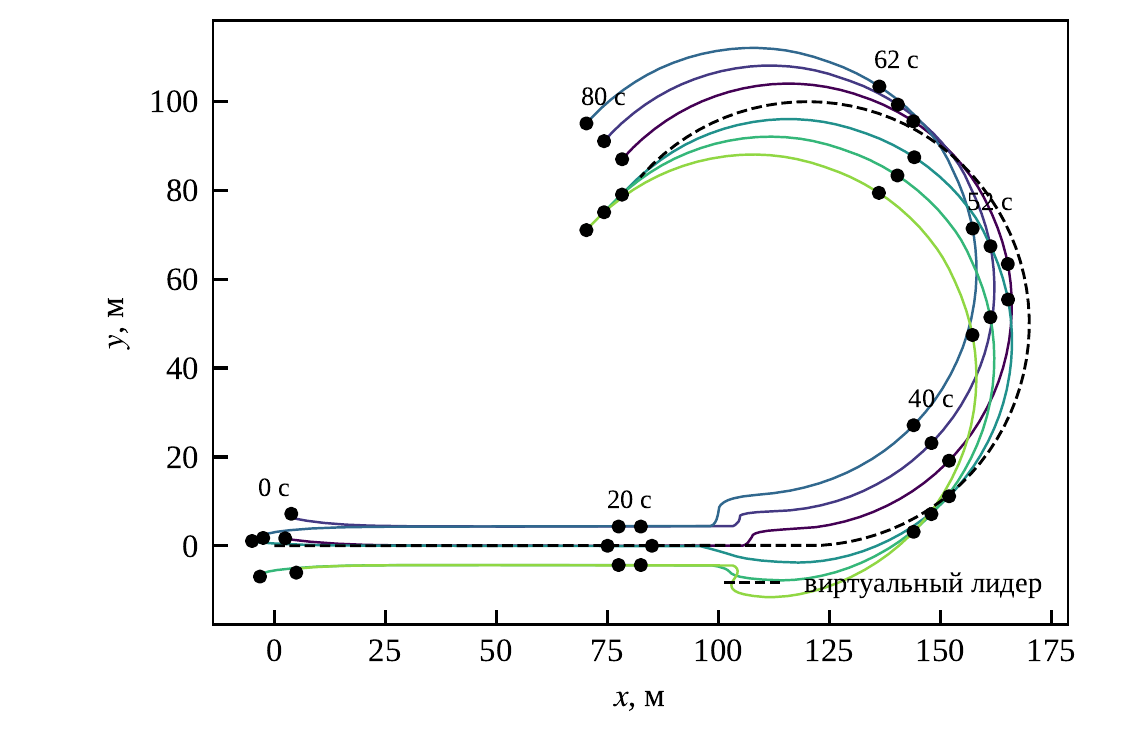
Рис. 2. Траектории дронов в горизонтальной плоскости при робастном адаптивном протоколе (σ = 0,05); точками отмечены положения агентов в указанные моменты времени
Результаты
|
Показатель |
Фикс. α = 1 |
Фикс. α = 8 |
Адапт. σ = 0 |
Адапт. σ = 0,05 |
|---|---|---|---|---|
|
|
11,9 |
4,3 |
4,4 |
4,4 |
|
|
— |
6,3 |
6,7 |
6,6 |
|
СКО на развороте, м |
1,36 |
0,15 |
0,08 |
0,10 |
|
СКО после обрыва, м |
1,18 |
0,15 |
0,07 |
0,12 |
|
СКО при порыве, м |
7,78 |
0,89 |
0,36 |
0,77 |
|
Макс. ошибка при порыве, м |
10,9 |
1,15 |
0,57 |
1,17 |
|
|
110 |
360 |
1259 |
536 |
|
Доля времени в насыщении, % |
1,4 |
3,1 |
67,4 |
18,4 |
|
Макс. коэффициент в конце |
1 |
8 |
39,3 |
9,4 |
 , м²/с³
С рой собирается почти 12 секунд и не успевает перестроиться до обрыва связей. При порыве ошибка доходит до 10,9 м — вдвое больше радиуса строя. Остальные три варианта собираются за 4,3–4,4 с и перестраиваются за 6,3–6,7 с.
На развороте адаптивные протоколы точнее настроенного вручную: 0,08–0,10 м против 0,15 м. Но сравнение не совсем равное. К развороту их максимальные коэффициенты после перестроения уже 20–40, то есть они просто работают с более сильной связью, чем .
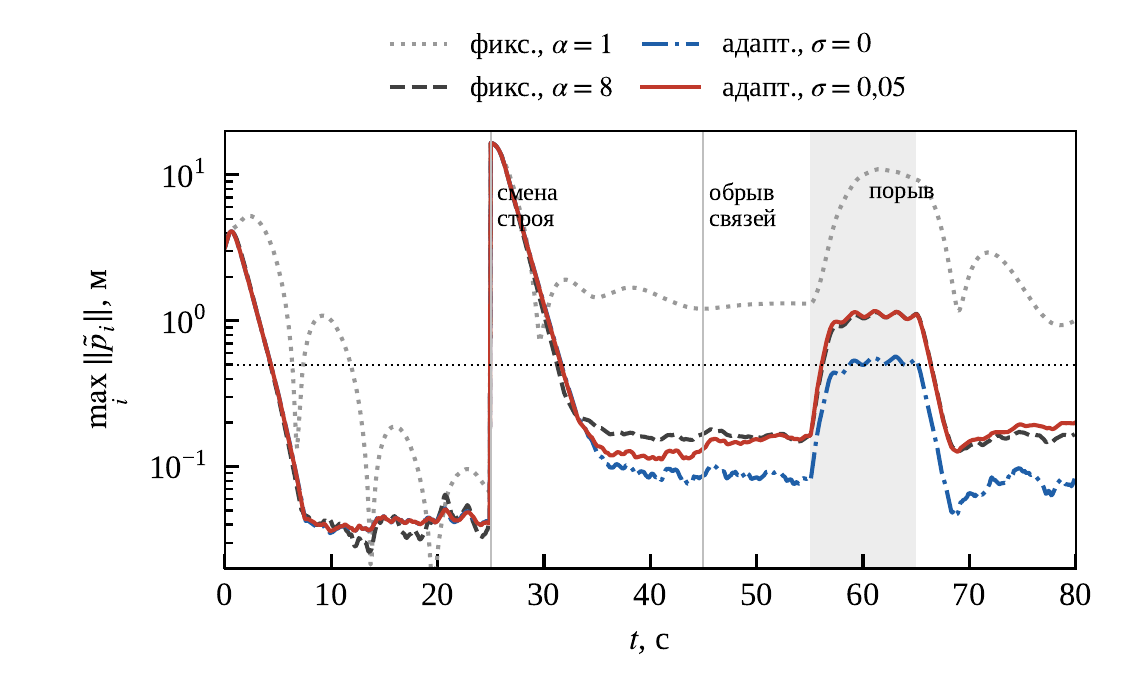
Рис. 3. Максимальная по агентам ошибка строя; вертикальные линии — смена строя и обрыв каналов связи, серая полоса — порыв ветра, пунктир — порог 0,5 м
Чемпион по точности, который сжигает батарею
Адаптивный закон без регуляризации даёт наименьшую ошибку: при порыве 0,36 м против 0,89 м у , почти в 2,5 раза меньше. Но затраты на управление в 3,5 раза больше, хотя бы один аппарат 67 % времени висит в насыщении, а коэффициенты к концу полёта доходят до 39,3.
Откуда берётся такой рост, хорошо видно на рис. 4. Коэффициенты растут не плавно, а ступенями. При сборке максимальный подскакивает примерно до 20, при команде на перестроение — примерно до 38. Обе ступени — реакция на большое рассогласование, когда дронам надо пролететь несколько метров до своих мест. После этого рост почти останавливается: за следующие 50 секунд разворота, обрыва связей и порыва и максимум, и среднее по рёбрам прибавляют меньше единицы. Это и есть дрейф от неизвестного ускорения лидера и шума, но за 80 секунд он вносит немного. Главная беда в том, что поднятые на манёврах коэффициенты больше не опускаются.
На сами коэффициенты шум почти не влияет: без шума к концу полёта они доходят до 38,2. Зато он решает всё в затратах. При СКО шума 0; 0,02; 0,05 и 0,1 м затраты на управление составили 412, 684, 1259 и 1836 м²/с³. Большие коэффициенты умножают шум измерений, и команда на ускорение упирается в ограничение.
Для настоящего дрона это плохо. Постоянное насыщение — это моторы на пределе и быстро севшая батарея, а шум, умноженный на большие коэффициенты, превращается в дрожание аппарата.
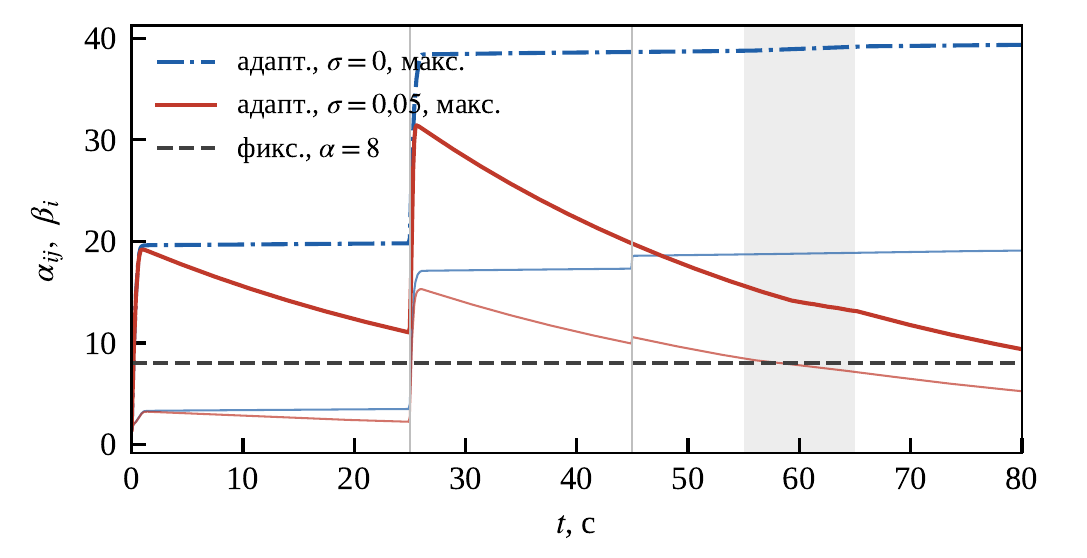
Рис. 4. Эволюция адаптивных коэффициентов: жирные линии — максимум по рёбрам и связям с лидером, тонкие — среднее по рёбрам. Скачок средних при t = 45 с вызван тем, что оборванные рёбра выпадают из среднего
Робастный закон ведёт себя иначе. При сборке и перестроении коэффициенты так же подскакивают — до 19 и 31. Но когда ошибка входит в зону нечувствительности, утечка возвращает их к базовому уровню с постоянной времени  с. К концу полёта максимальный коэффициент — 9,4. Точность при этом близка к вручную настроенному протоколу: при порыве 0,77 м против 0,89 м. Затраты на управление в 1,5 раза выше, в основном из-за пика коэффициентов при перестроении.
Главное: я нашёл перебором под конкретный сценарий. Адаптивному протоколу не нужно знать ни граф, ни возмущения. Его собственные параметры ( , ,
 ,
 ) подобраны один раз, и графа они не касаются.
Ручка «точность — энергия»
Главный параметр, которым задаётся рабочая точка, — коэффициент утечки . При росте от 0 до 0,2 затраты на управление падают с 1259 до 228 м²/с³, максимальный коэффициент — с 39,3 до 2,5, а СКО ошибки при порыве растёт с 0,36 до 1,63 м.
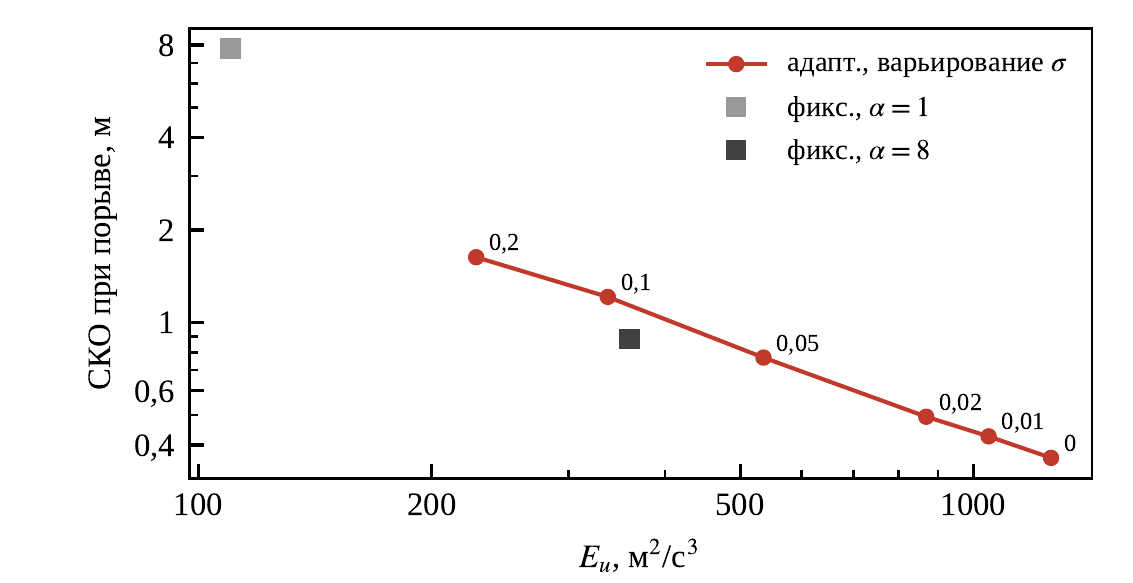
Рис. 5. Компромисс между СКО ошибки строя при порыве и затратами на управление; подписи точек — значения σ
Честно скажу: протокол с вручную подобранным лежит чуть ниже кривой адаптивных протоколов. Если сценарий известен заранее, хорошо настроенный фиксированный коэффициент энергетически выгоднее. Преимущество адаптации должно проявляться, когда условия отличаются от расчётных. Я увеличил амплитуду порыва:
|
Протокол |
СКО при порыве ×1, м |
СКО при порыве ×2, м |
Рост |
|---|---|---|---|
|
Фикс. α = 1 |
7,78 |
15,30 |
1,97 |
|
Фикс. α = 8 |
0,89 |
1,80 |
2,04 |
|
Адапт. σ = 0 |
0,36 |
0,84 |
2,32 |
|
Адапт. σ = 0,05 |
0,77 |
1,31 |
1,70 |
При удвоенном порыве ошибка настроенного вручную протокола выросла в 2 раза, а робастного адаптивного — в 1,7 раза, и он стал на 27 % точнее. При утроенном порыве (около 6,6 м/с²) возмущение превышает предельное ускорение 6 м/с², и строй не держит ни один протокол. Эта граница определяется тягой аппаратов, а не алгоритмом.
Здесь нужна важная оговорка. Порыв в моём сценарии начинается через 30 секунд после перестроения. Коэффициенты робастного протокола к этому моменту ещё не вернулись к базе: на рис. 4 видно, что во время порыва они около 13–16, то есть выше, чем . При этом во время порыва они не растут, а продолжают снижаться. Значит, часть выигрыша может объясняться тем, что порыв пришёл вскоре после манёвра, а не реакцией адаптации на сам порыв. Чтобы это разделить, нужен прогон, где порыв приходит после того, как коэффициенты вернулись к базовому уровню. Это ближайший эксперимент в моём списке.
Ограничения
-
Модель двойного интегратора не учитывает ориентацию и задержки автопилота. Для агрессивных манёвров нужна модель высокого порядка или каскадная схема управления.
-
Доказательство устойчивости не охватывает насыщение управления и переключение графа. Эти эффекты проверены только численно.
-
Все цифры получены на одной реализации шума. Статистика по серии запусков и лётный эксперимент — следующие шаги.
-
Смещения
при перестроении меняются ступенькой. Из-за этого адаптивный закон воспринимает команду как огромную ошибку, и коэффициенты подскакивают. Плавная смена смещений или заморозка адаптации на время перестроения, вероятно, заметно снизит пики коэффициентов и затраты.
Итог
Распределённый протокол с адаптивной настройкой коэффициентов держит строй роя на одних относительных измерениях, без GPS и без знания глобальных свойств графа. Классический адаптивный закон даёт наименьшую ошибку, но его коэффициенты только растут. Они поднимаются на каждом крупном манёвре, а в сочетании с шумом это оборачивается насыщением моторов 67 % времени и затратами в 3,5 раза выше. Робастная модификация с утечкой и зоной нечувствительности держит коэффициенты в рамках и без знания графа достигает точности вручную подобранного регулятора. Коэффициент утечки работает как ручка компромисса между точностью строя и энергией. При вдвое более сильном порыве робастный протокол в моём сценарии оказался на 27 % точнее, но эту цифру ещё предстоит проверить на сценарии, где порыв не следует сразу за манёвром.
Дальше в планах — задержки связи и динамика ориентации, доказательство устойчивости при переключаемом графе и ограниченном управлении и проверка на группе FPV-дронов с относительной навигацией по UWB.
Литература
-
Chung S.-J., Paranjape A.A., Dames P., Shen S., Kumar V. A survey on aerial swarm robotics // IEEE Transactions on Robotics. 2018. Vol. 34, No. 4. P. 837–855.
-
Coppola M., McGuire K.N., De Wagter C., de Croon G.C.H.E. A survey on swarming with micro air vehicles: Fundamental challenges and constraints // Frontiers in Robotics and AI. 2020. Vol. 7. Art. 18.
-
Olfati-Saber R., Fax J.A., Murray R.M. Consensus and cooperation in networked multi-agent systems // Proceedings of the IEEE. 2007. Vol. 95, No. 1. P. 215–233.
-
Ren W., Beard R.W. Distributed Consensus in Multi-vehicle Cooperative Control: Theory and Applications. London: Springer, 2008.
-
Olfati-Saber R., Murray R.M. Consensus problems in networks of agents with switching topology and time-delays // IEEE Transactions on Automatic Control. 2004. Vol. 49, No. 9. P. 1520–1533.
-
Ren W., Beard R.W. Consensus seeking in multiagent systems under dynamically changing interaction topologies // IEEE Transactions on Automatic Control. 2005. Vol. 50, No. 5. P. 655–661.
-
Guo K., Qiu Z., Meng W., Xie L., Teo R. Ultra-wideband based cooperative relative localization algorithm and experiments for multiple unmanned aerial vehicles in GPS denied environments // International Journal of Micro Air Vehicles. 2017. Vol. 9, No. 3. P. 169–186.
-
Zhou X. et al. Swarm of micro flying robots in the wild // Science Robotics. 2022. Vol. 7, No. 66. eabm5954.
-
Li Z., Duan Z., Chen G., Huang L. Consensus of multiagent systems and synchronization of complex networks: A unified viewpoint // IEEE Transactions on Circuits and Systems I: Regular Papers. 2010. Vol. 57, No. 1. P. 213–224.
-
Li Z., Ren W., Liu X., Fu M. Consensus of multi-agent systems with general linear and Lipschitz nonlinear dynamics using distributed adaptive protocols // IEEE Transactions on Automatic Control. 2013. Vol. 58, No. 7. P. 1786–1791. arXiv:1109.3799
-
Li Z., Ren W., Liu X., Xie L. Distributed consensus of linear multi-agent systems with adaptive dynamic protocols // Automatica. 2013. Vol. 49, No. 7. P. 1986–1995.
-
Ioannou P.A., Sun J. Robust Adaptive Control. Upper Saddle River: Prentice Hall, 1996.
-
Фрадков А.Л. Адаптивное управление в сложных системах: беспоисковые методы. М.: Наука, 1990.
-
Lv Y., Li Z., Duan Z., Feng G. Novel distributed robust adaptive consensus protocols for linear multi-agent systems with directed graphs and external disturbances. arXiv:1511.01331
ссылка на оригинал статьи https://habr.com/ru/articles/1110098/