Собрали руководителю поддержки отчет по обращениям, и он остался доволен. Но через неделю он попросил добавить цели по каждой группе, еще через неделю другой период, а потом вынести отдельно один тип задач. Каждая такая просьба — мелочь, но в стандартном конструкторе отчетов корпоративной системы пришлось бы делать каждый тип отдельно, а руководителю потом сверять вручную.
Мы попробовали по-другому: описали задачу словами в харнесе SimpleGen. На разработку готового решения ушло 17 сессий и примерно 17 часов с паузами. Ниже расскажем, что получилось, а что пришлось исправлять.
Почему стандартных отчетов не хватило
Формулировка у задачи была обманчиво простая: руководитель хочет видеть, справляется ли группа поддержки с потоком обращений. Пока вопрос был один, стандартные отчеты SimpleOne закрывали его без проблем. Потом добавились цели по группам, второй период и еще один тип задач, и на этом штатный инструмент закончился.
Стандартные отчеты и дашборды визуализируют данные таблиц и хорошо считают суммы. А вот баланс потока, медиана времени реакции, доля переоткрытых обращений и цели требуют отдельной логики расчета, особенно когда таблица истории, по нашей оценке, разрастается примерно до 30 млн записей.
Такой отчет нужен линейным руководителям, начальникам служб и направлений и ИТ-директорам. Если подходящего инструмента нет, они вручную листают списки обращений и пропускают критичные данные.
Для большой аналитики, конечно, есть BI, и годовую статистику правильнее строить именно там. Но поддержке нужны свои метрики, цели по группам и своя раскладка экрана, поэтому мы решили сделать отчет быстро и под конкретные задачи.
Как ИИ-агенты собирают отчет от спецификации до демо
Для разработки нужного отчета мы использовали SimpleGen — это инструмент ИИ-разработки на платформе SimpleOne, где ведут ITSM-процессы группы поддержки компании.
Весь процесс подробно показали на вебинаре — смотрите запись на RuTube. Дальше подробности текстом.
В SimpleGen работают ИИ-агенты под разные задачи: автор кода, исправитель, ревьюер и другие агенты. Путь от просьбы до готового отчета на стенде проходит четыре этапа, и времени на них уходит очень по-разному:
|
Этап |
Время |
Что внутри |
|
Спецификация |
около 5,5 часа |
11 итераций «написали и отревьюили», 28 вопросов агента |
|
План |
1,5 часа |
11 фаз, 42 задачи |
|
Код |
около 7 часов |
генерация по фазам, ревью, патч на стенд |
|
Демо |
около 2 часов |
сценарий, демоданные, прогон, правки |
Итого около 17 часов. По оценке владельца продукта, вручную такой отчет делали бы минимум вдвое дольше.
Больше всего времени заняла спецификация, и это самая окупаемая часть процесса. Вы пишете задачу свободным текстом, агент-автор собирает из нее документ, агент-ревьюер его проверяет, и так по кругу до вердикта «ок».
По дороге агент выясняет у вас все нюансы, и к этому, конечно, лучше отнестись внимательно. Если просто соглашаться со всем подряд не глядя, все пробелы в ТЗ агент заполнит по своему вкусу, и можно получить совсем не то что нужно. В нашем случае за 11 итераций подготовки спецификации агент задал 28 уточняющих вопросов, например:
-
что считать решенным обращением, с какого статуса и по какому коду закрытия;
-
на каких типах данных строить отчет и можно ли баланс потока уводить в минус;
-
как считать медиану времени реакции и какой у нее предел;
-
какую цель ставить, если у групп разные значения.
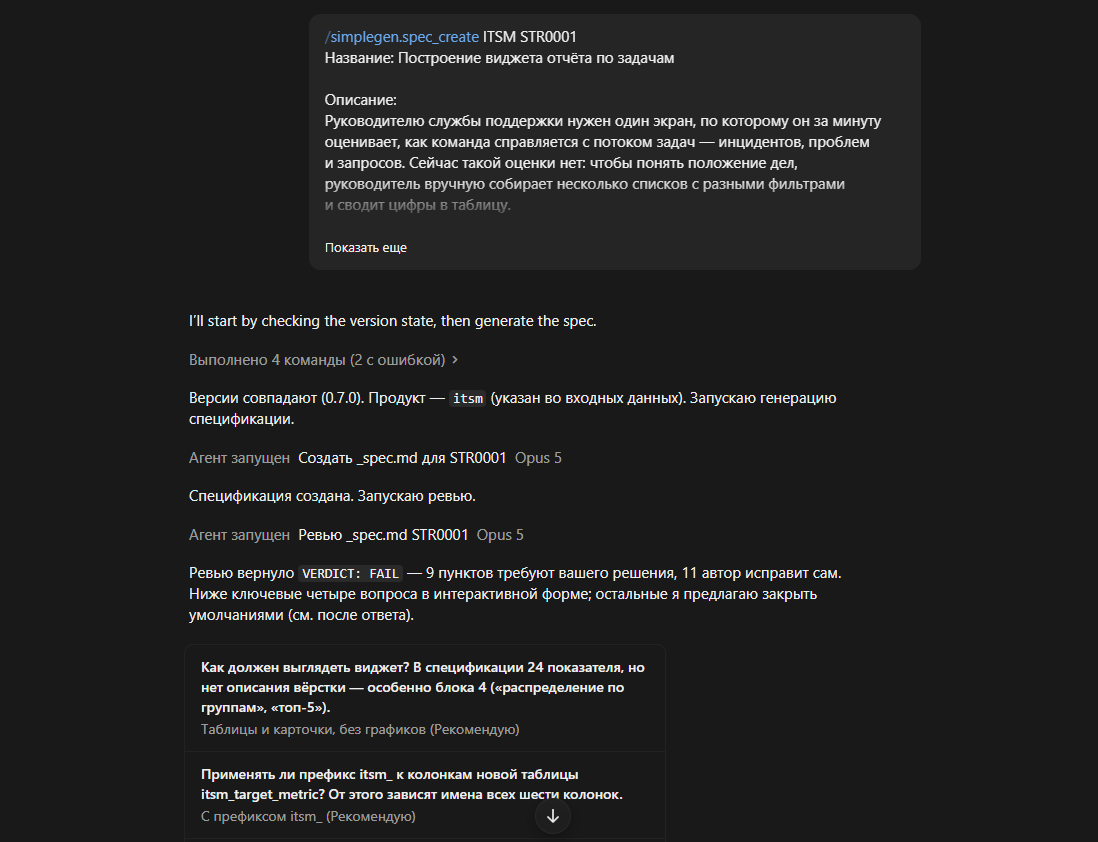
Отдельно на этом же этапе агент нашел места, где постановка разошлась со стендом. В описании было три наследника ITSM Task, а на стенде их десять, и учитывать нужно все. Статусы ожидания и коды закрытия в разных группах тоже оказались разными, поэтому пришлось отдельно согласовывать, что с ними делать.
Ответы агенту превращаются в формулы отчета, поэтому править их выгоднее сразу в спецификации, пока кода еще нет, потому что это заметно дешевле, чем переделывать готовый виджет. Сама спецификация лежит в Git вместе с планом, журналом изменений и логами, так что спорный расчет всегда можно проверить по первоисточнику.
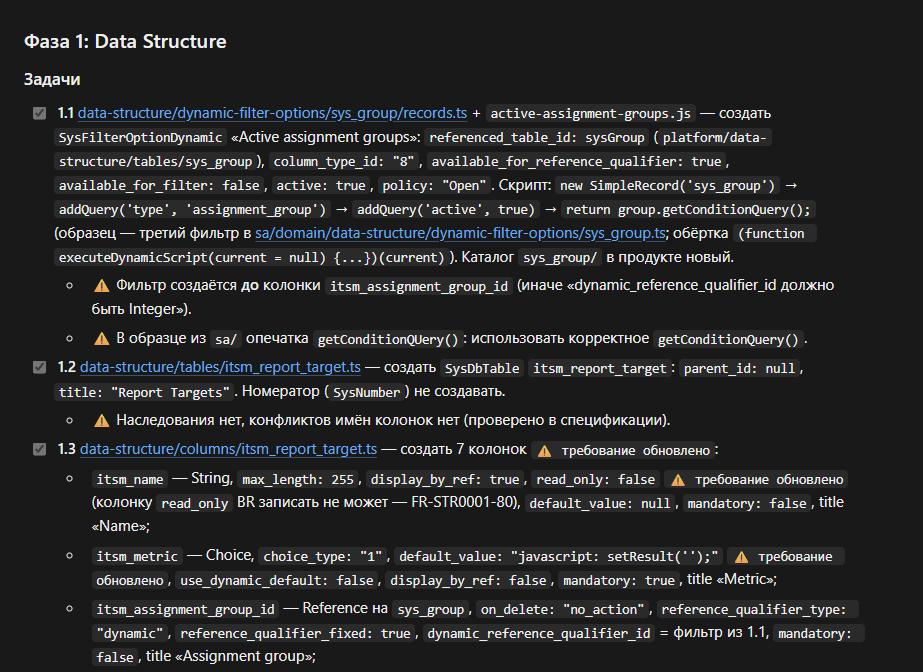
Когда спецификация была готова, SimpleGen разбил план на 11 фаз и 42 задачи. Код генерировался по фазам: в каждой сначала работал автор, потом ревьюер, потом шел патч на стенд, и деплой чаще всего проходил с первого раза. Ревью ловило то, что руками легко проскочить, например, пустое значение по умолчанию.
В результате мы для себя сформулировали золотые правила ИИ-разработки:
-
Отвечать на вопросы агента вдумчиво, потому что от ответов напрямую зависит результат.
-
Вносить изменения сначала в спецификацию, а код после этого пересоздавать по новому плану.
-
Генерировать и выкатывать по фазам, проверять каждую фазу на стенде отдельно, пока ошибка не затронула весь отчет.
-
Коммитить после каждого патча, чтобы всегда было куда откатиться.
-
Не пропускать demo run, потому что он находит дефекты, которых в коде не видно.
Что получилось: страница с фильтрами, блоками и целями
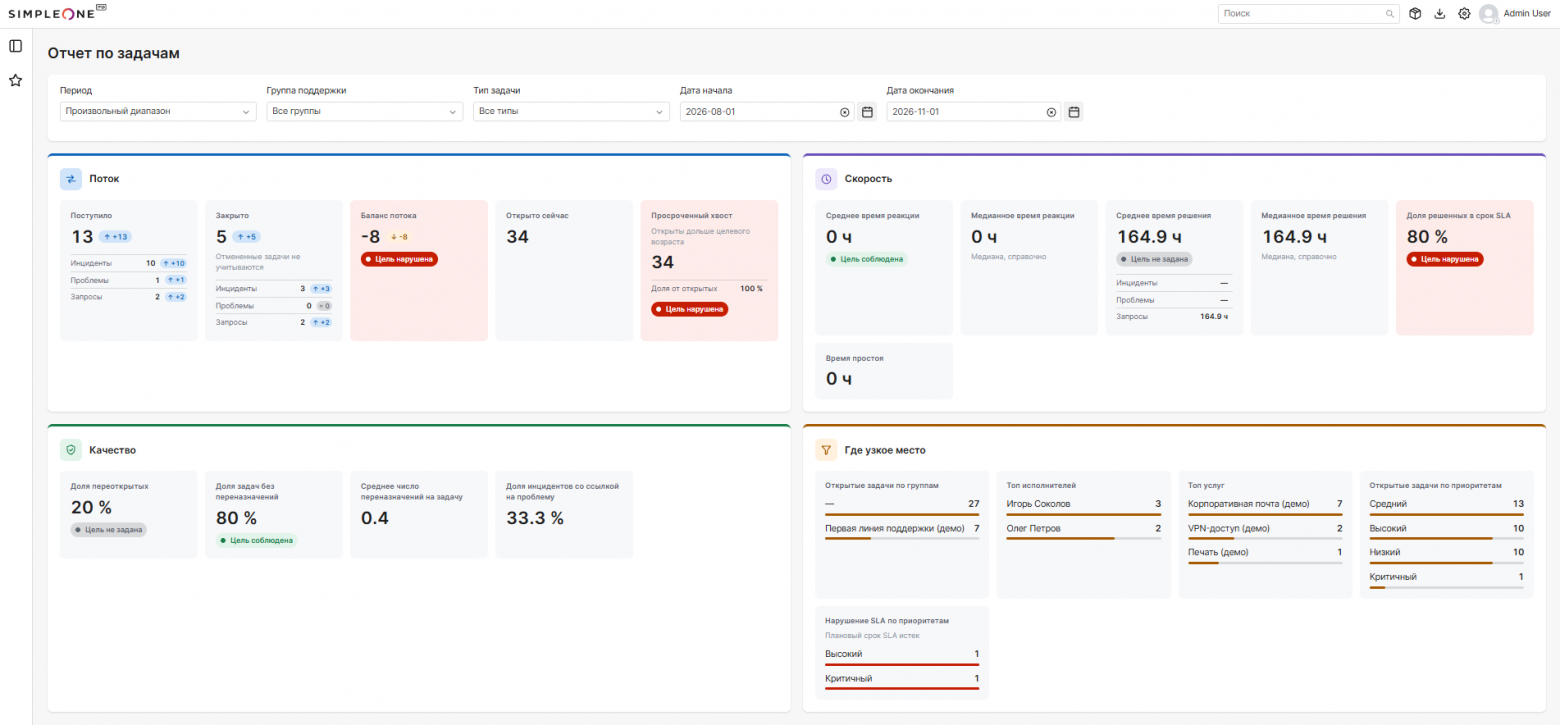
На выходе руководитель получил новую страницу и пункт в меню. Сверху три фильтра (период, группа поддержки и типы задач), а под ними четыре блока, которые отвечают на вопрос, как работает поддержка.
-
Поток: сколько обращений поступило и закрыто, какой баланс потока, сколько открыто сейчас и сколько просрочено.
-
Скорость: среднее и медианное время реакции плюс блок «узкое место».
-
Разрезы: разбивка по группам, топ исполнителей и услуг, приоритеты и нарушения SLA по приоритетам.
-
Качество: сколько обращений переоткрывали и сколько раз их переназначали.
-
Цели: отдельно живет справочник целей, и руководителям он нравится больше всего. Цель можно задать для любого показателя на странице. Например, для первой линии поддержки доля обращений, решенных в срок SLA, не должна опускаться ниже 75%. Если значение падает ниже цели, плитка краснеет, и руководитель видит это сразу, не дожидаясь конца месяца.
По объему получилось так:
-
В запросе на слияние набралось 169 записей и 161 файл, из них 130 файлов локализации, а код виджета занимает около 2 600 строк.
-
На стенде создано около 250 записей, и SOP из 288 записей ушел на чистый стенд без единой ручной правки в интерфейсе.
Сколько это стоило
Всего потратилось 786 330 токенов в Claude Code, и все это уложилось в подписку на модель Opus 5 за $20 в месяц, без превышения лимитов и доплат. Многие опасаются, что вариант через API, подходящий для корпоративных сценариев с требованиями к безопасности, окажется намного дороже. По нашим расчетам, тот же объем ответов стоил бы там $19,66 плюс оплата входящего контекста.
Что пришлось исправлять
Результат хороший, но не обошлось без проблем, и про них лучше знать заранее.
-
Деплой падал три раза. Стенд не принял длинную русскую подсказку с длинным тире (перевели на английский), в одном поле вместо строки пришел пустой массив, а в третий раз платформа сама создала форму, которую пытались создать повторно, и возник конфликт. Решается это командой
product sync, которая подтягивает форму в репозиторий, и каждая такая история занимала минут по пять. -
Демо прошло на 25 шагов из 28. Оставшиеся три требуют авторизации и ручных действий, которые агент по своим правилам не делает. Весь прогон с исправлениями занял около 7 минут и нашел два дефекта: пустой блок рисовался некорректно, а подсказки к полям целей вообще не были видны.
-
Расчеты нужно перепроверять. Код получился достаточно неплохой, но построчно его никто не читал, поэтому проверка формул остается за человеком.
И пара методологических моментов:
-
Часть метрик спорная. Блок «узкое место» назван неточно, потому что нарушения SLA по приоритетам дают обычную статистику, а узкое место из нее не следует. Баланс потока тоже вызывает вопросы, ведь обращения в ожидании ответа заказчика висят минусом, хотя команда на них повлиять не может. «Открыто сейчас» эксперт советует заменить динамикой хвоста.
-
Отчет ретроспективный. Он показывает, как команда справилась с потоком за прошедший период, но собирается и работает быстрее, чем массивная система отчетности. На стандартных дашбордах платформы можно посмотреть еще более оперативную картину.
С чего начать у себя
С ИИ-агентами аналитика под задачи конкретной службы больше не упирается в очередь в разработку. Условие одно: расчеты проверяет человек, и цели с правилами подсчета тоже формулирует он.
Начать можно с одной страницы текста: выпишите отчет, который у вас просят чаще остальных, какие цифры в нем нужны, какие цели к ним привязаны и что считается решенным обращением. А потом посчитайте, сколько раз его уже переделывали.
ссылка на оригинал статьи https://habr.com/ru/articles/1110350/