SWE-agents или агенты разработки — ассистенты, которые помогают человеку программировать. Мы все (ну почти все) их используем в повседневной работе, у всех на слуху: Claude Code, Codex, Cursor и множество других программ подобного рода. Такие агенты построены на основе архитектуры ReAct, когда модели дается описание инструментов, а модель генерирует их вызовы, агент производит реальный вызов и возвращает модели его результат. Все это добавляется в контекст как новое сообщение пополненная лента сообщений снова передается модели для обработки. Таким образом, контекст только растет, в этом и состоит его монотонность. В этой статье описана попытка создания агента разработки на основе подхода, когда контекст может сокращаться, какие-то сообщения затираются, вместо них добавляются новые, даже без участия в этом процессе языковой модели.
Проблема длинного контекста
Когда контекст постоянно растет, это имеет проблемы. Перечислим некотрые из них:
-
Языковая модель имеет свое окно контекста и длина его ограничена.
-
Длинный контекст «рассеивает внимание» модели, особенно в середине поданного на вход текста.
С проблемой длинной контекст можно бороться только одним способом — укорачиванием контекста. Это делается по разном, но обычно, либо усечением того, что было вначале (забыванием начала), либо построением summary текста контекста — своеобразным сжатием информации, размещенной на ленте.
Каждый подход имеет свои недостатки. При усечении контекста мы начисто забываем то, что не вошло в окно по длине (обычно усекаем то, что было в начале), а в резюме контекста может не войти что-то важное, что потом может понадобится модели для выводов.
Когда мы имеем дело с провайдерами моделей, то обычно считаем четыре типа токенов:
-
Входные (in) токены — это та самая лента, которая приходит модели на вход от агента.
-
Выходные (out) токены — то, что модель генерирует в ответ.
-
Токены размышлений (reasoning) — часть выходных токенов, но они обычно не показываются пользователю. Размышления являются частью выхода модели и за них точно также необходимо платить.
-
Токены кэша (cache) — провайдер модели может запомнить переданный на вход текст и то состояние, которое было у модели при обработке этого текст. Когда в следующий раз текст или его часть подается на вход, провайдер вычисляет по буквальному совпадению текста его состояние и не прогоняет через модель, а использует как есть.
Входные токены, обычно, намного дешевле выходных, а токены кэша на порядок дешевле входных токенов. У моего провайдера кэш дешевле входа в 50 раз. Токены рассуждений, хотя и не видны пользователю, оплачиваются по цене выходных токенов. Рассуждения у модели могут быть достаточно длинными и если пользователь перед собой одно предложение на выходе, это не значит, что модель не потратила пару десятков тысяч токенов на размышления. Модель размышляет много в ситуации, когда нет однозначного решения, уверенности в правильности своих действий.
Кэширование хорошо работает на монотонно контексте. Тот текст, который был на ленте в прошлый раз, оплачивается по цене кэша, только новые сообщения (а это обычно вызов инструмента и результат его исполнения) оплачиваются по цене входных токенов. Поэтому, размер контекста, который показывает агент кодирования, не должен приводить в ужас бедного студента, оплачивающего токены из своего кармана, — необходимо помнить о кэше.
Журнал
Агент разработки Skein записывает каждый ход в специальную структуру данных — журнал. Сообщение от модели, вызов инструмента и результат этого вызова — все записывается в журнале в виде событий определенного типа. Так обеспечивается возможность работы с контекстов на программном уровне, не просто в виде последовательности сообщений на ленте.
Перед каждым ходом (обращением к модели) контекст собирается из журнала специальной функцией проекции, т.е. журнал отображается на ленту. Какие-то события журнала могут быть отображены, а другие — нет, контекст перестает быть монотонно пополняющимся, какие-то сообщения стираются с ленты, т.е. длина ленты варьируется. Я себе придумал удобный образ «гармошки», в традиционном агенте гармошку мы только растягиваем, а в Skein еще и периодически сжимаем.
Сам по себе, журнал ничего не делает, кроме как записывает события и строит проекции событий на ленту. Чтобы обеспечить немонотонность контекста, необходимо нечто большее — это состояния и динамические гипотезы.
Состояния
В процессе кодирования разработчики часто переходят из одной стадии разработки в другую. Например, когда необходимо найти баг в коде и исправить его, то такую стадию можно назвать Patch, потом исправленный код необходимо верифицировать, проверить, что исправление верное. Эту стадию можно назвать Verification. Для различных исследований подойдет Research, а когда надо просто написать какой-то код с нуля, то эту стадию можно назвать Construction. Есть еще завершающая стадия End.
Skein содержит в себе перечисленные в предыдущем параграфе фазы как состояния. Состояние — это маленький агент со своим промтом и со своим пользовательским запросом — частью исходного запроса пользователя, спроецированного в это состояние. У состояния есть цель и критерий остановки. Внутри состояния агент ходит по ленте, вызывает инструменты и останавливается, когда считает, что критерий остановки достигнут. В этот момент, агент не вызывает ни одного инструмента, только текст — это обычный способ остановки ReAct агентов.
После остановки состояния модель в текст генерирует его итоги. Лента внутри состояния затирается и остается только начальное system сообщение «Start state Patch» — для состояния Patch. Затем добавляется system сообщение «Finish state Patch» и итоговая информация, которую сгенерировала модель при окончании состояния. Так контекст перестает быть монотонным.
Между состояниями можно осуществлять переходы. Вот таблица переходов:
|
Состояние из |
Состояние в |
Комментарий |
|
Patсh |
Verification, Research |
После исправление надо сделать проверку или доисследовать |
|
Research |
End, Patch |
После исследования можно закончить, а можно еще что-то поправить |
|
Construction |
End, Research |
Написали код и закончили, если надо еще исследовать, то делаем это |
|
Verification |
End, Patch |
Если проверка прошла удачно, то заканчиваем, иначе снова идем менять код |
Переходы между состояниями осуществляет модель, основываясь на запросе пользователя и результатах предыдущего состояния. В самом начале выбирается одно из состояний: Patсh, Research или Construction — потом производятся переходы в соответствие с результатами работы в состоянии и таблицей переходов. Еще раз напоминаю, что модели на вход просто подается промт возможных переходов и кратких описаний состояний, куда можно перейти, модель видит на ленте пары («Start state…», «Finish state…») для каждого пройденного состояния и начинает новое. Для этого есть специальный инструмент move.
Об инструментах мы поговорим позже, пока только скажем, что состояния позволяют динамически менять набор инструментов, в зависимости от ситуации. Скажем, перед началом состояния журнал передает модели только один инструмент move, как возможный для вызова, а внутри состояния передает рабочие инструменты, но не move — пока мы не закончили работу в состоянии, переходить некуда.
Гипотезы
Если состояния — это заранее выбранные фазы кодирования, то почему также не позволить модели создавать состояния на лету, исходя из задачи? Возможно ли это сделать вообще?
Для решения этого вопроса я использовал подходы британского логика 19 века Чарльза Сандерса Пирса. Он исследовал законы человеческого мышления и выделил следующие познавательные процедуры:
-
Аналогия — люди находят в данной ситуации аналогию с другой и применяют ее, чтобы получить выводы, известные в этой другой ситуации. Я считаю, что это единственный способ размышлений, доступный в языковых моделях на основе архитектуры Transformer, даже написал статью на эту тему, где это пытаюсь математически доказать: https://doi.org/10.5281/zenodo.23133879
-
Индукция — это эксперимент, процедура проверки гипотезы через опыт. Индукцию можно ассоциировать с вызовом инструмента в агенте и наблюдением его результатов.
-
Дедукция — логические следствия, вывод типа: если A истинно, а B следует из A, значит и B истинно.
-
Абдукция — это порождение объяснения о наблюдении. Скажем, у нас есть какой-то факт B и мы хотим построить объяснение (более общее утверждение) A, чтобы B следовало из A.
Пирс считал абдукцию единственным способом получения нового знания: аналогия просто берет известный паттерн из другой ситуации, индукция уже имеет в уме гипотезу, которую проверяет, а дедукция просто строит умозаключения известных гипотез. Но, абдукция действительно строит A, которого в системе нет, или если есть, то связывает A как объяснение B.
Больше не буду утомлять скучной логикой, обещаю. Итак, мы имеем некую проблему, сформулированную пользователем в чета агента разработки, ее можно интерпретировать как цель T. Обычно, это некое наблюдение, типа тесты не проходят и какая-то гипотеза, почему так случилось (если пользователь не тупой и не ленивый). Мы хотим построить абдуктивную гипотезу H, которая будет служить объяснением T и, заодно, его исправлением.
Как мы будем строить гипотезу H? Как последовательность гипотез H1, H2,… Если гипотеза сложная, то ее можно саму сделать композицией гипотез, я тогда использую составной идентификатор типа H1.2.3 для гипотезы третьего уровня. С гипотезами мы поступаем точно также, как с состояниями: только название гипотезы и критерий остановки генерирует модель. Внутри все совершенно также, как с состояниями — мы останавливаемся текстовым ответом, без вызова инструмента, только текст возвращается как JSON с полями об наблюдениях (observed), кратким описанием того, что делалось (summary) и вердиктом (verdict) — одной из трех констант, которая говорит о том, выполнилась ли гипотеза или опровергнута или сброшена (например, по предельному количеству ходов в гипотезе).
После того, как гипотеза закрыта, мы стираем ее ленту и оставляем только формулировку гипотезы (label, claim) и результирующие описанные только что поля. Перед началом новой гипотезы мы просим модель, либо остановиться, если исходная цель достигнута (тогда просто текстовый выход), либо вызвать инструмент open_hypothesis для создания новой гипотезы. При создании новой гипотезы модель видит на ленте только краткую информацию о выполнении предыдущих гипотез, что и делает контекст немонотонным т.к. информация внутри гипотезы стирается с ленты.
Все очень похоже на статические состояния, лента затирается при выходе, инструменты динамически меняются, в зависимости от контекста. В начале новой гипотезы модели подаются open_hypothesis и рабочие инструменты. Если вызвана open_hypothesis, то создается подгипотеза как составная задача, а если вызван какой-то из рабочих инструментов, то мы убираем open_hypothesis из доступных инструментов и рассматриваем данную гипотезу только, как цепочку наблюдений.
Инструменты
Для агентов разработки набор базовых (рабочих) инструментов достаточно стандартный, перечислим их:
|
Название |
Комментарий |
|
read |
Прочитать файл |
|
grep |
Поиск по содержимому файлов |
|
list |
Список файлов рабочей области |
|
edit |
Точная замена строк в существующем файле |
|
write |
Создать новый или перезаписать файл |
|
apply_patch |
Применить unified diff |
|
bash |
Shell-команда (сборка, тесты, прочее) |
|
webfetch |
Скачать URL в файл (в workspace или engine-owned ref) |
Кроме обычных рабочих инструментов есть специфические для Skein, связанные с журналом, переходами между состояниями и открытиями гипотез:
|
Название |
Комментарий |
|
move |
Переход в новое состояние |
|
recall |
Прочитать сохранённый результат по id — сразу на ленту записывается не больше 8K символов, потом можно перечитать заново по смещению |
|
search |
regex-поиск внутри сохранённого результата по id |
|
open_hypothesis |
Открыть гипотезу |
Набор инструментов динамически изменяется, в зависимости от ситуации, в которой находится агент в данным момент.
Агенты
В Skein реализованы несколько агентов, применяемых в различных ситуациях. Два агента задач кодирование: агент задачи на состояниях и агент задачи на гипотезах. Именно их можно использовать при запуске агента для решения задачи не в интерактивном режиме.
Однако, в интерактивном режиме с пользователем общается т.н. агент сессии. Это классический агент с монотонным контекстом, имеющий несколько специфических инструментов: task запускает задачу кодирования, respond просто отвечает на вопрос пользователя, document вызывает агента построение длинного документа в Markdown формате, planner строит план исполнения, который затем исполняется в агенте сессии как отдельные запросы пользователя для каждого пункта плана, general исполняет read-only задачу (например, исследовать репозиторий), а revision исполняет задачу с возможностью записи, но не кодирования. Например, переход на другой commit.
Все перечисленные выше агенты можно рассматривать, как агенты одного состояния, кроме агентов задач, которые построены на других принципах. Каждому агенту дан инструмент, агент сессии вызывает этот инструмент с переформулировкой реплики пользователя в сессии в контексте всего диалога. Переформулированный запрос передает агенту и тот на своем собственном контексте начинает его исполнение. Результат возвращается как результат вызова соответствующего инструмента, после чего преобразуется в Markdown для показа пользователю в агенте сессии.
Есть еще агент наблюдения. По задумке он должен запускаться в состоянии или гипотезе, если они выполняются слишком долго, больше заданного числа ходов. Однкао, он пока не готов к работе и требует отладки.
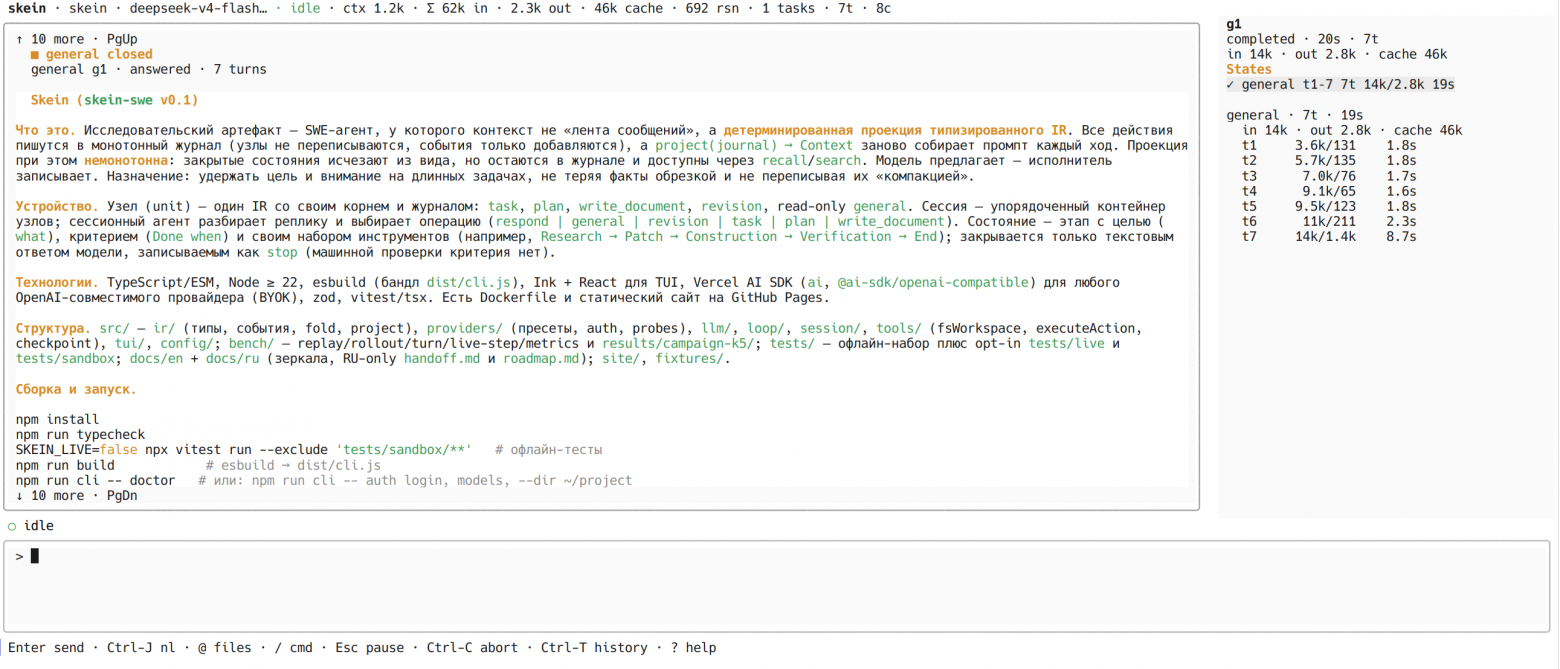
Skein реализован как терминальный агент с тремя панелями:
-
Панель ввода запроса пользователя.
-
Панель вывода наблюдений и результатов.
-
Панель задач справа, на которой изображается ход исполнения задачи.
Сравнительные тесты
Необходимо было как-то оценить работу агента. Я плачу провайдеру из своей зарплаты, поэтому выбрал для тестирования 13 задач из коллекции Terminal Bench: https://github.com/laude-institute/terminal-bench. Можно прочитать статью о подходах к организации тестирования здесь: https://arxiv.org/abs/2601.11868.
Задачи были выбраны таким образом, чтобы покрыть возможные сценарии работы, но ни в коей мере не претендуют на полноту. Ниже приведена таблица с описанием задач.
|
Задача |
Описание |
|
regex-log |
написать /app/regex.txt: регулярка, выбирающая строки лога по условию. Окружение пустое (bare Ubuntu), Python ставится верификатором |
|
fix-git |
в /app/personal-site потерян коммит (висит вне master): восстановить и слить; проверка сверяет файлы сайта с эталоном |
|
git-leak-recovery |
в /app/repo секрет спрятан в недостижимом git-объекте: извлечь его и вычистить историю |
|
log-summary-date-ranges |
по сгенерированному дереву логов посчитать сводку и записать /app/summary.csv |
|
password-recovery |
вырезать фрагментированный секрет из образа диска |
|
db-wal-recovery |
восстановить XOR-зашифрованный WAL SQLite и прочитать базу |
|
crack-7z-hash |
подобрать пароль 7z через John the Ripper (единственная задача, требующая сеть) |
|
openssl-selfsigned-cert |
сгенерировать самоподписанный сертификат и объединённый PEM в /app/ssl |
|
fix-code-vulnerability |
найти и исправить header-injection в bottle.py, написать report.jsonl; должны пройти и собственные тесты репозитория, и верификатор |
|
fix-ocaml-gc |
исправить баг run-length sweep в GC OCaml; верификатор пересобирает компилятор и гоняет тесты |
|
custom-memory-heap-crash |
устранить крэш статического разрушения против кастомного аллокатора |
|
cobol-modernization |
модернизировать COBOL-программу (gnucobol в образе), проверка компилирует и запускает |
|
modernize-scientific-stack |
переписать устаревший климатологический скрипт под современные numpy/pandas |
Для тестирования я использовал только одну модель: DeepSeek V4.1 Flash. Эту модель провайдер предоставляет под разными субподрядчиками, которые используют различную квантизацию, что сильно мешает получению детерминированного результата. Особенно это видно по размышлениям модели и ее решениям. Есть даже 4-битовые квантизации.
В качестве контрагента разработки я использовал opencode первой версии (вторая, как мне кажется, работает хуже). Это классический агент с одной монотонной лентой, чем и был обусловлен его выбор. Скажу сразу, что по стоимости Skein проигрывает, особенно на коротких задачах. Лишние ходы на переходы и порождение гипотез тратят токены и хотя общий расход токенов меньше, за счет кэша opencode выигрывает. Тем не менее, результаты сравнимы. По качеству на terminal bench трудно было судить, оно одно и тоже.
Тестирование проводилось с включенной и выключенной сетью (возможность для скачивания).
Skein (состояния) против OpenCode (13 задач, 5 сэмплов на задачу)
|
агент/сеть |
solved |
turns |
fresh input |
output |
cache % |
cost |
|
skein/on |
63/65 |
14 |
22.1k |
4.1k |
86.7% |
0.704₽ |
|
skein/off |
60/60 |
15 |
25.0k |
7.3k |
84.1% |
1.000₽ |
|
opencode/on |
65/65 |
9 |
10.4k |
3.0k |
95.3% |
~0.47₽ |
|
opencode/off |
58/60 |
9 |
10.4k |
2.7k |
94.3% |
~0.44₽ |
Skein (состояния) против Skein (гипотезы) (7 задач, 5 сэмплов на задачу)
|
режим/сеть |
solved |
turns |
fresh |
cost |
|
states/on |
35/35 |
17 |
34.5k |
2.421₽ |
|
states/off |
34/35 |
15 |
28.7k |
1.606₽ |
|
hypotheses/on |
34/35 |
20 |
19.6k |
1.883₽ |
|
hypotheses/off |
34/35 |
22 |
20.1k |
1.983₽ |
Провалы на решении задач были вызваны ограничениями на число ходов. Задача, не решенная за определенное число ходов, останавливалась и запускался скрипт тестирования результатов от Terminal Bench.
Как видно из результатов, opencode эффективнее по ходам и токенам. Skein (состояния) близок по solve, но дороже по fresh. Skein (гипотезы) меньше fresh, больше ходов, лучше на коротких/средних и требует больше бюджета на длинных.
Итоги
Когда я начинал эту работу пару месяцев назад, я не был вообще уверен, что получится добиться сравнимого качества при таком подходе. Практика показала, что это возможно. Да, Skein проигрывает OpenCode по ходам и бюджету, но по качеству работает хорошо. Мне кажется, что применять Skein, особенно на гипотезах, стоит для исследовательских задач, которые требуют длинных рассуждений. Тогда затраты по бюджету окупятся с лихвой.
Затраты на дополнительные переходы были ожидаемы и именно они дают прибавку в стоимости. К сожалению, плотность результатов на выбранной модели и данных задачах не дает оценить эффективность подхода. Это работа была по личной инициативе и протестировать работу агента на разных моделях и большем числе задач у меня просто не хватило бюджета.
Однако, в целом можно сказать, что эксперимент прошел успешно. Задуманные цели были реализованы и результаты приемлемые. Я думаю, что тюнинг модели на разделение задачи на гипотезы может дать сопоставимые с OpenCode результаты. Сами размышления должны быть надежнее по определению, но это необходимо доказать.
Skein написан на TypeScript (я следовал традиции). Основные ссылки:
-
GitHub: https://github.com/merfill/skein
-
Сайт: https://skein-swe.dev (EN) · https://skein-swe.dev/ru/ (RU)
-
Препринт v2 (Zenodo): https://doi.org/10.5281/zenodo.24400661
-
Документация: https://github.com/merfill/skein/blob/main/docs/en/README.md (EN) · https://github.com/merfill/skein/blob/main/docs/ru/README.md (RU)
Работа мне самому кажется интересной и, я надеюсь, что это только ее первая стадия.
ссылка на оригинал статьи https://habr.com/ru/articles/1110628/