Stable Diffusion хочет видеокарту с 4–8 ГБ памяти. Flux хочет 12 ГБ, а лучше 24. А у меня на столе лежит ESP32-S3 — микроконтроллер, отладочная плата с которым стоит несколько сотен рублей, у которого 512 КБ оперативной памяти, два ядра по 240 МГц и ни одного тензорного ядра.
Вопрос был простой: можно ли заставить эту штуку рисовать картинки по тексту? Не «отправить промпт в облако и показать ответ», а честно прогнать диффузию на самом чипе.
Спойлер: можно. Пишешь «улыбающаяся девушка со светлыми волосами», и через 5,4 секунды ESP32 выдаёт лицо 64×64. Внутри латентная диффузия с трансформером (DiT), int8-квантование, ассемблер под векторные инструкции S3 и некоторое количество грязных трюков. В общем — всё, как вы любите.
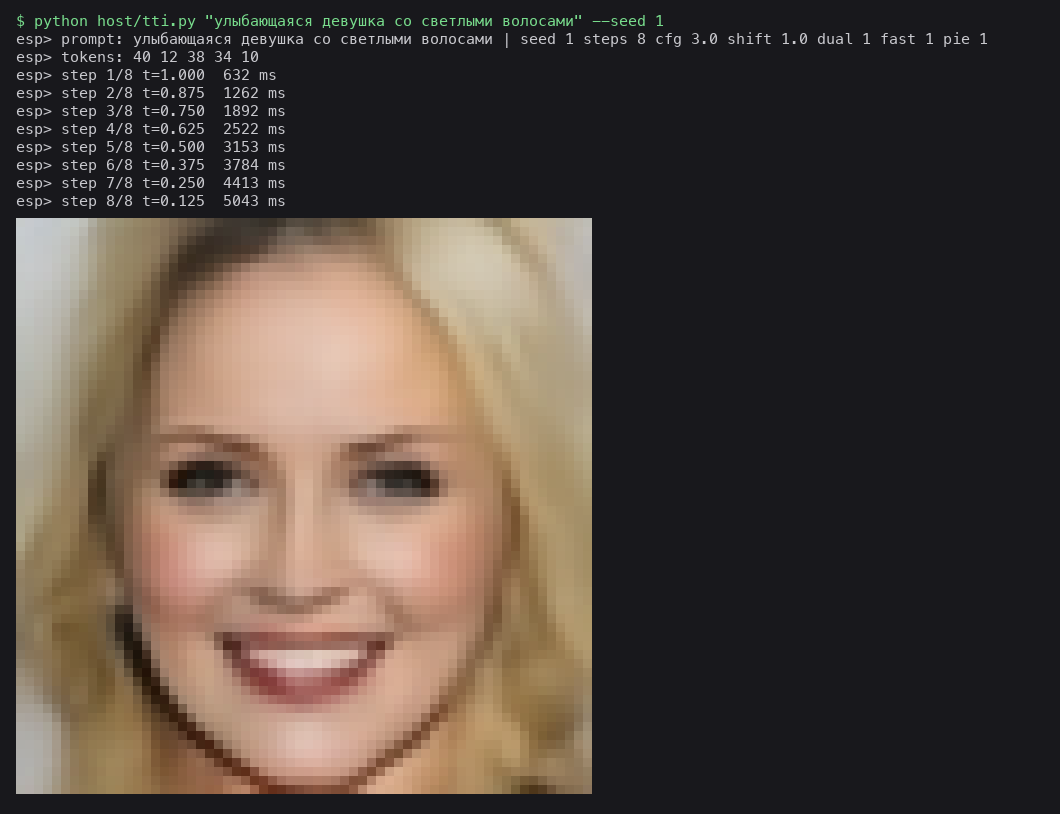
В этой статье разберём, что пришлось ужать, где схитрить и обо что я споткнулся по дороге.
▍ Что у нас есть
Начнём с ревизии. Вот всё, что ESP32-S3 готов отдать под нейросеть:
|
Ресурс |
Сколько |
Комментарий |
|---|---|---|
|
CPU |
2 × Xtensa LX7, 240 МГц |
есть FPU одинарной точности |
|
SIMD |
PIE, 128-битные регистры |
16 умножений int8 за инструкцию |
|
SRAM |
512 КБ |
реально свободно ~320 КБ |
|
PSRAM |
2 МБ |
медленная, по quad SPI |
|
Flash |
8 МБ |
отображается в адресное пространство через кэш |
Для сравнения: веса одного только текстового энкодера CLIP из Stable Diffusion весят 250 МБ. В 500 раз больше, чем вся оперативка чипа.
Значит, готовую модель взять не получится. Будем строить свою — с нуля, с прицелом на железо.
▍ План: что ужать и где схитрить
Прежде чем писать код, я выписал всё, что можно урезать без потери смысла.
Домен. Генерировать «всё что угодно» в таком бюджете бессмысленно. Лица — идеальный компромисс: датасет CelebA с 200 тысячами фотографий и 40 атрибутами («улыбается», «очки», «борода»…), а результат сразу понятен человеку.
Разрешение. 64×64. Меньше — уже не узнать лицо, больше — не влезет.
Латентная диффузия. Диффузию гоняем не по пикселям, а по сжатому латенту 16×16×4 — это в 12 раз меньше данных, чем картинка. Декодер в пиксели работает один раз в самом конце.
Трансформер вместо U-Net. DiT на 64 токенах — это, по сути, набор матричных умножений. А значит, всю сеть можно свести к одному ядру int8 × int8 → int32 и вылизать только его.
Текстовый энкодер. Никакого CLIP. Свой крошечный трансформер на 300 тысяч параметров со словарём из 45 «слов».
Квантование. Веса int8, активации int8, аккумулятор int32. Это не только экономия памяти: PIE умеет перемножать 16 пар int8 за инструкцию.
Шаги. Rectified flow вместо классического DDPM — хорошие картинки получаются уже за 8 шагов вместо 50–1000.
Classifier-free guidance. Обычно это две прогонки сети на шаг. Склеим обе ветви в один батч, и веса будут читаться из flash один раз вместо двух.
▍ Данные: CelebA и русские подписи
У CelebA нет текстовых описаний — только 40 бинарных атрибутов. Ничего страшного: сгенерируем подписи сами. На лету, разные для каждого прохода по датасету.
def caption(a, rng=random): has = lambda n: a[I[n]] == 1 male, young = has('Male'), has('Young') g = lambda m, f: m if male else f # согласование по роду adj, post = [], [] p = 0.75 # упоминаем признак не всегда — модель учится на неполных описаниях if rng.random() < p: adj.append(g('молодой', 'молодая') if young else g('пожилой', 'пожилая')) if has('Smiling'): if rng.random() < p: adj.append(g('улыбающийся', 'улыбающаяся')) elif rng.random() < 0.3: adj.append(g('серьёзный', 'серьёзная')) ...
На выходе получается что-то такое:
молодая улыбающаяся девушка с чёлкой с волнистыми волосами пожилой дедушка в галстуке с усами с волнистыми тёмными волосами улыбающийся мужчина с бородой с открытым ртом без очков молодая брюнетка с помадой
Русский язык подкинул проблему: «улыбающийся», «улыбающаяся», «улыбающимися» — для словаря это три разных слова. Нормальный морфологический анализатор в микроконтроллер не затащишь, поэтому стеммер у нас в одну строку:
return [w[:5] for w in re.findall(r'[а-яa-z]+', s.lower().replace('ё', 'е'))]
Обрезаем каждое слово до пяти букв. «улыбающаяся» → «улыба», «светлыми» → «светл». Грубо, но для нашего домена работает. Весь словарь — 45 токенов, по 16 байт на запись в прошивке.
▍ Автоэнкодер: декодер под микроконтроллер
Автоэнкодер сжимает картинку 64×64×3 в латент 16×16×4 и обратно. Энкодер нужен только при обучении, и на него можно не скупиться: 1,9 млн параметров. А вот декодер поедет в ESP, поэтому к нему требования жёсткие:
-
только свёртки 3×3, ReLU и nearest-апсемплинг;
-
никаких нормализаций — GroupNorm на МК дорогой и плохо квантуется;
-
179 тысяч параметров.
class Decoder(nn.Module): CH = (64, 48, 32) def __init__(s, z=4): super().__init__() a, b, c = s.CH s.net = nn.Sequential( nn.Conv2d(z, a, 3, padding=1), Res(a), nn.Upsample(scale_factor=2), nn.Conv2d(a, b, 3, padding=1), Res(b), nn.Upsample(scale_factor=2), nn.Conv2d(b, c, 3, padding=1), Res(c), nn.ReLU(), nn.Conv2d(c, 3, 3, padding=1))
Чтобы декодер с таким скромным бюджетом не мылил картинку, лосс — L1 плюс перцептивный LPIPS. Сверху совсем немного KL, чтобы латентное пространство было гладким и диффузии было за что зацепиться. 20 тысяч шагов на Colab T4 — около 20 минут.
▍ DiT: трансформер, который рисует
Денойзер — диффузионный трансформер по мотивам DiT. Латент 16×16×4 режем на патчи 2×2 и получаем 64 токена по 16 чисел. Дальше стандартный трансформер:
|
Параметр |
Значение |
|---|---|
|
Ширина |
192 |
|
Блоков |
6 |
|
Голов внимания |
6 по 32 |
|
MLP |
×3 |
|
Параметров всего (с текстом) |
2,9 млн |
Пара мест, где пришлось схитрить.
adaLN-single. В оригинальном DiT каждый блок получает условие (шаг + текст) через свою adaLN-проекцию D → 6D. При D=192 это 221 тысяча параметров на блок — больше, чем само внимание! Я подсмотрел трюк у PixArt-α: одна проекция на всю сеть плюс крошечная обучаемая таблица-сдвиг на каждый блок. Минус 1,1 млн параметров почти бесплатно.
class Block(nn.Module): def __init__(s): super().__init__() s.attn = Attn(D, HEADS); s.mlp = Mlp(D, MLP) s.table = nn.Parameter(torch.randn(6, D) / D ** 0.5) # свой сдвиг на блок def forward(s, x, mod): sh1, sc1, g1, sh2, sc2, g2 = (mod + s.table[None]).unbind(1) x = x + g1[:, None] * s.attn(ln(x) * (1 + sc1[:, None]) + sh1[:, None]) x = x + g2[:, None] * s.mlp(ln(x) * (1 + sc2[:, None]) + sh2[:, None]) return x
LayerNorm без параметров. Масштаб и сдвиг всё равно приходят из adaLN, так что у LayerNorm их нет. На МК это минус два вектора и минус одно умножение на элемент.
Текст через пулинг. Вместо cross-attention текстовый эмбеддинг усредняется в один вектор и складывается с эмбеддингом шага. Для атрибутов лица этого хватает с головой, а вычислений почти никаких.
Rectified flow. Модель учится предсказывать скорость v = ε − x₀ на прямой между картинкой и шумом. Траектории получаются почти прямыми, поэтому восьми шагов метода Эйлера хватает за глаза:
for i in range(steps): v = model(z, t[i], text) vu = model(z, t[i], null) # «пустой» промпт v = vu + cfg * (v - vu) # classifier-free guidance z = z + (t[i + 1] - t[i]) * v
Обучение: батч 512, 24 тысячи шагов, около 50 минут на T4.
▍ int8 по-взрослому
Теперь самое интересное: как засунуть это в микроконтроллер.
Все линейные слои квантуются по схеме W8A8 dynamic:
-
веса — int8, свой масштаб на каждый выходной канал, считается один раз при экспорте;
-
активации — int8, свой масштаб на каждый токен, считается на лету;
-
аккумулятор — int32, потом умножаем на два масштаба и добавляем bias.
Динамический масштаб на токен — главное, что спасает трансформер. У активаций после LayerNorm и модуляции бывают выбросы, и общий статический масштаб на тензор их просто убивает. А посчитать максимум по 192 числам — копейки.
Внимание тоже целиком в int8. Q·Kᵀ — это то же матричное умножение (Q и K квантуются по токенам). Произведение P·V — тоже, если взять Vᵀ и квантовать его по каналам. Всё сводится к одному ядру.
И маленький трюк с softmax. Чтобы проквантовать вероятности, нужен их максимум. Но мы и так вычитаем максимум перед экспонентой, а значит, наибольшая экспонента равна ровно единице, а максимальная вероятность — ровно 1/sum. Отдельный проход не нужен:
// p = r/sum, max(p) = 1/sum => q = round(p / (max/127)) = round(r * 127)a_sp[i] = 1.f / (sum * 127.f);for (int c = 0; c < T; c++) o[c] = (int8_t)rne(r[c] * 127.f);
Скрытый слой MLP (576 нейронов) не помещается в память целиком, поэтому он считается кусками по 96. Каждый кусок квантуется со своим масштабом — получается group-wise квантование по K, которое заодно точнее обычного.
Декодер квантуется проще: статический масштаб на тензор, откалиброванный на латентах, которые сгенерировала сама модель.
Итоговый model.bin весит 3,1 МБ и лежит в отдельном разделе flash. Прошивка не копирует его в память, а отображает в адресное пространство через esp_partition_mmap и читает веса прямо оттуда.
▍ PIE: SIMD, о котором мало кто знает
В ESP32-S3 есть набор векторных инструкций PIE (Processor Instruction Extensions). Восемь 128-битных регистров q0–q7, и главное — инструкция EE.VMULAS.S8.ACCX: перемножить 16 пар int8 и прибавить сумму в 40-битный аккумулятор. Одной инструкцией.
Компилятор эти инструкции сам не генерирует, так что пишем на ассемблере. Ядро — скалярное произведение одной строки весов с несколькими строками активаций:
// a2 = x, a3 = w (выровнены по 16), a4 = K/16, a5 = out, a6 = nrows, a7 = шаг xdot_rows_s8: entry a1, 32 addi a10, a4, -1.Lrow: mov a8, a2 mov a9, a3 ee.zero.accx // обнулить аккумулятор ee.vld.128.ip q0, a8, 16 // 16 байт активаций ee.vld.128.ip q1, a9, 16 // 16 байт весов loopgtz a10, .Lend // аппаратный цикл, без накладных на переход ee.vmulas.s8.accx.ld.ip q0, a8, 16, q0, q1 // 16 MAC + загрузка следующих 16 байт ee.vld.128.ip q1, a9, 16.Lend: ee.vmulas.s8.accx q0, q1 nop nop rur.accx_0 a11 // забрать int32 из аккумулятора s32i a11, a5, 0 addi a5, a5, 4 add a2, a2, a7 addi a6, a6, -1 bnez a6, .Lrow retw
Одна строка весов читается один раз и сразу умножается на все 64–128 токенов. Это важно: веса лежат во flash, и каждое лишнее чтение — промах кэша.
Чтобы было честно, я замерил одно и то же умножение матриц 64×192 на 192×576 (7 миллионов MAC) разными способами. Результат каждый раз сверялся бит в бит с эталоном на C.
|
Вариант |
Время |
MMAC/s |
|---|---|---|
|
float32 (данные в PSRAM) |
1993 мс |
3,6 |
|
int8, чистый C |
356 мс |
19,9 |
|
int8, PIE |
27,3 мс |
259 |
|
int8, PIE, выход в SRAM в раскладке [O][T] |
7,9 мс |
897 |
|
int8, PIE, два ядра |
4,5 мс |
1562 |
Строчка «выход в SRAM» заслуживает отдельного абзаца. Первая версия ядра писала результат в PSRAM в раскладке [T][O], то есть с шагом 2304 байта. PSRAM висит за кэшем, и такие прыжки его просто убивали. Хватило переложить выход в раскладку [O][T] во внутренней SRAM — и ×3,5 на ровном месте.
Итого 1,5 миллиарда умножений в секунду на микроконтроллере. Это в 78 раз быстрее int8 на чистом C (а с float сравнивать даже неловко: он ещё и данные из PSRAM таскал). Это самое красивое, что я видел за день.
▍ Два ядра
У ESP32-S3 два ядра, а FreeRTOS по умолчанию гоняет app_main на одном. Делим работу: второе ядро крутит воркер, который ждёт задание через task notification (это дешевле семафоров) и считает свою половину.
static void par(par_fn fn, void *arg, int n) { if (use_dual && n >= 2) { s_fn = fn; s_arg = arg; s_main = xTaskGetCurrentTaskHandle(); xTaskNotifyGive(s_worker); // ядро 1: половина [n/2, n) fn(arg, 0, 2); // ядро 0: половина [0, n/2) ulTaskNotifyTake(pdTRUE, portMAX_DELAY); } else fn(arg, 0, 1);}
В GEMM делим выходные каналы, в LayerNorm, softmax и квантовании — строки, во внимании — столбцы матрицы оценок.
▍ Когда GEMM уже быстрый
Собрав первую рабочую версию, я запустил профайлер и удивился. Матричные умножения занимали меньше трети времени. Остальное съедала «мелочь»:
|
Операция |
Время на 2 шага |
|---|---|
|
GEMM |
898 мс |
|
Квантование активаций |
816 мс |
|
softmax |
305 мс |
|
LayerNorm |
282 мс |
|
GELU |
160 мс |
Квантование дороже матричных умножений?! Виновник нашёлся быстро — lrintf(). На Xtensa нет инструкции округления к ближайшему, поэтому это честный вызов функции из libm. На каждый элемент.
Лечится старым трюком с магической константой:
// Округление к ближайшему чётному (как np.round) без libm: 1.5 * 2^23.static inline int32_t rne(float x) { union { float f; int32_t i; } u = {x + 12582912.0f}; return u.i - 0x4B400000;}
Прибавляем 1,5·2²³ — и мантисса float сама округляет число к ближайшему целому, а результат лежит прямо в младших битах. Две инструкции вместо вызова функции, и округление в точности как у np.round (это важно для сверки с симулятором, о нём ниже).
Та же история с floorf внутри экспоненты. А expf и tanhf заменились на:
-
exp — разбиваем x·log₂e на целую часть (её запихиваем прямо в поле экспоненты float) и дробную (полином третьей степени);
-
GELU — таблица на 1024 точки в диапазоне [−6, 6] с линейной интерполяцией и заранее посчитанными наклонами.
Хронология на целой модели, один шаг DiT:
|
Версия |
Шаг DiT |
Декодер |
|---|---|---|
|
int8, чистый C, 1 ядро |
16 835 мс |
11 633 мс |
|
+ PIE |
1 924 мс |
448 мс |
|
+ второе ядро |
1 199 мс |
343 мс |
|
+ rne, быстрые exp и GELU, всё поэлементное на 2 ядрах |
632 мс |
343 мс |
В 27 раз быстрее наивной версии на DiT и в 34 раза на декодере.
▍ 512 килобайт и ни байтом больше
Отдельный квест — память. Свободной внутренней SRAM после загрузки оказалось 288 КБ, а первая версия хотела 430.
Что помогло:
-
Одна арена на все фазы. Текстовый энкодер, DiT и декодер никогда не работают одновременно, так что живут по одним и тем же адресам. Буферы im2col декодера лежат там же, где у DiT residual stream.
-
CFG-ветви по очереди во внимании. MLP и проекции считаются для обеих ветвей разом (128 токенов, веса читаются один раз), а внимание — по очереди, чтобы буферы Q/K/V были вдвое меньше.
-
Кэш flash 32 КБ вместо 64. Кэш живёт в той же SRAM, так что это +32 КБ для арены. Большой кэш здесь и не нужен: каждая строка весов читается из flash один раз и сразу умножается на все токены.
-
Порядок аллокаций. Куча фрагментирована, самый большой свободный кусок — 244 КБ. Пришлось резать арену на четыре части и выделять их от больших к меньшим.
Активации декодера (64×64×32 int8 = 128 КБ, две штуки) уехали в PSRAM. Чтобы im2col не дёргал медленную PSRAM по девять раз на пиксель, нужные три строки входа сначала копируются во внутреннюю память. ReLU при этом применяется прямо при копировании. А nearest-апсемплинг вообще не существует как операция — он спрятан в индексацию im2col (xx >> up). Апсемпленный тензор в память никогда не попадает.
▍ Отладка: симулятор, который не врёт
Сразу запускать на железе настоящую модель — плохая идея. Если на выходе каша, непонятно, кто виноват: квантование, обучение или прошивка.
Поэтому экспорт весов идёт вместе с numpy-симулятором, который повторяет арифметику прошивки один в один: те же масштабы, то же округление, тот же группированный MLP, тот же генератор случайных чисел (xorshift + Box–Muller в обоих местах). Дальше берём модель со случайными весами и сравниваем тензоры с ESP после каждого этапа:
ESP DBG ctext -0.64606 0.95074 0.48622 0.25162REF ctext [-0.6460566 0.9507371 0.4862245 0.2516181]ESP DBG v -0.72824 -0.09718 ... | -0.66372 -0.81753REF v [-0.708569 -0.09742 ...] [-0.7798759 -0.9223082]
Текстовый энкодер совпадал до пятого знака, а предсказание скорости — нет. Причём ветвь без текста расходилась сильнее. Бисекция по блокам привела к финальному слою:
float fm[2][2 * 256]; // строки по 512linear(&M.fada, HQ, SX, 2, fm[0], 2 * D); // а пишем с шагом 2*192 = 384
Вторая строка модуляции записывалась с шагом 384, а читалась с шагом 512. Безусловная ветвь CFG получала сдвиг и масштаб из чужих данных. На обученной модели такой баг дал бы «просто немного странные» картинки, и я бы неделю грешил на квантование. Мораль: проверяйте не только код, но и то, как вы его проверяете.
▍ Результаты
А теперь — то, ради чего всё затевалось.
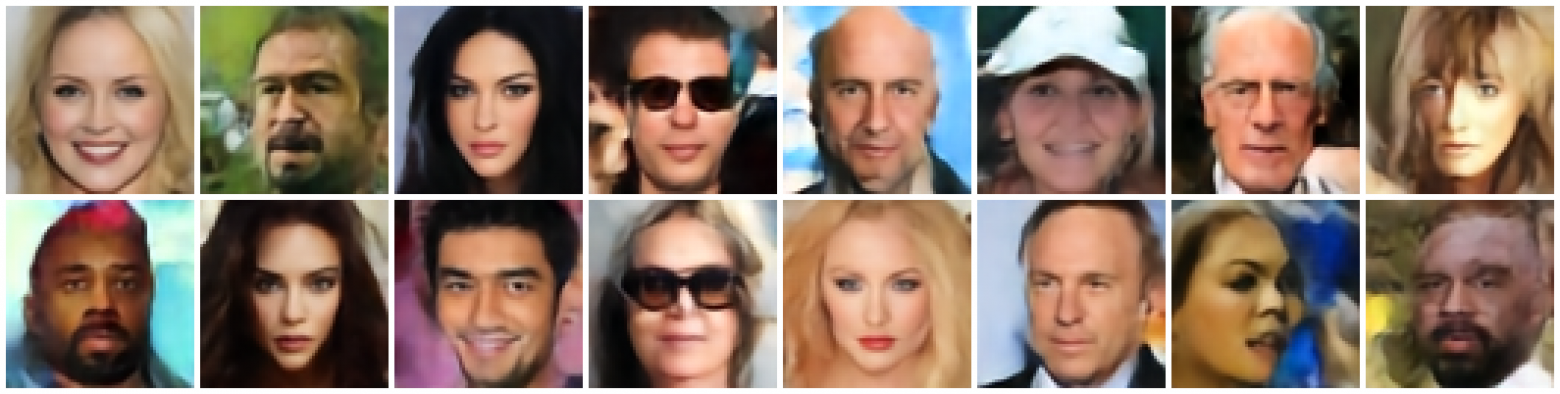
Промпты, слева направо: «улыбающаяся девушка со светлыми волосами», «пожилой мужчина с бородой», «брюнетка с помадой», «молодой парень в очках», «лысый мужчина», «улыбающаяся женщина в шляпе», «дедушка с седыми волосами», «девушка с чёлкой», «серьёзный мужчина с усами», «молодая женщина с волнистыми волосами», «улыбающийся парень с тёмными волосами», «бабушка в очках», «блондинка с макияжем», «мужчина в галстуке», «девушка с открытым ртом», «полный мужчина с бородкой».
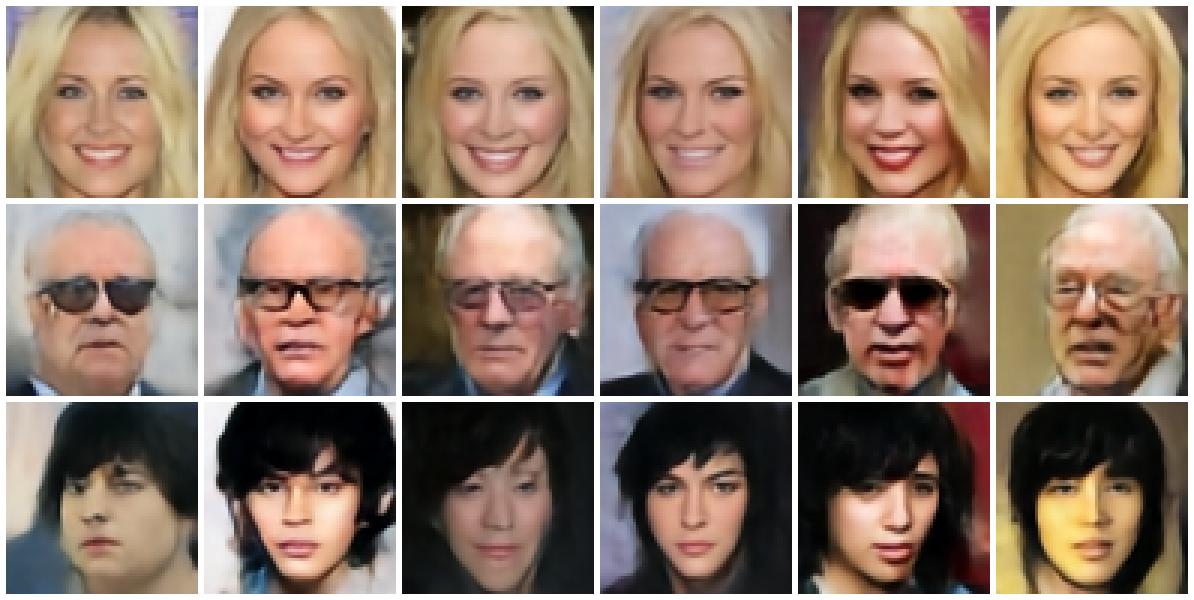
Модель — не справочник лиц. Один и тот же промпт с разным начальным шумом даёт разных людей:
Главный вопрос: сколько качества съело квантование? Ответ — практически ничего:
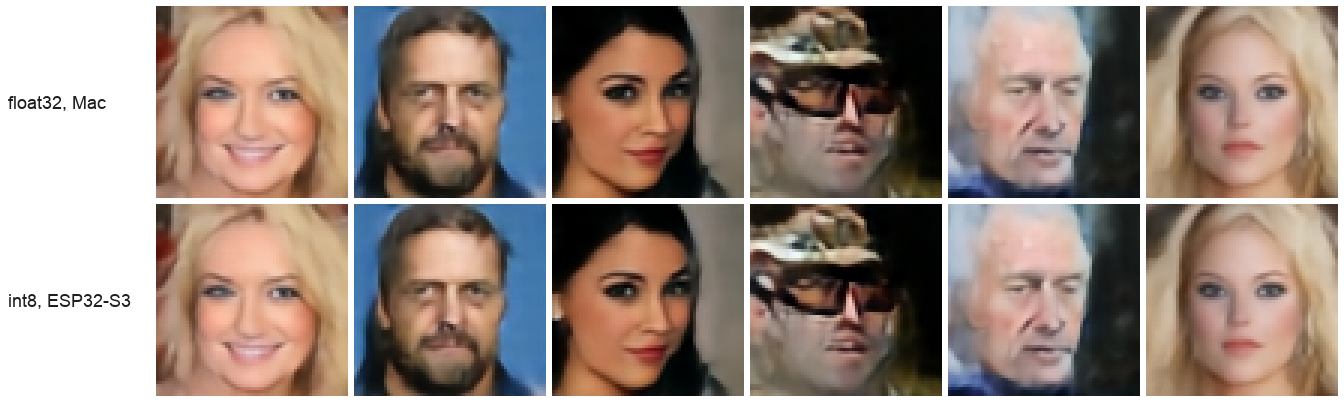
Средняя разница между ними — 1,2 уровня яркости из 255. Глазом не отличить, и это, пожалуй, главная заслуга динамического квантования по токенам.
Число шагов — главная ручка «скорость/качество»:
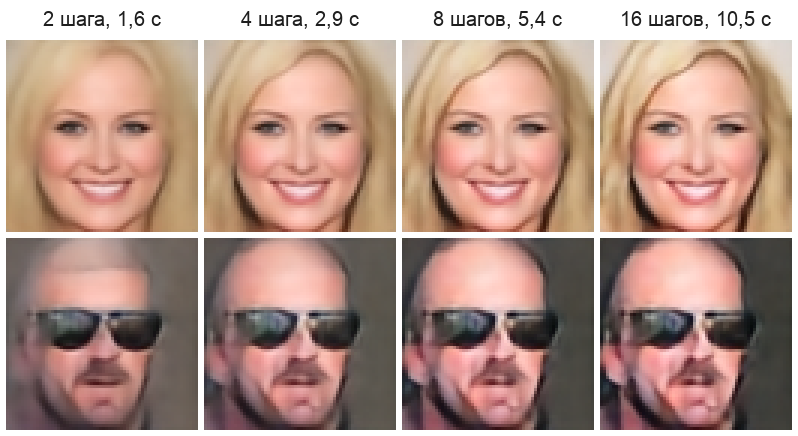
Тут rectified flow показывает себя во всей красе. Два шага — уже лицо, просто мыльное. А четыре шага от восьми почти не отличить, при этом картинка готова за 2,9 секунды. Шестнадцать шагов добавляют разве что пару морщин.
И сила guidance:
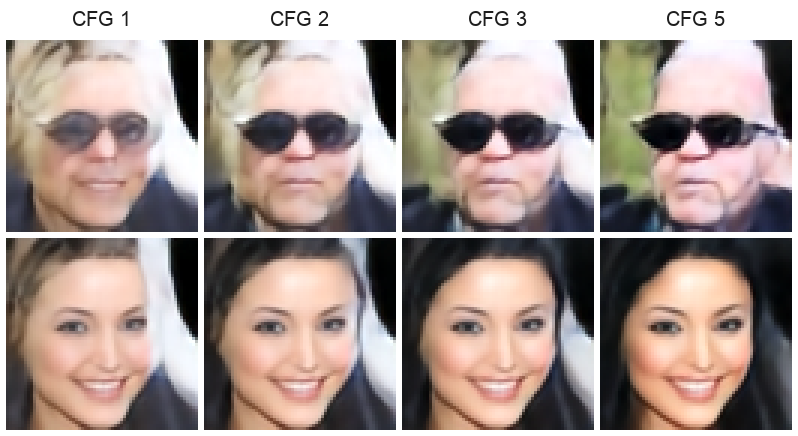
При CFG = 1 (то есть без guidance) модель слушает текст вполуха: «пожилой мужчина» превращается в кого-то неопределённого пола и возраста. С ростом CFG картинка становится контрастнее и точнее следует описанию, а на CFG = 5 начинаются пересвеченные «пластиковые» лица. Я остановился на 3.
Ну и обещанные неудачи. Без них было бы нечестно:
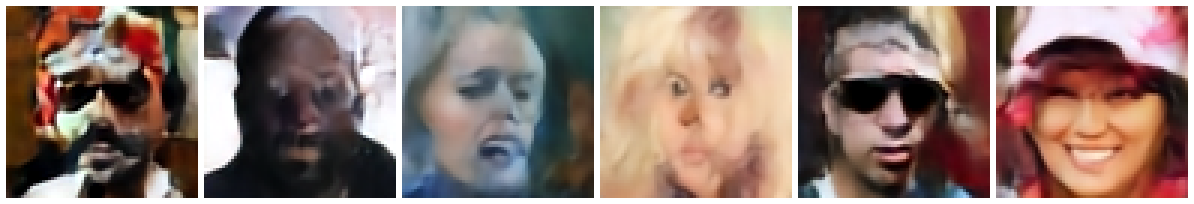
Хуже всего модели даются редкие сочетания атрибутов: в CelebA мало полных мужчин с бородкой, зато очень много улыбающихся блондинок. Плюс 64×64 и 3 миллиона параметров — это всё-таки не Midjourney. Примерно одна генерация из пяти выходит вот такой.
Куда уходят 5,4 секунды одной картинки:
|
Что |
Время |
Доля |
|---|---|---|
|
GEMM на PIE (DiT + декодер) |
3 122 мс |
58% |
|
softmax |
540 мс |
10% |
|
GELU + квантование |
470 мс |
9% |
|
внимание (int8, кроме softmax) |
463 мс |
9% |
|
квантование остального |
300 мс |
6% |
|
LayerNorm |
236 мс |
4% |
|
im2col и прочее в декодере |
194 мс |
4% |
|
текстовый энкодер |
15 мс |
0,3% |
Матричные умножения снова главные — так и должно быть. 2,5 миллиарда MAC за 3,1 секунды — это 0,8 GMAC/s в среднем по всем слоям, включая неудобные маленькие матрицы внимания (K=32).
Итоговые цифры:
|
Параметров |
2,9 млн (DiT + текст) + 179 тыс. (декодер) |
|
model.bin |
3,1 МБ во flash |
|
Пик SRAM |
~250 КБ |
|
Один шаг DiT (обе ветви CFG) |
632 мс |
|
Декодер |
343 мс |
|
Картинка за 8 шагов |
5,4 с |
|
Картинка за 4 шага |
2,9 с |
|
MAC на картинку |
2,5 млрд |
▍ Итоги
2,9 миллиона параметров, восемь шагов rectified flow, int8 на векторных инструкциях — и чип за несколько сотен рублей рисует лицо по русскому описанию за 5,4 секунды. А если согласиться на четыре шага — за 2,9. Да, иногда у него получается полный мужчина с бородкой, похожий на акварель, оставленную под дождём. Но для 512 КБ памяти это, по-моему, простительно.
Код: https://github.com/nikuson/esp32-test-to-image
Что дальше? В теории можно прикрутить дисплей и микрофон и сделать «рисующую рамку», которая слушает описания. А вы бы что запустили на ESP32?
ссылка на оригинал статьи https://habr.com/ru/articles/1095474/