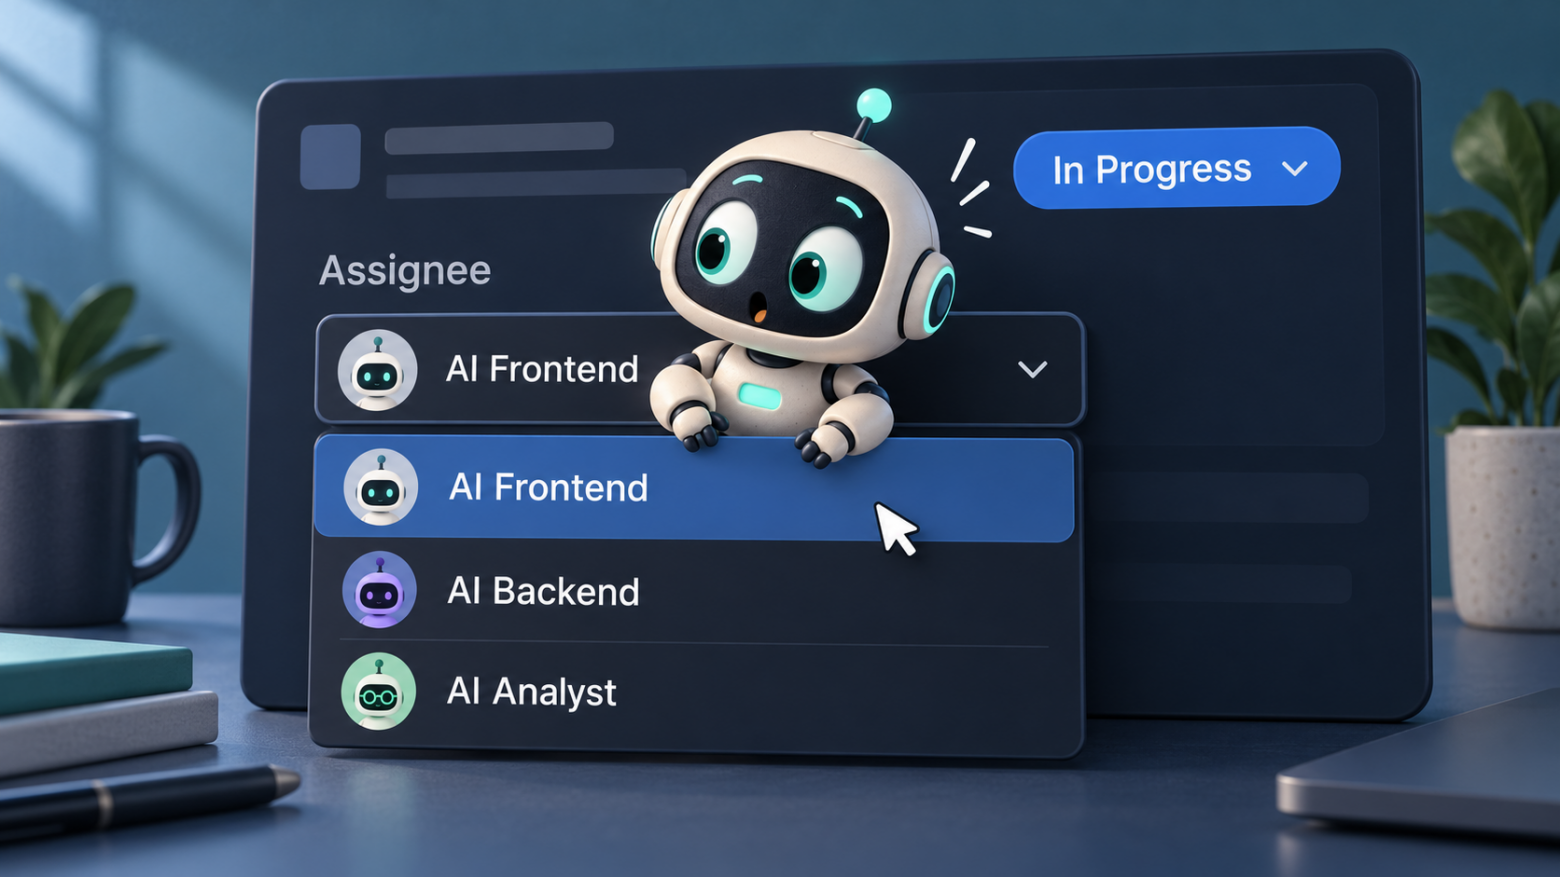
IT-команда в средней компании (продуктовой, интеграторе, неважно) обычно состоит из продукт-менеджера, бизнес-аналитиков, разработчиков и QA-инженеров. Работают они, как правило, в одном трекере вроде Jira. А теперь представьте, что в поле Assignee появились виртуальные коллеги на все эти роли. У меня таких три: фронт, бэк и аналитик.
Людей они не заменяют. Ревью, ответы на вопросы и последнее слово в MR остаются за человеком, ниже покажу, где именно. Агентам я отдаю oneshot-задачи: достаточно понятные и ограниченные, чтобы решить их за один проход без долгой переписки: добавить кнопку, поправить форму, подготовить черновик требований и проч.
С AI-агентами я работаю давно, а со своим harness (кто не в курсе, это рабочая среда вокруг модели: контекст проекта, инструкции, доступы, проверки) привык работать локально. Он давно стал рабочим контуром целой команды, без него не проходит ни одного дня. Но локальный вариант живет на машине каждого, а хотелось ставить агентам задачи так же, как людям: в Jira. Так появился серверный вариант.
Дальше два демо-сценария: небольшая frontend-задача и более сложная, для аналитика. Потом разберу, что стоит за полем Assignee.
Кейс 1. Одна кнопка и два merge request
Кнопка здесь не главное. Мне было интересно проверить весь процесс, от назначения задачи в Jira до изменений в коде, документации и ревью в GitLab. Поэтому взял небольшую задачу: добавить на карточку поставщика кнопку копирования реквизитов. В Jira это одна строка, без описания и макетов.
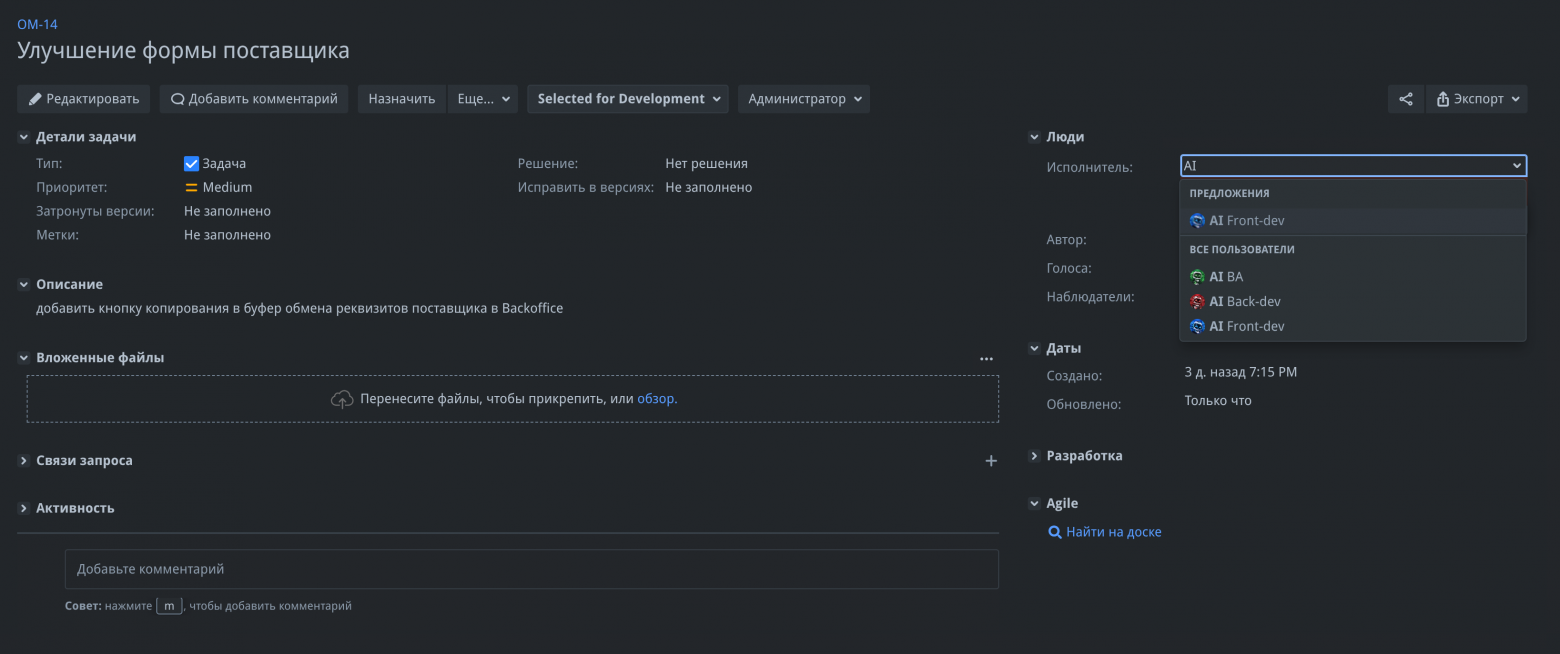
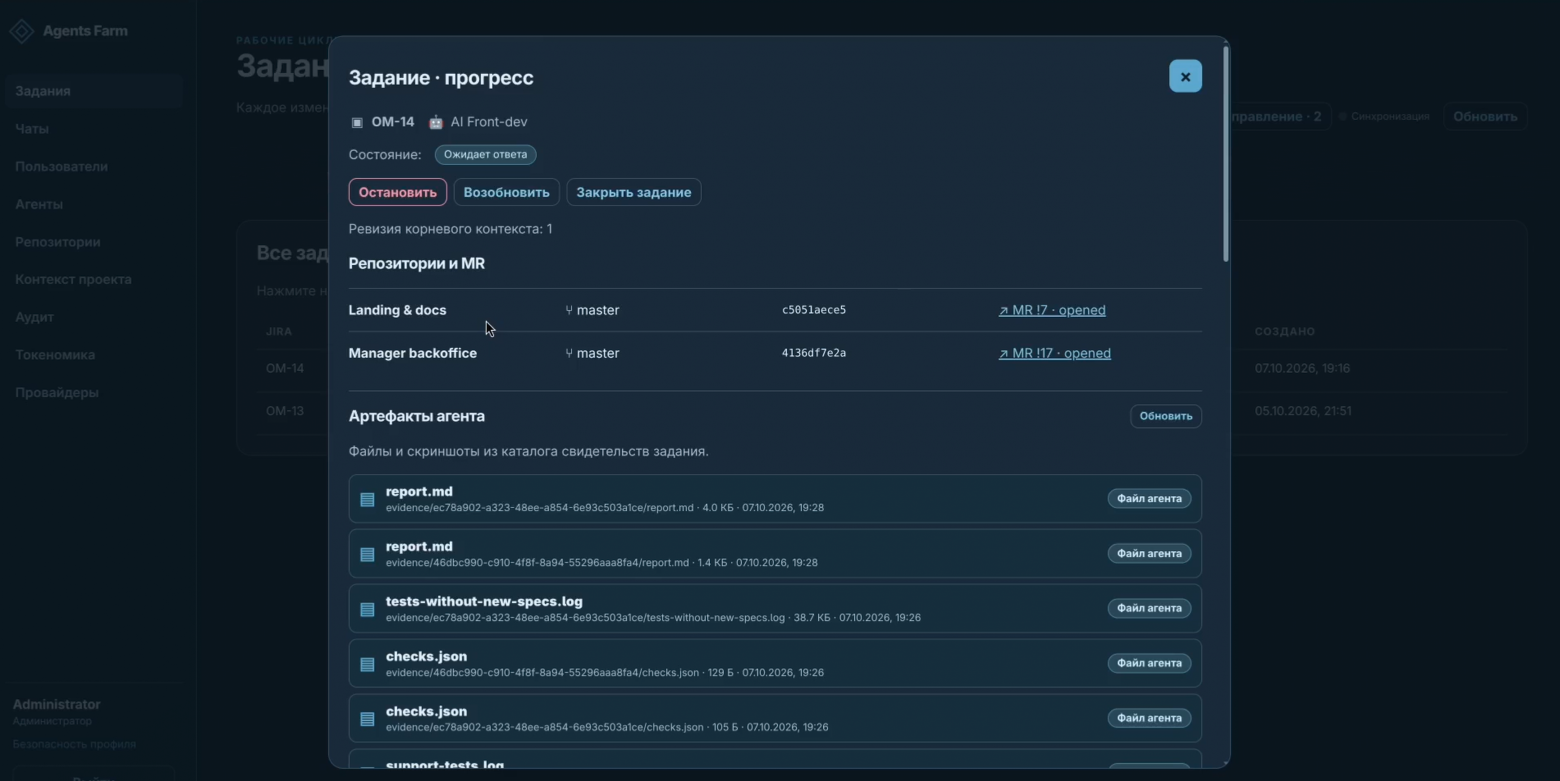
Назначаю исполнителем AI Front-dev, перевожу задачу в «В работе», и в бэкофисе harness автоматически появляется задание. В карточке видно, как агент загружает инструкции проекта, изучает репозитории, выбирает нужные и решает заодно обновить документацию. По ходу работы появляются логи тестов, результаты проверок и другие артефакты.
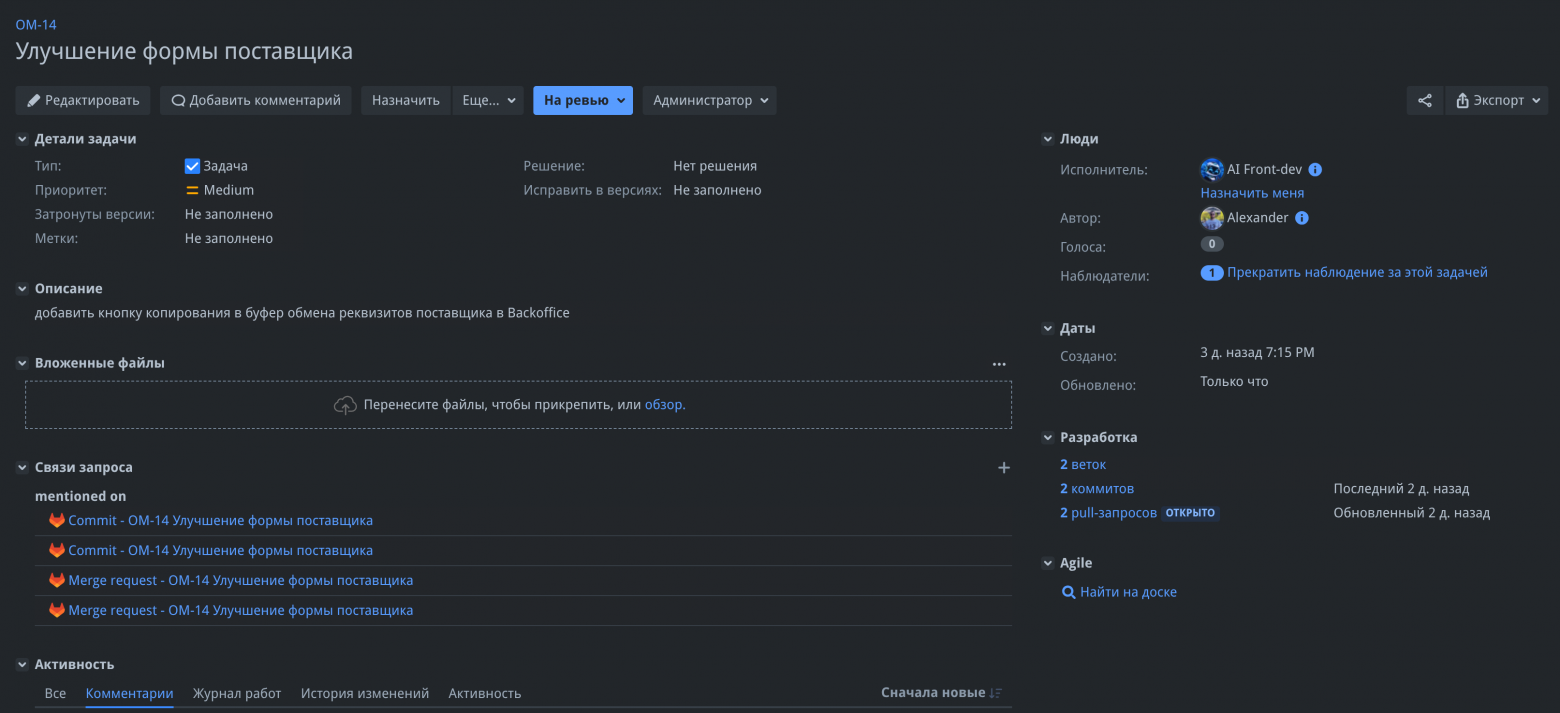
Итог: в задаче Jira две ссылки на merge request и статус «На ревью». В первом проектная документация с описанием новой кнопки. Во втором сама кнопка: код в стиле проекта, тест и логика копирования.
Я переключился на ветку и открыл форму. Кнопка появилась и копирует реквизиты в буфер:
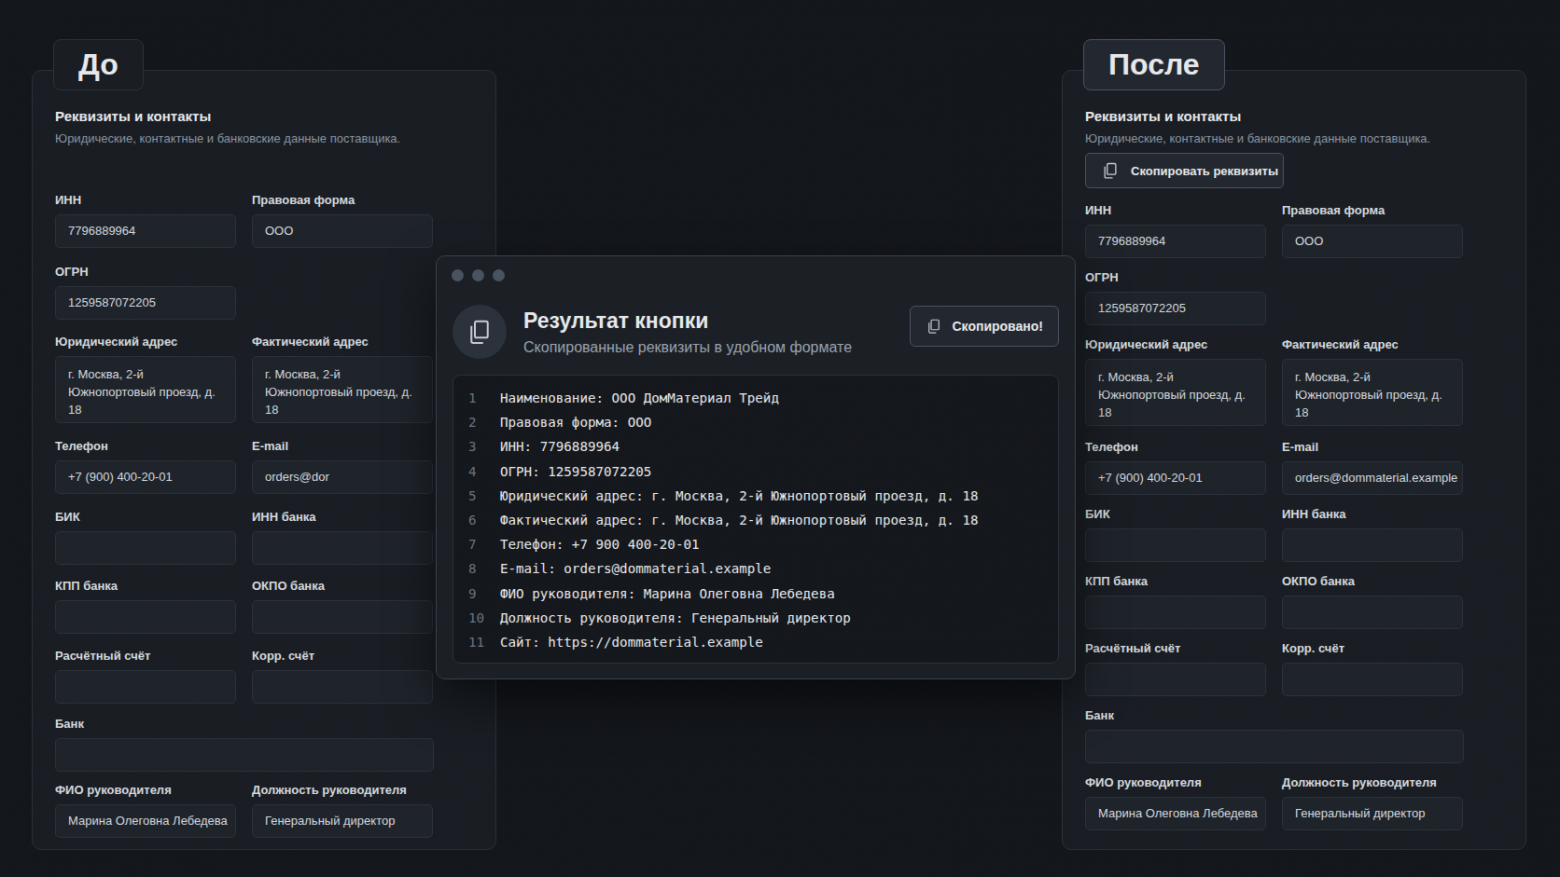
Работает, но выглядит скучно. Тут к агенту вопросов нет: в задаче была одна строка, без макета и требований к оформлению. Чтобы попасть в дизайн проекта, ему нужны макеты в Figma или хотя бы более подробное описание. Но это отдельный разговор, для теста это не важно. Дальше за мной остается только ревью MR от агента.
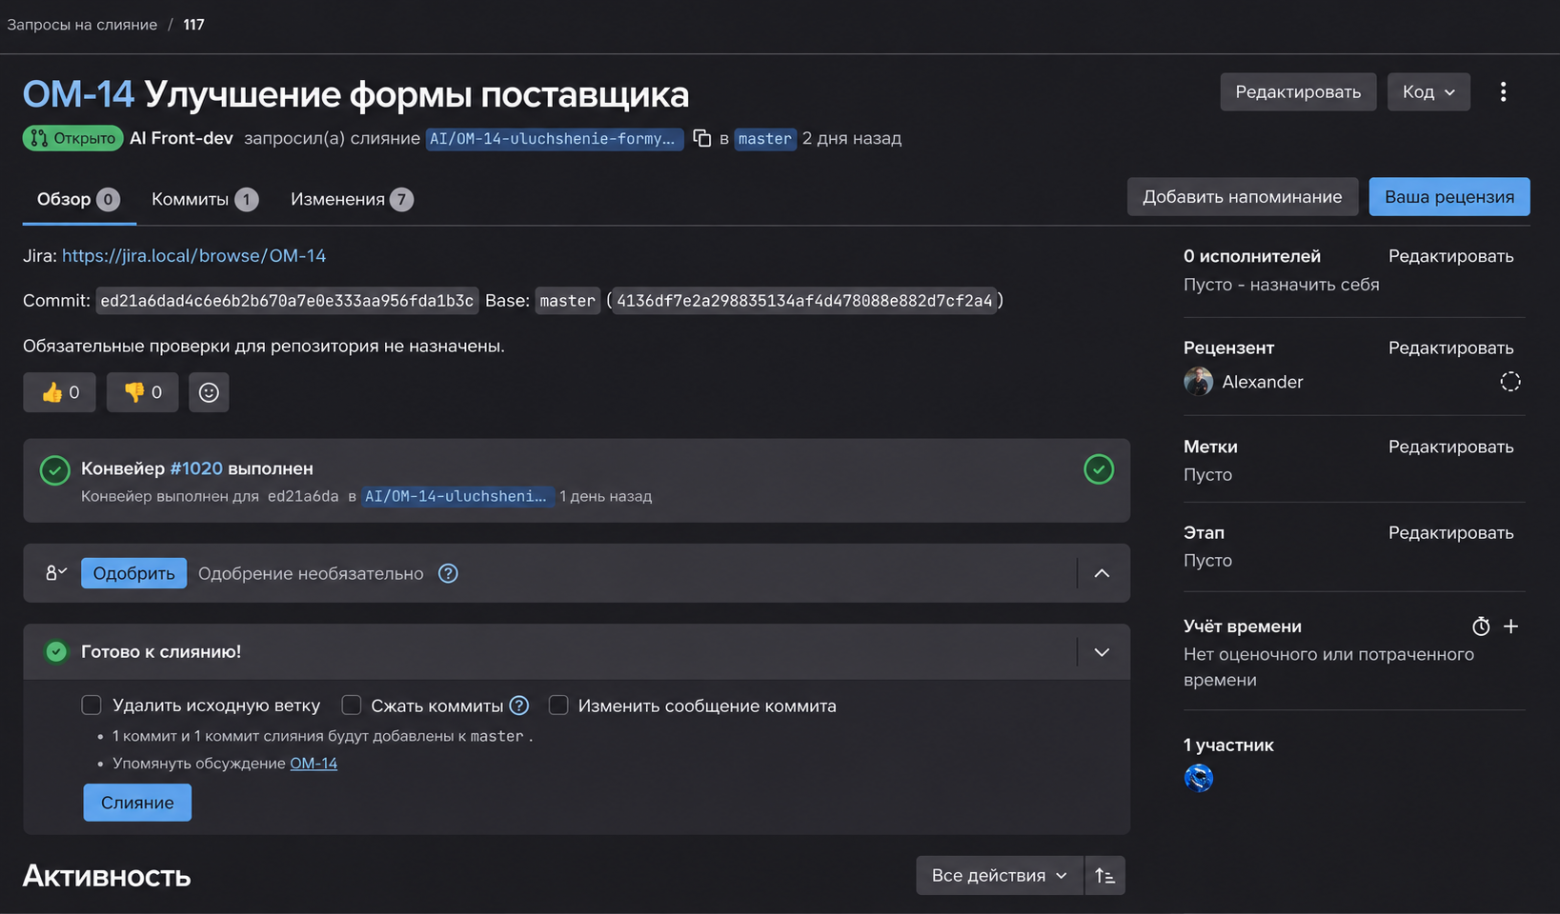
На первый взгляд код выглядит нормально, но MR в любом случае нужно проверять. Если что-то не устроит, я могу оставить комментарии и перевести задачу Jira в статус «В работе». И тогда агент автоматически снова возьмет задачу в работу, увидит что MR в задаче требует доработок, прочитает мои комментарии и сделает правки, цикл повторится.
Кейс 2. От бизнес-потребности до User Story
Теперь задача посложнее, и это уже не oneshot. Описываю потребность так, как мог бы написать заказчик, коротко и без технических деталей: «Хочется прямо из анализа остатков находить товары, которые скоро закончатся, и сразу создавать по ним заявку на поставку». В этом случае я назначаю исполнителем агента бизнес-аналитика и перевожу задачу в работу.
Аналитик читает документацию и репозитории (кодовую базу проекта он только читает) и останавливается: задание в harness переходит в «Ожидает ответа». Агент не додумывает за меня, а задает вопросы.
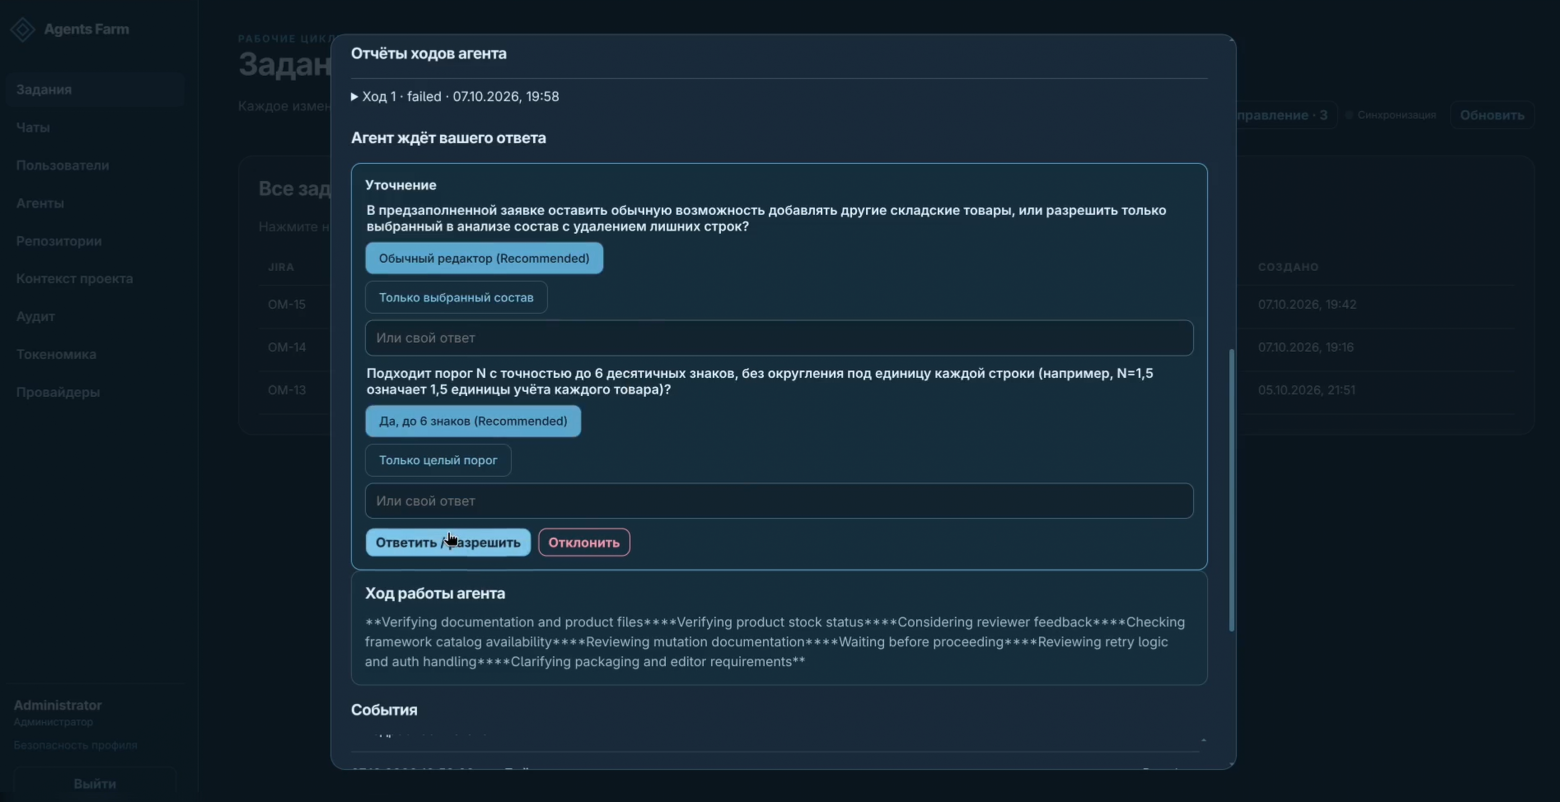
Вопросы конкретные, это развилки реализации. Например, можно ли менять состав товаров в созданной заявке или в нее должны попадать только выбранные позиции? Указывать порог остатков целым числом или разрешить дробные значения с точностью до шести знаков? К каждому вопросу агент предлагает рекомендованный вариант, а я могу выбрать его или написать свой ответ.
После моих ответов аналитик готовит черновик User Story в Confluence. Я читаю ее и решаю, что она готова для разработки.
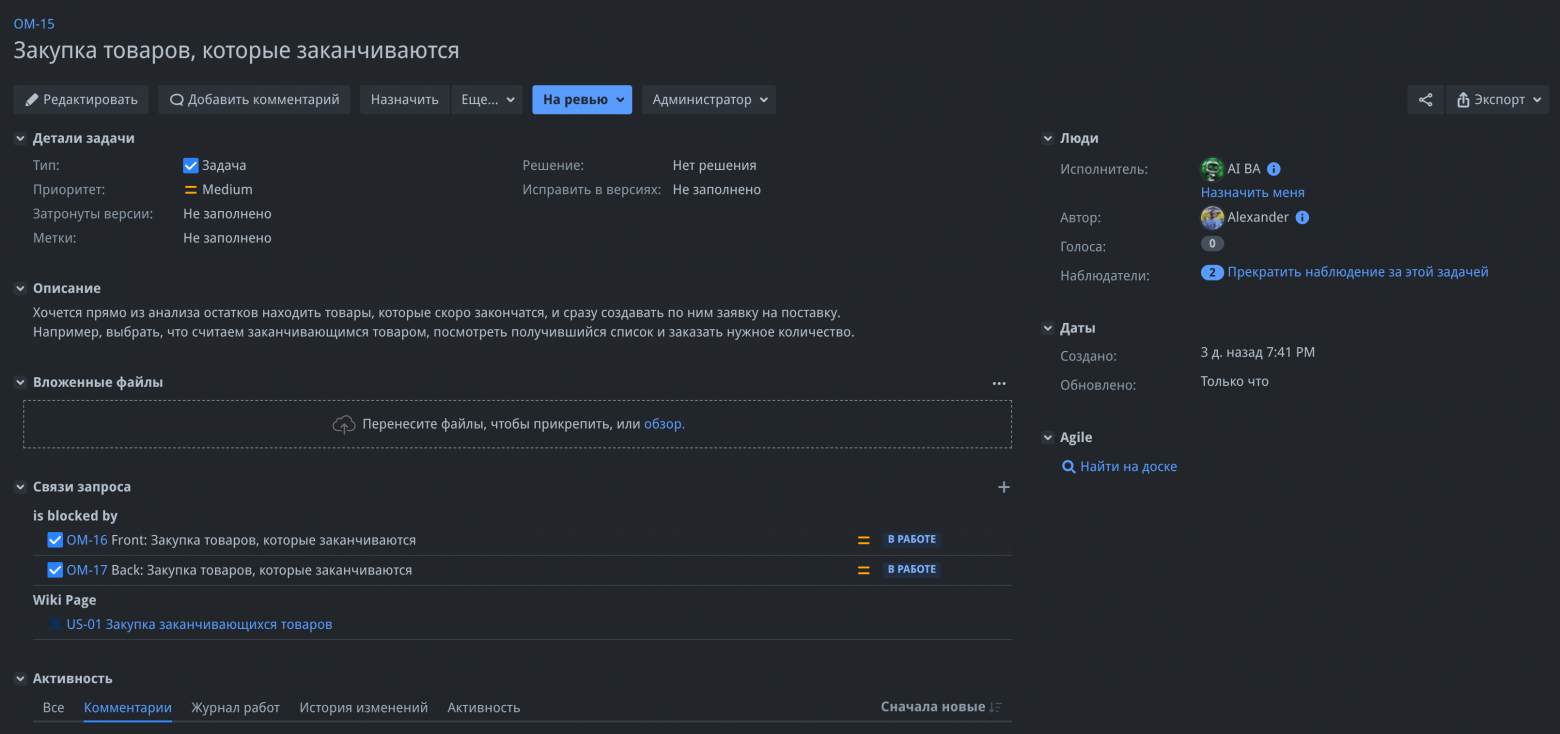
В исходной задаче теперь ссылка на User Story и две связанные задачи, Front и Back. Обе уже в статусе «В работе»: их получили разработчики-агенты. Как они справились, здесь не разбираю, механика та же, что в кейсе 1.
Человек в этой цепочке нужен трижды: ответить на вопросы, прочитать User Story, решить, что она готова для разработки. Остальное сделали агенты.
Как это устроено за полем Assignee
У каждого исполнителя в Jira есть профиль в harness: роль, модель, инструкции и доступы. Когда я назначаю задачу такому исполнителю и перевожу ее в «В работе», сервер проверяет назначение, создает задание и ставит его в очередь. Дальше работа идет по одному из двух сценариев из кейсов выше.
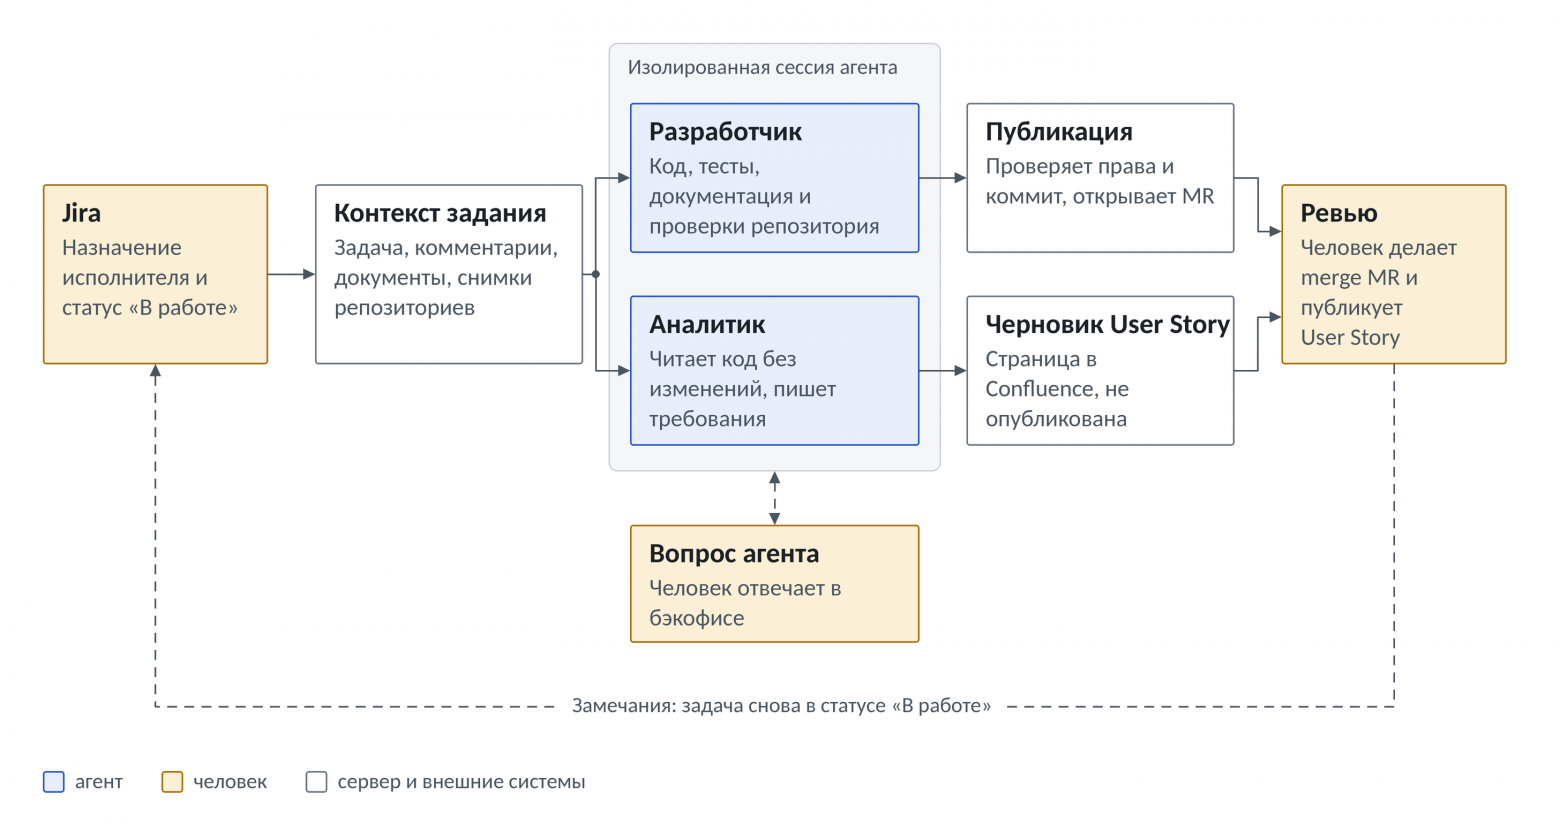
Сначала сервер собирает контекст: описание задачи, комментарии, связанные материалы из Jira и Confluence, инструкции проекта и снимки репозиториев. Версии источников сохраняются вместе с заданием, поэтому потом видно, на каких требованиях основывался результат. Если в контексте остаются существенные пробелы, задание ждет человека для уточнений.
Работа идет в отдельном окружении. Агент-разработчик готовит код, тесты и документацию. Агент-аналитик читает код, но менять репозитории в этом режиме не может: его результат это требования. Если для продолжения нужно решение человека, агент задает вопрос через бэкофис. Эта остановка была показана в кейсе 2.
Для каждого репозитория можно настроить свои проверки. Например, линтер, тесты, сборка. Для интерфейсных задач можно добавить прогон в headless-браузере со скриншотами. Команды и результаты сохраняются в артефактах задания. Если проверка упала, сервер запрашивает решение человека: исправить команду, доработать результат или согласовать пропуск с указанием причины. Если обязательных проверок для репозитория не назначено вообще, MR все равно создается, но с отметкой об этом.
Ветки и MR публикует отдельный серверный компонент, не сам агент. Перед отправкой он сверяет права исполнителя, актуальность задания, исходную ветку и коммит, к которому относятся проверки. Для аналитика результат это неопубликованный черновик User Story в Confluence. Merge или публикацию документа делает человек.
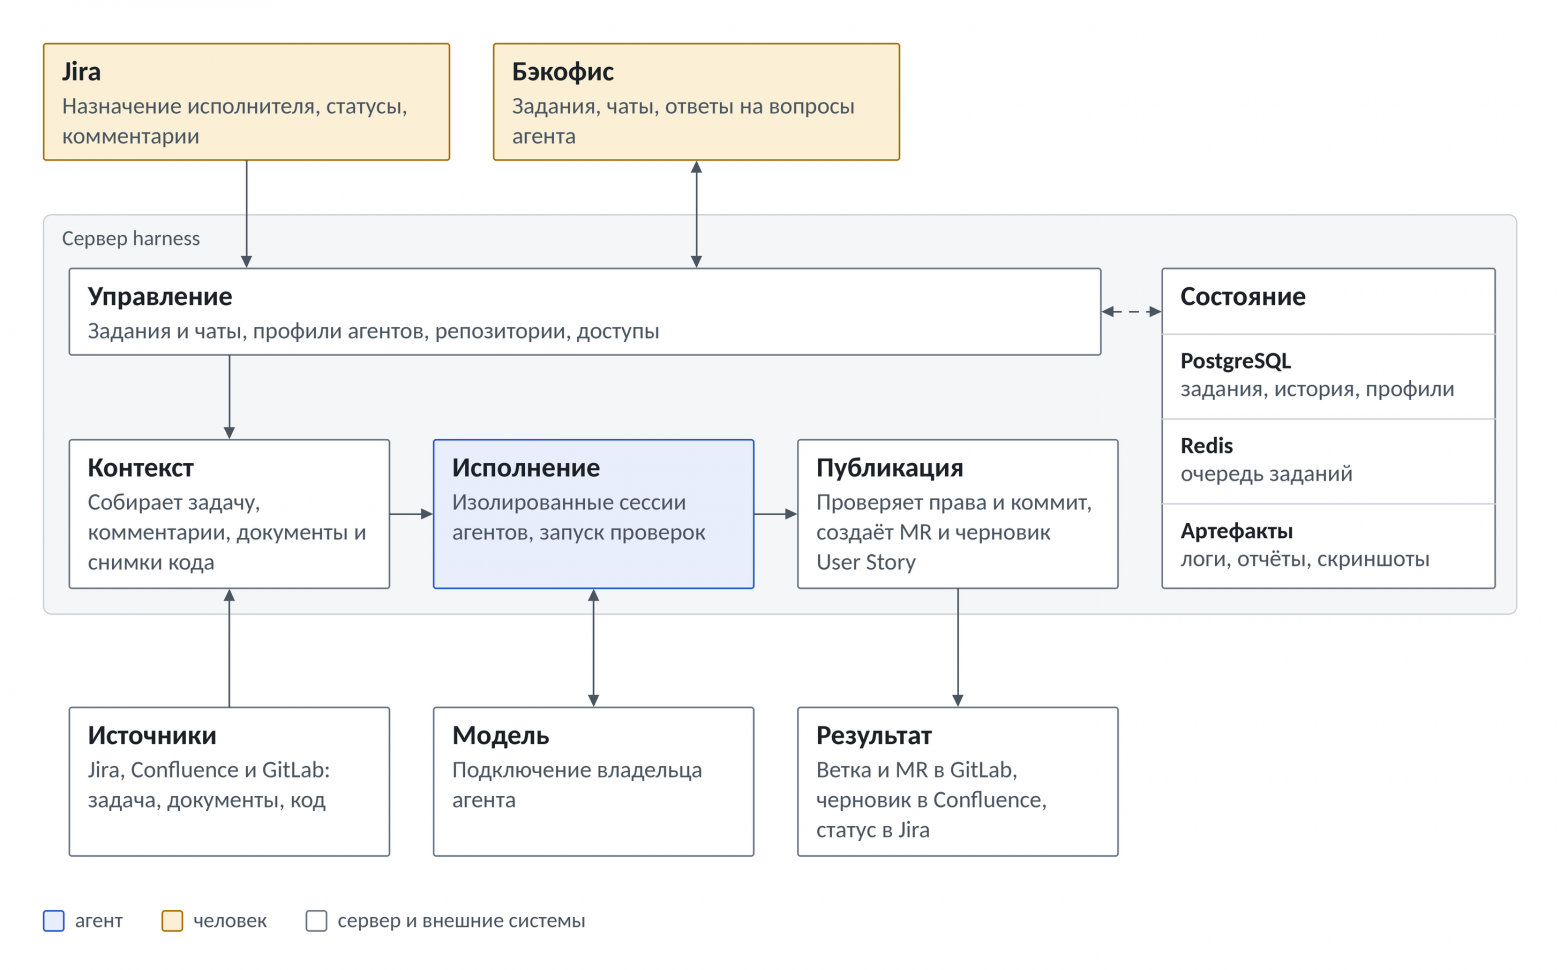
Задание живет на сервере: PostgreSQL хранит состояние и историю, Redis распределяет работу. Поэтому я могу закрыть вкладку, вернуться позже, открыть подготовленные файлы, остановить или возобновить задание. В бэкофисе собраны события, вопросы, артефакты и расход токенов. Скрытые рассуждения модели при этом не сохраняются: видны действия, команды и результаты, а не «о чем агент думал».
Как локальный harness стал серверным
За основу я взял harness, которым пользовался локально: роли агентов, скиллы, инструкции, доступ к кодовой базе и правила проверки результата. Если вы собрали такую среду под себя, ее можно сделать основой серверного варианта. Потребуется добавить запуск из трекера, состояние заданий, изолированное выполнение и бэкофис для людей. Схема выглядит так:
Отдельный вопрос — учетные записи. Чтобы агенты появились среди исполнителей Jira, их нужно зарегистрировать в трекере. А для работы с документацией и кодом необходимо настроить доступы к Confluence и GitLab. Я сделал это так:
-
Владелец и модель. В harness создаю пользователя-человека, подключаю его учетную запись у провайдера. Для каждого пользователя создаю несколько исполнителей (агентов), выбираю для них роль, модель и уровень рассуждений.
-
Учетки агентов в Jira, Confluence и GitLab. Каждому исполнителю нужен доступ во все три системы: видеть свои задачи, читать документацию, работать с разрешенными проектами GitLab. Права задаются в самих сервисах и не зависят от владельца в harness.
-
Три PAT. Personal Access Token это токен, с которым сервер обращается к API от имени учетной записи агента. Для каждого сервиса выпускаю отдельный токен и добавляю его в профиль исполнителя. harness проверяет токены и определяет их владельцев.
-
Репозитории и проверки. Для каждого репозитория указываю источник, ветку по умолчанию, доступ на чтение и команды проверок, при необходимости выбираю UI-профиль для серверных проверок.
-
Контекст и автозапуск. Задаю инструкции, скиллы и документацию, разрешаю серверное исполнение и включаю автозапуск нужных агентов. После этого назначение в Jira связывает задачу с конкретным профилем: сервер знает роль, модель и источники.
Чаты в бэкофисе
У harness есть второй вход: чаты. Здесь можно обсудить идею, спросить про существующий код или разобрать файл, не заводя задачу в Jira. Перед кейсом 1 я так и сделал: открыл чат с профилем фронтенд-разработчика и репозиторием интерфейса и спросил, какие реквизиты у карточки поставщика уже есть.
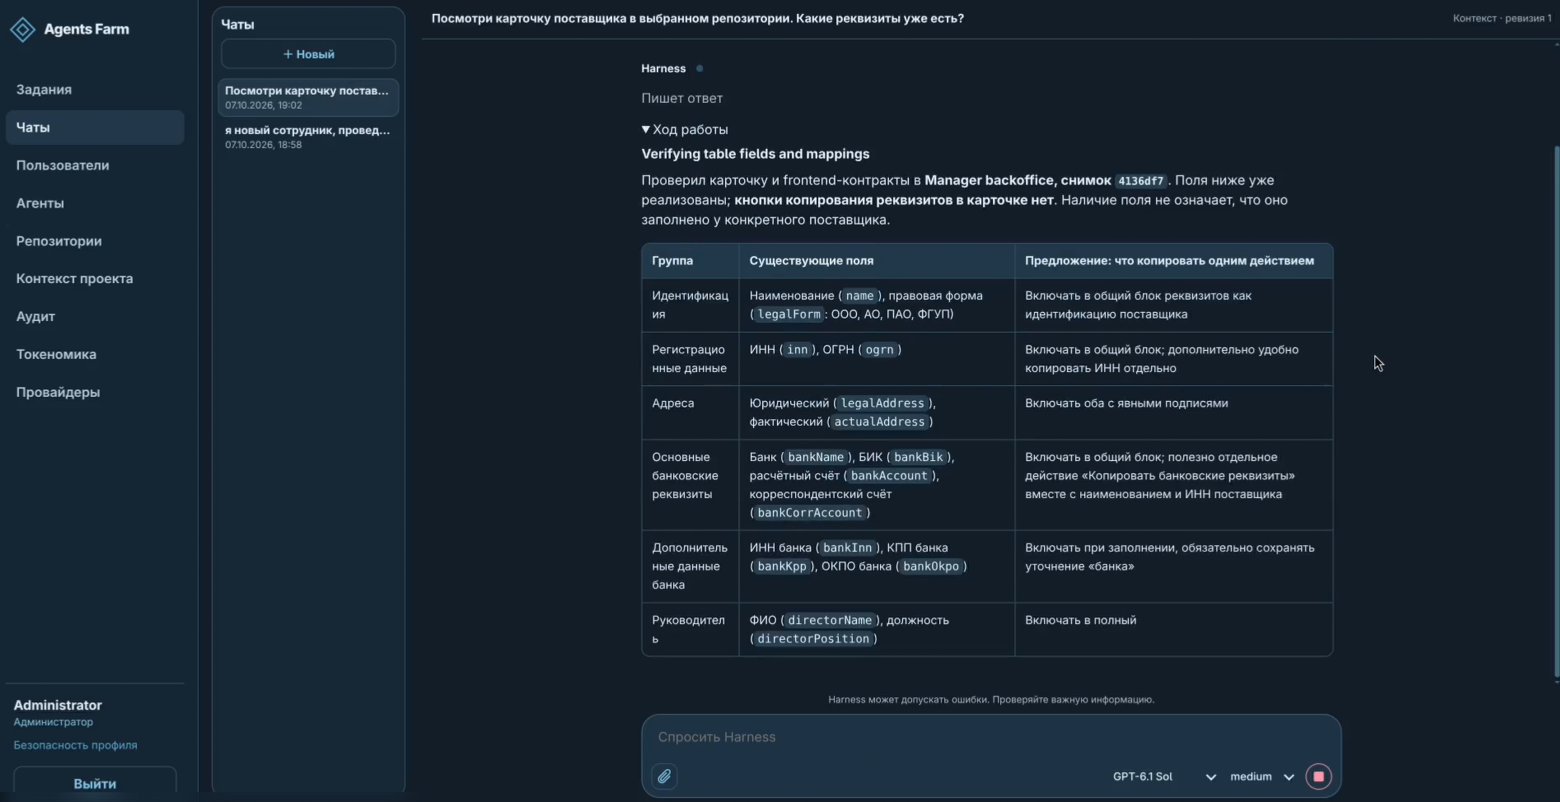
Агент посмотрел код и ответил по существу: поля реализованы, кнопки нет. Дальше разбил поля на группы и предложил, что копировать одним действием: общий блок, банковские реквизиты и ИНН отдельно.
Для простых вопросов есть быстрый чат без выбора агента и репозиториев. Если нужен контекст проекта, выбираю профиль исполнителя и нужные репозитории. Можно добавить ссылки на Jira, Confluence или GitLab: сервер проверит доступ и загрузит связанные материалы. Чат поддерживает вложения, а агент при необходимости может подготовить файл для скачивания с результатом работы которую он провел.
Репозитории в чате открыты только на чтение, созданные файлы лежат отдельно от кодовой базы. История сохраняется, расход попадает в токеномику, текущий ответ всегда можно остановить. Полученный разбор помогает уточнить постановку, а задачу на реализацию я назначаю уже через Jira.
Что это дает
Задачу можно поставить откуда угодно. Достаточно открыть Jira, хоть с телефона В моей конфигурации для этого не нужен VPN или локально запущенный harness, необходимые подключения уже настроены на сервере. Само задание живет на сервере, вкладку можно закрыть и вернуться к результату позже.
Задачи встают в очередь. Можно назначить несколько подряд, не дожидаясь результата по каждой — назначил, ушёл на встречу, вернулся к готовым MR и вопросам от агентов.
Подходит команде. Любой участник ставит агенту задачу так же, как коллеге: через Assignee. На эту схему очень хорошо ложатся oneshot-задачи. Их можно отдать в работу сразу, не стоя в очереди к разработчикам, не открывая репозиторий и не поднимая окружение. Разработчик подключается позже: смотрит готовый MR, а не делает правку с нуля.
Правила одни на всех. Инструкции проекта, роли и проверки лежат на сервере, а не у каждого на машине. Обновил в одном месте, и новые задания работают уже по новым правилам. Запущенные остаются на том контексте, с которым стартовали.
Но есть и обратная сторона. Чем больше задач выполняют агенты, тем больше результатов нужно проверять. Скорость генерации кода сама по себе мало что дает, если на ревью уходит столько же времени, сколько заняла бы ручная разработка. Поэтому я пока смотрю на эту систему как на способ делегировать ограниченные задачи, а не как на замену полноценной команде.
Цена вопроса
В бэкофисе есть токеномика: входные и выходные токены, использование кэша и расчетная стоимость каждого задания и чата. Ниже статистика из двух примеров статьи.
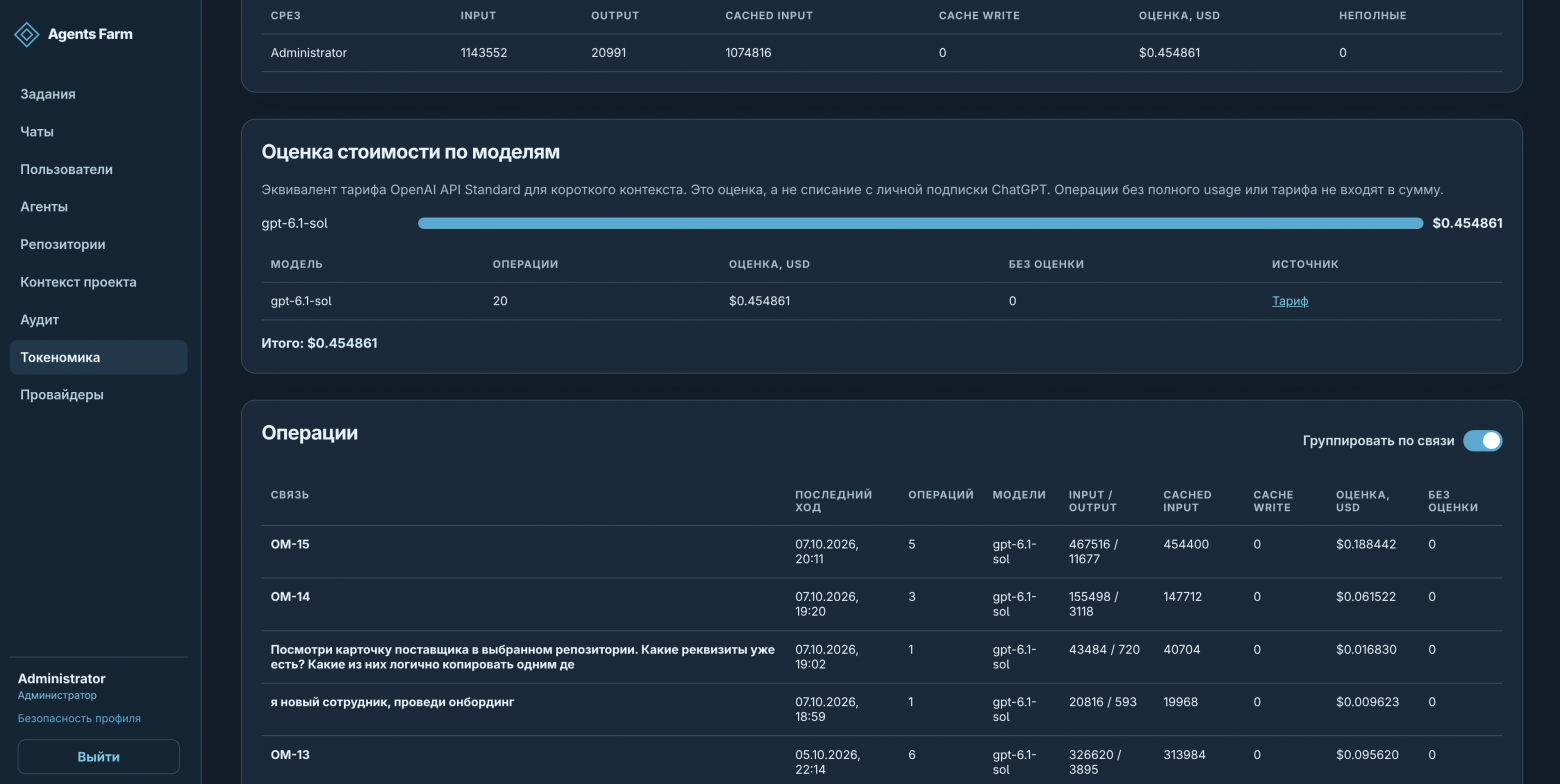
В моем случае эти суммы не являются фактическими списаниями. Я использую оплаченную подписку с лимитами, а harness рассчитывает, сколько аналогичная работа стоила бы по тарифам API. Поэтому цифры на экране это ориентир для сравнения задач, а не полная стоимость их выполнения.
Для демонстрации я выбрал флагманскую модель. Для такой небольшой кнопки это избыточно, можно попробовать модели дешевле.
При использовании API расходы будут зависеть от фактического числа токенов и тарифов провайдера. Но и тогда токеномика не покажет полную стоимость: отдельно остаются серверная инфраструктура, поддержка harness и время человека на проверку результатов. Полную стоимость одной принятой задачи, включая ревью и возможные доработки, я пока не измерял.
Что в итоге
Изначально мне хотелось избавиться от необходимости вручную переносить задачи из Jira в локальный harness. В итоге получилась серверная система, где AI-агентам можно назначать задачи как обычным исполнителям, а результаты проверять в Jira, GitLab и Confluence.
Пока я вижу в этом удобный способ отдавать агентам небольшие задачи и подготовку требований. По времени разница заметная: кнопка из кейса 1 заняла у агента около 12 минут от создания задания до готовых MR, а разработчик, по моей оценке, списал бы на такую задачу от одного до четырёх часов. Но это время до готового MR: ревью остаётся за человеком и может стать узким местом. Поэтому два вопроса к вам.
Первый. Представьте: раньше вы получали один MR в день, а теперь агенты приносят тридцать. Внимательно проверить каждый уже не получается. Что будете делать? Ограничите поток, усилите автоматические проверки и станете вручную смотреть только рискованное, распределите ревью на всю команду (включая коллег уровня junior) или пересмотрите постановку задач, чтобы у агентов было меньше свободы?
Второй. Выходит, агенты съели хлеб джунов — ведь раньше именно на таких задачах они набивали руку. А теперь что, учиться на ревью AI-кода? Кто и как будет растить будущих мидлов и сеньоров? Вы уже придумали, что с этим делать?
Напишите в комментариях, как вы это решаете или как собираетесь решать.
ссылка на оригинал статьи https://habr.com/ru/articles/1095690/