Бесконечные запросы на выгрузку данных, ожидание нужных отчетов, жаркие споры вокруг инициатив на планерках, не подкрепленных цифрами, — это признаки дефицита данных у менеджеров. Мы столкнулись с этой проблемой и благодаря современным технологиям смогли решить ее. Результаты меня впечатлили и порадовали.
Меня зовут Станислав Решетнев. Я отвечаю за направление разработки Link Building в Sape, а также возглавляю команду Платформы. Наш актуальный проект — ИИ-платформа. Сегодня я расскажу об одном из ее важнейших компонентов, который уже отлично показал себя, — Sape Unified Data Access (универсальный доступ к корпоративным данным).
От классических витрин данных к ИИ-агенту
Доступность, полнота и качество данных необходимы современному бизнесу для выживания. Важно понимать, с какими задачами пользователь приходит в продукт и насколько успешно справляется с ними. Нужно уметь находить инсайты для новых продуктовых гипотез и идеи для персонализированных предложений. И это далеко не все. У биржи есть ценный актив — данные о пользовательском опыте, который теперь мы можем извлекать и применять для развития продукта.
Конечно, у нас есть витрины данных в их классическом представлении: материализованные структуры в базах данных (БД) и платформа бизнес-аналитики. Однако источники данных в витрины добавляются вручную, и этот процесс может занимать несколько дней. Кроме того, наборы доступных срезов данных заранее определены. Источников очень много, поэтому в конечном счете мы упираемся в возможности дата-аналитиков.
Мы решили пойти другим путем и предоставить сотрудникам доступ к базам данных через ИИ-агента. Главная ценность такого подхода — возможность свободно группировать, фильтровать и объединять данные из разных источников. При этом есть и ограничения: например, без специализированных материализаций скорость обработки данных остается невысокой.
Первые результаты: как ИИ-платформа помогает менеджерам
Sape Unified Data Access начал приносить пользу еще на этапе создания PoC (Proof of Concept — проверки концепции, или работающего прототипа). У менеджеров пока не было непосредственного доступа к инструменту, но мы уже могли находить ответы на актуальные для них вопросы. Ниже я приведу несколько примеров того, как корпоративные данные помогли разобраться в проблемах и найти полезные решения.
Пример № 1. Связь между расположением ссылки и сроком ее жизни
Биржа позволяет подобрать страницу-донор для размещения ссылки по набору параметров. Сейчас их более 70. Однако есть и другие факторы, влияющие на качество размещения и, как следствие, на удовлетворенность рекламодателя.
Однажды в чате разгорелся спор о том, как место размещения ссылки на странице (мы используем термин «подвальность») влияет на вероятность ее отмены в течение недели и на срок ее жизни в целом. Этот спор так и остался бы на уровне догадок, если бы не появившийся прототип компонента доступа к данным в ИИ-платформе. Мы задали ему несколько наводящих вопросов и в итоге получили интересный результат:
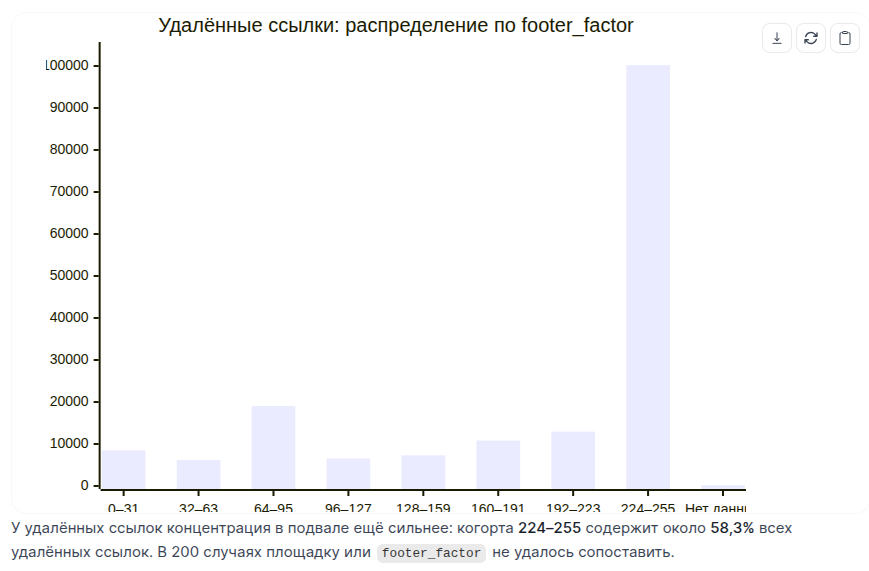
Около 60% ссылок, которые были куплены и удалены за прошлый месяц, находились в самом низу страницы. Разница с другими когортами и общей базой доноров оказалась настолько существенной, что мы увидели явную взаимосвязь. Теперь мы знаем, как сделать поисковую выдачу еще качественнее: поработать с «подвальностью» доноров.
Представим, что менеджер проводил бы такую аналитику с помощью выгрузок данных. Ему потребовалось бы несколько итераций, чтобы сформулировать обоснованную продуктовую гипотезу. Здесь же весь процесс занял не более получаса.
Пример № 2. Простая любознательность и полезная находка
Продуктовый менеджер Элеонора начала знакомство с ИИ-платформой с простого вопроса: у каких пользователей больше всего ссылок заблокировано из-за недостатка средств на балансе?
В личной переписке Элеонора поделилась первыми результатами:
«Я изучала статистику и нашла 2 аккаунта, у которых часто заканчиваются деньги на балансе. Коммерция связалась с пользователями, обсудили удобный для них способ пополнения и проблему устранили».
Этот пример показывает, что даже простой запрос к данным может помочь обнаружить проблему, которую раньше не замечали.
Пример № 3. SQL-запрос для микросервиса адаптивной витрины
Продуктовый менеджер Афанасий самостоятельно разрабатывает микросервис, который рассчитывает веса доноров для адаптивной витрины (системы ранжирования поисковой выдачи). Он тестирует алгоритмы, формирует запросы и периодически обновляет микросервис.
Получив учетную запись в ИИ-платформе, Афанасий первым делом обратился к ней, чтобы выяснить, в каких полях хранятся интересующие его данные и как составить SQL-запрос для своего микросервиса. Sape Unified Data Access помог найти нужные данные и подготовил запрос всего за пять минут.
Показательно, что все эти сценарии использования не были запланированы. Менеджеры сами начали искать способы решить свои рабочие задачи, а ИИ-платформа предоставила им такую возможность. Фактически менеджеры постепенно начинают самостоятельно выполнять задачи дата-аналитиков.
Как устроена ИИ-платформа: архитектура решения
Наше решение построено на базе Open WebUI с моделью, которая использует навык с описанием нашего бизнеса, и MCP (Model Context Protocol — протокол контекста модели), обеспечивающего доступ к кластеру Trino.
Для пользователей Платформы, то есть наших менеджеров, работа с системой выглядит так:
Внутри решение устроено следующим образом:
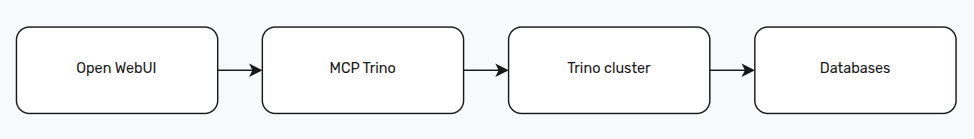
Рассмотрим каждый из компонентов подробнее.
Open WebUI
Описание модели в Open WebUI выглядит следующим образом:
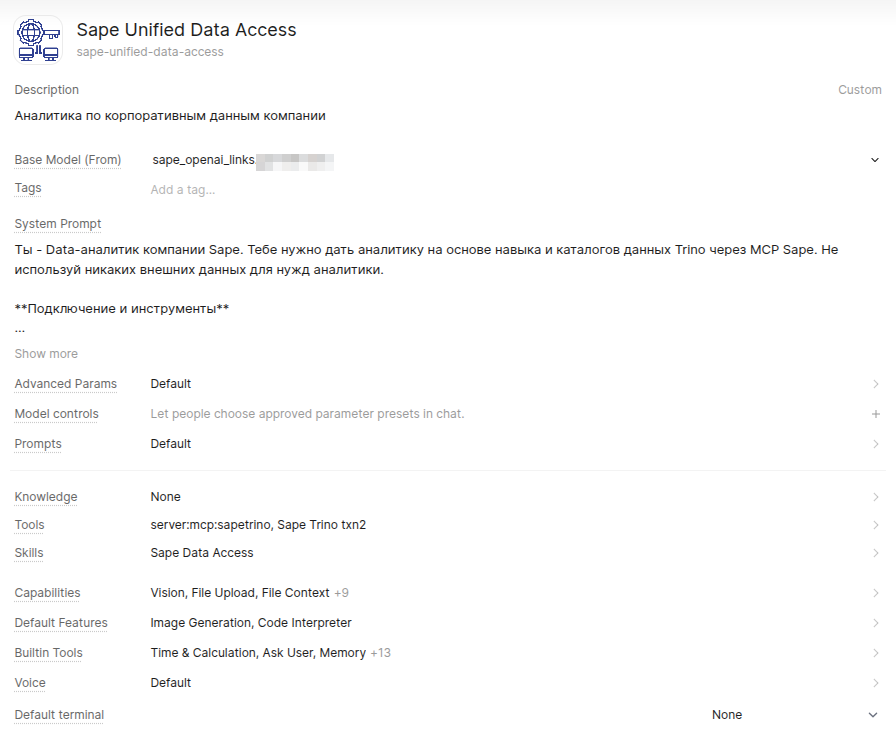
MCP рассмотрим ниже, а пока остановимся на подключении навыка (Skill), который используется при работе с ним. Skill и MCP Trino тесно связаны благодаря общему семантическому описанию.
Навык содержит описание нашего бизнеса, бизнес-сущностей и каталогов данных. В нем описано, чем занимается компания, какие у нее есть продукты, каковы их особенности и по каким алгоритмам работает система. Кроме того, навык включает техническую информацию: описание каталогов данных и рекомендации по оптимизации запросов.
Ниже приведу фрагмент этого навыка.
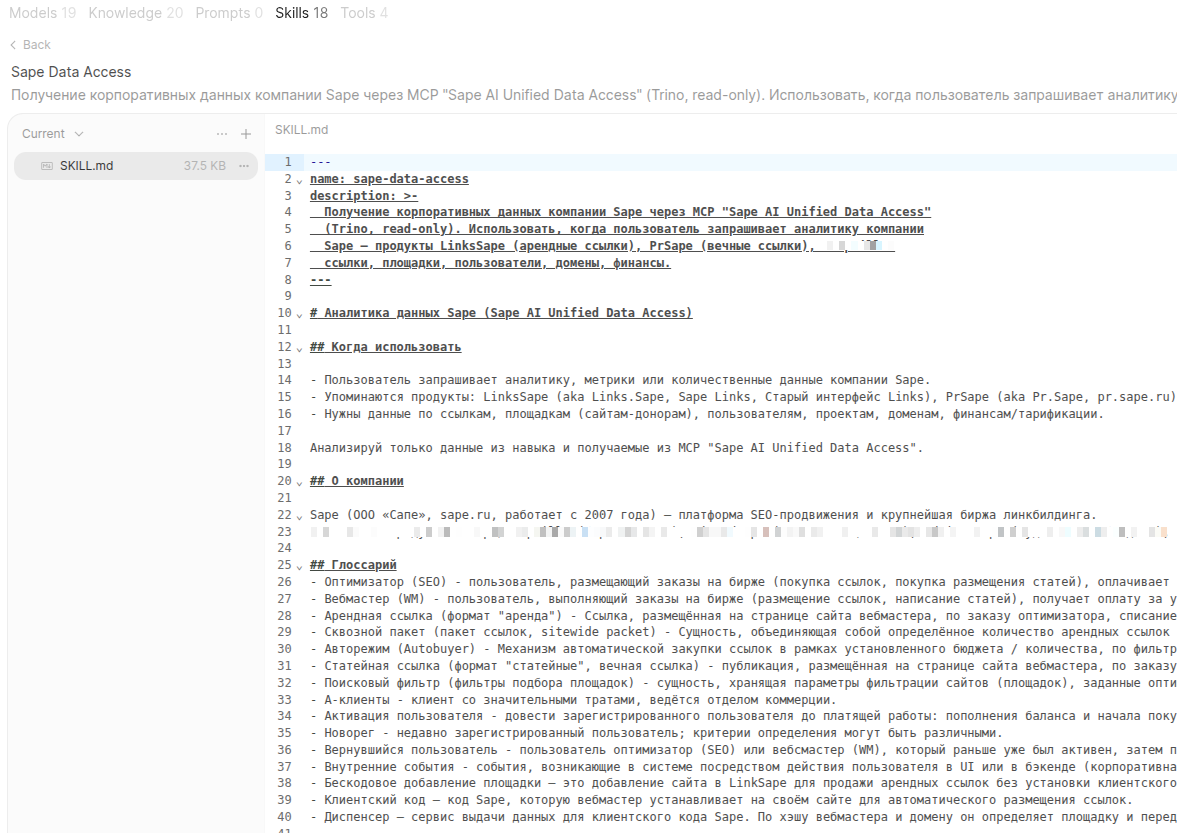
Open WebUI предоставляет привычный веб-интерфейс, похожий на интерфейсы Claude и ChatGPT. Менеджеры могут общаться с ИИ-агентом в чате текстом или голосом, а также прикреплять документы.
MCP Trino
Для доступа к кластеру Trino мы выбрали пакет txn2/mcp-trino. Его преимущество в том, что он поддерживает семантический слой на своей стороне: добавляет метаданные таблиц непосредственно в инструмент trino_describe_table (инструментами, или тулами, называют функции MCP).
Конфигурация семантического слоя хранится в файле semantic.yaml. В нем описаны таблицы и их поля.
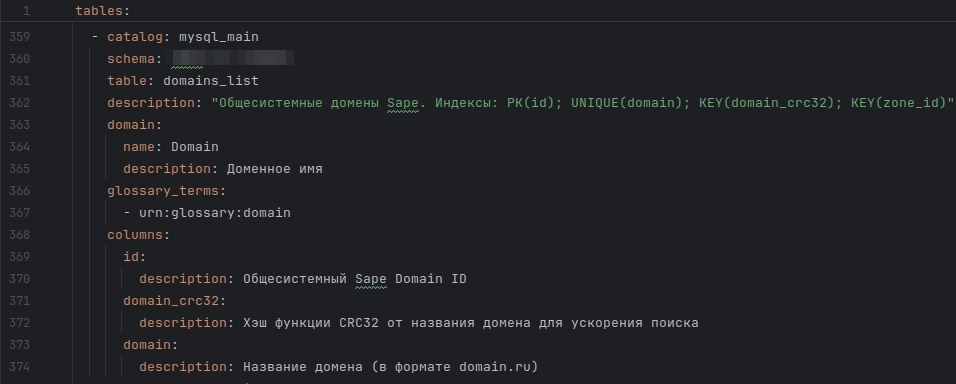
При вызове инструментов для описания таблиц MCP заменяет описания, полученные из БД, теми, что указаны в этом файле. Благодаря этому мы можем дополнять структуры описаниями, которые соответствуют нашей предметной области, а не ограничиваться техническими пояснениями, обычно содержащимися в комментариях к таблицам и полям.
Это позволяет согласовать терминологию в двух местах: в Skill мы описываем предметную область, а в semantic.yaml — таблицы и поля с использованием той же терминологии. В результате агент лучше ориентируется в структуре данных и может самостоятельно подбирать нужные таблицы и поля в соответствии с запросом пользователя.
Например, в этом фрагменте семантического описания мы явно указали, что ID домена является общесистемным (сквозным). Благодаря этому указанию и упоминанию данного правила в Skill агент понимает, что разные таблицы можно связывать между собой по этому полю.
Если не указать, что ID является сквозным для всей системы, агенту придется самостоятельно определять границы его уникальности. В результате он может ошибаться при объединении таблиц.
В Skill мы отдельно описали общесистемные сущности и сущности, уникальные в пределах конкретного продукта. При этом не стали дублировать описания отдельных полей конкретных таблиц, чтобы сохранить модульность системы.
Таким образом, MCP выступает промежуточным звеном, через которое ИИ-агент взаимодействует с кластером Trino.
Кластер Trino
Trino обеспечивает федеративный доступ к корпоративным базам данных: он позволяет одним запросом получать данные из разных источников и объединять их в едином результате.
Например, мы хотим узнать, сколько ссылок было создано за вчерашний день. При этом часть данных находится в основной базе, а часть — в архиве (удаленные ссылки хранятся отдельно от активной базы). Trino позволяет получить информацию из обеих баз в рамках одного запроса.
Кластер Trino хорошо масштабируется. Поскольку в его архитектуре разделены узлы-координаторы и вычислительные узлы (compute nodes), мы можем независимо увеличивать количество тех и других. При необходимости также можно развернуть мультикластерную архитектуру.
Кроме того, Trino позволяет гибко настраивать права доступа. В нашей системе они разграничены по группам пользователей и доступным им таблицам. Ограничение на чтение данных (read-only) реализовано сразу на нескольких уровнях: в настройках пользователя БД, в файле access-control.json Trino и непосредственно в MCP.
Итоги: новые возможности для работы с корпоративными данными
Одна из особенностей ИИ-агентов — способность самостоятельно искать способы решения задач. В нашем случае агент подбирает способы извлечения необходимых данных, в том числе ищет подходящие комбинации индексов, чтобы выполнить запрос в пределах установленного таймаута. Это особенно важно при работе с таблицами, которые изначально не предназначены для использования в качестве витрин данных. В результате агент готовит аналитику практически под ключ.
Данные могут быть разнообразными и дублировать друг друга, но при этом иметь разную логику хранения и представления. Например, списания по подписочной модели можно рассчитать, определив срок действия подписки и умножив его на стоимость. А можно получить готовые данные о списаниях непосредственно из биллинговой базы. Поэтому в промпте лучше уточнять, откуда агент взял данные: из какого каталога и почему выбрал именно этот источник. При работе с ИИ важно контролировать ход его рассуждений. Многое зависит и от возможностей используемой языковой модели.
Доступность корпоративных данных помогает нам стимулировать менеджеров и разработчиков к самостоятельному поиску решений и позволяет подкреплять идеи реальными данными. Теперь сотрудники могут получать доступ к информации, которая раньше была для них недоступна. Однако результаты работы агента необходимо проверять: он должен указывать каталог, из которого получил данные, и объяснять, почему выбрал именно этот источник.
В этой статье я рассказал о решении для доступа к корпоративным данным компании. Однако ИИ-платформа Sape гораздо шире и включает ряд других компонентов. Например, у нас есть отдельное направление, связанное с разработкой, — конструктор для создания приложений с подходом AI-First. Об этом я расскажу в одной из следующих статей.
ссылка на оригинал статьи https://habr.com/ru/articles/1104110/