Как превратить готовый аудиофайл в читаемую стенограмму: пять маршрутов, бесплатные лимиты, сохранение текста и проверка ошибок в именах, числах и терминах.
Перевести аудио в текст онлайн можно через транскрибатор или чат с поддержкой аудиофайлов. Есть и локальное распознавание. Сравним пять маршрутов для готовой записи: загрузку, ограничения, сохранение и проверку результата.
У вас уже есть MP3, M4A или WAV: интервью, рабочий разговор, комментарий эксперта. Нужен читаемый текст с сохранением реплик, цифр и оговорок. Начать стоит с вопроса: запись можно передать облачному сервису или она должна остаться на компьютере? Реклама. ООО «КАМПУС», ИНН 7813675309. erid: 2SDnjbw1trg
Следующая развилка — что делать с результатом. Одному человеку достаточно прочитать стенограмму в браузере, другому нужен документ для редактора, третьему — возможность уточнять отдельные фрагменты в диалоге. От этого зависит маршрут, даже если исходный файл у всех одинаковый.
🎧 Кэмп — попробуйте начать с короткого фрагмента: загрузите готовую запись и запустите создание транскрипта, чтобы затем сверить текст с оригиналом.
Какой вариант транскрибации выбрать для готового аудиофайла
Первые два маршрута различаются организацией работы: в одном запись становится материалом внутри платформы, в другом основной результат — скачиваемый транскрипт. Далее идут чат с аудиозагрузкой, локальная программа и обходной вариант через микрофон. Реклама. ООО «ПЛАТФОРМА МИКРОТЬЮТОРИНГА», ИНН 7813667410. erid: 2SDnjdG6v2g
|
Маршрут |
Что передаём |
Как забираем текст |
Главное условие |
|
Кэмп |
Готовый аудиофайл до 50 МБ |
Работаем с результатом в интерфейсе; для отдельного документа сохраняем текст вручную |
Для запуска обработки нужен вход |
|
A24Hub |
Файл до 100 МБ |
Скачиваем TXT, DOCX или PDF |
Бесплатно распознаются первые 10 минут |
|
ChatGPT |
Аудиофайл в режиме с поддержкой такой загрузки |
Получаем ответ в переписке и сохраняем текст |
Нужны подходящие подписка, интерфейс и режим |
|
Whisper локально |
Путь к файлу на компьютере |
Получаем локальный TXT |
Нужно установить программу и модель |
|
Google Документы |
Звук через микрофон |
Текст появляется в документе |
Готовый файл напрямую не загружается |
Пока выбираете, прослушайте начало и конец исходника. Убедитесь, что открыли нужную запись и она не оборвана. Для чужого интервью или рабочего разговора заранее проверьте, допустима ли передача файла внешнему сервису. Если нет — переходите к локальному способу.
1. Кэмп: загрузить запись и работать с её текстом
Этот сервис подходит, когда хочется бесплатно получить расшифровку в браузере без установки программ. В Кэмп входной точкой служит кнопка «Сделать транскрипт»: она открывает Кэмпик, агента для обработки материалов. Он создаёт транскрипцию и прикладывает саммари — краткое содержание записи.
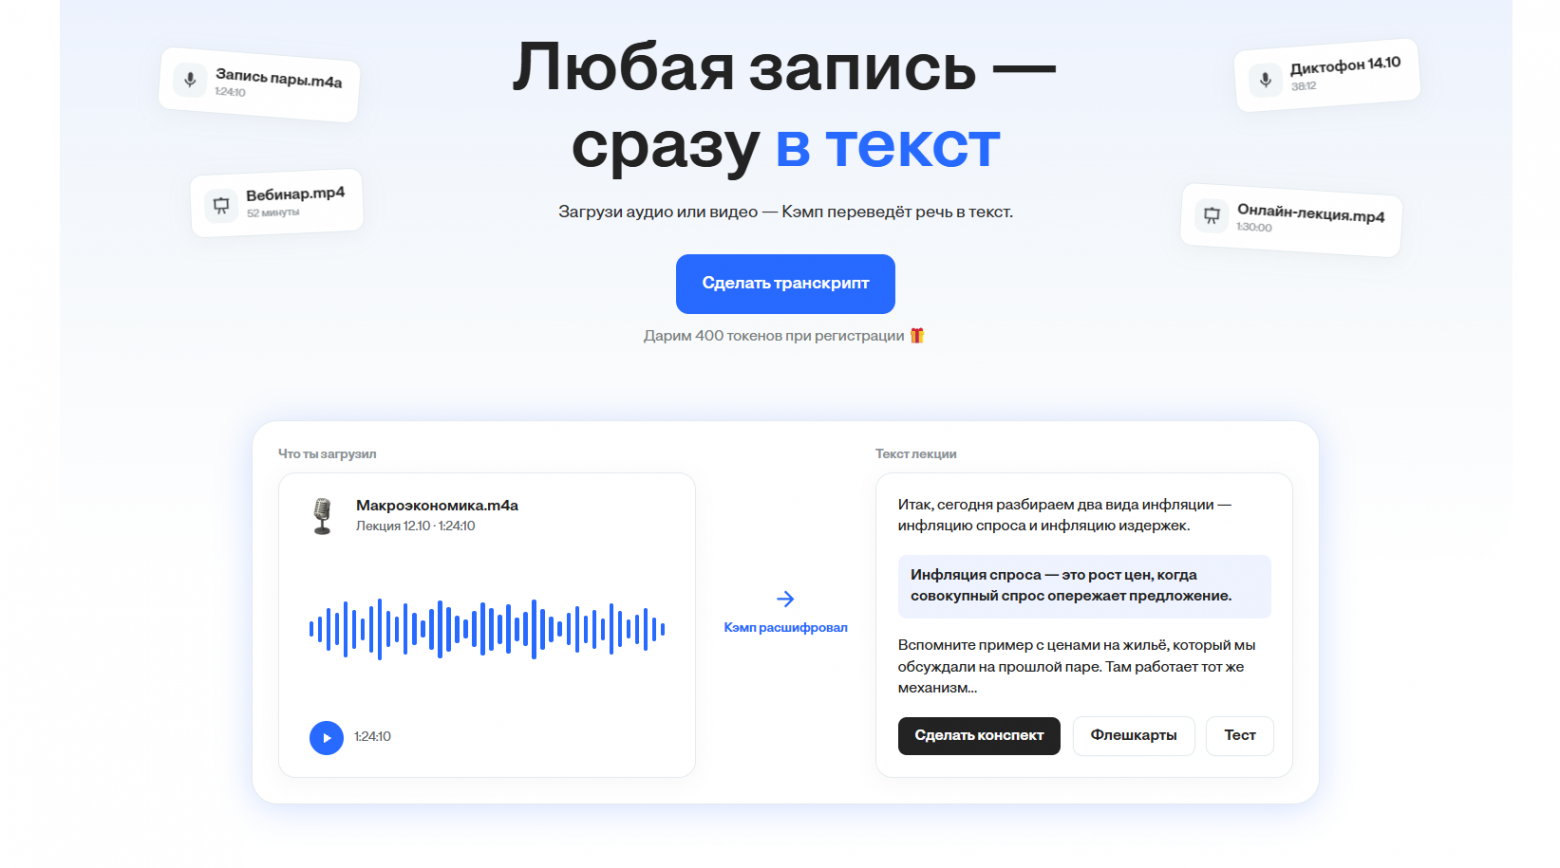
Для нашей задачи нужен именно полный текст. Саммари удобно для быстрой ориентации, но по нему нельзя восстановить все реплики или выбрать точную цитату.
-
Откройте страницу транскрибации и нажмите «Сделать транскрипт».
-
В области загрузки выберите готовый аудиофайл. Для первого запуска удобно взять MP3 на одну-две минуты; лимит загрузчика — до 50 МБ.
-
Убедитесь, что нужный файл появился среди выбранных источников и отмечен для обработки.
-
Нажмите «Сделать транскрипт». Если откроется экран авторизации, войдите в аккаунт, чтобы продолжить.
-
После обработки откройте транскрипт и сверяйте его с записью. Краткое содержание рассматривайте отдельно.
Не начинайте с большой папки записей. На коротком фрагменте проще проверить весь путь: принят ли файл, получился ли связный текст, сохранилась ли последняя реплика. Успешный выбор файла в загрузчике ещё не означает завершённое распознавание.
Нужен отдельный документ? Скопируйте доступный текст транскрипта в текстовый редактор и сохраните свою копию. Это ручное сохранение, а не обещание встроенного экспорта в DOCX или PDF. Если скачивание в определённом формате обязательно для рабочего процесса, следующий маршрут закрывает эту задачу напрямую.
Конспект, флешкарты и тест здесь можно оставить на потом. Для стенограммы критерий готовности другой: вы видите последовательность разговора, можете найти нужную фразу и сопоставить её с аудио.
2. A24Hub: получить бесплатную расшифровку отдельным файлом
«Мне нужен Word-документ, который можно отправить редактору». Для такого запроса удобен A24Hub: он принимает файл, распознаёт речь и позволяет скачать результат в DOCX, TXT или PDF.
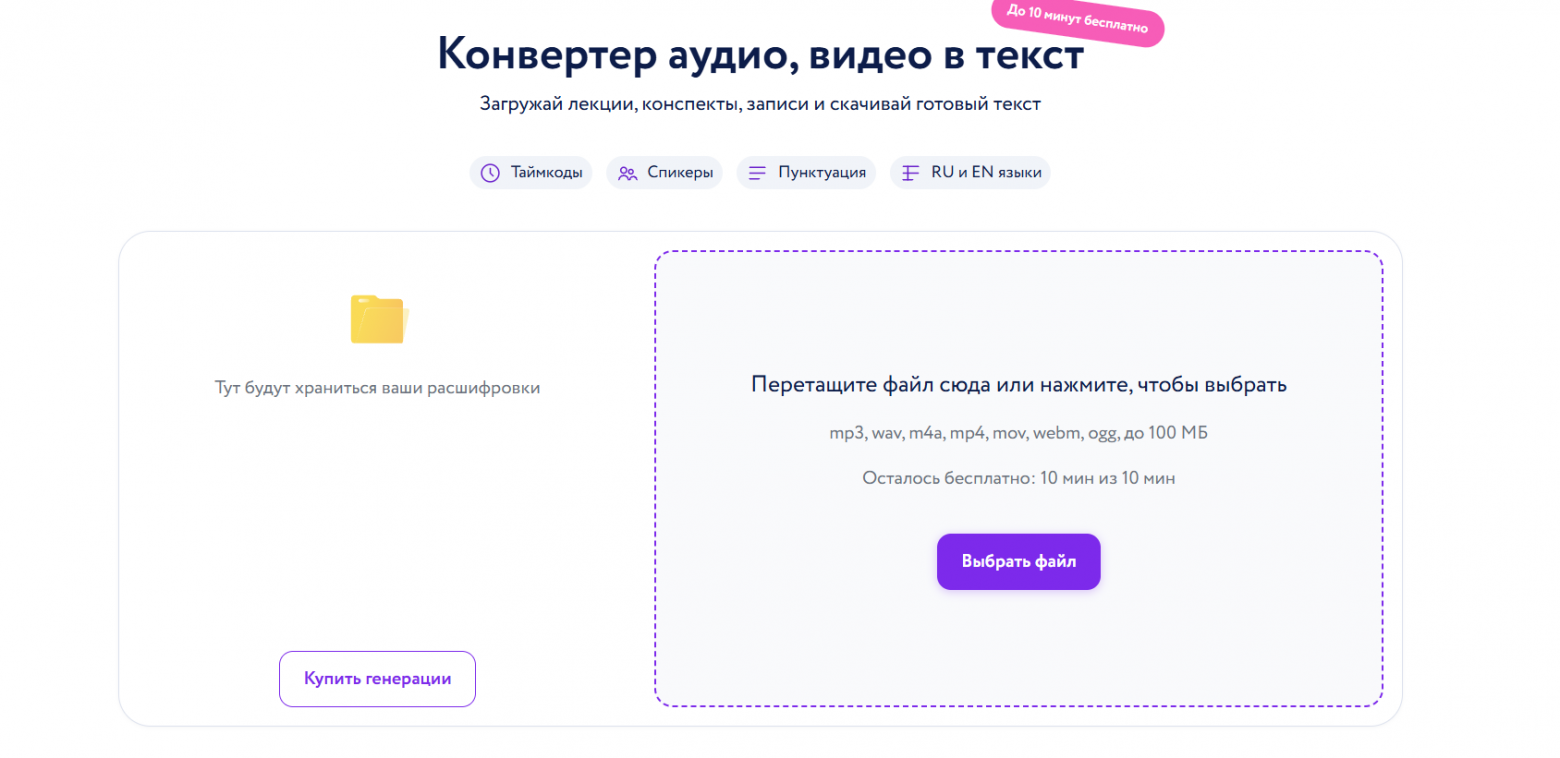
Поддерживаются MP3, WAV, M4A, MP4, MOV, WebM и OGG размером до 100 МБ. Для аудиозаписи достаточно исходного MP3, M4A или WAV — превращать её в видео не требуется. Распознавание работает с русским и английским языками.
-
Нажмите «Выбрать файл» или перетащите запись в область загрузки.
-
Проверьте доступный остаток бесплатных минут перед запуском.
-
Дождитесь обработки и просмотрите текст с временными отметками.
-
Для редактирования скачайте DOCX, для переноса текста между программами — TXT, для отправки готового документа — PDF.
Бесплатный лимит — первые 10 минут без регистрации. При превышении этого объёма бесплатная расшифровка обрезается. Файл может укладываться в 100 МБ и при этом быть слишком длинным для полного бесплатного результата: размер и продолжительность проверяются отдельно.
В транскрипте добавляются таймкоды и предпринимается попытка разделить участников на Speaker 1, Speaker 2 и далее. Эти обозначения помогают ориентироваться, но не устанавливают личности людей. На длинных записях нумерация может сбрасываться между частями. Перед заменой «Speaker 1» на фамилию прослушайте несколько его реплик.
Для интервью это существенная проверка: правильно распознанная фраза всё равно окажется ошибочной цитатой, если приписать её другому собеседнику.
Реклама. ООО «Диджитал Гениус», ИНН 7813681158. erid: 2SDnjdcs5TS
3. ChatGPT 6.1 Sol: от аудиофайла к отредактированной стенограмме
Этот маршрут удобен, если нужно не только расшифровать разговор, но и привести текст в порядок: расставить абзацы, оформить реплики, убрать речевой мусор. Работа состоит из двух этапов: распознавание аудио в поддерживаемом режиме ChatGPT, затем редактирование полученного текста через GPT-6.1 Sol.
Загрузка аудио доступна через ChatGPT в агрегаторе нейросетей с доступом из РФ. Для готовой записи подойдут MP3, WAV или M4A. Если файл не принимается, сначала получите расшифровку в транскрибаторе, затем передайте текст GPT-6.1 Sol.
-
Загрузите запись. Откройте режим ChatGPT с поддержкой аудиовложений и прикрепите файл. Для начала возьмите короткий фрагмент, чтобы проверить весь процесс.
-
Запросите полную расшифровку. Укажите язык и потребуйте сохранить последовательность реплик, числа, отрицания и самоисправления. Неразборчивые места попросите отмечать, без догадок.
-
Сохраните исходный транскрипт. Проверьте, что текст доходит до последней реплики записи, и оставьте отдельную копию перед редактированием.
-
Передайте текст GPT-6.1 Sol. Вставьте расшифровку или приложите её текстовым файлом в диалоге с выбранной моделью. На этом этапе модель работает с текстом: исправляет оформление и делает стенограмму удобнее для чтения.
-
Сверьте смысловые детали. Прослушайте фрагменты с фамилиями, суммами, датами и спорными формулировками. Редактирование не заменяет проверку по аудио.
Для обработки расшифровки через GPT-6.1 Sol используйте такой запрос:
Отредактируй стенограмму, сохранив содержание и порядок реплик. Расставь пунктуацию, раздели текст на абзацы. Убери только бессодержательные междометия и случайные повторы слов. Сохрани числа, отрицания, оговорки и исправления говорящих. Не объединяй реплики разных участников, не придумывай их имена. Метки [неразборчиво] оставь без изменений. Верни полный отредактированный текст без пересказа.
Например, фраза «пятнадцать… нет, пятьдесят тысяч» должна сохранить исправление суммы. Если заменить её на гладкое «пятьдесят тысяч», исчезнет часть разговора. Для читаемой стенограммы допустимо улучшать оформление, но решения о сокращении содержания лучше принимать отдельно.
4. Whisper локально: распознать речь без загрузки записи в облако
Если файл должен остаться на компьютере, подойдёт Whisper. Это открытая модель распознавания речи. После установки программы и скачивания весов модели обработку можно выполнять локально. Расплата за самостоятельность — настройка окружения и нагрузка на компьютер.
Понадобятся Python и FFmpeg. Установите FFmpeg для своей ОС, затем пакет распознавания:
python -m pip install -U openai-whisper
Для русскоязычного файла запустите:
whisper «interview.mp3» —model small —language Russian —task transcribe —device cpu —fp16 False —output_format txt —output_dir «./transcripts»
Это воспроизводимый пример команды для обычного процессора. Замените имя файла своим. Параметр —language Russian задаёт русский язык, —task transcribe — расшифровку, а —output_dir — папку результата. После завершения появится interview.txt. Параметры доступны в командном интерфейсе Whisper.
Для расшифровки аудио на русском выбирайте многоязычную модель: суффикс .en обозначает английскую версию. Скорость зависит от оборудования и выбранной модели; фиксированного времени обработки здесь нет.
Локальный TXT удобно проверить и отредактировать вручную. Если затем отправить его в облачный чат, содержание записи покинет компьютер уже в текстовом виде — учитывайте это при выборе маршрута.
5. Google Документы: запасной путь через голосовой ввод
В Google Документах есть голосовой ввод, но он слушает микрофон в реальном времени. Загрузить MP3 и получить стенограмму через эту функцию нельзя.
Для готовой записи остаётся обходной сценарий: воспроизводить её рядом с микрофоном. Он годится для короткого, разборчивого фрагмента, когда прямое распознавание речи из файла недоступно.
-
Откройте документ в поддерживаемом браузере, например Chrome.
-
Выберите «Инструменты» → «Голосовой ввод», установите русский язык.
-
Включите микрофон и воспроизведите короткий участок записи через динамик.
-
Остановите ввод и сопоставьте появившийся текст с исходником.
Здесь появляется дополнительный звуковой путь: динамик, помещение, микрофон. Эхо, посторонние разговоры и тихий голос могут ухудшить результат. Запись придётся проигрывать, поэтому для длинного интервью этот способ неудобен.
Если текст не появляется, проверьте разрешение браузера на микрофон и выбранное устройство ввода. Звук в наушниках сам по себе не поступает в микрофон. Для полноценной стенограммы лучше вернуться к одному из способов прямой обработки файла.
Проверка на 90 секундах: фамилия, число и исправление
Чтобы понять, справляется ли Кэмп транскрибации со сложными диалогами без смысловых потерь, мы протестировали его на плотном рабочем фрагменте. Для стресс-теста взяли полутораминутный диалог двух участников с перебиваниями, цифрами, профессиональной лексикой и оперативным исправлением данных прямо по ходу разговора. Все 1.5 минуты публиковать смысла нет, продемонстрирую короткий отрывок из аудиофайла:
Исходная аудиозапись (фрагмент 00:24–01:10)
Спикер 1: «Так, коллеги, двигаемся дальше. Смету подготовила Ольга Синицына. На оборудование заложили пятнадцать тысяч рублей, крайний срок согласования — до шестого ноября».
Спикер 2: «Погоди, уточню: не пятнадцать, а пятьдесят тысяч. И учтите, амортизация в эту сумму не входит».
Результат автоматической расшифровки сервисом
Спикер 1: «Так, коллеги, двигаемся дальше. Смету подготовила Ольга Синицына. На оборудование заложили 15 000 рублей, крайний срок согласования — до 6 ноября».
Спикер 2: «Погоди, уточню: не 15, а 50 000. И учтите, амортизация в эту сумму не входит».
Разбор контрольных точек
-
Имена собственные (Синицына): Распознано без искажений. Алгоритм не подменил фамилию на созвучные («Синицина», «Куницына») и корректно оформил заглавную букву.
-
Числительные и исправление контекста (15 000 → 50 000): Сервис перевёл устную речь в арабские цифры и сохранил обе реплики. В стенограмме осталась исходная ошибка спикера и последующая правка, что критично для протоколов разногласий.
-
Отрицание («не входит»): Частица «не» не проглочена. В юридических и финансовых стенограммах потеря одного отрицания полностью переворачивает суть договоренности.
-
Терминология («амортизация»): Термин распознан точно, без фонетических галлюцинаций («моторизация», «аккредитация»).
-
Разметка диалога (диаризация): Сервис верно разделил дорожку по голосам: четко зафиксировано, кто назвал ошибочную сумму, а кто внес корректировку.
Если бы сервис выдал короткую выжимку вроде «Бюджет оборудования составляет 50 000 рублей», это сработало бы для краткого саммари, но провалило задачу стенограммы. Когда важна история согласования и ответственность сторон, любое скрытое сокращение — это прямая потеря данных.
При выборе инструмента не ограничивайтесь первыми секундами аудио: тестируйте участки из середины и финала записи, где темп речи обычно ускоряется, а спикеры чаще начинают говорить одновременно.
Файл не принимается, текст обрывается или его нечем открыть
Расширение подходит, а загрузка не проходит
Сначала проверьте размер и воспроизведение файла в обычном плеере. Затем сравните формат с поддерживаемыми в выбранном инструменте. Переименование recording.m4a в recording.mp3 не меняет устройство файла — для преобразования нужен аудиоредактор или конвертер.
Если запись превышает лимит, разделите её на части по паузам. Назовите их последовательно: interview_01, interview_02. Для каждой части запишите время начала в исходнике: локальный таймкод 00:30 во втором фрагменте не означает тридцатую секунду всего разговора.
В документе отсутствует конец разговора
Не просите нейросеть дописать недостающую часть по смыслу. Сначала проверьте, заканчивается ли сам аудиофайл нужной репликой. Затем посмотрите, не сработал ли лимит бесплатной длительности и все ли части были обработаны. Недостающий отрезок следует распознать из аудио.
Транскрипт есть, но кнопки скачивания нет
Сохраните текст вручную в UTF-8 TXT или вставьте его в документ Word. Это позволит продолжить работу без привязки к интерфейсу. Оставьте рядом оригинальную запись: после исправления пунктуации и разметки она всё ещё нужна для проверки цитат.
Удобно хранить три файла: исходное аудио, первоначальную расшифровку и отредактированную копию. Тогда можно исправлять читаемость, не теряя возможности выяснить, откуда появилась спорная фраза.
Итоговый выбор сервиса для транскрибации
Чтобы выбрать, как перевести аудио в текст, достаточно последовательно ответить на несколько вопросов:
-
Готовый файл можно передать внешнему сервису?
-
Да, нужен текст и дальнейшая работа с записью в браузере — начните с Кэмп и короткого фрагмента до 50 МБ.
-
Да, нужен скачиваемый DOCX, TXT или PDF — выбирайте A24Hub; заранее сопоставьте длительность с бесплатными 10 минутами.
-
Да, хотите уточнять результат в переписке — используйте ChatGPT при доступной аудиозагрузке.
-
Нет, запись должна остаться на компьютере — установите Whisper и сохраните локальный TXT.
-
-
Прямая обработка файла сейчас недоступна?
-
Фрагмент короткий и хорошо слышен — можно попробовать голосовой ввод Google Документов через микрофон.
-
Запись длинная, с тихими репликами или несколькими участниками — восстановите возможность загрузки либо используйте локальное распознавание.
-
Остановиться можно, когда сохранённый текст охватывает запись до конца, участники не перепутаны, а фамилии, суммы и отрицания сверены с оригиналом. Именно такой результат можно передавать редактору, использовать для поиска по разговору и брать за основу точных цитат.
ссылка на оригинал статьи https://habr.com/ru/articles/1104528/