Браузеры постепенно ограничивают использование сторонних cookies, а операционные системы дают пользователям больше возможностей контролировать отслеживание. В результате рекламным системам становится сложнее связывать действия одного человека между сайтами и устройствами.
Возникает логичный вопрос: как вообще возвращать человека, если мы не можем нормально его идентифицировать?
На самом деле не всё так драматично. Ретаргетинг не отменяется — меняются способы формирования аудиторий и работы с ними. У рекламодателей по-прежнему остаются собственные данные, CRM-сегменты, события на сайте и в приложениях. Плюс появляются алгоритмические модели, которые помогают находить заинтересованную аудиторию, даже если конкретного пользователя определить не получается.
На связи Андрей Луненко, руководитель продуктового маркетинга Яндекс Метрики. В этой статье разберёмся, что происходит с cookies, какие технологии и подходы помогают работать с аудиторией в новых условиях и что уже можно использовать. А заодно посмотрим, как выстроить работу с данными так, чтобы не зависеть от одного идентификатора.
Что случилось с привычным ретаргетингом
Раньше с ретаргетингом всё было просто: человек зашёл на сайт, посмотрел товар, ушёл — а потом увидел рекламу этого же продукта на другом сайте. Сторонние cookies помогали связать эти действия: система понимала, что пользователь уже был на сайте компании, и могла показать ему рекламу позже.
Схема классная, но рассчитывать на неё, как раньше, больше не получится. Часть браузеров блокирует «куки» по умолчанию, срок жизни некоторых идентификаторов ограничен, а пользователи получили больше возможностей управлять отслеживанием. В итоге аудитория, собранная на таких идентификаторах, становится неполной: часть пользователей система перестаёт узнавать.
И дело не только в cookies. Например, в мобильных приложениях пользователь может запретить отслеживание, а значит, рекламный идентификатор будет недоступен. В CRM тоже не всегда есть контакт, по которому можно уверенно сопоставить человека с рекламным профилем. Например, пользователь может указать временный или подменный email вместо настоящего.
Есть ещё один неприятный нюанс: даже свои данные сайт не всегда хранит вечно. Например, Safari может ограничивать срок жизни некоторых идентификаторов. Поэтому, если пользователь зайдёт сегодня, а вернётся через пару недель, при следующем визите он может определиться как новый посетитель, хотя раньше уже заходил на сайт.
Получается, привычная модель постепенно разваливается сразу с нескольких сторон. И здесь не очень помогает идея «давайте просто найдём замену cookies». Задача теперь другая: опираться на данные, которыми бизнес действительно управляет, правильно их собирать и передавать платформе, а идентификацию пользователя между разными устройствами оставлять на стороне самой рекламной системы.
На какие данные можно опираться вместо «кукис»
Если сторонние идентификаторы работают не во всех сценариях, логично опираться на данные, которые бизнес собирает сам. Это информация о поведении пользователей на сайте, оформленных заказах, обращениях, контактах клиентов, событиях в мобильном приложении.
Такие данные устойчивее сторонних: они принадлежат бизнесу и меньше зависят от политики браузеров и настроек приватности.
В первую очередь стоит привести в порядок три источника:
-
Актуальную и структурированную CRM-базу
-
Цели и события в веб-аналитике
-
События в мобильном приложении
|
Принцип № 1. Работа с ретаргетингом в 2026-м начинается не с настройки рекламной кампании, а с наведения порядка в данных. Если конверсии размечены неправильно, в CRM есть дубли или нужные события вообще не передаются, любая технология сверху будет работать недостаточно хорошо. |
При этом first-party data тоже не стоит считать универсальным решением. Например, браузеры могут ограничивать срок жизни идентификаторов, которые сайт сохраняет на устройстве пользователя. Контактные данные в CRM не всегда позволяют точно сопоставить человека с рекламным профилем, а сбор данных в приложениях зависит, в частности, от настроек приватности и согласий пользователей.
Ещё один способ сделать работу с собственными данными более устойчивой — перенести часть обработки событий с браузера на сервер. В классической схеме браузер отправляет события напрямую в аналитические и рекламные системы. При server-side tracking браузер сначала передаёт их серверу сайта, а уже оттуда события и параметры уходят в нужные системы, поэтому, например, блокировщики рекламы влияют на сбор данных заметно меньше.
Также сопоставлять действия пользователей помогает Advanced Matching в Яндекс Метрике. Технология использует данные, которые пользователь самостоятельно оставляет на сайте, например при регистрации или оформлении заказа. В хешированном виде они передаются в Метрику и помогают точнее идентифицировать пользователей даже в браузерах, которые ограничивают использование сторонних cookies.
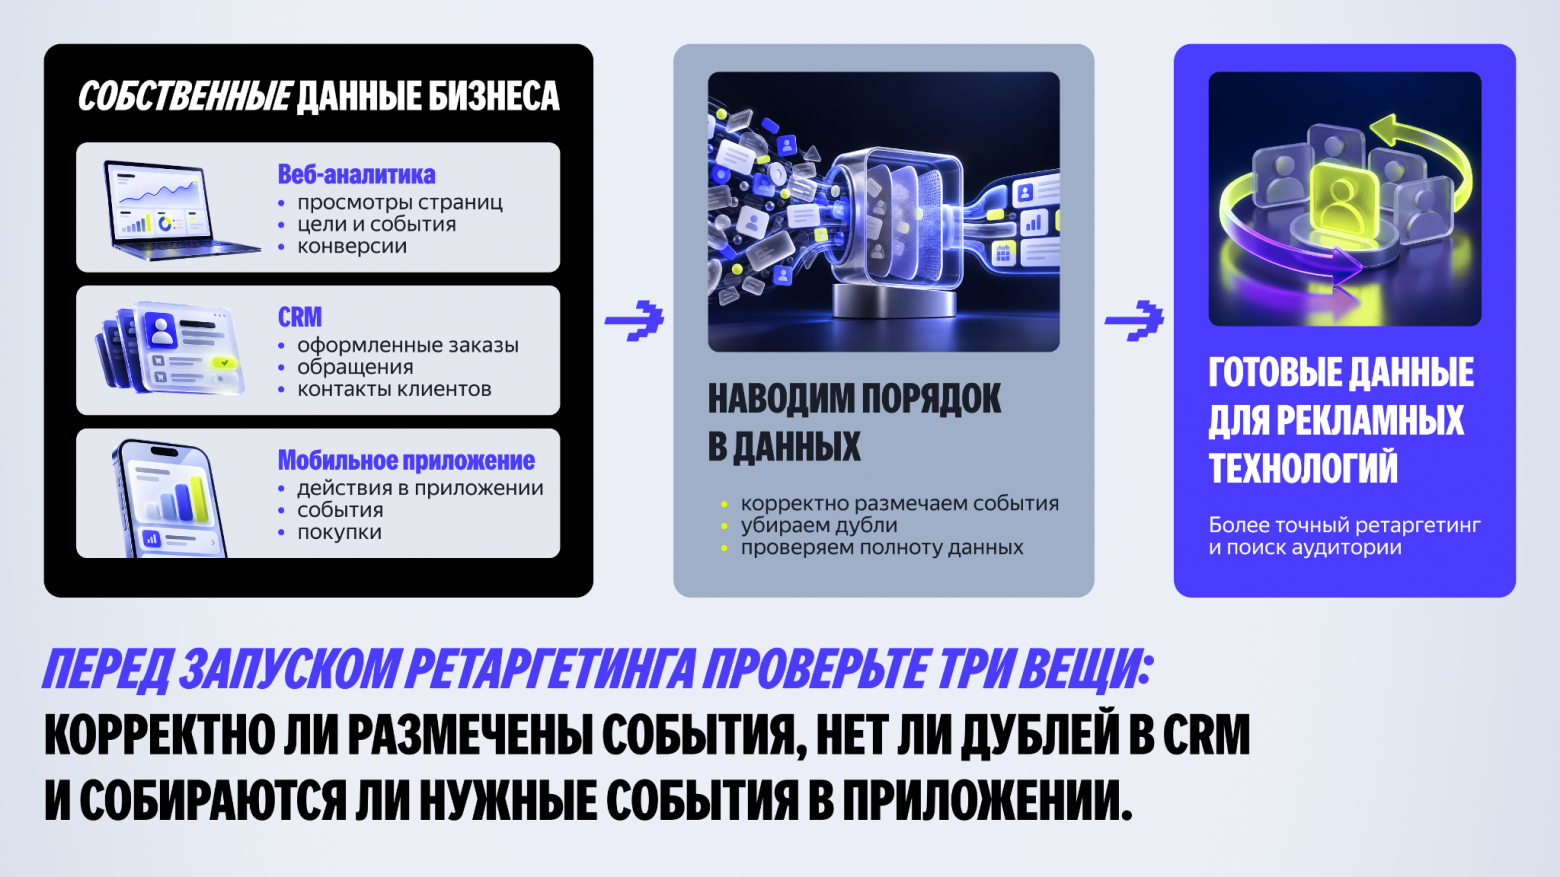
Так что перейти на собственные данные — это только половина дела. Важно ещё правильно организовать их сбор и передачу: связать идентификаторы, при необходимости использовать серверную передачу событий и следить за качеством данных в CRM.
Как собрать аудиторию из собственных данных
Когда данные бизнеса уже в порядке, из них можно собирать сегменты для ретаргетинга. Например, в Яндекс Аудиториях можно использовать контакты из CRM, посетителей сайта и их действия, данные из мобильного приложения, а также геолокацию.
Дальше всё зависит от задачи. Допустим, человек положил товар в корзину, но так и не купил. Можно собрать таких пользователей в отдельный сегмент и показать им рекламу. Ещё один вариант — вернуть клиентов, которые давно ничего не покупали.
Можно комбинировать сегменты и исключать из них отдельных пользователей. Например, показать рекламу тем, кто интересовался товаром, но не тем, кто уже его купил. Или, наоборот, использовать базу действующих клиентов, чтобы предложить им другой продукт.
|
Принцип № 2. Не стоит собирать одну огромную аудиторию. Лучше разделять пользователей по действиям. Тогда реклама получится точнее и понятнее для юзеров. |
Как ещё найти нужную аудиторию
С пользователями, которые уже заходили на сайт компании, разобрались. Но можно пойти дальше — взять тех, кто уже совершил нужное действие, и найти людей с похожим поведением. Для этого используют технологию look-alike.
Механика довольно простая. Допустим, у бизнеса есть сегмент покупателей. Система берёт его как образец и ищет пользователей, чьи поведенческие паттерны похожи на поведение этих клиентов. При этом ей не нужно искать того же человека по следам на чужих сайтах: сходство определяется по обезличенным профилям внутри экосистемы.
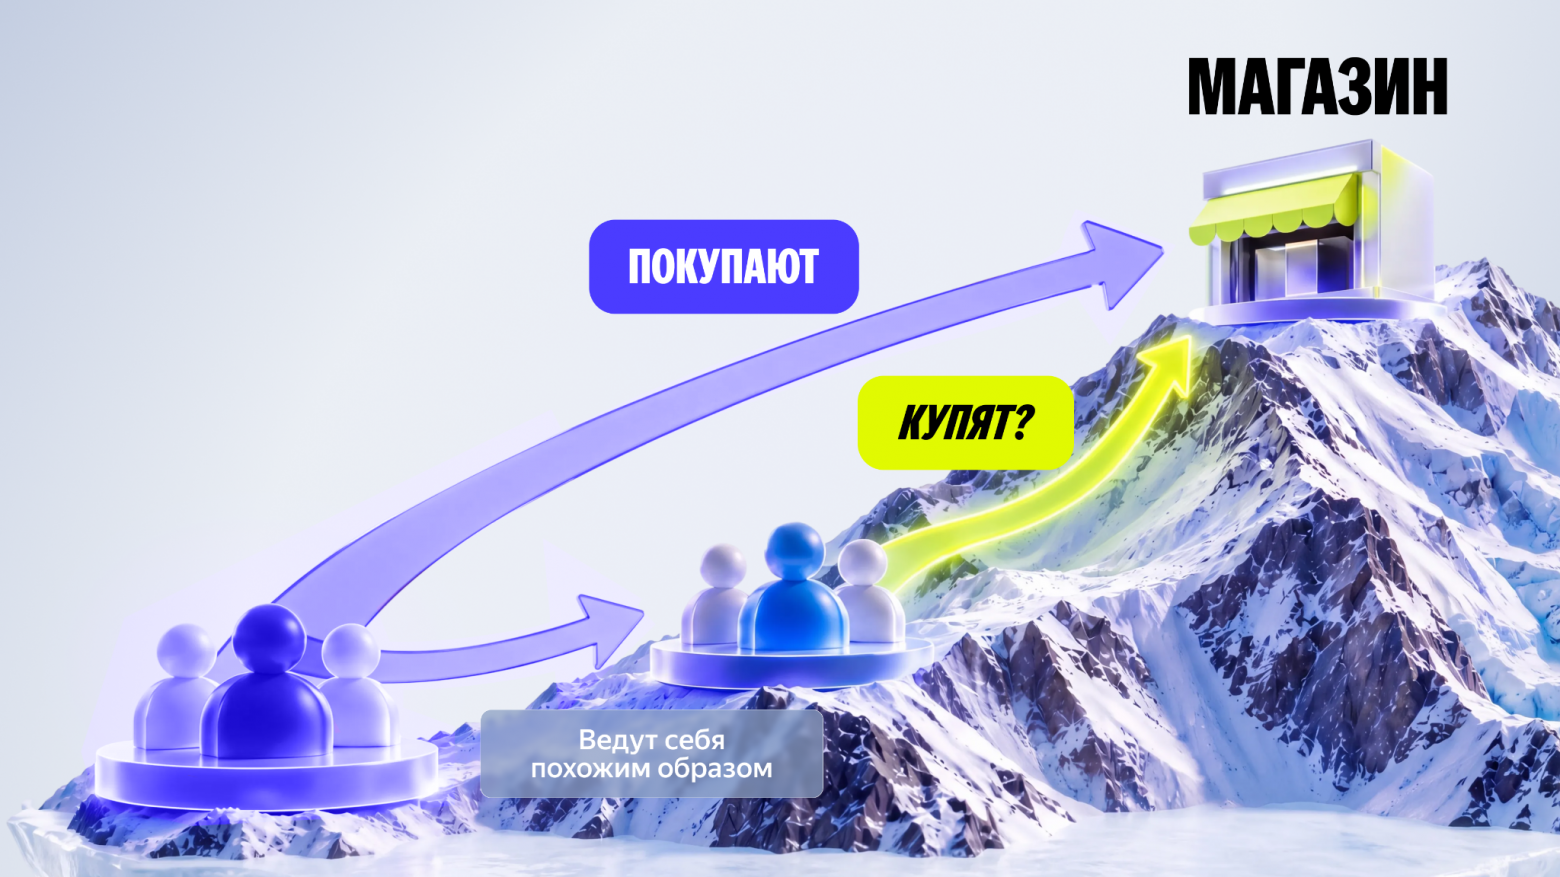
Но здесь есть важный нюанс: результат сильно зависит от того, кого берут за образец. Сегмент из всех посетителей сайта — не обязательно хороший вариант. Гораздо полезнее взять покупателей с высоким чеком или тех, кто возвращается и покупает снова. Так система получает более точный пример того, какие пользователи нужны бизнесу.
Например, ИЛЬ ДЕ БОТЭ разделил покупателей на восемь сегментов по сумме покупки — от менее 1 000 до более 10 000 рублей — и для каждого создал похожую аудиторию. Такие кампании принесли 30,5% дохода от размещения в Рекламной сети Яндекса (РСЯ), а средний чек оказался на 35% выше среднего по РСЯ.
С охватом тоже не стоит сразу выкручивать всё на максимум. Чем шире похожая аудитория, тем больше в ней людей, но тем ниже точность. Поэтому на старте логичнее взять более узкий сегмент и посмотреть, что из этого получится.
Поэтому look-alike нужен не столько для того, чтобы вернуть конкретного пользователя, сколько для того, чтобы расширить качественную аудиторию: берём за основу тех, кто уже покупал или проявлял интерес к продукту, и ищем пользователей, похожих на них.
Справка: как алгоритмы узнают пользователей без cookies. Для этого рекламные системы используют доступные им сигналы о поведении и об интересах пользователей. На их основе формируются обезличенные профили — наборы признаков, которые помогают оценивать сходство между пользователями. Например, какие страницы они смотрят, с какой рекламой взаимодействуют и какие действия совершают. На основе таких сигналов система может определить, что перед ней тот же или похожий пользователь, даже если привычный идентификатор браузера недоступен.
Здесь же работает технология кросс-девайс. Она позволяет связать действия человека на разных устройствах и собрать их в единый профиль. Допустим, пользователь утром посмотрел товар со смартфона, днём открыл сайт с рабочего компьютера, а вечером — с домашнего ноутбука. Система может определить, что за этими действиями стоит один человек, а не три разных посетителя.
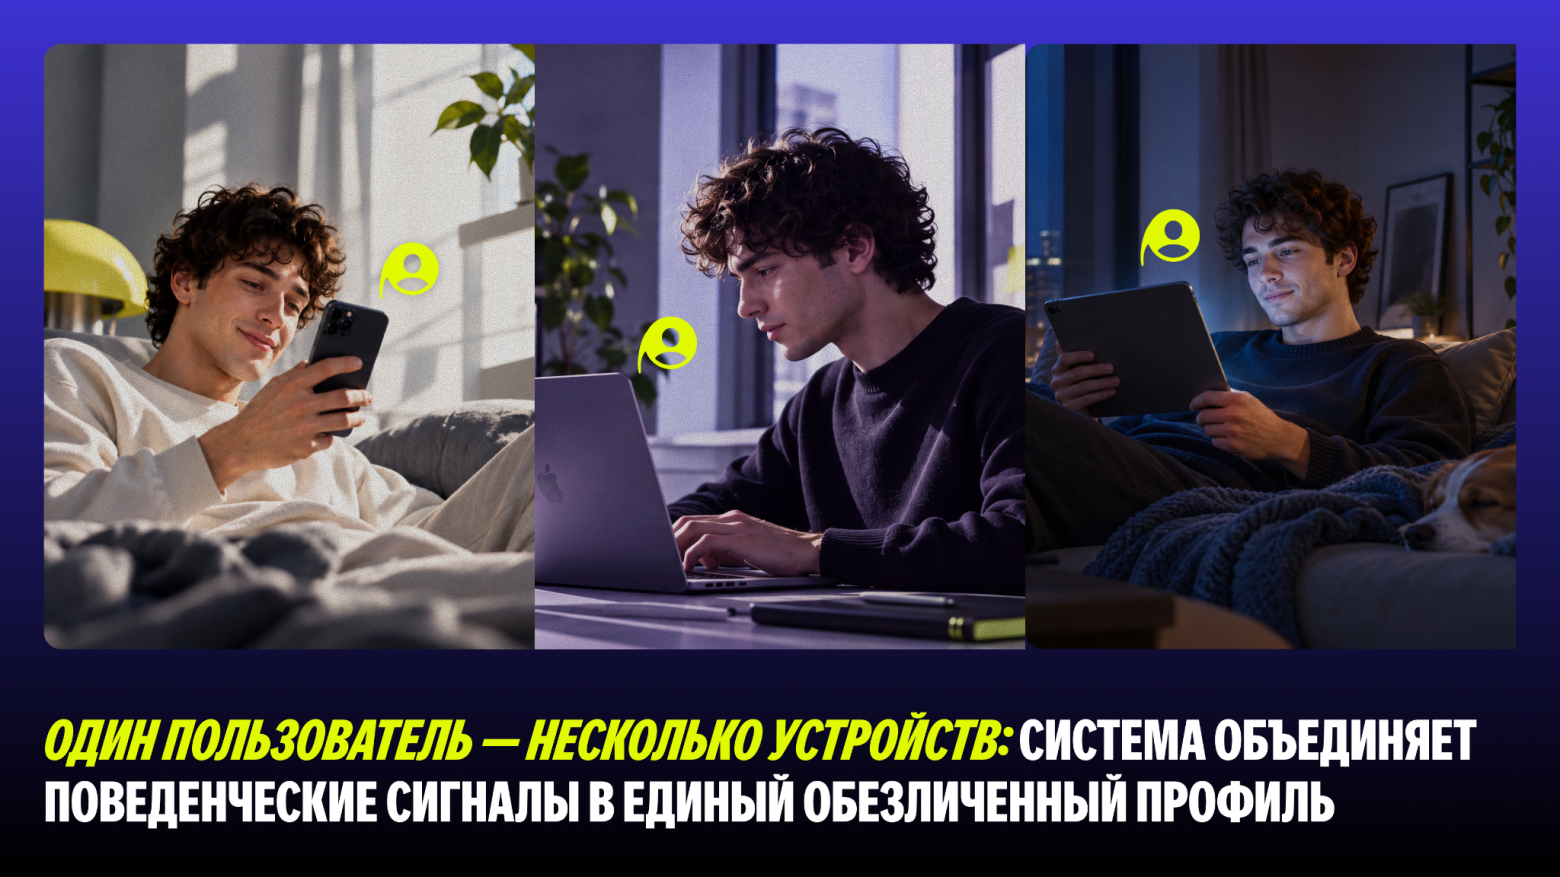
Это как раз то, чего сторонние cookies сами по себе делать не умели: они были привязаны к конкретному браузеру. Поэтому при смене устройства цепочка взаимодействий обрывалась. Кросс-девайс позволяет её сохранить: человек посмотрел товар с телефона в метро, а вечером может увидеть напоминание о нём уже на другом устройстве.
Как находить аудиторию, если пользователя не удаётся идентифицировать
В этом случае тоже не всё потеряно. Если пользователь не оставил идентификатор, запретил отслеживание или браузер не передаёт нужные данные, система может работать с вероятностью действия, а не с точным совпадением.
На этом принципе работают алгоритмические модели и автоматический подбор аудитории. Система анализирует доступные сигналы: действия на сайте, события в приложении, взаимодействие с рекламой, данные CRM, — а также контекст, например поисковый запрос или содержание страницы.
Допустим, человек читает статью о питании. По самому содержанию страницы можно предположить его текущий интерес, чтобы далее показать рекламу товаров, связанных с этой темой. Или пользователь ищет информацию о горных лыжах — тогда ему можно предложить экипировку. Здесь не обязательно знать, кто именно этот человек, — достаточно понять, что ему сейчас интересно и какое действие он с высокой вероятностью совершит.
Как подходы работают вместе
Представим ситуацию: человек зашёл в интернет-магазин, посмотрел диван и ушёл, ничего не купив. Дальше всё зависит от того, какие данные доступны системе.
Если система узнаёт посетителя, работает обычный ретаргетинг. Магазин собирает сегмент тех, кто смотрел диваны, но не оформил заказ, и показывает им рекламу. Покупателей из этого сегмента лучше исключить, иначе человек будет видеть диван, который уже стоит у него дома. Для этого пригодятся данные о заказах, в том числе офлайн-продажи из CRM.
Если узнать не получилось — например, браузер ограничил срок жизни идентификатора, — помогают собственные данные. Допустим, у магазина есть база покупателей мебели. На её основе можно создать сегмент и найти похожую аудиторию. Наш человек вполне может в неё попасть, даже если система не связала его с прошлым визитом.
А если он вообще не заходил на сайт, но прямо сейчас ищет «угловой диван в гостиную» или читает статью про обустройство квартиры, этого достаточно. Интерес виден по контексту, и реклама может показаться ему в нужный момент без всякого ретаргетинга.
Получается, ни один из этих подходов не решает все задачи сразу. Классический ретаргетинг помогает возвращать знакомых посетителей, look-alike — находить похожую аудиторию, а контекстный и алгоритмический подбор — охватывать потенциальных покупателей на основе их текущих интересов. Поэтому эти подходы могут дополнять друг друга.
Как перестроить ретаргетинг
Сначала лучше разобраться, какие данные уже есть у бизнеса и насколько они пригодны для работы. Это могут быть события на сайте и в приложении, CRM, данные об авторизованных пользователях, готовые сегменты.
При этом задача не в том, чтобы собрать как можно больше информации о пользователях. Важно понимать, какие данные действительно помогают выделять нужные сегменты, оценивать качество аудитории и принимать решения о рекламных кампаниях.
Затем можно постепенно тестировать новые способы работы с аудиторией, например look-alike. При этом не обязательно отказываться от привычного ретаргетинга: для большинства пользователей он по-прежнему будет работать.
На что обратить внимание при работе с аудиторией
Используйте собственные данные. Если у бизнеса есть CRM, события на сайте и данные приложения, было бы странно не оперировать ими.
Не ждите результата сразу: алгоритмам нужно время, чтобы обучиться, а новым сегментам — чтобы накопить статистику.
Не смотрите только на клики и краткосрочный CPA. Можно получить дешёвые конверсии, которые ничего не дают бизнесу. Поэтому лучше смотреть, что происходит с клиентом дальше: возвращается ли он, покупает ли снова и какой LTV.
Что будет с ретаргетингом дальше
Скорее всего, будет меняться сам подход к работе с аудиторией. Если раньше ретаргетинг в основном помогал вернуть тех, кто уже был на сайте, то теперь рекламные системы опираются на интересы пользователей и контекст их взаимодействия с контентом.
При этом сам ретаргетинг никуда не исчезает. Он становится частью более широкой работы с аудиторией, где собственные данные бизнеса, алгоритмы и разные способы идентификации дополняют друг друга.
Главная задача остаётся прежней: помочь рекламе найти своего пользователя и показать ему подходящее предложение в нужный момент.
Больше о современных подходах к рекламе, работе с данными и поиске целевой аудитории рассказываем в наших каналах в Telegram, во ВКонтакте и в MAX.
ссылка на оригинал статьи https://habr.com/ru/articles/1104554/