Всем привет!) Про топовые модели пишут много. Мне стало интересно другое: что будет, если отдать реальную задачу быстрой модели без громкого имени, а рассуждающую модель подключать только тогда, когда первая упирается не в синтаксис, а в поведение системы? Стек такой: VS Code (Cline), Particle-1 как кодер ( «руки»), GPT-6 Luna Pro как «мозг», Tilda (отдельная страница с формой), n8n , PostgreSQL 16, Docker.
Сам замысел что не в чате «напиши мне функцию…», а в роли кодера в VS Code через Cline: модель пишет SQL и JavaScript для нод n8n, получает текст ошибки, предлагает следующий патч и т.д. до рабочего результата.
Задачу взял из рабочего проекта: поиск по каталогу изделий. На вид вроде бы выглядит как «ввёл теги = получил карточки». Под поверхностью оказались массивы в PostgreSQL, особенности передачи данных между нодами n8n, перекошенный источник и SQL-инъекция, которую на финальном ревью нашёл уже я, а не LLM.
Сразу оговорюсь: это разбор одного рабочего кейса, а не A/B-бенчмарк. Модели выполняли разные роли и не решали одинаковый набор задач в контролируемых условиях. Поэтому я не пытаюсь доказать, что одна из них объективно «лучше». Мне было важно другое — как такое разделение ролей ощущается в реальной разработке с данными LLM и где всё равно нужен человек.
Что за продукт и почему в рантайме нет LLM
С разрешения заказчика поясню вкратце по проекту — сугубо для ясности. На странице Tilda, закрытой паролем, стоит внутренняя форма. Специалист отмечает сферы: деньги;любовь;здоровье;защита;гармония;энергия;карьера;уверенность;удача; семья; развитие.
Затем выбирает дизайн изделия: женский, мужской или универсальный. В ответ получает до пяти карточек: название, описание состава и теги.
Карточки берутся из таблицы PostgreSQL на 1684 записи. Это авторские «рецепты» изделий из камней: каждое изделие описано сочетанием минералов и свойств, указанных в исходном документе мастера. Например: «родонит — любовь, семья, нежность; солнечный камень — смелость, решительность». Сами свойства здесь являются содержимым авторского каталога, а не предметом технической проверки.
Инструмент не публичный. Он помогает специалисту за секунды получить памятку под запрос клиента вместо ручного поиска и набора текста.
Первой у меня была навязчивая мысль: поставить между формой и базой LLM, чтобы она «понимала запрос». Я отказался от этого по трём практическим причинам:
1. Задержка. Поиск по 1684 строкам не требует отдельного сетевого вызова модели.
2. Цена и вариативность. Модель добавляла бы расходы на каждый запрос и меняла бы поведение там, где правила поиска можно записать явно.
3. Источник истины. SQL возвращает конкретные записи из каталога. Модель могла бы добавить правдоподобное свойство или объяснение, которого в первоисточнике нет.
SQL не делает исходные описания истиннее и не проверяет их смысл. Он просто не добавляет поверх них новых сгенерированных утверждений. Поэтому в рантайме остаётся обычный запрос, а LLM работают только на этапе разработки.
Разделение роли между моделями
«Руки» —particle-1. Эта модель стояла в Cline и выполняла основной объём механической работы: писала SQL и JavaScript, меняла выражения, исправляла имена полей и кавычки, предлагала следующий вариант после ошибки.
«Мозг» —gpt-6-luna-pro. Его я подключал точечно: для разбора работы с массивами PostgreSQL, для смены рамки при ошибке с ответом webhook и для общего обсуждения итогового решения.
Практический цикл выглядел так:
1. Я давал модели контракт и текущий фрагмент.
2. Модель предлагала код или патч.
3. Я применял изменение и запускал workflow в n8n.
4. Текст ошибки, OUTPUT ноды или неправильный результат возвращался в следующий раунд.
5. Если проблема была синтаксической, продолжали «руки». Если требовалось пересмотреть саму диагностику, подключался «мозг».
Запуски, проверку фактического HTTP ответа и продуктовые решения я не перекладывал на модели.
Почему обратил внимание на задержку, а не только на прайс
На странице сравнения OpenRouter на момент моего замера были такие значения:
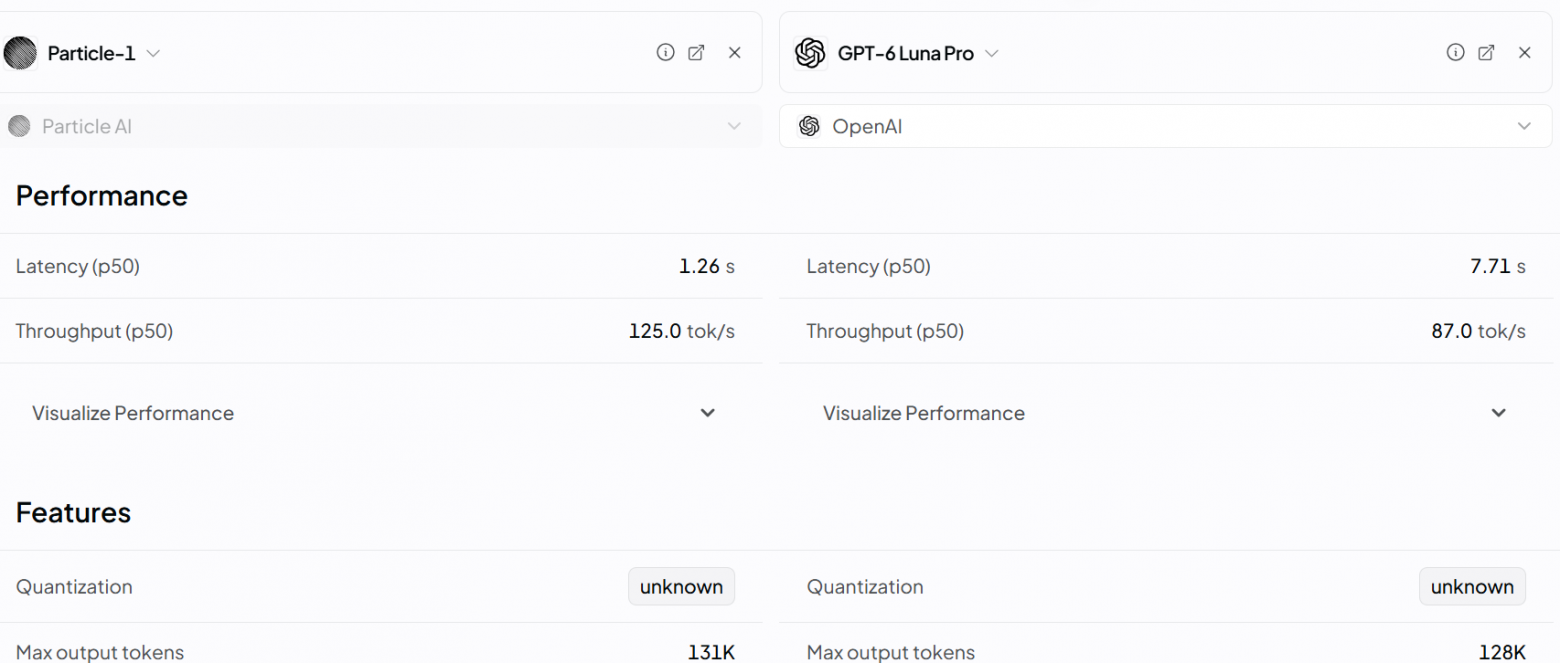
Это скрин конкретной страницы на конкретную дату, а не гарантированные характеристики моделей на будущее. Метрики OpenRouter зависят от провайдера, периода измерения и условий запросов. Кроме того, p50 на такой странице не равен длительности полного цикла Cline: в него ещё входят применение патча, вызовы инструментов, запуск воркфлоу и чтение результата.
Но как ориентир для выбора роли эта разница мне подошла. Когда агент делает серию коротких правок, мне важно быстро получить следующую итерацию. Более высокий throughput полезен при длинной генерации, но сам по себе не ускоряет начало ответа.
Субъективно если, Particle-1 позволяла вести механическую отладку в более комфортном ритме = меньше пауз между «получил ошибку» и «попробуй следующий вариант». Из этого кейса не следует, что полный агентный цикл у неё всегда в пять раз быстрее — такого измерения я не проводил.
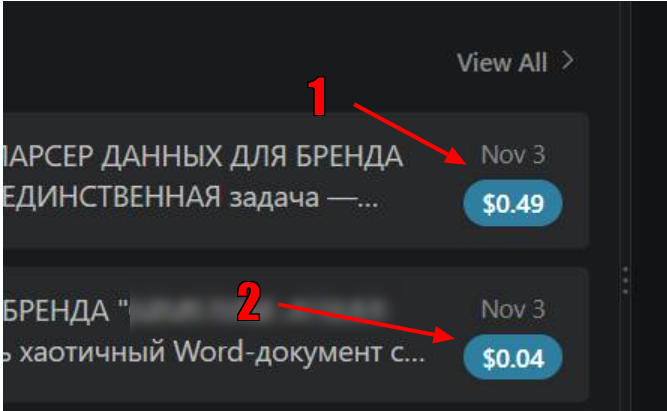
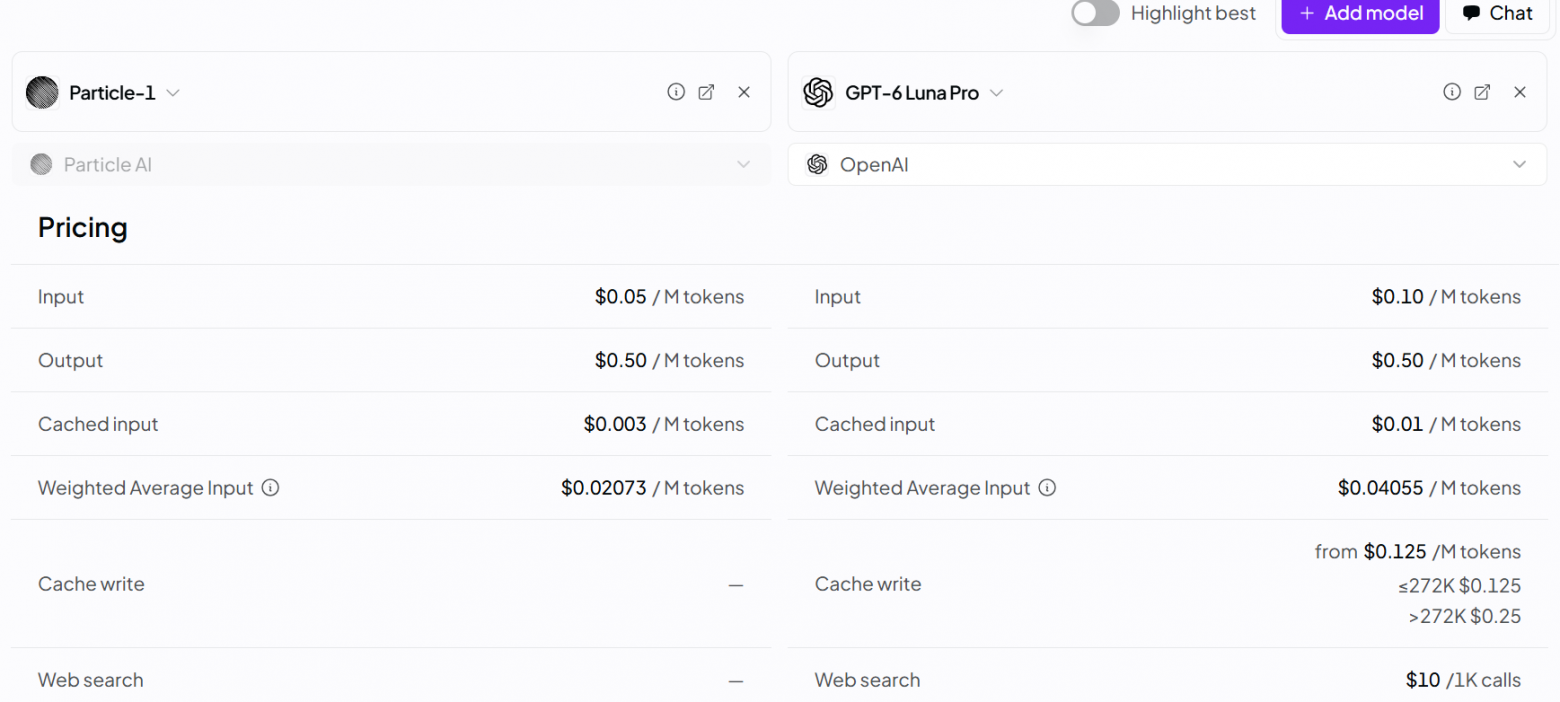
По деньгам картина тоже была скромной. Одна показанная на первом скриншоте сессия Particle-1 стоила 0,49 у.е.. Сессия с участием GPT-6 Luna Pro обошлась примерно в 0,04 у.е.. Но это были разные по объёму и назначению сессии, поэтому сравнивать их как стоимость решения одинаковой задачи нельзя. Общую стоимость всей разработки по этим двум числам я не вывожу.
Какое ТЗ получили «руки»
Задача формулировалась не как «напиши мне…», а как ограниченная спецификация:
-
вход: тело POST
{spheres, gender}; -
выход: до пяти строк
{id, name, full_recipe_text, tags}; -
отбирать записи по пересечению тегов;
-
сортировать по количеству совпадений;
-
при равенстве баллов ставить точное совпадение по полу выше универсального, затем предпочитать более узкий список тегов;
-
ограничить результат пятью записями;
-
не использовать LLM в рантайме;
-
не выдумывать колонки и не менять смысл существующих полей;
-
собирать запрос так, чтобы его приняла текущая связка n8n и PostgreSQL.
Модель собирала SQL и Code-ноду, а проверка каждого предположения происходила на реальном выполнении.
Что получилось в n8n
Весь контур поиска занял четыре ноды n8n:
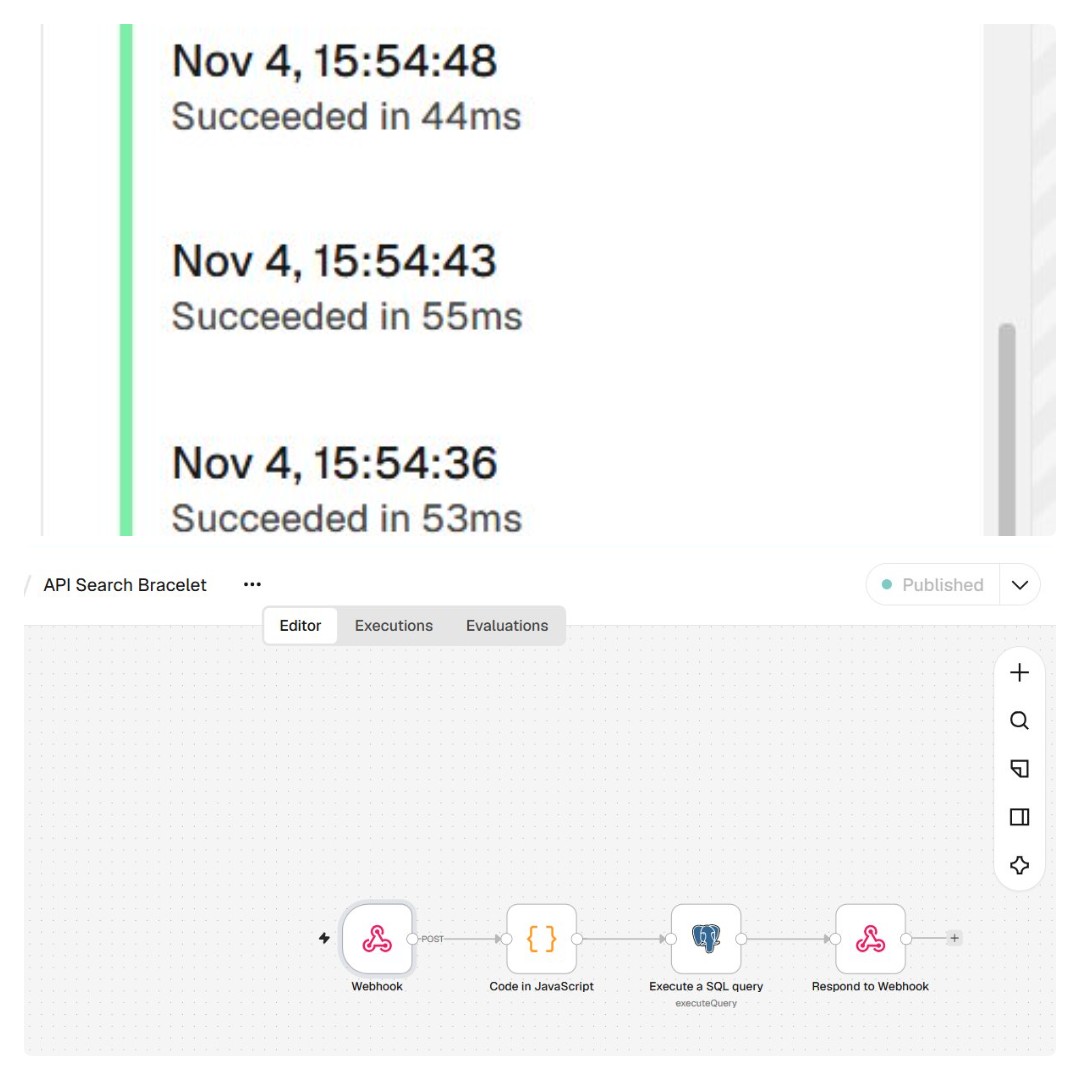
Дальше напишу про пять проблем в том порядке, в котором они проявлялись. Важно разделять их природу = одна относилась к SQL, две к границам между нодами, одна к данным, и только финальная была обнаружена прицельным security review.
Затык 1. operator does not exist: text[] & text[]
Для сортировки нужно было посчитать количество общих тегов. В первой версии модель поставила оператор & — внешне это выглядит как логичное «пересечение массивов». PostgreSQL такой оператор для text[] не поддерживает. Оператор && действительно проверяет пересечение массивов, но возвращает только boolean: есть ли хотя бы один общий элемент. Количество совпадений он не считает.
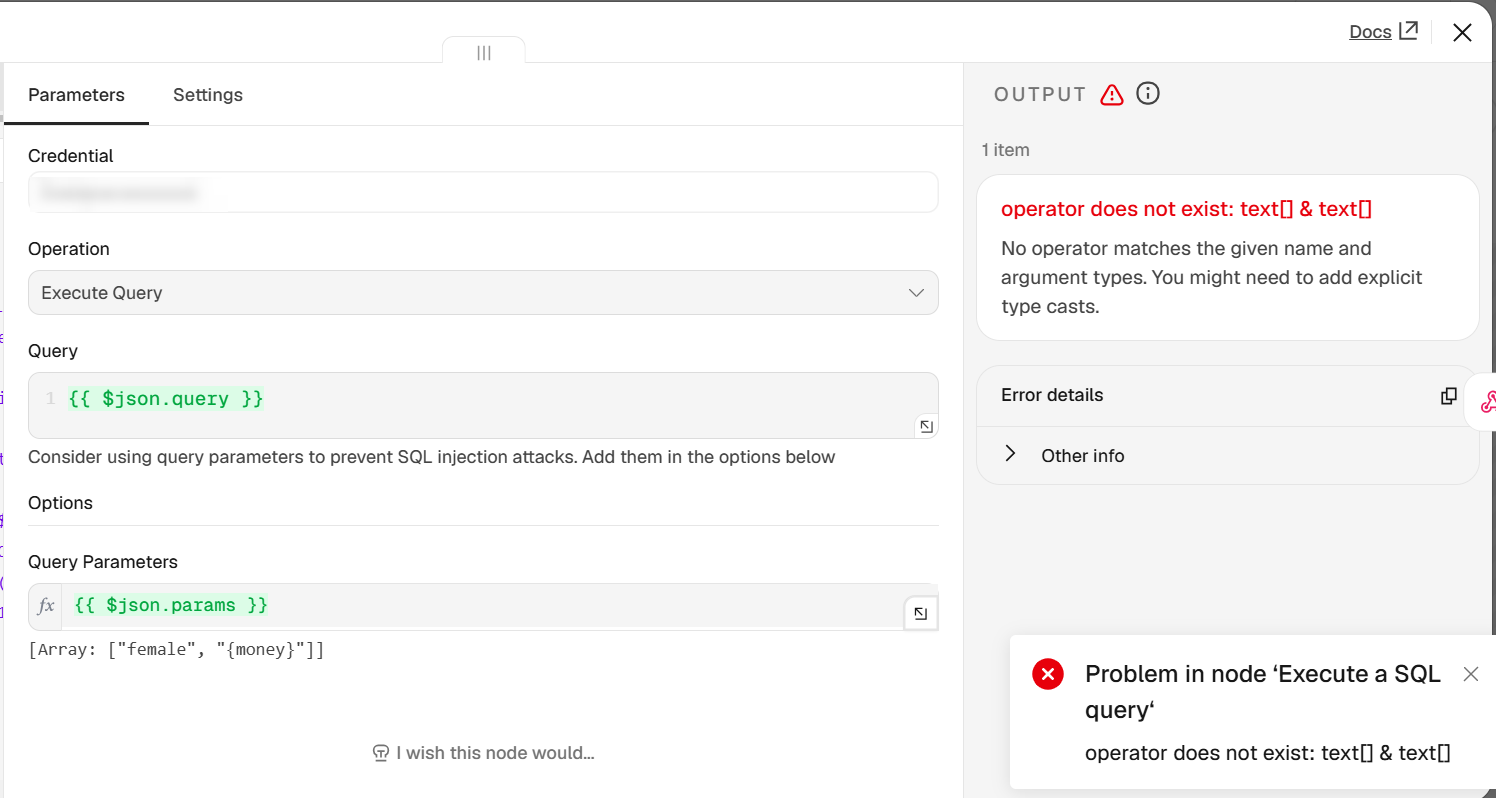
В итоге задачу разделил:&& отбирает кандидатов в WHERE; отдельный подзапрос разворачивает tags и считает совпадения.
```sql(SELECT count(*)::int FROM unnest(tags) AS tag(value) WHERE tag.value = ANY('{"love","harmony"}'::text[])) AS match_score```
Это хороший пример границы быстрого слоя. «Руки» уверенно писали общую конструкцию SQL, но ошиблись в конкретном операторе для text[]. После чтения ошибки и смены схемы дальнейшие правки уже были механическими.
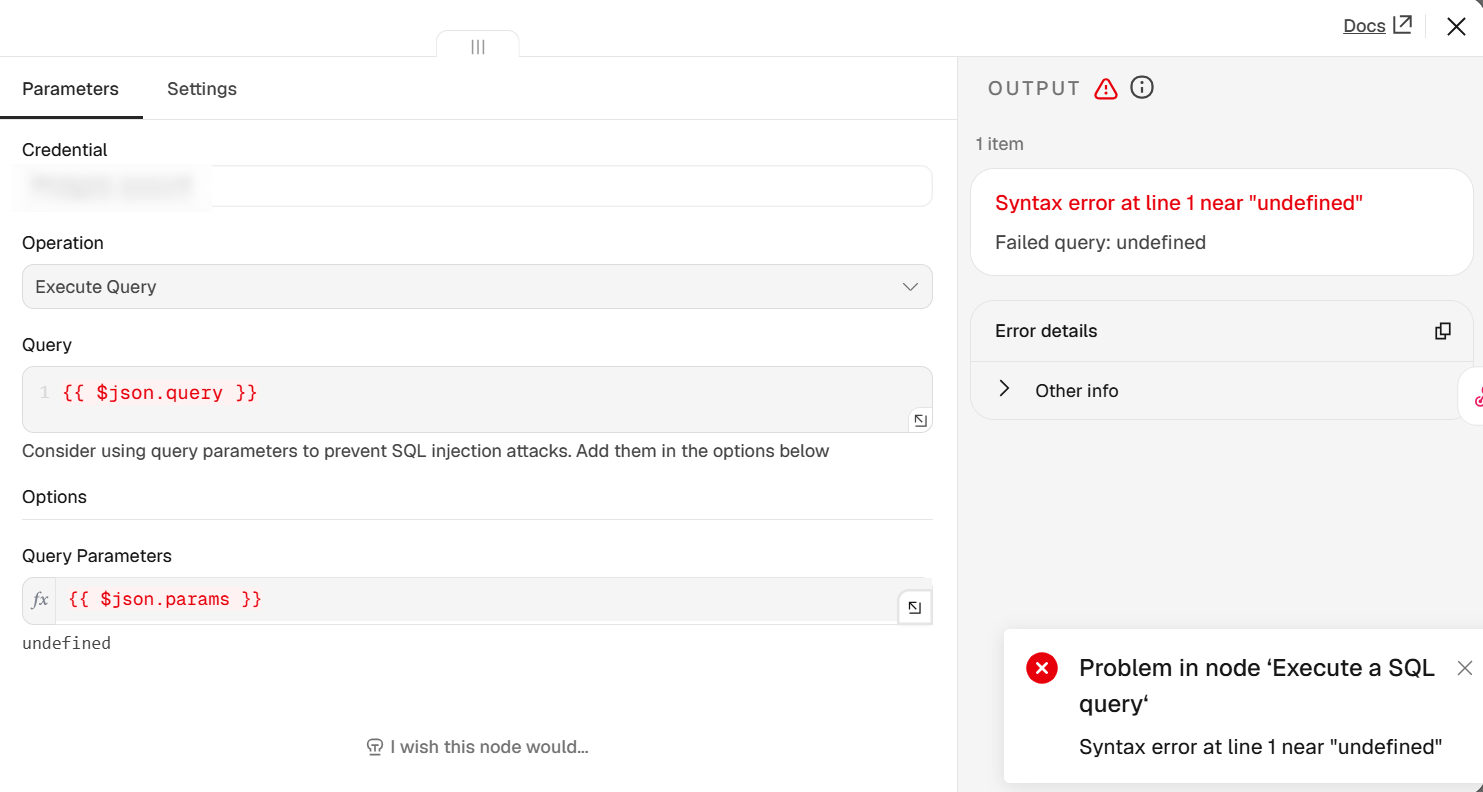
Затык 2. Syntax error near undefined
Следующая ошибка вообще не была ошибкой SQL по происхождению. Code-нода возвращала запрос в поле sql_query, а Postgres-нода пыталась прочитать другое имя. Выражение резолвилось в undefined, и дальше это значение попадало в текст запроса. Code-нода при этом отображалась успешной: она действительно сформировала item. Проблема проявлялась только на следующем шаге.
Здесь модель смотрела на собственный код, но не проверила фактический контракт на входе соседней ноды. После этого я изменил правило отладки: сверять не только красивое выражение в Parameters, а реальный OUTPUT предыдущей ноды и INPUT следующей. Зелёный статус одной ноды не подтверждает согласованность всего контура.
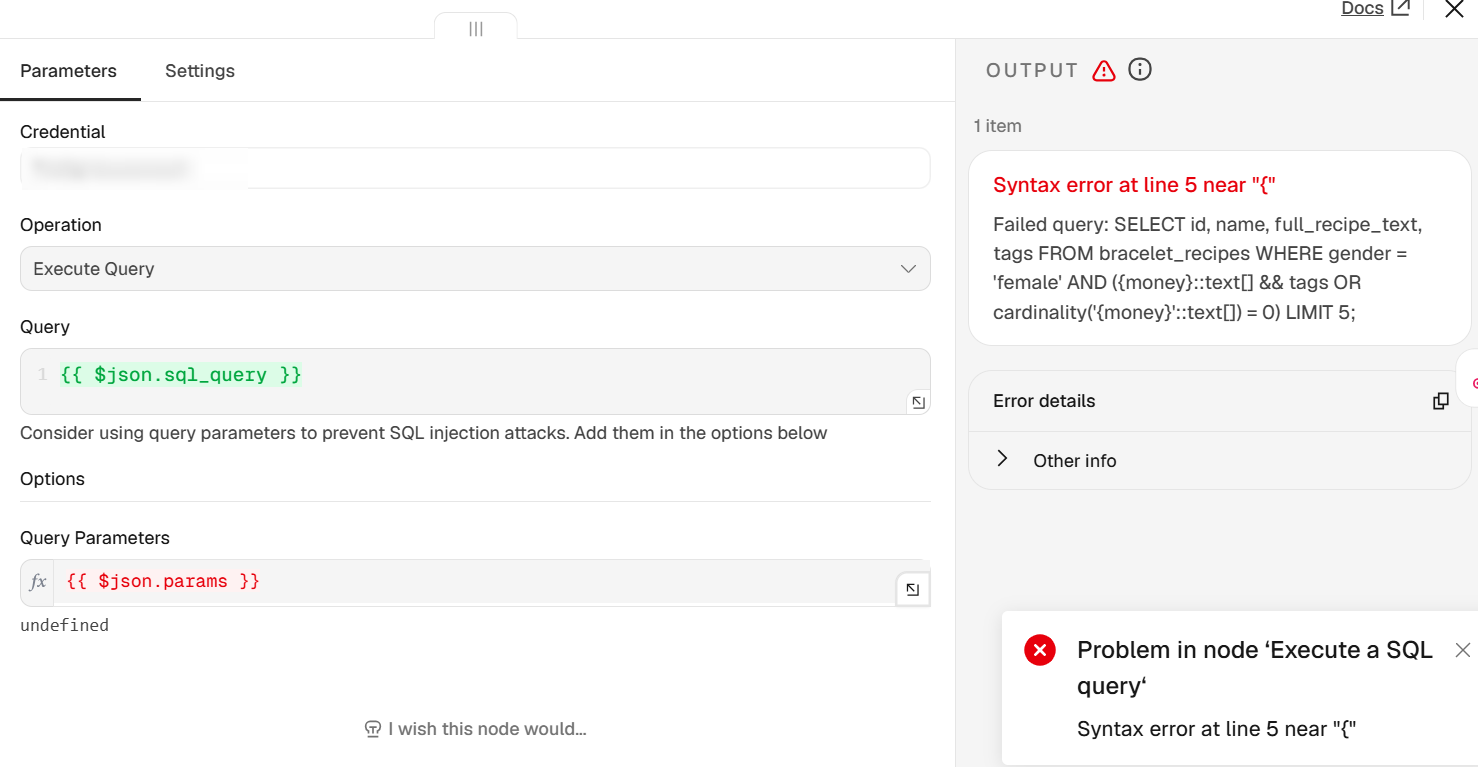
Затык 3. Syntax error near {
Литерал массива PostgreSQL в тексте SQL требует двух уровней синтаксиса:
```sql'{"money","love"}'::text[]```
Внутри находится представление массива с элементами в двойных кавычках. Снаружи — одинарные кавычки SQL строки. В первой версии модель потеряла внешний слой, и парсер упал около {. Отдельно я пробовал передать массив через Query Parameters и $1, $2. В моей конфигурации корректно передать text[] во время отладки не получилось, поэтому рабочий вариант остался на литерале внутри SQL. Честно оговорка: я не делаю из этого вывод, что n8n или PostgreSQL «не умеют параметризовать массивы». Документация n8n прямо описывает Query Parameters и prepared statements. Без отдельного минимального воспроизведения я не могу назвать причину своей неудачи: это могла быть конкретная форма выражения, сериализация или настройка ноды.
Поэтому показанную ниже сборку SQL следует воспринимать как обход конкретной проблемы, а не как предпочтительный универсальный паттерн. Для нового production-контура я бы сначала добился параметризованного запроса.
Затык 4. Пять строк в SQL, одна карточка на сайте
По моему это самый показательный случай. В OUTPUT Postgres-ноды было пять строк. Но в Respond to Webhook стояло выражение {{ $json }}, и сайт получал одну карточку.
Причина заключалась уже не в SQL. Согласно документации, n8n (https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.respondtowebhook/) прямо предупреждает: Respond to Webhook выполняется один раз, используя первый входной item. Поэтому пять строк на выходе Postgres ещё не означают массив из пяти элементов в HTTP-теле. Самый простой способ вернуть всё = выбрать:
```textRespond With → All Incoming Items```
В рабочем графе я также проверил явную сборку массива:
```javascript{{ $('Execute a SQL query').all().map(item => item.json) }}```
Но для новой версии нативный All Incoming Items понятнее: он не требует отдельного выражения и сразу показывает намерение.
Диагностику запутывал ещё один эффект. Сверху часто оказывалась широкая универсальная запись с восьмью тегами. Она законно набирала много совпадений, а обрезка ответа оставляла только её. На странице это выглядело типа как «SQL всегда возвращает одну и ту же карточку». На самом деле наложились две разные вещи:
1. ранжирование действительно поднимало широкую запись;
2. нода ответа отдавала наружу только первый элемент.
Быстрый слой продолжал чинить SQL. Полезный сдвиг рамки заключался в другом: нужно было проверить не только результат запроса, но и преобразование items в HTTP-ответ.
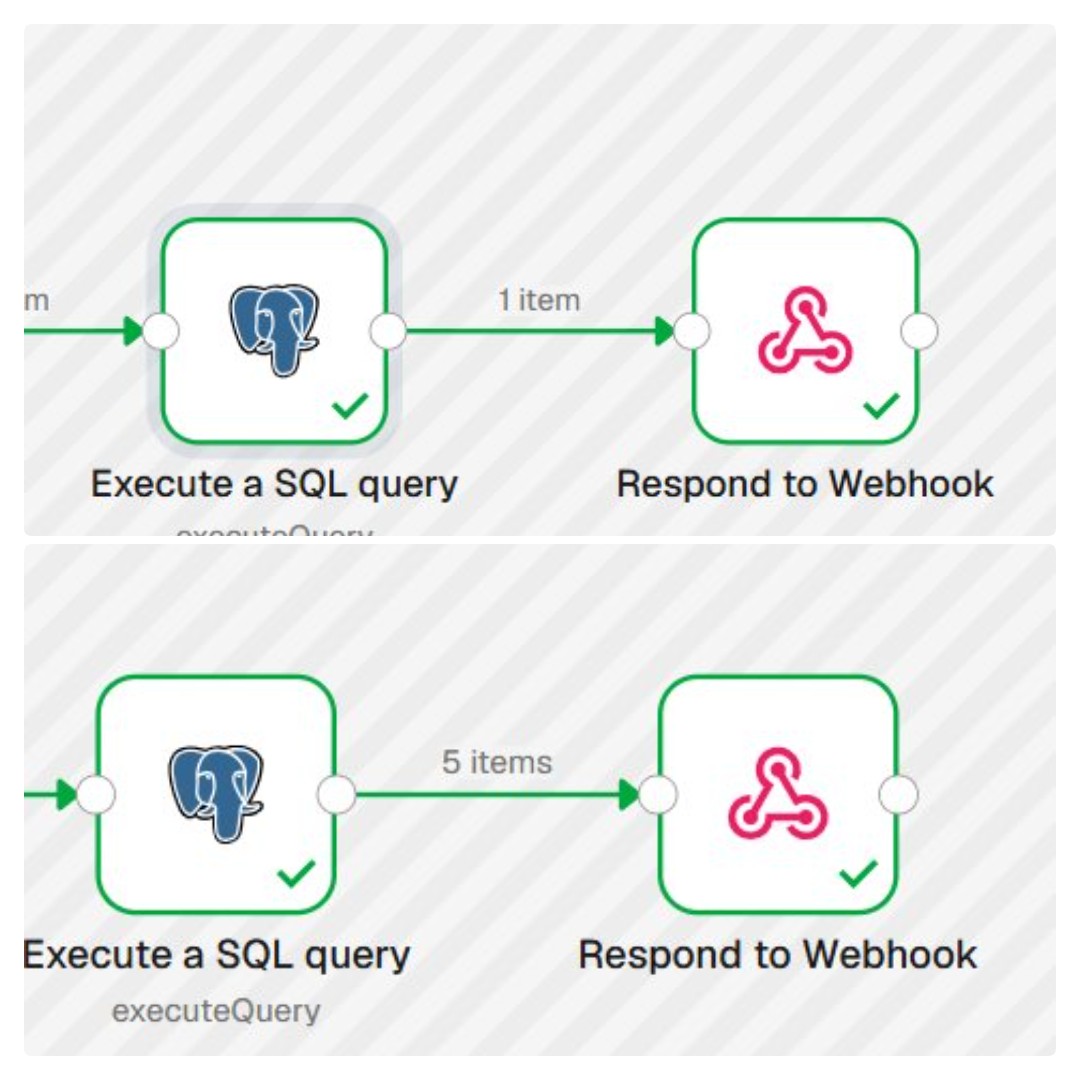
Затык 5. female = 1 из 1684
При подборе сферы женский вернулась одна запись. Первая реакция моя = сломался фильтр. Но запрос работал честно. Прежде чем переписывать код, я выполнил:
```sqlSELECT gender, COUNT(*) AS cntFROM bracelet_recipesGROUP BY genderORDER BY cnt DESC;```
И в итоге получил так:
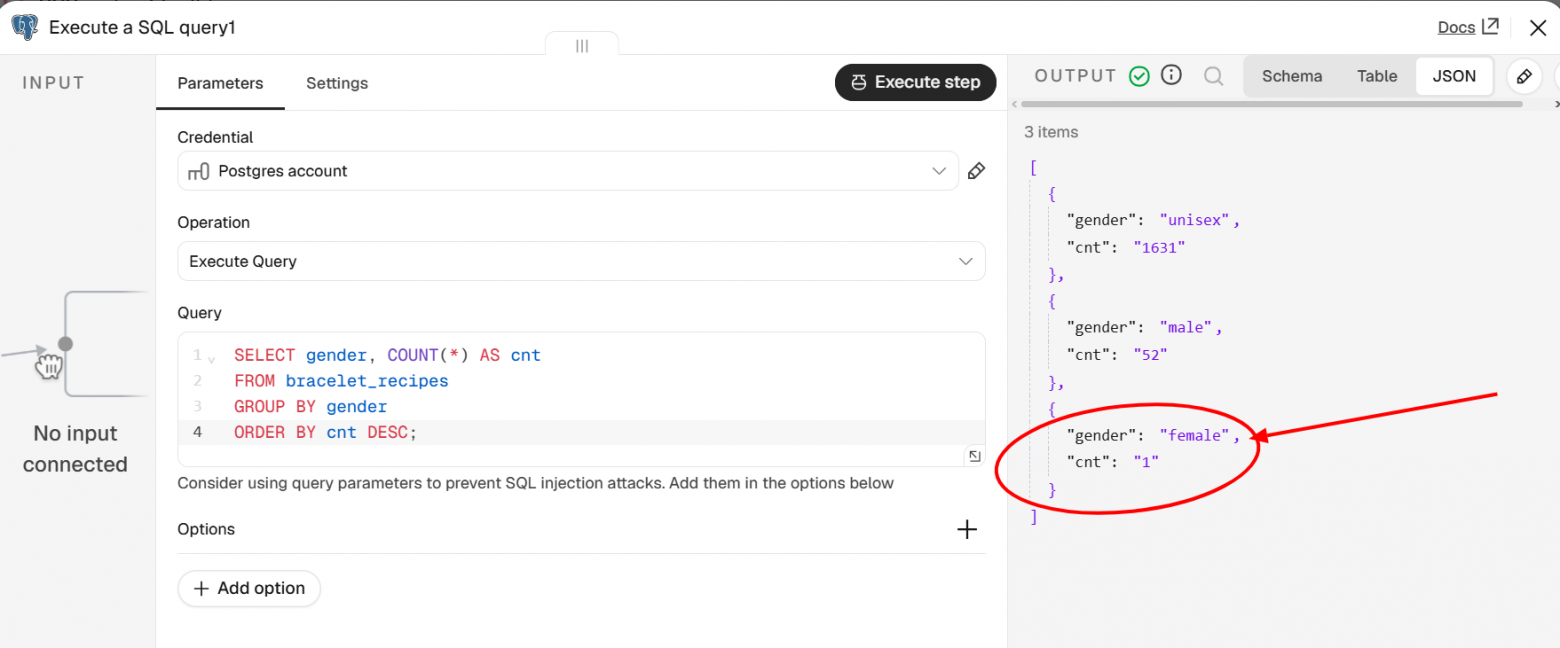
Проблема находилась в распределении исходных данных. Почти всё попало в unisex, а женской оказалась ровно одна запись.
Переписывать 1684 строки внутри алгоритма поиска не имело смысла — как минимум это не задача рантайма. Вместо борьбы с разметкой я зафиксировал продуктовое правило:
-
женский запрос допускает
femaleиunisex; -
мужской —
maleиunisex; -
универсальный — все три значения;
-
при равенстве остальных условий точное совпадение по полу идёт выше универсального варианта.
В принципе, LLM могла бы написать GROUP BY или помочь записать эти правила в SQL. Но она не могла сама решить, является ли распределение ошибкой импорта и какое поведение приемлемо для продукта. Для этого нужны фактическая выборка и решение владельца каталога.
Итоговое ранжирование
После исправлений Code-нода собирала запрос следующего вида. Значения подставлены для примера:
sqlWITH matched AS ( SELECT id, name, full_recipe_text, tags, gender, ( SELECT count(*)::int FROM unnest(tags) AS tag(value) WHERE tag.value = ANY('{"love","harmony"}'::text[]) ) AS match_score FROM bracelet_recipes WHERE gender = ANY('{"female","unisex"}'::text[]) AND ( '{"love","harmony"}'::text[] && tags OR cardinality('{"love","harmony"}'::text[]) = 0 ))SELECT id, name, full_recipe_text, tagsFROM matchedORDER BY match_score DESC, CASE WHEN gender = 'female' THEN 0 ELSE 1 END, cardinality(tags), random()LIMIT 5;```
Ключи сортировки работают так:
-
match_score DESC. Чем больше совпавших тегов, тем выше запись. -
CASE. При равном score выше идёт точное совпадение с запрошенным полом. -
cardinality(tags). Только при равенстве предыдущих ключей выше оказывается запись с меньшим списком тегов. -
random(). Перемешивает записи при полном равенстве предыдущих ключей.
Здесь важно не превысить обещания. cardinality(tags) не гарантирует, что широкий универсал никогда не окажется первым. Если у него выше match_score или приоритет по полу, он всё равно законно победит. Меньшее количество тегов — лишь прокси для узости карточки, применяемый на более позднем этапе сортировки.
Если продукту нужен жёсткий запрет на доминирование одной широкой записи, потребуется отдельное правило разнообразия. Есть и ещё одна особенность: пустой spheres отключает фильтр по тегам через cardinality(...) = 0. В таком случае поиск фактически работает только по полу и правилам сортировки. Для внутреннего инструмента это было допустимым поведением. Для публичного API я бы явно решил, что должно происходить при пустом или полностью невалидном списке: например, возвращать 400, а не молча расширять выдачу.
Наконец, из-за random() строго повторяемого порядка нет. Это осознанный способ немного разнообразить выдачу при равенстве оценок, а не детерминированный поиск.
Что нашёл на ревью: дыра, которую модели не подсветили
Я перепроверил код уже не с вопросом «почему он падает», а с вопросом «что будет, если его вызовут в обход формы». В версии до ревью экранировались обратный слеш и двойная кавычка, но не одинарная. При этом весь литерал массива оборачивался именно в одинарные кавычки SQL-строки.
Если передать произвольное значение с ', можно было сломать строку и изменить текст запроса. Это уже не косметическая проблема сериализации, а потенциальная SQL-инъекция. Набор чекбоксов в Tilda здесь ничего не защищает. Человек, получивший URL webhook, может отправить POST через curl с произвольным телом.
Пароль страницы тоже важно описывать точно:
-
он ограничивает доступ к HTML-странице Tilda;
-
он не авторизует отдельные запросы к n8n;
-
скрытость URL снижает вероятность его обнаружения, но не является контролем доступа;
CORS здесь ни при чём: это механизм браузерного чтения ответов, а не авторизация сервера. Ключ API, встроенный в клиентский JavaScript, тоже не решил бы проблему настоящей аутентификации — ведь тот, кто может загрузить страницу и прочитать её код, получит и ключ. Поэтому я не стал добавлять такой «декоративный слой».
Исправление самой инъекции потребовало двух серверных мер:
-
разрешить только фиксированные значения
spheresиgender; -
корректно экранировать оба уровня кавычек при построении литерала.
Заодно исправился CASE: раньше он всегда сравнивал пол с 'female', поэтому при мужском запросе male не получал преимущества перед unisex. Теперь сравнение идёт с фактически запрошенным значением.
Итоговый вариант Code-ноды после ревью:
const body = $input.first().json.body ?? $input.first().json;const ALLOWED_SPHERES = [ 'money', 'love', 'health', 'protection', 'harmony', 'energy', 'career', 'confidence', 'luck', 'family', 'development',];const ALLOWED_GENDERS = ['female', 'male', 'unisex'];const gender = ALLOWED_GENDERS.includes(body.gender) ? body.gender : 'unisex';const spheres = (Array.isArray(body.spheres) ? body.spheres : []) .filter((sphere) => ALLOWED_SPHERES.includes(sphere));const genderMap = { female: ['female', 'unisex'], male: ['male', 'unisex'], unisex: ['female', 'male', 'unisex'],};// Уровень PostgreSQL array: \ и "// Уровень SQL-строки: ' -> ''const pgArray = (items) => "'{" + items .map((item) => '"' + String(item) .replace(/\\/g, '\\\\') .replace(/"/g, '\\"') + '"' ) .join(',') .replace(/'/g, "''") + "}'::text[]";const sphereLiteral = pgArray(spheres);const genderLiteral = pgArray(genderMap[gender]);const sql_query = `WITH matched AS ( SELECT id, name, full_recipe_text, tags, gender, ( SELECT count(*)::int FROM unnest(tags) AS tag(value) WHERE tag.value = ANY(${sphereLiteral}) ) AS match_score FROM bracelet_recipes WHERE gender = ANY(${genderLiteral}) AND ( ${sphereLiteral} && tags OR cardinality(${sphereLiteral}) = 0 ))SELECT id, name, full_recipe_text, tagsFROM matchedORDER BY match_score DESC, CASE WHEN gender = '${gender}' THEN 0 ELSE 1 END, cardinality(tags), random()LIMIT 5;`;return [{ json: { sql_query } }];
Здесь главную защиту даёт allowlist: в SQL попадают только заранее перечисленные значения. Сам pgArray не стоит копировать как универсальный безопасный сериализатор для произвольного пользовательского ввода. Если параметризацию удаётся корректно настроить, prepared statements остаются предпочтительным решением.
Также важно разделить закрытые и оставшиеся риски:
-
allowlist и экранирование защищают запрос от инъекции через эти поля;
-
они не запрещают постороннему вызывать webhook, если он узнал URL;
-
для реальной авторизации нужен server-side proxy или другой проверяемый сервером механизм;
-
для публичного сценария дополнительно нужны rate limiting, ограничение размера запроса и желательно отдельная read-only роль PostgreSQL.
Смысл эпизода не в том, что якобы человек принципиально «умнее модели». Модель можно явно попросить провести threat model, и она может помочь. Но в этой сессии ни быстрый слой, ни общее ревью reasoning-модели не заметили проблему после того, как основные сценарии «позеленели». Финальную проверку пришлось провести отдельно.
Инфраструктура: Tilda снаружи, бэкенд в Docker
Tilda остаётся внешней CMS. Self-hosted бэкенд живёт на одном VPS: n8n 2.45.5; PostgreSQL 16-alpine; Redis 7-alpine для других сценариев проекта. Контейнеры объединены сетью n8n-redis-net. n8n обращается к базе по внутреннему имени gemstone-postgres; публиковать порт PostgreSQL на внешний интерфейс для этого не требуется. Для повторения схемы я бы сразу использовал named volume и restart policy:
docker network create n8n-redis-netdocker run -d \ --name gemstone-postgres \ --network n8n-redis-net \ --restart unless-stopped \ -e POSTGRES_PASSWORD="$POSTGRES_PASSWORD" \ -e POSTGRES_DB=gemstone_db \ -v gemstone_pgdata:/var/lib/postgresql/data \ postgres:16-alpine
Тут оговорочка — это не полный рабочий манифест: отдельно нужны резервное копирование, управление секретами, обновления и ограничение сетевого доступа. Сам по себе Docker ни одну из этих задач не решает. Redis в hot path поиска не участвует. Он нужен соседним мессенджерным воркфлоу для дебоунса, агрегации сообщений и хранения memoryKey. Подборщик карточек остаётся stateless.
Моё мнение итога оркестрации данных LLM
Что хорошо получилось у «рук». Particle-1 написала основной объём механического кода: SQL, JavaScript ноды, выражения и последовательные исправления. На коротких итерациях низкая задержка субъективно помогала сохранять темп.
Где быстрый слой застревал. На операторе для text[], на рассогласовании полей между нодами и на границе между SQL-результатом и HTTP-ответом. Это не один класс ошибок: первый случай относился к знанию PostgreSQL, остальные — к проверке фактического поведения системы.
Где помогал «мозг». Там, где требовалось пересмотреть саму диагностику: разделить overlap и подсчёт совпадений, перестать искать ошибку исключительно в SQL, обсудить итоговую структуру решения.
Что осталось на мне. Запуск и проверка workflow, чтение фактического HTTP-ответа, GROUP BY по данным, продуктовое правило для пола и финальный security review.
Что можно сказать про экономику. Отдельные сессии стоили центы или десятки центов, но они не были одинаковыми экспериментами. Поэтому я не превращаю их в вывод «одна модель в десять раз выгоднее». Практический результат другой: большую часть механических итераций удалось выполнить быстрой моделью, не вызывая reasoning-слой на каждую правку.
Главный вывод для меня оказался не «быстрая модель заменяет медленную». Скорее наоборот: быстрые итерации, редкая смена рамки и человеческая проверка результата решают разные задачи. Если перепутать эти роли, можно очень быстро получить работающий на счастливом пути код, и так же быстро пропустить проблему за его пределами.
Также могу сказать что если в дальнейшем буду применять такую связку данных моделей, то изменил бы и учитывал вот что:
-
сначала пытаться использовать параметризованные запросы;
-
для массива ответа по умолчанию выбирать
All Incoming Items; -
до исправления фильтров смотреть на распределение данных;
-
проверять контракт на входе и выходе каждой ноды;
-
после зелёных прогонов отдельно проводить security review;
-
не считать p50 со страницы провайдера измерением полного агентного цикла.
Всем спасибо за внимание, надеюсь мой разбор был полезен и интересен в прочтении.)
ссылка на оригинал статьи https://habr.com/ru/articles/1104662/