Сеньор-админ выбирает не между двумя модными названиями должностей. Он выбирает, какую инженерную задачу хочет решать дальше: автоматизировать поставку и эксплуатацию программных систем или строить их измеримую надежность. Вместе с Хабр Курсами постарались разобрать, чем эти задачи отличаются на уровне архитектуры, что требует рынок и как пройти путь за полгода.
Оглавление
Что на самом деле стоит за вопросом «DevOps или SRE»
Распространенная ошибка заключена уже в самой постановке. DevOps и SRE не конкурируют между собой и не образуют карьерную лестницу, где один уровень выше другого. Это разные ответы на разные вопросы.
DevOps отвечает, как сократить путь от изменения в коде до безопасного запуска этого изменения в рабочей среде. SRE отвечает, сколько отказов допустимо и как уложиться в этот бюджет.
На практике обязанности пересекаются. Один и тот же инженер может отвечать за инфраструктуру как код, автоматизацию развертывания, наблюдаемость и устранение аварий. Поэтому корректный вопрос для опытного администратора звучит иначе: какой набор компетенций даст максимальный карьерный прирост и позволит перейти от обслуживания инфраструктуры к проектированию платформ и надежности.
DevOps: не должность, а способ доставки изменений
Считать, что DevOps-инженер просто пишет сценарии автоматизации и настраивает Kubernetes, значит видеть только вершину айсберга. Задача шире: выстроить непрерывный цикл, в котором обратная связь из production возвращается в разработку.
Цикл выглядит так:
-
Разработчик: изменение кода, тесты, Git.
-
Сборка и проверка: CI, тестирование, анализ, сборка образа.
-
Доставка: CD, публикация артефакта, изменение конфигурации.
-
Рабочая среда: Kubernetes, виртуальные машины, облако, сеть, хранилища.
-
Обратная связь: метрики, журналы, трассировки, оповещения.
Технически этот цикл держится на нескольких понятиях. CI автоматически собирает и проверяет изменения при попадании в репозиторий. CD автоматизирует подготовку и выпуск. IaC описывает серверы, сети и права доступа в декларативном виде. GitOps управляет состоянием инфраструктуры и приложений через Git-репозитории.
Контейнеризация упаковывает приложение вместе с зависимостями в воспроизводимое окружение, оркестрация управляет жизненным циклом контейнеров.
Типичный стек включает Linux, Bash, Python или Go, Git, Docker, Kubernetes, Terraform, Ansible, GitLab CI/CD, Jenkins, Helm, Argo CD, Prometheus и Grafana.
Для сеньора-админа переход начинается не с очередного инструмента, а со смены подхода. Вместо ручного исправления конфигурации на десяти серверах появляется описание желаемого состояния и автоматическое приведение всех серверов к нему. Звучит просто. На деле именно здесь ломается большинство переходов, потому что привычка чинить руками никуда не исчезает.
SRE: надежность как инженерная величина
Site Reliability Engineering выросла из практики Google и начинается с отказа от удобной фразы «сервис работает, потому что мониторинг зеленый». Вместо нее появляются вопросы: какую доступность обещаем, как быстро система должна отвечать, сколько ошибок допустимо, какой объем отказов бизнес готов принять, когда пора остановить выпуск функций и заняться надежностью.
Ключевая идея в том, что надежность не абсолютное требование, а измеряемый компромисс между скоростью изменений и устойчивостью системы.
|
Понятие |
Что означает |
Пример |
|
SLA |
Договорный уровень обслуживания |
Доступность 99,9% |
|
SLI |
Измеряемый показатель обслуживания |
Доля успешных запросов |
|
SLO |
Целевое значение показателя |
99,9% успешных запросов за 30 дней |
|
Error Budget |
Допустимый бюджет ошибок |
0,1% неуспешных запросов |
При SLO 99,9% за 30 дней допустимое время недоступности при расчете по времени составляет около 43 минут 12 секунд. Но для пользовательского сервиса важнее не время простоя, а доля неуспешных запросов. Сервис может формально отвечать и быть при этом бесполезным из-за ошибок или задержки в пятнадцать секунд.
Отдельного внимания заслуживает Toil, то есть рутинная ручная работа. Ежедневные перезапуски служб, чистка дисков, проверка сертификатов и восстановление одинаковых ошибок не являются инженерной деятельностью. Это нагрузка, которую нужно автоматизировать или устранить на уровне архитектуры.
К остальным практикам относятся дежурства и реагирование на инциденты, анализ первопричин, разбор аварий без поиска виноватых, тестирование отказоустойчивости, контроль задержек и пропускной способности, управление запасом надежности через Error Budget. Первоисточники по теме доступны бесплатно: Site Reliability Engineering и The Site Reliability Workbook.
Где проходит граница между дисциплинами
|
Критерий |
DevOps |
SRE |
|
Основная задача |
Ускорить и автоматизировать поставку ПО |
Обеспечить измеримую надежность |
|
Основной результат |
Воспроизводимый процесс развертывания |
Выполнение целевых показателей |
|
Фокус |
Инфраструктура, доставка, взаимодействие команд |
Доступность, задержки, ошибки, инциденты |
|
Автоматизация |
Сборка, тестирование, развертывание, инфраструктура |
Реагирование, диагностика, восстановление |
|
Показатели |
Частота выпусков, время поставки, доля неудачных изменений |
SLI, SLO, бюджет ошибок, MTTR |
|
Работа с отказами |
Предотвращение ошибок при поставке |
Управление последствиями и вероятностью отказов |
Разделение не жесткое. Зрелая DevOps-команда использует практики SRE, а SRE-команда вполне может разрабатывать инструменты доставки и управлять инфраструктурой.
Рынок 2026: Kubernetes больше не преимущество
В январе 2026 года CNCF опубликовала результаты ежегодного исследования облачных технологий за 2025 год. Цифры показательны: 98% опрошенных организаций используют облачные технологии соответствующего класса, 82% пользователей контейнеров эксплуатируют Kubernetes в production, 58% наиболее зрелых организаций активно применяют GitOps, а OpenTelemetry закрепляется как центральный проект наблюдаемости.
Вывод для карьеры простой: знание Kubernetes становится базовым требованием для целого класса инфраструктурных вакансий. Конкурентное преимущество Senior смещается к проектированию платформ, управлению стоимостью, отказоустойчивости и автоматизации сложных процессов.
Параллельно растет Platform Engineering. Задача направления в том, чтобы дать разработчикам внутреннюю платформу самообслуживания: единый портал, через который команды сами создают сервисы, получают окружения, подключают мониторинг и выпускают изменения.
Документация Backstage описывает такую модель подробно. Инженер при этом превращается из обслуживающего конвейеры в проектирующего инфраструктурные возможности для других команд. Зарплатные ориентиры по России на основе данных 2025-2026 годов, в тысячах рублей в месяц:
|
Уровень |
Москва |
Санкт-Петербург |
Регионы |
|
Junior |
100-170 |
90-140 |
80-130 |
|
Middle |
190-300 |
170-270 |
130-230 |
|
Senior |
300-480 |
290-440 |
250-380 |
|
Lead / Architect |
380-600 |
340-550 |
280-450 |
Важная оговорка: переносить эти цифры на SRE нельзя. У дисциплины другая структура вакансий, а отдельная статистика по рынку может иметь недостаточную выборку. Утверждение, что SRE зарабатывает больше DevOps, требует проверки по конкретным вакансиям, уровню ответственности и отрасли.
Senior и Middle: разница не в количестве инструментов
Middle отвечает на вопрос «как реализовать задачу». Senior отвечает, почему выбрана именно такая архитектура и какие последствия она даст через год.
|
Задача |
Middle |
Senior |
|
Kubernetes |
Развернуть приложение |
Спроектировать отказоустойчивую платформу |
|
Terraform |
Создать ресурсы |
Модули, состояние, политики, контроль изменений |
|
Мониторинг |
Настроить графики |
Определить пользовательские показатели и стратегию оповещений |
|
Инциденты |
Устранить последствия |
Организовать реагирование и устранить системную причину |
|
CI/CD |
Собрать конвейер |
Спроектировать безопасную доставку и откат |
|
Экономика |
Подобрать размер виртуальной машины |
Сбалансировать стоимость, производительность и запас надежности |
Для Senior SRE критичны пять вещей: умение определить SLI и SLO для реального пользовательского сценария, понимание поведения зависимостей при отказах, проектирование наблюдаемости вместо сбора метрик ради галочки, организация дежурств и разборов, способность аргументировать инвестиции в надежность перед бизнесом.
Четыре ошибки при переходе из администрирования
Изучать инструменты вместо принципов. Человек проходит Docker, затем Kubernetes, Terraform, Ansible, Jenkins, Prometheus, Grafana и считает, что готов к Senior. Но знание интерфейсов не равно пониманию инфраструктуры.
Можно создавать Deployment и не понимать, почему контейнер перезапускается, чем отличаются readiness, liveness и startup probes, как работают requests и limits, почему под уходит в OOMKilled и почему балансировщик продолжает слать трафик на фактически неработающий сервис. Разбираться в этом лучше через диагностику отказов, а не через очередной курс по синтаксису.
Путать мониторинг с наблюдаемостью. Мониторинг отвечает, есть ли проблема. Наблюдаемость объясняет, почему она возникла. Для второго нужно связывать метрики, логи и трассировки. График показывает рост задержки API со 100 до 1500 мс, а причину дает только связка телеметрии: ожидание ответа от базы, а не перегрузка самого API. Здесь важен OpenTelemetry, объединяющий все три типа сигналов и контекст.
Переносить культуру ручной эксплуатации в облако. Правка конфига через ssh решает проблему и создает новую: фактическое состояние расходится с описанным в системе управления. Через неделю автоматизация вернет старую конфигурацию, или коллега воспроизведет окружение и получит другое поведение. Корректный процесс выглядит иначе: изменение описывается в коде, проходит проверку, применяется после согласования плана, а результат контролируется мониторингом.
Считать SRE более дорогим DevOps. Это не следующий грейд. Если нравится строить конвейеры и управлять инфраструктурой, ближе DevOps или Platform Engineering. Если интересно исследовать поведение распределенных систем, определять допустимые показатели отказов и договариваться с бизнесом о надежности, стоит смотреть в сторону SRE.
Кейс: от мониторинга серверов к инженерии надежности
Возьмем интернет-магазин с микросервисами: API Gateway, Order Service, Payment Service, Inventory Service, PostgreSQL, Redis и Kafka. Администратор настроит мониторинг CPU, RAM, дисков и доступности процессов. Бизнесу этого мало. Если серверы доступны, а платежи обрабатываются с задержкой в пятнадцать секунд, пользователь считает сервис неисправным.
Шаг 1. Пользовательский показатель. Для сценария оформления заказа SLI описывается как отношение успешных заказов ко всем допустимым попыткам, умноженное на 100%. SLO задается как 99,9% за 30 дней. При миллионе попыток за месяц допустимо не более тысячи неуспешных. Отдельно нужно определить, что попадает в знаменатель: пользовательские ошибки валидации и отмененные операции нельзя смешивать с внутренними сбоями в одной метрике.
Шаг 2. Бюджет ошибок. При SLO 99,9% бюджет равен 0,1%. Если из миллиона попыток восемь тысяч завершились ошибкой, бюджет исчерпан на 800%. В этот момент команда меняет приоритеты: вместо новой функциональности ресурсы идут на надежность. Здесь SRE перестает быть технической дисциплиной и становится инструментом управления разработкой.
Шаг 3. Мониторинг. Упрощенный запрос для Prometheus считает долю успешных операций:
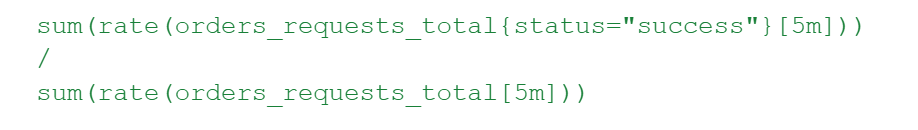
Для ошибок знаменатель тот же, а в числителе status=»error». Это иллюстрация, не production-решение: нужны согласованная классификация ошибок, корректное окно расчета и обработка отсутствия трафика.
Шаг 4. Первопричина. Метрики показывают: CPU API Gateway 35%, память 60%, число запросов не изменилось, задержка оформления выросла в десять раз, PostgreSQL демонстрирует рост времени выполнения запросов. Администратор добавит ресурсы. SRE проверит цепочку зависимостей и обнаружит, что после обновления Order Service запрос к базе стал выполнять полное сканирование таблицы. Увеличение CPU первопричину не устранит. Нужны оптимизация запроса, проверка индексов и нагрузочное тестирование.
Шаг 5. Закрепление. Разбор инцидента с временной шкалой, определение первопричин и способа обнаружения, задачи по предотвращению повторения, корректировка оповещений, при необходимости обновление SLO и архитектурных решений.
Дорожная карта на шесть месяцев
Разумнее строить не два независимых маршрута, а общий фундамент и специализацию в конце.
Этап 1. Инженерная база (месяцы 1-2). Углубление Linux: процессы, память, дисковые подсистемы, системные вызовы. Сети: TCP/IP, DNS, TLS, HTTP, балансировка. Bash и Python для автоматизации, Git. Результат: репозиторий с рабочими сценариями диагностики и автоматизации типовых административных задач.
Этап 2. Современная инфраструктура (месяцы 2-3). Устройство контейнеров, Kubernetes на уровне Pod, Deployment, Service, Ingress. Terraform: провайдеры, модули, состояние. Ansible для управления конфигурациями, Helm для приложений. Результат: воспроизводимое окружение, разворачиваемое из кода.
Этап 3. Автоматизация и эксплуатация (месяцы 3-4). GitLab CI/CD или GitHub Actions, Argo CD и GitOps, Prometheus и Grafana, Loki и OpenTelemetry, безопасное хранение секретов, проверка и откат изменений. Результат: автоматический выпуск приложения с контролем состояния и возможностью восстановления.
Этап 4. Специализация (месяц 5). Ветка DevOps: архитектура CI/CD, GitOps, управление инфраструктурой, платформенная инженерия, DevSecOps. Ветка SRE: SLI и SLO, Error Budget, наблюдаемость, Incident Management, Postmortem.
Этап 5. Инженерный проект (месяц 6). Небольшой сервис обработки заказов: несколько микросервисов, PostgreSQL, Redis, Kubernetes, Terraform, Ansible, GitLab CI/CD, Argo CD, Prometheus, Grafana, OpenTelemetry. Для DevOps-ветки акцент на автоматизации сборки, доставки и восстановления инфраструктуры. Для SRE-ветки на показателях надежности, моделировании отказов, нагрузочном тестировании, оповещениях и разборе инцидентов.
Где закрыть пробелы: четыре программы
Образовательные программы имеет смысл подбирать не по названию, а по конкретному дефициту компетенции. Каталог Хабр Курсов обновлен 14 ноября 2026 года, цены приведены по карточкам и страницам школ и могут меняться в зависимости от тарифа.
Яндекс Практикум, «DevOps для эксплуатации и разработки». Программа на 4, 6 или 8 месяцев, в каталоге около 128 400 ₽. Закрывает разрыв между традиционной эксплуатацией и автоматизированной инфраструктурой: Linux и диагностика, Bash, CI/CD, инфраструктура как код, Docker и Kubernetes, 11 практических работ с проверкой в базовом варианте. Ограничение честное: это широкая программа повышения квалификации, а не углубленная специализация Senior, часть материала опытному инженеру покажется повторением. Перед покупкой стоит оценить глубину модулей по Kubernetes и Terraform. Программа в каталоге.
Яндекс Практикум, «SRE: обеспечение надежности систем». Четыре месяца, около 92 000 ₽. Модули закрывают ровно те пробелы, которые видны в кейсе выше: введение в SRE, SLI, SLO, SLA и Error Budget, симптомы «пожара», наблюдаемость, инциденты и Postmortem, производительность. Заявлены шесть проектов, два воркшопа, около 80 часов теории и 175 часов практики, стек включает Prometheus, Grafana, Loki, Mimir, Tempo, OpenTelemetry, Alertmanager, Kubernetes и Nginx. Ограничение: курс не заменяет опыт дежурства на высоконагруженном production-сервисе. Программа в каталоге.
Слёрм, «Управление надежностью систем на основе данных». Трехнедельный интенсив, около 100-110 тыс. ₽. Ценность в моделировании работы SRE-команды: SLO и бюджет ошибок, мониторинг и оповещения, разбор инцидентов, восстановление сервиса, подготовка Postmortem, взаимодействие внутри команды. Около 20 часов практики на стендах с учебным production-сервисом. Ограничение: три недели не заменяют длительную практику, а стоимость заметно выше массовых программ, поэтому рациональнее рассматривать как корпоративное повышение квалификации. Страница курса.
Слёрм, «Наблюдаемость надежных систем». Три недели, около 20-25 тыс. ₽. Узкая программа для случая, когда Prometheus и Grafana уже стоят, но о проблемах по-прежнему сообщает поддержка. Внутри: четыре золотых сигнала, RED и USE, мониторинг микросервисов, метрики и логи, трассировка, выбор показателей пользовательского опыта, проектирование оповещений. Требуются предварительные знания Linux, Kubernetes, Python и основ мониторинга. Страница курса.
Выбор по ситуации: переход из администрирования в DevOps — первая программа; переход из DevOps в SRE — вторая; внедрение SRE в команде на действующем production — третья; дефицит диагностики микросервисов — четвертая. Все четыре в одной последовательности смысла не имеют, это выглядит как рекламная подборка, а не как план.
Портфолио, которое показывает мышление
Один комплексный проект убедительнее пяти разрозненных репозиториев. Собранная система с Terraform и Ansible, доставкой через GitLab CI/CD и Argo CD, метриками в Prometheus, дашбордами в Grafana и трассировкой через OpenTelemetry демонстрирует не знание инструментов, а способность спроектировать и эксплуатировать сервис.
Хороший финальный штрих для SRE-ветки: имитация инцидента. Намеренно внесенная деградация, сработавшее оповещение, найденная первопричина и оформленный Postmortem расскажут о кандидате больше, чем сертификат.
Финальный выбор
-
Инфраструктура, автоматизация, облака и процессы разработки: начинать с DevOps.
-
Надежность, производительность, распределенные системы и аналитика инцидентов: развиваться в SRE.
-
Уже Senior DevOps: следующий шаг лежит в Platform Engineering, SRE или архитектуре инфраструктуры.
Осваивать все направления одновременно не стоит. Шесть месяцев на фундамент и одну специализацию дают больше, чем три параллельных курса и ни одного законченного проекта.
FAQ
SRE что это простыми словами?
Инженерия, которая превращает надежность в число. Команда договаривается, какая доля запросов должна завершаться успешно, считает эту долю по факту и останавливает выпуск новых функций, когда бюджет ошибок исчерпан.
Нужно ли начинать с Junior DevOps?
Для опытного администратора это шаг назад. Реалистичнее подтвердить навыки уровня Middle или Senior в новой области через проект и практику автоматизации.
Зарплата SRE инженера выше, чем у DevOps?
Репрезентативного сравнения по рынку нет. У дисциплин разная структура вакансий, поэтому корректно сравнивать конкретные предложения по уровню ответственности и отрасли, а не средние цифры из подборок.
Обязателен ли Go?
Нет. Python закрывает большинство задач автоматизации, Go полезен при разработке внутренних инструментов и чтении кода Kubernetes-экосистемы.
ссылка на оригинал статьи https://habr.com/ru/articles/1109076/