Вам наверное очень интересно (нет) зачем нужно дома собирать мощный комп, особенно если это второй. Мне тоже, поэтому я решил обзавестись таким чтобы ответить на этот вопрос. И бонусом тут на Хабре объявили стихийно сезон сборок на старых видеокартах, поэтому я влетаю в него с опозданием! Однако вместо очередного скучного обзора на хуанан и V100 мы зададимся другим вопросом — что же со всем этим добром делать. Особенно если ты не программист и даже не байтослесарь.
Пара слов о сборке
Сборка следующая:
|
Позиция |
Тип |
Цена (доставка и пошлина) |
Откуда |
|---|---|---|---|
|
AMD EPYC 7452 |
ЦП |
12920 |
Aliexpress |
|
HUANANZHI H12D 8D |
Материнская плата |
34858 (2500) |
Aliexpress |
|
DDR4 16GB 2400 x 4 |
ОЗУ |
18966 |
Aliexpress |
|
Nvidia V100 16GB SXM2 x2 |
ГП |
27862 (2000) |
Aliexpress |
|
Samsung PM9A1 1000 GB |
SSD |
13999 |
DNS |
|
Deepcool Matrexx 70 |
Корпус |
0 |
у друга |
|
Gigabyte ud850gm pg5 v2 |
БП |
5000 |
у друга |
|
Итого |
|
113105 |
Ещё сверху водянка вышла в 50к. Не повторяйте моих ошибок, если без кастомной воды можно обойтись — обходитесь. Цены указаны на момент покупки так что можно пускать слезу, ведь это было всего полгода назад. Сейчас ещё едет 128 ГБ оперативки, позволит гонять glm 5.3 flash чуть быстрее.
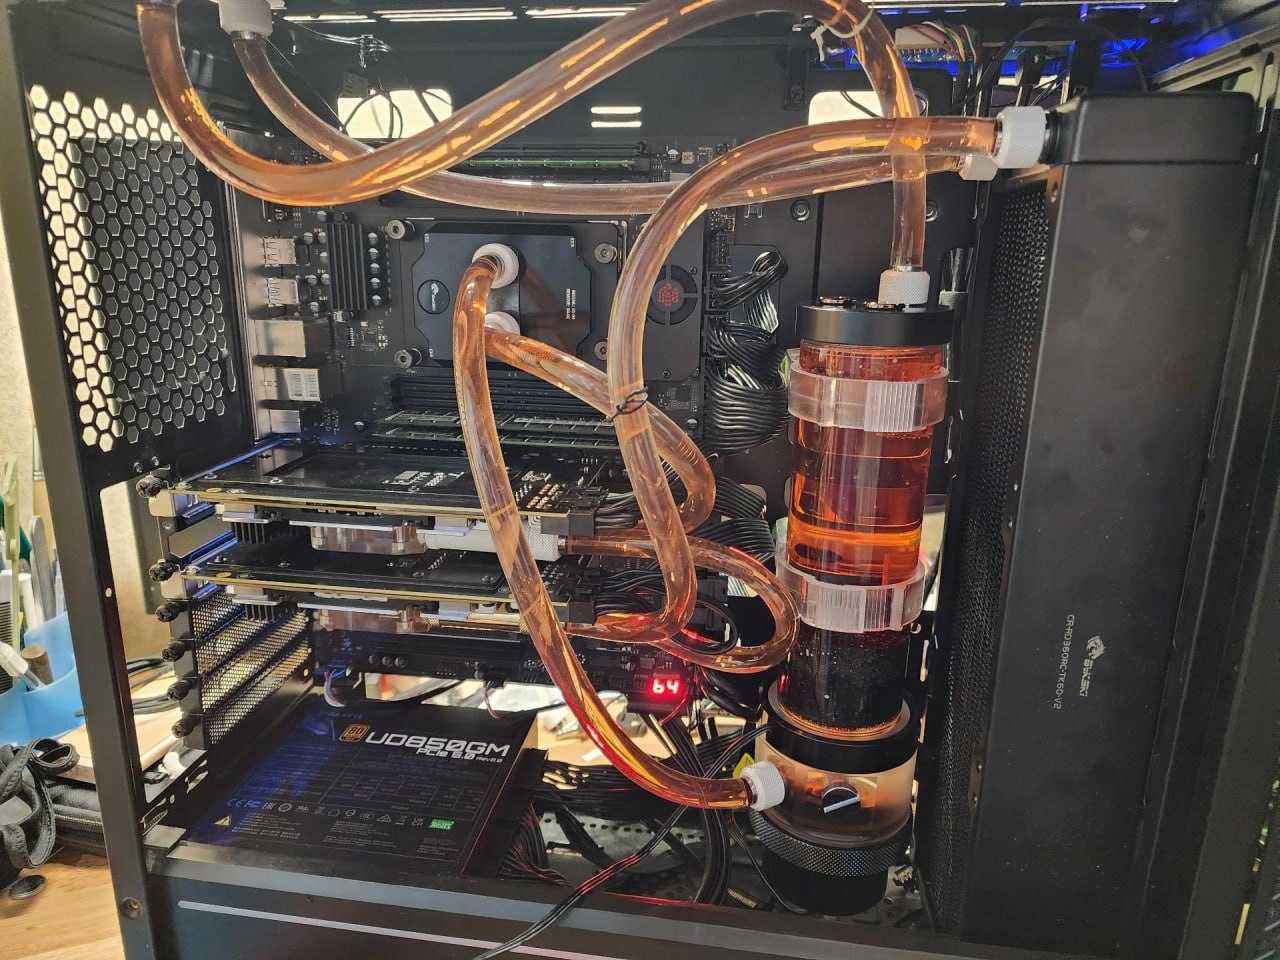
Коротко что почему. Epyc потому что 128 линий PCIe 4.0 и 8 каналов DDR4, причем за копейки. HUANANZHI H12D 8D, это единственная материнка под Epyc 2/3 поколения с 4 x16 слотами и адекватной ценой. Из альтернатив Supermicro h11ssl-i, но там только 3 слота, плюс для поддержки 7xx2 нужна последняя ревизия и обновленный биос. Остальные варианты идут от 70к. SSD я просто увидел цену в DNS и сразу поехал брать. Остальное довольно тривиально. Оперативка кстати спокойно разогналась до 2933.
Реальных альтернатив платформе в ультра бюджетном сегменте нет. Недорого можно собраться на Intel C612, поменьше каналов памяти, PCIe всего 3.0, зато есть AVX-512, возможно при оффлоаде моделей на CPU это даст преимущество, но это не точно.
Динамический мир локальных LLM
Пока у меня был claude на этом добре гонялось CFD, Depth Anything, SionnaRT, и прочие мегапроекты с их использованием, которые я уже забыл. Однако теперь claude нет, запариваться с обходом лень, да и осадочек остался, поэтому самое время запускать там локальные LLM чтобы слоперировали уже они. Остается только понять, смогут ли они. Скучные тесты типа сделай клон Minecraft, интерфейс Windows 11 уже были, поэтому надо погонять тесты оригинальнее и поближе к вайбкод реальности.
Что такое вайбкод? Да брось, все знают что это такое, скажете вы, и будете не совсем правы. При разработке с ИИ есть два подхода: агнентная разработка и вайбкод. В чем разница? В агентной разработке вы работаете с агентом как сеньор с джуном, описываете задачу, что делать, как, подробное ТЗ, модели остается только следовать инструкциям. В вайбкоде — как менеджер: идёт формулировка уровня «Сделай зае хорошо». И вот если с первым модели справляются неплохо, то как получится со вторым, мы сейчас и выясним.
Мир локального ИИ разивается стремительно, изначальный вариант статьи предполагал примерно такой формат, я потестирую на 2-3 задачах следующие модели:
-
Gemma 4 26B-A4B
-
Muse Spark 30B
-
Qwen 3.8 27B
Будет простой вердикт типа Qwen 3.8 что-то может, остальные для вайбкода вообще не, страдаем дальше и всё такое, но пока я прокрастинировал написание статьи, появились проекты Strata и Maya, что позволило запускать Qwen 3.8 flash next (125B), GLM 5.3 flash (320B) и даже deepseek flash v4.1 1017 (763B) на этом железе. Оба проекта нацелены на эффективное использование ОЗУ и стриминг весов с SSD для инференса MoE моделей, что получается у них весьма и весьма неплохо.
Поэтому шорт лист моделей для тестов следующий:
-
Huihui-Qwen3.8-27B-abliterated (Q4_K)
-
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS
-
GLM-5.3-Flash-Maya-S24-IQ2_XXS_S
Производительность моделей приблизительно такая:
|
Модель |
Prefill |
Decode |
|---|---|---|
|
Qwen 3.8 27B |
800-1000 |
50-70 |
|
Qwen 3.8 flash next |
500-1400 |
50-70 |
|
GLM 5.3 flash |
200-600 |
15-20 |
|
Deepseek v4.1 flash |
180-250 |
7-15 |
Декод сильно зависит от типа задачи, mtp даёт ощутимое ускорение при написании кода. Deepseek формально работает, но скорость делает его неюзабельным, в тестах поэтому он не участвует.
Инференс и харнесс
Выше упоминались Strata и Maya, инференс Qwen 3.8 flash next — Strata, GLM 5.3 flash — Maya. Их настроить успел opus, поэтому приводить тут конфиг не буду, спросите вашего ИИ агента! Qwen 3.8 27B запускается llama.cpp следующими аргументами:
GGML_CUDA_P2P=1 NCCL_P2P_DISABLE=0 NCCL_P2P_LEVEL=SYS GGML_CUDA_ALLREDUCE=nccl \~/src/llama.cpp-20261006/build/bin/llama-server \ --host 0.0.0.0 --port 8080 \ -m ~/models/qwen38/Huihui-Qwen3.8-27B-abliterated-Q4_K.gguf \ --mmproj ~/models/qwen38/mmproj-F16.gguf \ -ngl 999 -sm tensor -fa on \ -ctk q8_0 -ctv q8_0 \ -c 196608 -b 4096 -ub 512 --parallel 1 --jinja \ -t 4 -tb 8 \ --spec-type draft-mtp --spec-draft-n-max 3 \ --reasoning-budget 16384 --reasoning-effort medium \ --image-min-tokens 1024 --image-max-tokens 4096
Вместо харнесса был opencode 1.19, веб поиск searxng с duckduckgo через mcp. Разумеется все тестировали на Windows 10.
Непосредственно тесты
Модели настроены, харнесс готов, переходим к тестам. Здесь задача проверить что-то менее стандартное чем уже было на хабре. Плюс не давать четкий план модели, а посмотреть на то как у них получится работать с нечетким ТЗ, а также выполнять несколько задач последовательно. Я стремился сделать задачи one-shot. Если итеративно что-то делать с LLM то шансы на успех повыше, но у тогда сравнение не очень честное да и потребует много времени. Наши тесты стремятся быть максимально неадекватными, поэтому пристегнитесь! Во всех промптах орфография сохранена!
Читалка чата на ANSI C
Начинаем с самых простых задач. Здесь проверяем способность модели разведать эндпоинт, изучить его формат, написать код на ANSI C, отладить его, отладить кроссплатформерную сборку под винду.
Промпт
Задача создать консольную читалку для кукарекалки Радио Анонимус. Адрес anon.fm. Тебе необходимо на странице самосотятельно найти «кукарекалку» определить эндпоинт и его формат. При выводе сообщений в консоль необходимо визуально индетефицировать пользователей — раскрашивать ники уникальными индивидуальными цветами. Читалка должна иметь два режима: постоянный — автообновление и выдача новых сообщений и «once» выводит последние n сообщений и завершается.Стек приложения: ANSI C (C89), WolfSSL. Остальные библиотеки, при необходимости, по твоему усмотрению.Сборка: cmake на WSL2 (Ubuntu на нашей системе). Кроссплатформерная сборка под linux и windows.Все комментарии в коде пишутся на simplified technical english (asd-ste100). По готовности сделай к проекту README.md на русском языке
Результат:
Все модели тут справились хорошо. Код рабочий, 27B потребовалось указать вручную что на винде не работает, остальные справились с 1 промпта. Визуально мне понравилось, у обоих Qwen формат получился похожий, GLM сделал оригинальнее.
Здесь в тесты попали ещё и gemma 4 и muse spark. Краткий сравнительный анализ от ИИ:
🏆 TL;DR — таблица лидеров (кто не зря ел электричество)
|
Место |
Проект |
Собралось? |
Эндпоинт |
WolfSSL |
Вердикт одной строкой |
|---|---|---|---|---|---|
|
🥇 |
glmaya |
✅✅ |
✅ верный |
✅ по-настоящему |
Строгий C89 |
|
🥈 |
27b |
✅ |
✅ верный |
✅ по-настоящему |
Взрослый проект. Настоящий JSON-парсер, честный дедуп, ~2200 строк. Пара скелетов в шкафу, но работает. |
|
🥉 |
next |
✅ |
✅ верный |
✅ по-настоящему |
Крепкий середнячок. Чище всех грузит CA, но парсер на соплях и дедуп течёт в долгую. |
|
4-е |
muse |
❌ |
✅ верный |
⚠️ есть, но выключен |
Эндпоинт нашёл, поля разложил — и на этом всё. Не собирается, TLS проверку отрубил, стек на 3.4 МБ. |
|
💩 |
gemma |
❌ |
❌ не тот |
❌ нет вообще |
Скелет в костюме проекта. |
Итог: до рабочего бинаря доехали трое — glmaya, 27b и next. muse правильно понял что читать, но не смог это собрать. gemma не понял ни что, ни чем.
Оптимизация инференса на… ESP32
Окей, на сишке модели писать умеют, а как насчет немножечко эмбеда? ESP32 это вполне себе боевая классика, но обучающих данных по нему много, надо взять что-то менее очевидное. О, точно, ESP32S3 это на самом деле не WiFi SoC, это секретный DSP, причем один из самых эффективных по цене. Про его векторные инструкции уже известно меньше, поэтому надо использовать их для оптимизиации инференс движка esp32-ai (прим. — где-то до коммита 97018d5 движок был на чистом C). Fable 5 осилил дать тут аж под 22-31 т/с, а на что способны локальные модели?
Промпт
В рабочей папке лежит проект esp32-ai. Это проект инференса малой языковой модели на ESP32S3. Твоя задача ускорить инференс. Движок инференса в референсном проекте написан на чистом C, проект на arduino. Необходимо изучить проект, докачать необходимое если отсутствует, понять каким образом устроен движок инференса. Переписать этот движок на esp-idf с использованием векторных инстукций ESP32S3, библиотеки esp-dsp. В системе установлен IDF v6.0.1. Среда включается следующей командой: C:\Windows\System32\WindowsPowerShell\v1.0\powershell.exe -NoExit -ExecutionPolicy Bypass -NoProfile -Command «& {. ‘C:\Espressif\tools\Microsoft.v6.0.1.PowerShell_profile.ps1’}»
Для тестирования подключена отладочная плата с ESP32S3 на порту COM12. Взаимодействие с ESP32 по UART, не использовать WiFi. Сделать CLI интерфейс для работы с инференсом, простой, несколько команд позволяющих работать с инференсом и получать статистику.По результатам собрать README.md на русском с описанием того как был устроен изначальный инференс, что ты модифицировал для ускорения и сравнением скорости генерации.
Результаты:
Flash next тут не справился, где-то застрял и после нескольких компактов так никуда и не продвинулся. 27B справился с задачей и получил ~13 т/с генерации, +30% прироста, используя функции библиотеки ESP-DSP. GLM 5.3 получил ~20 т/с генерации, +100% прироста, уже используя PIE-ассемблер. Оба проекта верифицированы, логиты байт в байт идентичны оригинальному движку. При разборе выяснилось что все модели оптимизировали head, причем у GLM 5.3 получились почти те же оптимизации что и у Fable 5, разница от того что Fable вдовесок оптимизировал attn.
Тест на креативность — генератор никнеймов
Отойдем от низкого уровня и посмотрим с совершенно другой стороны, насколько модели умеют в креативность.
Промпт
Давай сделаем генератор никнеймов. Нам нужно создавать интересные никнеймы на русском или английском языке. Принцип работы выбери самосотятельно. Для реализации используй Python. В конце сделай README.md, включающий в себя описание того как генератор устроен.
Результаты:
Оба Qwen сделали генераторы псевдослов, немного по-разному, у GLM 5.3 — только генерация словосочетаний. Все приправили 1337speak, xXx и прочими модными украшениями ников. Результаты совсем непримечательные, ну типа: ледянойщит9, обсидианель, рьяныйНеистовыйКвазар, supernovaRoot, буу, что это такое вообще, на дворе 2012? Этот тест меня скорее разочаровал, я бы конечно ожидал тут что-то посложнее, ну хотя бы цепи Маркова. Но что есть, какое ТЗ такой результат, тест на креативность скорее провален чем пройден, а вот по техническому исполнению замечаний почти нет.
Противоречивое ТЗ — рисуем фрактал Мандельброта на GPU
Повышаем градус упоротости заданий. Этот промпт мне посоветовали в одном чате и, о, этот манёвр стоил нам 7 лет, застряли мы надолго, потому что фракталы пришлось рисовать всем, в том числе Claude пока он был.
Промпт
Сделай анимацию пролёта фрактала Мандельброта. Сделай пролёт по известным красивым местам. Сделай чтобы это выглядело красиво. Вывод в видео, mp4 h264, 1920×1080 60 fps. Сделай на ANSI C (C89). Фрактал без зависимостей, никаких библиотек, кодировать видео можно ffmpeg. Для отрисовки используй GPU. Учитывай что у нас архитектура Blackwell.
Тут есть несколько моментов. Во-первых, C89 и GPU — не очень совместимый стек, CUDA это C++. Во-вторых, красивые места это размытое понятие, хотя есть известные примечательные места в фрактале. Но мы же вайбкодеры, нас такие моменты не остановят, не так ли?
Результаты:
Вот тут разница уже налицо. 27B, как бы это описать, хотя бы смог нарисовать его.
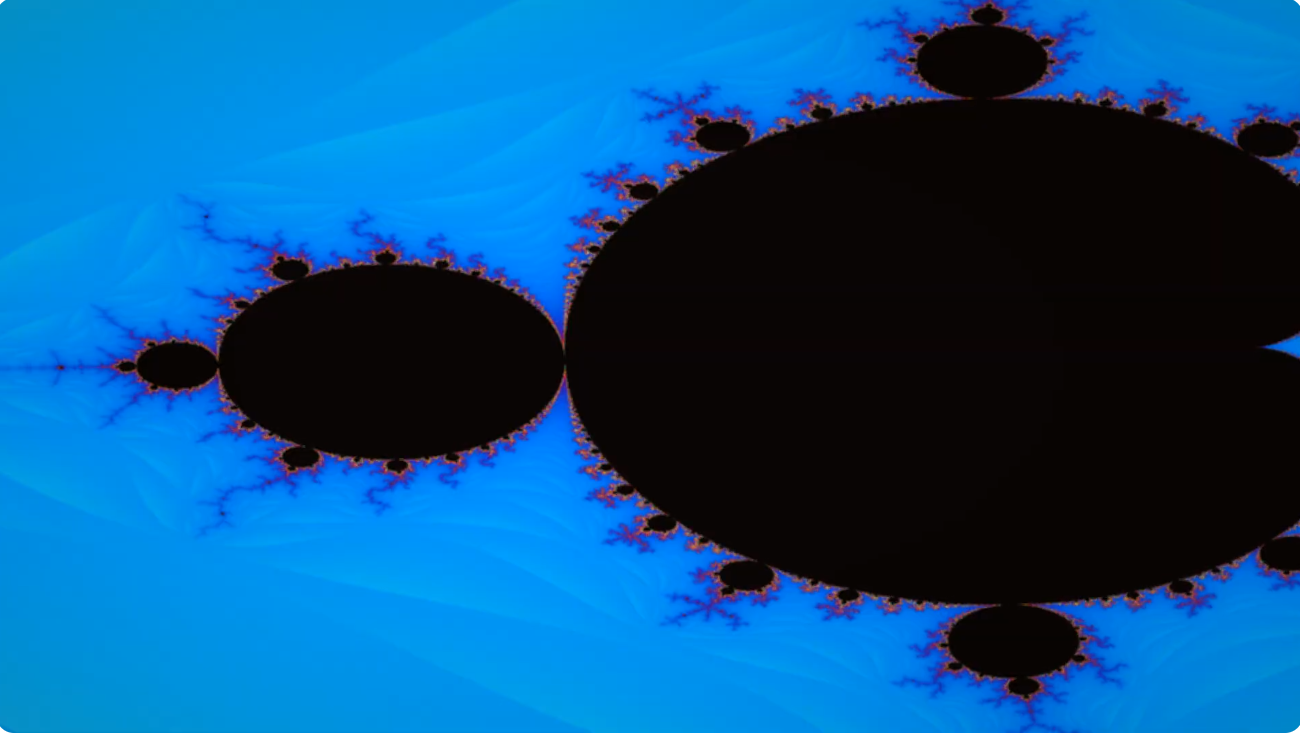
Qwen 27B взял имевшийся в системе nvcc и по сути забил на требование ANSI C, хотя кроме CUDA библиотек в целом писал совместимый с ANSI C код.
Qwen Flash Next интерпретировал иначе и вместо CUDA взял… compute шейдеры на OpenGL. Тоже не совсем ANSI C, но в целом пойдет. Результат уже заметно лучше, хоть и кривые движения слишком резкие, плюс разрешение так себе, сглаживания нет, цвета меняются скачком.
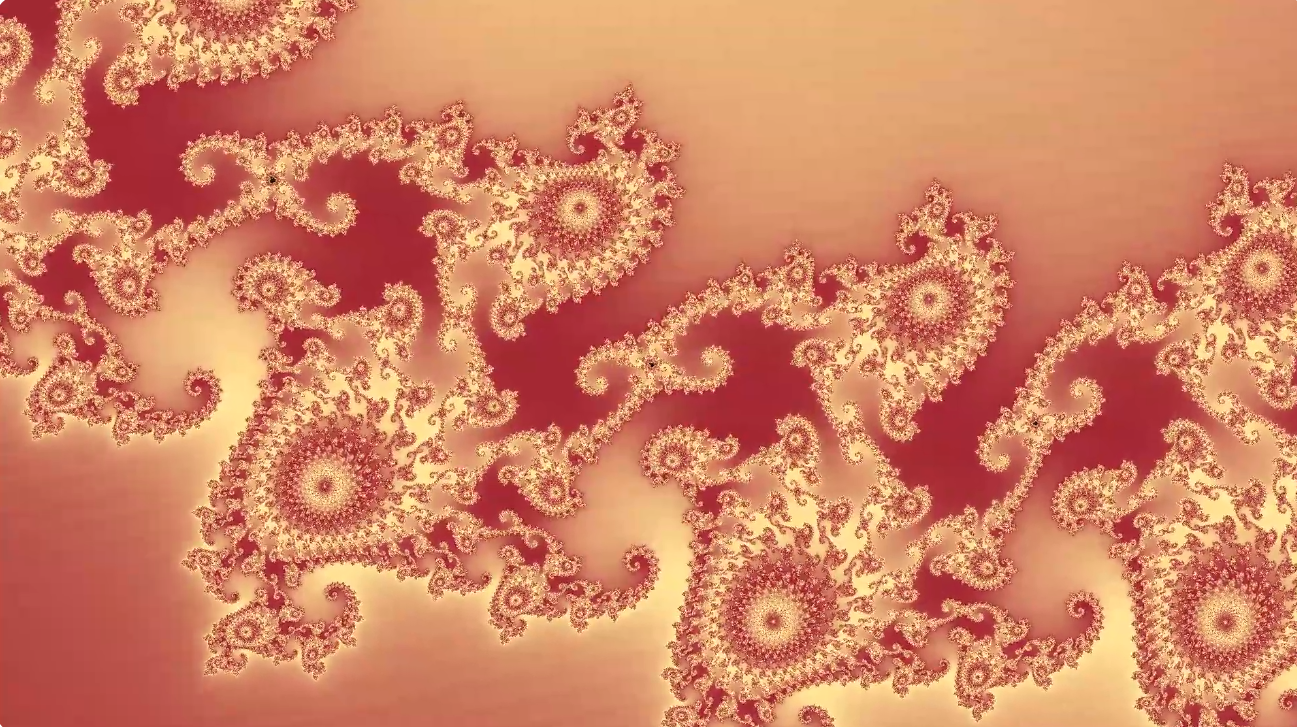
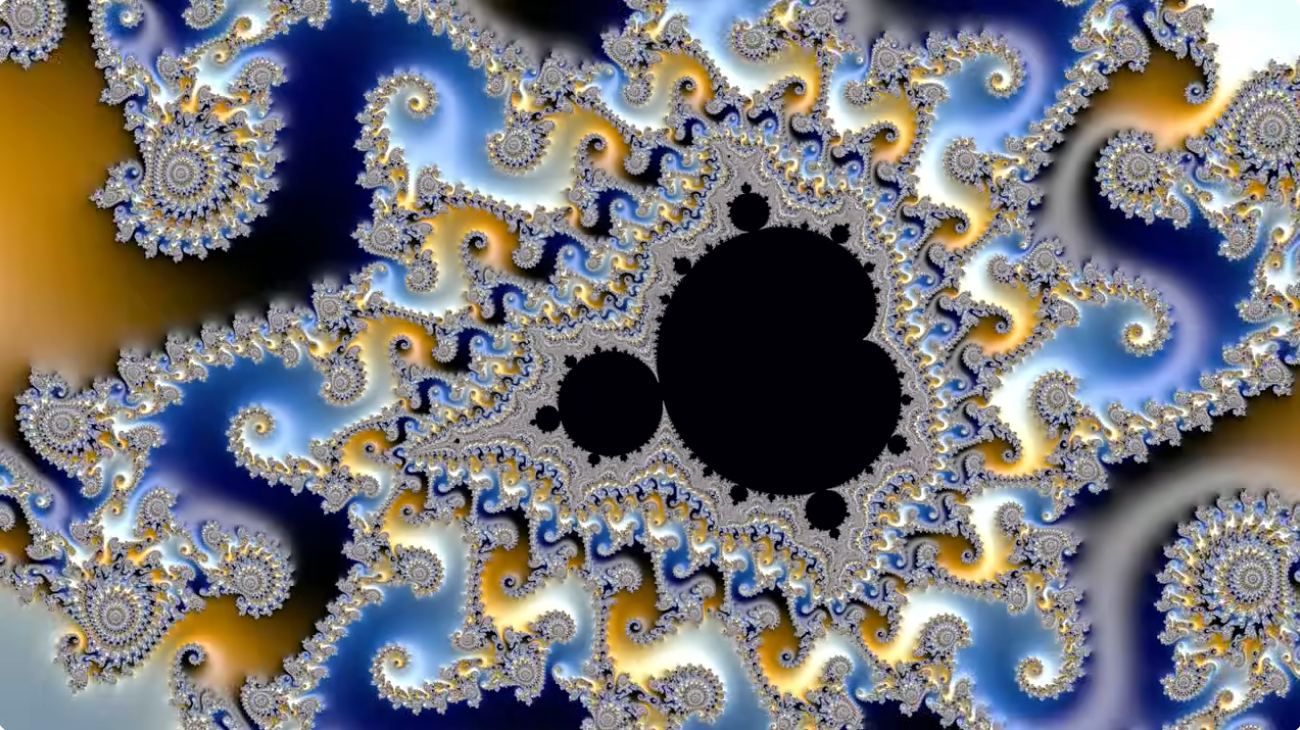
GLM 5.3 показал лучший результат. Сглаживания всё ещё нет, причем мерцание заметно даже после сжатия ютуба, зато какие цвета, какая плавность движения! Можно залипать с почти удовольствием.
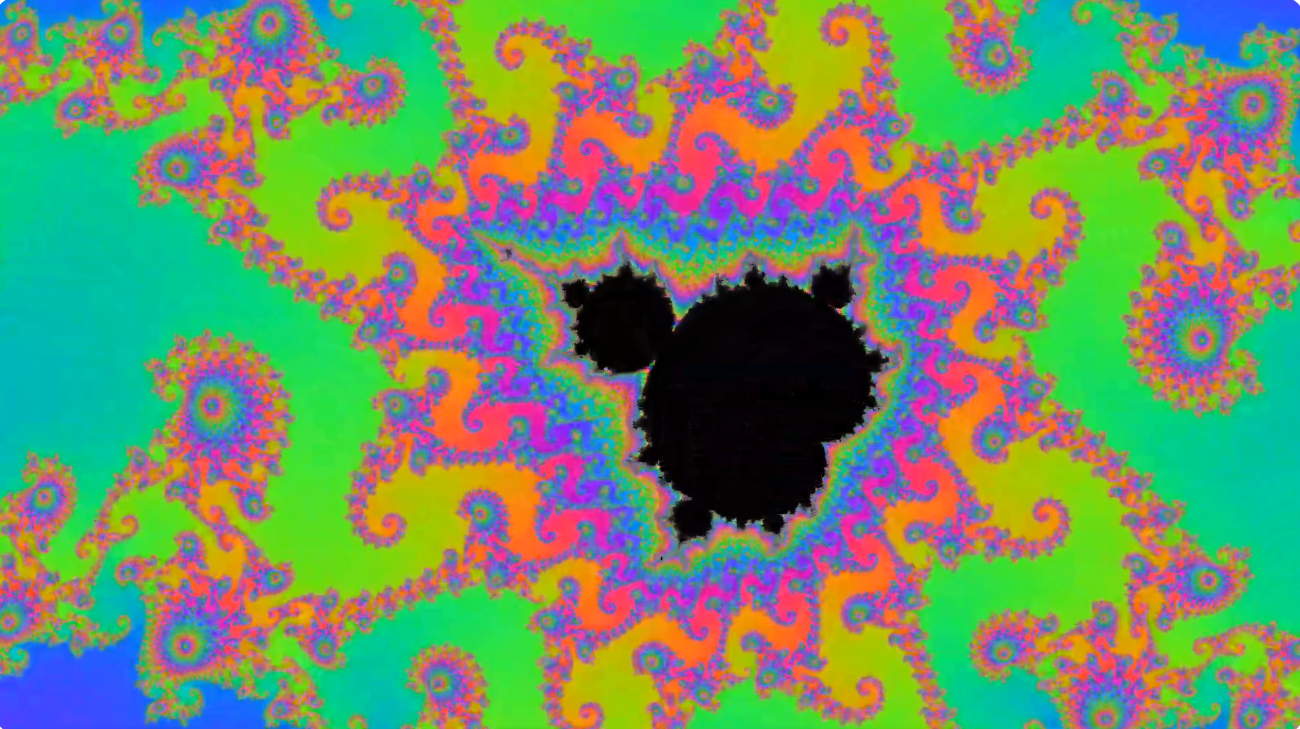
Здесь по требованию ANSI C модель пошла ва-банк, рендер написан на PTX с JIT компляцией так что CUDA Toolkit в рантайме не нужен вообще! И это локальная нейронка на топ железе 2018-2019 года.
Для сравнения что сделал Opus 5 (там же есть пара видео от Fable):
Когда софт уже не вставляет — Verilog
Окей, справились с графоном и программирвоанием под GPU, а давайте писать своё железо. Вот Verilog то мы уже не осилим? Ну ладно, чисто Verilog может осилим, но как насчет написать HDL, верифицировать, зашить на реальное железо и протестить? Дадим не слишком сложную задачку, сделем генератор ШИМ, то есть таймер. С управлением по UART. Под рукой была Tang Nano 9k, так что…
Промпт
Тебе дана заготовка HDL проекта, Gowin EDA, Verilog. Тестовая плата — Tang Nano 9k. Constraints заданы, у нас 6 светодиодов, uart, reset и вход тактового сигнала 27 МГц. Необходимо реализовать логику, проект должен делать следующее. ШИМ контроллер с 6 выходами (светодиоды). Длительность импульса каждого канала настраивается индивидуально. Пределитель и счетчик общие. Все значения 16 битные. Проверки что длительность импульса меньше счетчика не требуется. Для управления сделать командный интерфейс UART. Через интерфейс должно быть доступно чтение и запись регистров. Формат уточни сам, примерно так:
R,1 — прочитать регистр 1
W,1,2 — записать в регистр 1 значение 2
Интерфейс должен быть терминал совместимым, то есть loopback, рабочее стирание через backspace. Вместо мгновенной интерпретации команды необходимо ожидать перевода строки — это индикатор ввода. Команда чтения возвращает результат, записи K при успешной, E при ошибке. Неизвестные команды E.
Инструменты: D:\Programs\Gowin\Gowin_V1.9.11.02_x64, в системе есть iverilog, python. Gowin programmer автоматически определит подключение плис, UART на COM37. При необходимости веб поиска используй mcp searxng с движком «ddg impersonate» Реализуй проект, отладь и протестируй.
По готовности сделай к проекту README.md на русском языке.
Результаты:
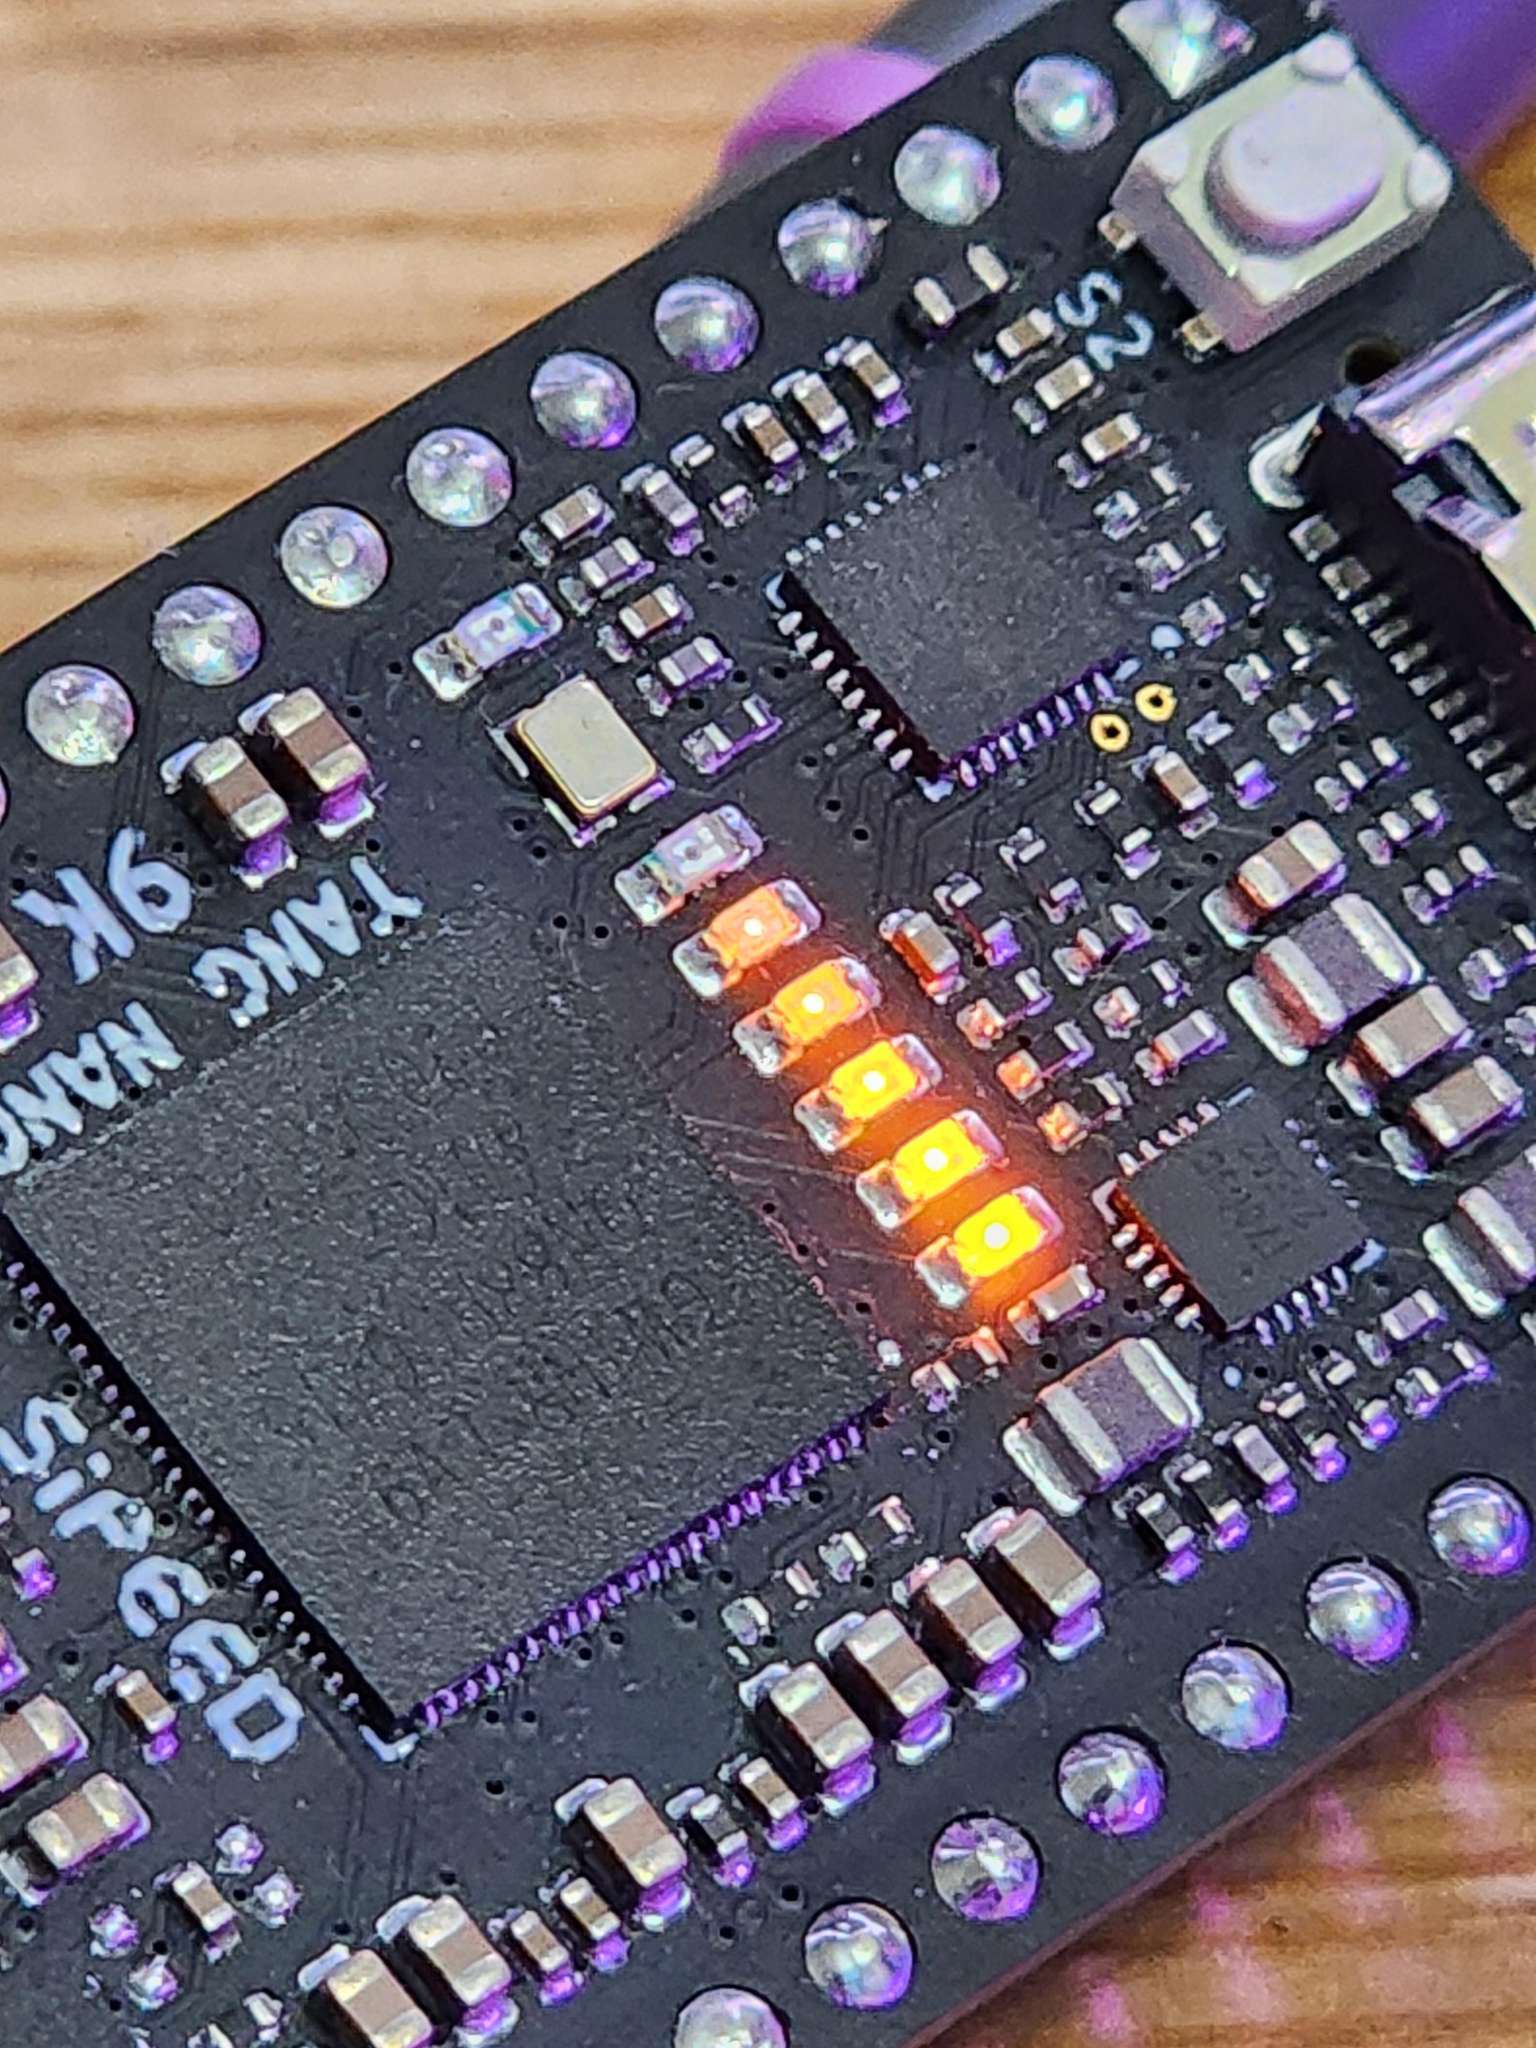
К моему удивлению с этим справились все модели, даже 27B. В основном разница в том что Flash next и GLM догадались сначала уточнить полярность светодиодов у Tang Nano, 27B решил не запариваться этим, что, впрочем, соотвествует ТЗ. Verilog для меня всё ещё новая область поэтому качественно сравнить исполнение не могу, но если оно работает — оно работает. Более того, время, которое понадобилось тоже удивительное, 27B — около 1.5 часа, Flash next около получаса, GLM — около двух часов. Хм, а может попробовать навайбкодить GPS приёмник с поиском и слежением на ПЛИС и отладкой с помощью SDR? Как-нибудь в другой раз.
Когда Verilog недостаточно аппаратно — проектируем свою плату
Недавно появился новый модный AI-native софт для разработки печатных плат — tscircuit. Больше всего там интересно следить за разработкой автотрассировщика, по демонстрациям похоже что это что-то уровня TopoR, не меньше. Opus конечно после двух часов с ним жалобливо попросил перейти в KiCad, но вдруг сейчас выйдет? Дам простую задачку, вот ну совсем простую, USB преобразователь термопары. STM32G491 (просто потому что я накупил себе пару десятков зачем-то), элитный max31856, дальше додумать по ситуации.
Промпт
@tscirctuit Создай печатную плату преобразователя термопары. Используемые микросхемы: MAX31856, контроллер stm32g491ccu6. Для подключения термопары используй 2-контактный клемник с шагом 5 мм. У STM32 выведен USB, разъем USB-C. Прошивка контроллера через DFU, необходима кнопка выбора режима загрузки boot0. Размер платы не более чем 30×50 мм. Минимум 2 крепежных отверстия под винт M3. USB разъем и клеммник должны быть расположены с разных сторон платы. У STM32 выведи 4 свободных GPIO пина на разъем с шагом 2.54. Печатная плата имеет 2 слоя.
Результаты оставляют смешанные чувства. С одной стороны я удивлен что это вообще дало что-то похожее на печатную плату, с другой, наконец-то фейл, мы нашли что-то чего локальные LLM пока что не могут сделать!
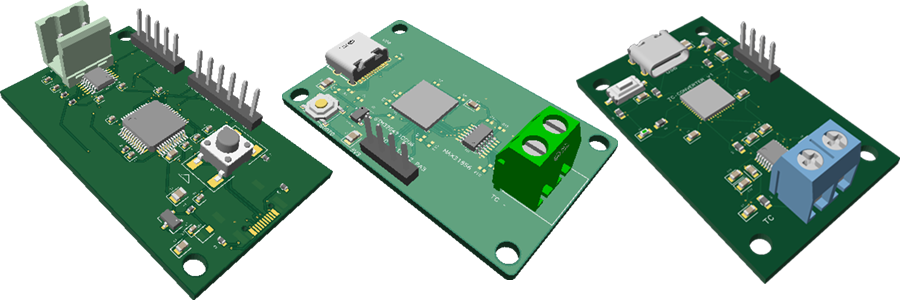
Здесь прекрасно всё! Более-менее получилось у, внезапно, flash next, это почти неплохая плата для новичка: usb смотрит в правильную сторону, компоненты не залезают друг на друга, плата имеет скругления углов. Да и рендеры нескучные, он сделал виды со всех сторон. Правда вот посадочное место max31856 неправильное, он шире.
Qwen 27B зачем-то вывел SWD хотя этого не требовалось, перепутал QFN48 и LQFP48, поставил USB смотрящим в сторону платы, на его посадочном месте скрыл под паяльной маской площадки для крепления разъема. GLM 5.3 flash сделал почти правильно, но посадочное место под STM32 неправильное, да и развернутый USB это конечно косяк-косяк, в особенности цитируя CoT модели:
Small note: the USB-C model orientation — it faces up/out of board toward viewer, correct-ish. The model might be slightly rotated vs pads? Looks fine.
Тем не менее, по схемотехнике замечаний нет, я не изучал это дотошно, тем более что схемы, созданные в tscircuit обладают сомнительной читаемостью, но выглядит как будто нет серьёзных проблем по этой части.
Что ещё?
Пока я писал статью вышла ещё одна «компактная» модель Hy4 flash на 220B параметров. Движки под неё ещё не оптимизировали, но через llamacpp запустить можно, префилл ~200 т/с, декод 35 т/с. С первой задачей читалки на ANSI C модель справилась за всего 100к токенов, похоже она перспективная для домашнего использования.
Кроме агентной разработки относительной популярностью пользуются ИИ ассистенты. Вот этот сценарий я не особо понял. Я ставил Hermes agent, думал из него выйдет отличный кейс для статьи о том, как домашний ИИ это круто, но я просто не понял зачем он нужен, у меня не нашлось задач для него.
Вместо итогов
Если выбирать победителя, то я склоняюсь к Qwen 3.8 flash next. Ощутимо умнее 27B при той же скорости, сильно быстрее GLM 5.3 flash. Для отдельных задач GLM 5.3 flash имеет смысл применять, когда скорость не так важна.
Конечно мегапроекты уровня тех, что делал Opus, пока локальные LLM не могут делать; особенно я не готов им доверить то, что вряд ли смогу проверить сам. Тем не менее, готовя эту статью, я не без удивления обнаружил, что всё таки локальные LLM могут делать что-то реальное и инетресное, не очередную змейку в браузере, не очередной клон майнкрафта, а показывают себя в тех областях, которые полезны лично мне. Следущая отладочная плата на отечественном МК вряд ли будет сделана агентом на этих моделях, а вот инструменты и библиотеки к ней — очень даже возможно.
ссылка на оригинал статьи https://habr.com/ru/articles/1110104/